Google verbessert Live-Übersetzung, OpenAI öffnet Vollduplex-Sprachdialoge: Was bleibt nach dem Gespräch?
GPT-Live-1 ist für 0,05 US-Dollar pro Sprachminute per API verfügbar, drei Monate nach Googles Live-Sprachübersetzung für 70 Sprachen. Was die veröffentlichten Preise und Benchmarks messen, was nicht, und warum Gesprächsprotokolle, geteilte Ideen und gespeicherte Quellen wichtiger werden, je leichter Gespräche fallen.
Eine originelle konzeptionelle Illustration. Eine natürlichere Konversation und eine nützliche Aufzeichnung dieser Konversation sind ergänzende Designziele und keine gemessenen Phasen einer Produktveröffentlichung.
An den jüngsten Ankündigungen zur Sprach-KI begeistert mich vor allem eine alltägliche Möglichkeit: einen Gedanken in der eigenen Sprache zu Ende zu führen, unterwegs zu präzisieren und trotzdem selbstverständlich am Gespräch teilzunehmen. Weniger auf die Übersetzung warten, weniger Sätze vor dem Sprechen im Kopf proben. So bleibt mehr Aufmerksamkeit dafür, was das Gegenüber wirklich meint.
Google führte Gemini 3.5 Live Translate am 9. Juni 2026 ein. OpenAI führte seine Vollduplex-Modelle GPT-Live am 8. Juli in ChatGPT ein und veröffentlichte dann GPT-Live-1 am 10. September in der API. Dabei handelt es sich um verschiedene Produkte, die unterschiedlichen Zwecken dienen, aber die Reihenfolge deutet auf eine kontinuierlichere gesprochene Interaktion hin. Die neueste Ankündigung von OpenAI erweitert den Zugriff für Entwickler; Es ist nicht der erste Auftritt von GPT-Live. Googles Juni-Ankündigung, OpenAIs Juli-Einführung, OpenAIs September-API-Release.
Ich sehe darin einen Schritt zu einer Welt, in der Sprachbarrieren im Alltag weniger ins Gewicht fallen. Zugleich wird eine weitere Frage wichtiger: Wie bewahren wir den Wert eines Gesprächs, wenn es leichter wird, dieses Gespräch zu führen? Protokolle, geteilte Ideen und gespeicherte Quellen gehören zur Antwort.
Vollduplex verändert das Warten im Gespräch
Vollduplex bedeutet, dass ein System gleichzeitig zuhören und sprechen kann. OpenAI beschreibt GPT-Live-1 in seiner aktuellen Modelldokumentation auf diese Weise, zusammen mit der Möglichkeit, Argumentation und Werkzeugnutzung an einen Backend-Agenten zu delegieren. Das ist eine Aussage über simultane Interaktion, kein Zertifikat perfekter Übersetzung. GPT-Live-1-Modelldokumentation, geprüft am 11. September 2026.
Stellen Sie sich vor, Sie korrigieren einen Assistenten, während er einen Plan erklärt: „Eigentlich ist der Kunde in Madrid, nicht in Mexiko-Stadt.“ Eine nützliche gesprochene Schnittstelle muss diese Korrektur bemerken, bevor sie mit der falschen Annahme fortfährt. Es muss auch eine Korrektur von einer kurzen Bestätigung oder eine Denkpause von einer Aufforderung zur Übernahme unterschieden werden. Die Qualität des Austauschs hängt von diesen kleinen Urteilen ab.
Bei älteren Sprachschnittstellen fiel oft die Turn-Struktur auf. Sie haben gesprochen, auf die Verarbeitung gewartet, zugehört und es dann erneut versucht. Eine schnellere Verarbeitung hilft, aber eine Interaktion kann sich dennoch unangenehm anfühlen, wenn das System vermutet, dass Sie zu früh fertig sind. Das Vollduplex-Design befasst sich mit der Überlappung selbst, anstatt jeden Moment der Sprache als sauber geschlossene Nachricht zu behandeln.
In frühen, von OpenAI berichteten Auswertungen verzeichnete das Sprachlernunternehmen Speak während der Denkpausen Lernender fast 80 % weniger Unterbrechungen als mit früheren rundenbasierten Systemen. Dieses Partnerergebnis betrifft das Unterbrechungsverhalten, nicht die Übersetzungsgenauigkeit, und lässt sich möglicherweise nicht auf jede Sprache und jede Situation übertragen. API-Startbericht von OpenAI, 10. September 2026.
OpenAI berichtet, dass GPT-Live-1 auf Full Duplex Bench 30 Prozentpunkte mehr erzielt als GPT-Realtime-2.1. Der Test umfasst Pausen, Sprecherwechsel, Unterbrechungen und kurze Rückmeldesignale (Backchannels). Zusammen mit GPT-6 Astra bei mittlerem Reasoning-Aufwand belegt GPT-Live-1 auf Tau3 den ersten Platz bei gesprochenen Aufgaben aus Kundenservice und Banking, darunter 97 Aufgaben zu Bankwissen. Diese Anbieter-Auswertungen messen Gesprächsverhalten und Aufgabenerfüllung, nicht Übersetzungsgenauigkeit. OpenAIs Auswertungsübersicht, 10. September 2026.
Für jemanden, der eine zweite Sprache spricht, kann eine Denkpause genau der Punkt sein, an dem die Teilnahme schwierig wird. Ein Assistent, der angemessen wartet, lässt Raum für die Wortfindung. Ein Assistent, der eine Korrektur akzeptiert, macht den Versuch kostengünstiger. Das sind praktische Gründe, sich für die natürliche Sprachinteraktion zu begeistern, die über den beeindruckenden Klang einer Demonstration hinausgeht.
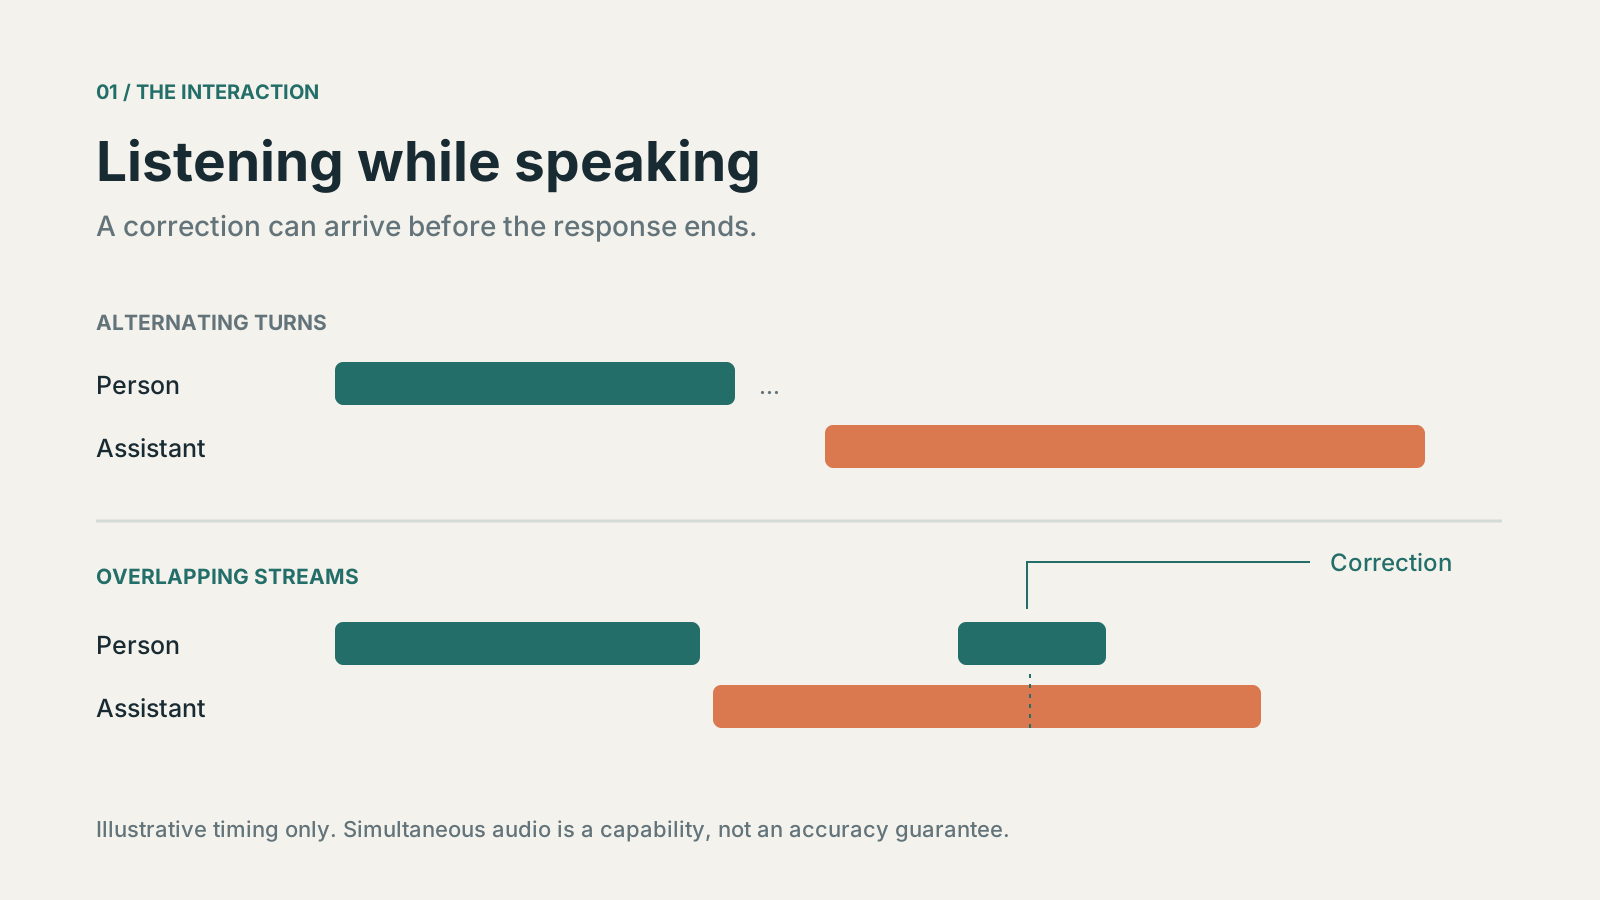
Nur konzeptionelles Timing; Die Balken stellen keine gemessene Latenz dar. Vollduplex beschreibt die gleichzeitige Ein- und Ausgabe, während die sinnvolle Behandlung von Unterbrechungen immer noch vom Modell und der Anwendung abhängt.
Live-Übersetzung und Sprachassistenten haben unterschiedliche Aufgaben
Die Juni-Ankündigung von Google beschreibt die kontinuierliche Sprachübersetzung in mehr als 70 Sprachen. Das Modell generiert während des Zuhörens übersetzte Sprache und gleicht so die Notwendigkeit von mehr Kontext mit der Notwendigkeit ab, in der Nähe des Sprechers zu bleiben. Laut Google bleiben einige Sekunden zurück, was eine sinnvollere Erwartung ist, als sich eine Nullverzögerung vorzustellen. Bei der Entwicklerversion handelte es sich um eine öffentliche Vorschau. Googles Startbeschreibung, 9. Juni 2026.
Die Größenangaben in dieser Ankündigung sind konkret. Die Sprachübersetzung in Google Meet soll von fünf unterstützten Sprachen auf mehr als 70 wachsen und statt nur von und ins Englische künftig mehr als 2.000 Sprachkombinationen in einem Meeting abdecken. Sie startet als private Vorschau für ausgewählte geschäftliche Workspace-Kunden; eine breitere Einführung folgt später im Jahr 2026. Grab testet das Modell für die Abholung von Reisenden durch Fahrer, ein Anwendungsfall mit mehr als 10 Millionen Sprachanrufen pro Monat. Die Ankündigung zitiert Lob von Partnern für Qualität, Genauigkeit und geringe Latenz, nennt für diese Messgrößen aber keine Zahlen. Googles Angaben zum Start, 9. Juni 2026.
Es gibt einen Unterschied, der es wert ist, sichtbar zu bleiben. Der Live-Übersetzungsleitfaden von Google beschreibt einen Dolmetscher, der einen Audiostream kontinuierlich verarbeitet, mit übersetzungsspezifischen Einstellungen und ohne Unterstützung für Tools oder allgemeine Anweisungen. GPT-Live-1 ist ein Konversationsmodell, das mit einem separaten Agenten arbeiten kann. Man hilft dabei, die Bedeutung eines Sprechers in eine andere Sprache zu übertragen; der andere nimmt am Austausch teil. Sie sollten nicht als austauschbare Dienste dargestellt werden. Leitfaden zur Live-Übersetzung von Google, Modelldokumentation von OpenAI, überprüft am 11. September 2026.
| Meilenstein | Was wurde angekündigt | Verfügbarkeit oder Umfang |
|---|---|---|
| Google, 9. Juni 2026 | Gemini 3.5 Live Translate; kontinuierliche Sprachübersetzung | Öffentliche Entwicklervorschau zum Zeitpunkt der Ankündigung; Qualität kann je Sprachpaar variieren |
| OpenAI, 8. Juli 2026 | GPT-Live-Rollout in ChatGPT, mit gleichzeitigem Zuhören und Sprechen | Konversationelle Sprache ist nicht gleich Dolmetschgenauigkeit |
| OpenAI, 10. September 2026 | GPT-Live-1 API-Zugriff zum Erstellen von Sprachanwendungen | Entwickler müssen es noch in ihre eigenen Produkte integrieren |
Zeitpunkt und Umfang der Veröffentlichungen stammen aus den drei verlinkten Ankündigungen; die Produkte erfüllen unterschiedliche Aufgaben und werden nicht miteinander verglichen.
Zusammengenommen machen diese Entwicklungen eine überzeugende Richtung sichtbar: Die Übersetzung kann kontinuierlicher werden und die Interaktion mit einem Assistenten kann weniger starr werden. Die Verbindung dieser Funktionen zu einem zuverlässigen mehrsprachigen Meeting-Erlebnis bleibt Anwendungsarbeit. Es muss immer noch jemand entscheiden, wessen Audio gedolmetscht wird, wohin das Ergebnis geht, wie mit Korrekturen umgegangen wird und was die Teilnehmer sehen.
Die veröffentlichten Zahlen: 0,05 US-Dollar pro Minute, aber kein Genauigkeitswert
Eine Minute Sprache mit GPT-Live-1 kostet in der API 0,05 US-Dollar und wird sekundengenau abgerechnet, ohne Aufrundung auf volle Minuten. Dieser Preis gilt nur für die vorgelagerte Sprachschicht; das Backend-Modell und die Tools, an die eine Sitzung Aufgaben delegiert, werden separat zu ihren regulären Preisen berechnet. OpenAIs Modelldokumentation, geprüft am 11. September 2026.
Bei diesem Tarif kosten 30 Minuten 1,50 US-Dollar für die Sprachschicht, eine Stunde 3,00 US-Dollar und 100 Stunden im Monat 300 US-Dollar, noch ohne Backend-Reasoning. Eine Anwendung, die jedem Teilnehmer eine eigene Sitzung zuweist, vervielfacht die Gesamtkosten mit der Zahl der Sitzungen. Googles Juni-Ankündigung nannte keinen Preis für Gemini 3.5 Live Translate; diese Beträge sind daher kein Kostenvergleich.
| Kennzahl | Wert | Quelle und Datum | Was sie misst |
|---|---|---|---|
| GPT-Live-1 API-Preis | 0,05 US-Dollar pro Minute, sekundengenau abgerechnet | OpenAI, 10. September 2026 | Nur die Sprachschicht; Backend-Modell und Tools werden separat berechnet |
| Full Duplex Bench | +30 Prozentpunkte gegenüber GPT-Realtime-2.1 | OpenAI, 10. September 2026 | Pausen, Sprecherwechsel und Unterbrechungen, keine Übersetzung |
| Tau3 | Platz eins, mit GPT-6 Astra (mittel) | OpenAI, 10. September 2026 | Erfolg bei gesprochenen Aufgaben (Pass@1), darunter 97 Banking-Aufgaben |
| Frühe Auswertung von Speak | Fast 80 % weniger Unterbrechungen in Denkpausen | OpenAI (Partnerzitat), 10. September 2026 | Unterbrechungsverhalten im Vergleich zu früheren rundenbasierten Systemen |
| Sprachfunktion in ChatGPT | Mehr als 150 Millionen Menschen pro Woche | OpenAI, 8. Juli 2026 | Nutzung von Sprachmodus und Diktierfunktion, nicht Qualität |
| Gemini 3.5 Live Translate | 70+ Sprachen, automatisch erkannt | Google, 9. Juni 2026 | Abdeckung, nicht Qualität je Sprachpaar |
| Sprachübersetzung in Google Meet | 5 → 70+ Sprachen; 2.000+ Kombinationen pro Meeting | Google, 9. Juni 2026 | Geplantes Upgrade, zunächst als private Vorschau |
| Übersetzungsverzögerung | „Nur wenige Sekunden hinter dem Sprecher“ | Google, 9. Juni 2026 | Beschreibung des Anbieters, kein Messwert |
Alle Zahlen stammen von den Anbietern selbst, aus den in diesem Beitrag verlinkten Ankündigungen und Dokumentationen. Keine davon ist ein numerischer Wert für Übersetzungsgenauigkeit, etwa eine menschliche Bewertung oder eine automatische Metrik für ein Sprachpaar.
Diese Lücke ist vor allem für alle wichtig, die ein Tool für mehrsprachige Meetings auswählen. Interaktions-Benchmarks zeigen, ob ein System angemessen wartet, zuhört und nach Unterbrechungen sauber weitermacht; sie zeigen nicht, ob „Montag“ in der koreanischen Übersetzung auch als Montag ankommt. OpenAIs Hinweis vom Juli auf nicht-muttersprachliche Akzente in einigen Sprachen und das Fehlen von Werten je Sprachpaar bei Google führen zur selben praktischen Regel: Testen Sie die Sprachpaare, die Ihr Team tatsächlich nutzt, bevor Sie sich bei Entscheidungen auf eines der beiden Systeme verlassen.
Niedrigere Sprachbarrieren machen es leichter, sich zu Wort zu melden
Stellen Sie sich ein hypothetisches 30-minütiges Projekttreffen mit vier Personen vor, die sich in drei verschiedenen Sprachen am besten auskennen. Der Vorteil einer besseren gesprochenen Übersetzung besteht nicht nur darin, dass jede Person mehr Wörter hört. Die Gruppe kann Folgefragen stellen, bevor aus einer Unsicherheit ein Missverständnis wird. Eine vorläufige Idee kann ausgedrückt werden, ohne dass sie zuvor in eine zweite Sprache übersetzt werden muss.
Das verändert die Ökonomie der Beteiligung in einem ganz gewöhnlichen Sinne: Mitmachen erfordert weniger Aufwand. Der ruhige Mensch mit einschlägiger Erfahrung hat einen anderen Weg in die Diskussion. Die Person, die das Meeting leitet, kann weniger Zeit damit verbringen, einen unterbrochenen Satz zu rekonstruieren. Eine Klarstellung kann erfolgen, wenn sie nützlich ist, während sich alle noch an den besprochenen Punkt erinnern.
Remote-Teams, Diskussionen im Klassenzimmer, Kundengespräche und informelle Gespräche auf Reisen sind Situationen, in denen kontinuierliche Übersetzung die Teilnahme erleichtern könnte. Das Ergebnis hängt weiterhin vom Sprachpaar, Akzent, Wortschatz, Mikrofonqualität und dem Produkt ab, das die Übersetzung bereitstellt.
In seiner Vorstellung im Juli wies OpenAI auf nicht muttersprachliche Akzente oder eingeschränkte Sprachflüssigkeit in einigen Sprachen hin. Teams sollten die tatsächlich verwendeten Sprachpaare und Akzente prüfen, statt anzunehmen, eine gelungene englische Demonstration sage ihre Ergebnisse voraus. OpenAIs GPT-Live-Einführung, 8. Juli 2026
Das richtige Ziel ist eine breitere Beteiligung mit einer einfachen Möglichkeit zur Klärung. Ein Datum, ein Betrag, der Name einer Person oder eine bedingte Zusage sollen leicht überprüfbar bleiben. Ein System kann selbstbewusst klingen, während ein Teilnehmer noch sagen muss: „Bitte zeigen Sie mir diesen Satz.“ Durch das Vorzeigen des Textes und das Aufbewahren des Originals, sofern die Teilnehmer der Aufnahme zugestimmt haben, wird dieser Bitte ein Ende gesetzt.
Auch ein flüssiges Gespräch braucht ein Entscheidungsprotokoll
Zurück zum erfundenen Projekttreffen: Jemand schlägt vor, das Produkt am Freitag zu veröffentlichen, sofern die Sicherheitsprüfung abgeschlossen ist. Eine andere Person bevorzugt Montag, damit das Supportteam mehr Vorbereitungszeit hat. Die Gruppe entscheidet sich für Montag und benennt einen Verantwortlichen; eine Voraussetzung bleibt jedoch offen. Eine Zusammenfassung, die nur den zuerst vorgeschlagenen Freitag festhält, verfehlt das Ergebnis.
Keine Verbesserung des Gesprächsrhythmus beseitigt den Unterschied zwischen einem Vorschlag, einer Bedingung und einer Entscheidung. Personen, die in derselben Sprache arbeiten, müssen sie bereits unterscheiden. Durch die mehrsprachige Interaktion wird es wertvoller, den Weg von der ursprünglichen Aussage über den übersetzten Wortlaut bis zur endgültigen vereinbarten Handlung zu bewahren.
Für eine praktische Besprechungsaufzeichnung möchte ich, dass ein Leser, der den Anruf verpasst hat, schnell drei Dinge herausfindet: was die Gruppe beschlossen hat, wer für den nächsten Schritt verantwortlich ist und welche Fragen offen bleiben. Eine Frist sollte erst dann als vereinbart gelten, wenn sie vereinbart wurde. Wenn die Quelle unklar ist, sollte die Aufzeichnung diese Unsicherheit weitertragen, anstatt sie zu einer falschen Schlussfolgerung zu machen.
Dazu ist es nicht erforderlich, jedes Gespräch in ein umfassendes Archiv zu verwandeln. Eine kurze Entscheidungsnotiz kann nützlicher sein als Seiten mit undifferenziertem Transkript. Die wichtige Beziehung besteht zwischen dem prägnanten Bericht und dem unterstützenden Material: dem relevanten Originalwortlaut, der Aufzeichnung, sofern verfügbar und autorisiert, und dem Dokument, über das die Gruppe diskutiert hat.
Mit dieser Verbindung lassen sich Fehler leichter berichtigen. Ein Teilnehmer kann die ursprüngliche Aussage zeigen, die Zusammenfassung korrigieren und die berichtigte Entscheidung teilen. Andernfalls könnte die nächste Person die Zusammenfassung erneut zusammenfassen und das erste Missverständnis wie eine gesicherte Tatsache behandeln. Bessere Sprachinteraktion erleichtert das Gespräch; gute Aufzeichnungen machen sein Ergebnis später überprüfbar.
Geteilte Ideen brauchen ihre Quellen
Eine nützliche Idee beginnt und endet selten innerhalb eines Anrufs. Jemand findet einen Artikel, speichert eine Passage, stellt eine Frage dazu und bringt die Frage zu einer Besprechung. Eine andere Person fügt ein Gegenbeispiel aus einem Video oder einer Forschungsarbeit hinzu. Der nächste Schritt hängt davon ab, ob es gelingt, diese Teile nach dem Ende des Gesprächs wieder miteinander zu verbinden.
Deshalb bleibt das Speichern von Webquellen auch mit sehr guter Sprach-KI sinnvoll. Eine URL führt zum Original zurück, ein ausgewählter Abschnitt hält die relevante Stelle fest, und eine persönliche Notiz erklärt, warum sie wichtig war. Diese Informationen erfüllen verschiedene Aufgaben. Zusammen vermitteln sie eine Idee besser als ein einzelner, weitergeleiteter KI-Absatz.
„Wir sollten die Einführung für neue Nutzer ändern“ bietet wenig, woran ein Kollege anknüpfen kann. „Dieser Artikel hat Fragen zu den ersten fünf Minuten aufgeworfen; hier sind die Passage, unsere Diskussion und der vereinbarte Versuch“ liefert dagegen eine prüfbare Grundlage. Das Beispiel ist erfunden, der Unterschied konkret: Mit dem Ergebnis allein bittet man um Vertrauen; mit Begründung und Quelle ermöglicht man die weitere Diskussion.
Die gleiche Disziplin schützt die Quelle davor, in einem Kommentar verwischt zu werden. Ein Zitat soll als Zitat erkennbar bleiben. Eine Übersetzung ist eine Interpretation dieser Quelle und eine Besprechungszusammenfassung ist eine weitere abgeleitete Ansicht. Wenn diese Rollen sichtbar bleiben, können Menschen produktiv anderer Meinung sein, ohne zunächst rekonstruieren zu müssen, was jemand ursprünglich gesagt hat.
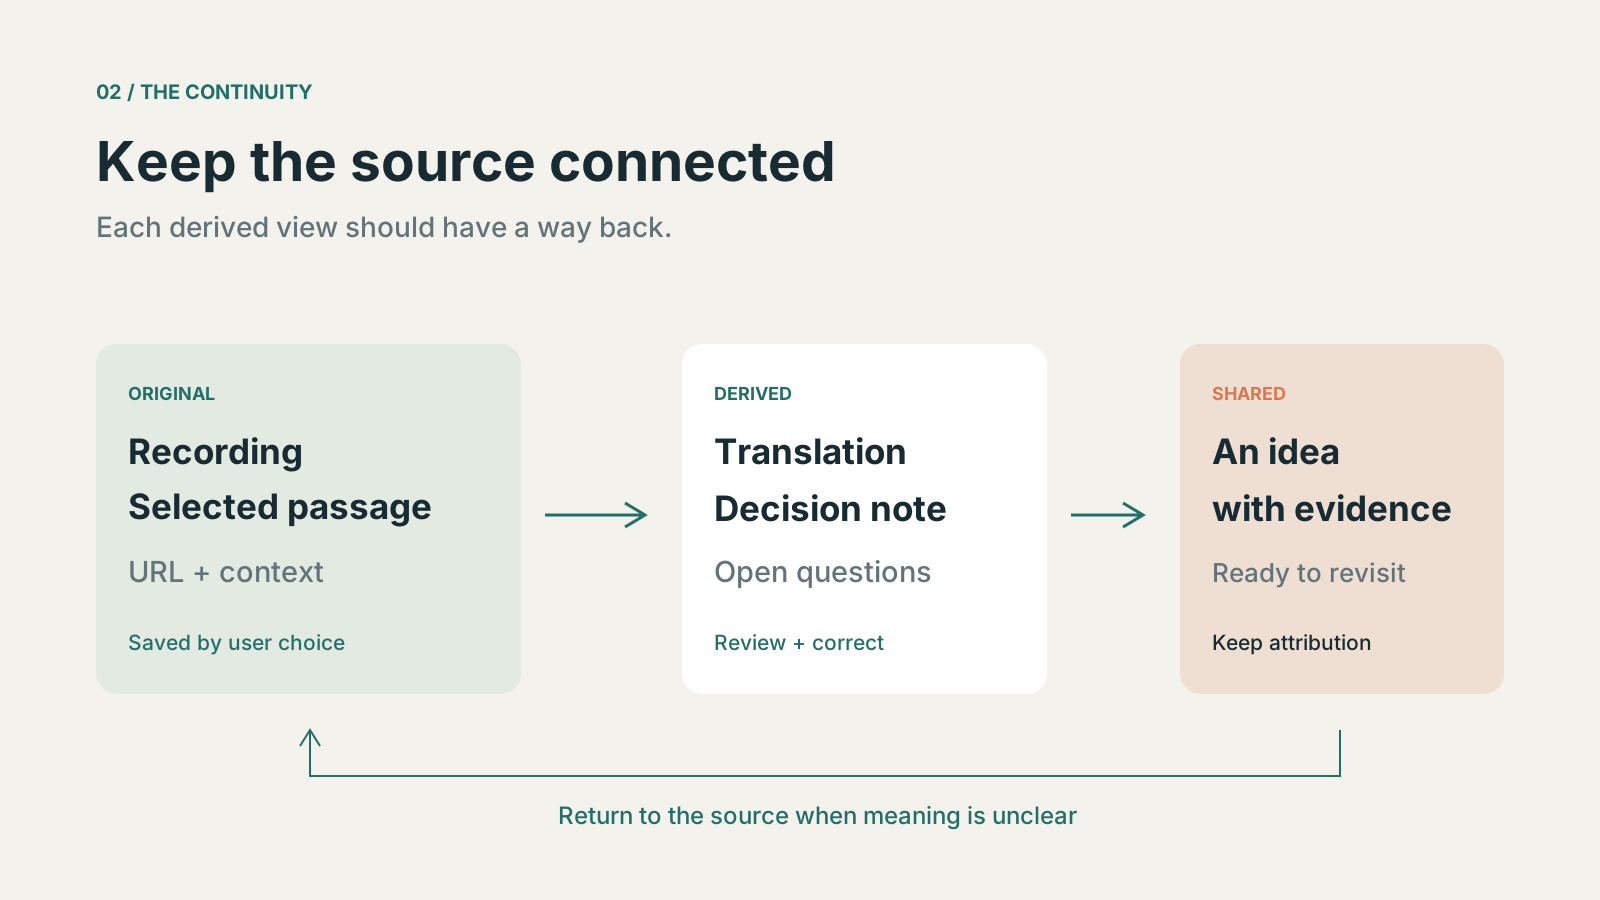
Ein ursprünglich vorgeschlagener Arbeitsablauf. Bewahren Sie autorisiertes Quellmaterial, machen Sie abgeleiteten Text korrigierbar und halten Sie die Verbindung beim Teilen sichtbar. Das Diagramm behauptet nicht, dass jeder Link heute eine automatisierte Funktion ist.
Der Zusammenhang muss auch nach dem Gespräch erhalten bleiben
Sprachsysteme beginnen auch, das Gespräch von der Arbeit dahinter zu trennen. In der Delegationsdokumentation von OpenAI wird erläutert, dass Live-Rede und delegierte Arbeit unabhängig voneinander fortgesetzt werden können. Eine abgeschlossene Backend-Antwort beweist nicht, dass der Benutzer die Antwort gehört hat. Dies ist eine nützliche technische Erinnerung an ein umfassenderes Produktproblem: Eine gesprochene Erfahrung und ein dauerhaftes Ergebnis sind getrennte Dinge, die es zu überprüfen gilt. OpenAIs Delegationsdokumentation, geprüft am 11. September 2026.
Für normale Benutzer ist die Frage einfacher. Wenn ein Anruf endet, kann ich die Entscheidung morgen finden? Kann ein Kollege verstehen, warum wir es geschafft haben? Kann ich zu dem Artikel zurückkehren, der unsere Annahme in Frage gestellt hat, ohne einen Chatverlauf, einen Browser und eine Aufzeichnung zu durchsuchen? Diese Fragen bleiben auch dann bestehen, wenn jeder Satz schön interpretiert wird.
Es gibt Grund zur Hoffnung, dass Sprachbarrieren weniger dominant werden. Wir sollten Tools begrüßen, die es mehr Menschen ermöglichen, bequem einen Beitrag zu leisten. Ich gehe davon aus, dass eine einfachere Konversation den Wert der Verknüpfung dessen, was wir sagen, mit dem, was wir behalten, teilen und schließlich tun, steigern wird. Das Treffen muss nicht ewig dauern; sein nützliches Ergebnis sollte den Anruf überdauern.
Wohin wir Telli.sh entwickeln wollen
Für Telli.sh ist das die Richtung: Gespräche und Entdeckungen in Wissen verwandeln, auf das Menschen zurückgreifen können. Heute vereint das Produkt Notizen, Aufnahmen, Übersetzungen und Clips in einem Arbeitsbereich. Als Nächstes wollen wir die Verbindungen zwischen diesen Materialien stärken, damit Protokoll, Idee und Quelle nicht wieder auseinanderfallen.
Der Ablauf soll zusammenhängend sein: ein zur Aufzeichnung freigegebenes Gespräch festhalten, wichtige Punkte prüfen, Entscheidungen verständlich dokumentieren und eine Idee mit ihren Belegen teilen. Beginnt die Diskussion auf einer Webseite, soll Clip die URL und den vom Nutzer ausgewählten Kontext bewahren helfen. Hilft eine Übersetzung beim Verständnis, muss das Original für Vergleich und Korrektur erreichbar bleiben.
Telli.sh hat GPT-Live-1 oder Gemini 3.5 Live Translate nicht integriert. Jede künftige Sprachintegration muss sich durch nützliche Ergebnisse in mehreren Sprachen, verlässliche Aufzeichnungen und klare Kontrolle darüber, was gespeichert wird, bewähren. Ziel ist ein nützlicherer Arbeitsbereich, wenn sich die zugrunde liegenden Modelle verbessern, ohne persönliches Wissen von einem einzelnen Modell abhängig zu machen.
Je leichter Gespräche über Sprachgrenzen hinweg werden, desto länger soll ihr Wert erhalten bleiben. Beginnen Sie mit einem wichtigen Meeting, einer Idee zum Teilen oder einer Quelle, die Sie später wieder brauchen.