装不下一场采访的免费 120 分钟:印尼语的免费 AI 转写,实际给你的是什么
Notta 的免费套餐每月给 120 分钟转写,单条录音卡在 3 分钟。TurboScribe 每天给 3 个文件,上限 30 分钟。谷歌的 API 给你 60 分钟免费额度,但不给界面。2026 年 8 月 7 日,Deepgram 上线了改进后的印尼语模型——只在批处理这条路上。这是一份实测过的对比:印尼的记者、研究者和 HR 面试官真正会撞上的免费套餐,以及它们都不会写在广告里的限制。
你手机里躺着一段 47 分钟的采访。今天上午在泗水录的一位受访者,大部分是印尼语,中间照例散着英语——deadline、stakeholder、follow up。你今天就要拿到文字稿,而且非常不想为它付钱。
于是你搜索,落到一个宣称每月免费转写 120 分钟的工具上,注册了账号。47 分钟的文件,稳稳落在 120 之内。然后上传失败了,而在套餐对比表的深处埋着第二个数字,没人会把它写进标题:单条录音最长转写时间,3 分钟。
整个品类都是这个形状。免费套餐拿听起来最慷慨的那个数字打广告,再被下面第三行的另一个数字锁死。这篇文章就是我们一直希望存在的那份对比:每个免费套餐对一场印尼语采访究竟给了什么,又默默拒绝了什么,以及在掏钱之前,怎么用五分钟把任何一个工具试出来。
要点速览
- 免费套餐有三道互相独立的上限——每月分钟数、单文件分钟数、每天文件数——而真正把采访卡死的几乎永远是单文件上限,不是月度总量。
- 印尼语的语音识别这个月确实变好了:Deepgram 在 2026 年 8 月 7 日上线了升级版的 Nova-3 印尼语模型,但只在批处理路径上,不含流式。上传录音的人受益,实时字幕不受益。
- 没有任何公开排行榜在测印尼语的准确率。Open ASR 排行榜在 2026 年 8 月 28 日加入了第一门全球南方语言,而那是印地语。在这一点改变之前,唯一能描述你自己音频的基准,就是你自己跑的那段 5 分钟测试片。
把免费套餐并排摆出来
下面每一个数字都来自厂商自己公开的价格页或文档,取用时间为 2026 年 8 月 31 日。参照任务是一场两人对谈、47 分钟的采访,因为那才是人们手里真实存在的那种文件。
| 工具 | 免费套餐 | 免费额度下的最长单文件 | 印尼语 | 付费起步 |
|---|---|---|---|---|
| Notta | 每月 120 分钟、每月 50 次上传、每月 10 次 AI 摘要、1 个席位 | 3 分钟 | 未确认 | Pro 按年付合每月 $8.17 —— 每月 1,800 分钟,5 小时文件 |
| TurboScribe | 每天 3 份转写,排队优先级较低 | 30 分钟 | 支持 | Unlimited 每月 $10,按年付 $120 —— 10 小时文件 |
| Transkriptor | 未公布免费月度分钟数 | — | 支持 | Lite 每月 $9.99 —— 每月 300 分钟 |
| Maestra | 未公布免费月度分钟数 | — | 支持 | 按量付费每 60 分钟 $12;Lite 每月 $23 —— 每月 180 分钟 |
| Google Cloud Speech-to-Text | 每月 60 分钟,之后每分钟 $0.016 | 实际上没有上限 | 支持,id-ID | 开启数据日志每分钟 $0.016,关闭为 $0.024 |
| OpenAI 转写 API | 无 | 实际上没有上限 | 支持 | 每分钟 $0.006(gpt-4o-transcribe)、每分钟 $0.003(mini) |
| Whisper,自建部署 | 不限量,MIT 许可 | 取决于你的硬件 | 支持 | 软件免费,成本是你自己的 GPU 时间 |
| Telli.sh | 每月 60 分钟 | 在额度内可整段上传 | 支持 | 付费套餐从每月 300 分钟起 |
来源:各厂商价格页,2026 年 8 月 31 日查阅;id-ID 取自谷歌的支持语言文档;OpenAI 取自其公开的 API 价格。TurboScribe 的实时价格页会拦截自动抓取,因此其数字取自互联网档案馆的页面快照,并与该套餐在其他地方的现行描述一致——依赖它们之前请自行核实。2026 年 8 月 31 日我们无法从 Notta 取到分语言清单,所以它的印尼语支持标为未确认,而不是默认为有。
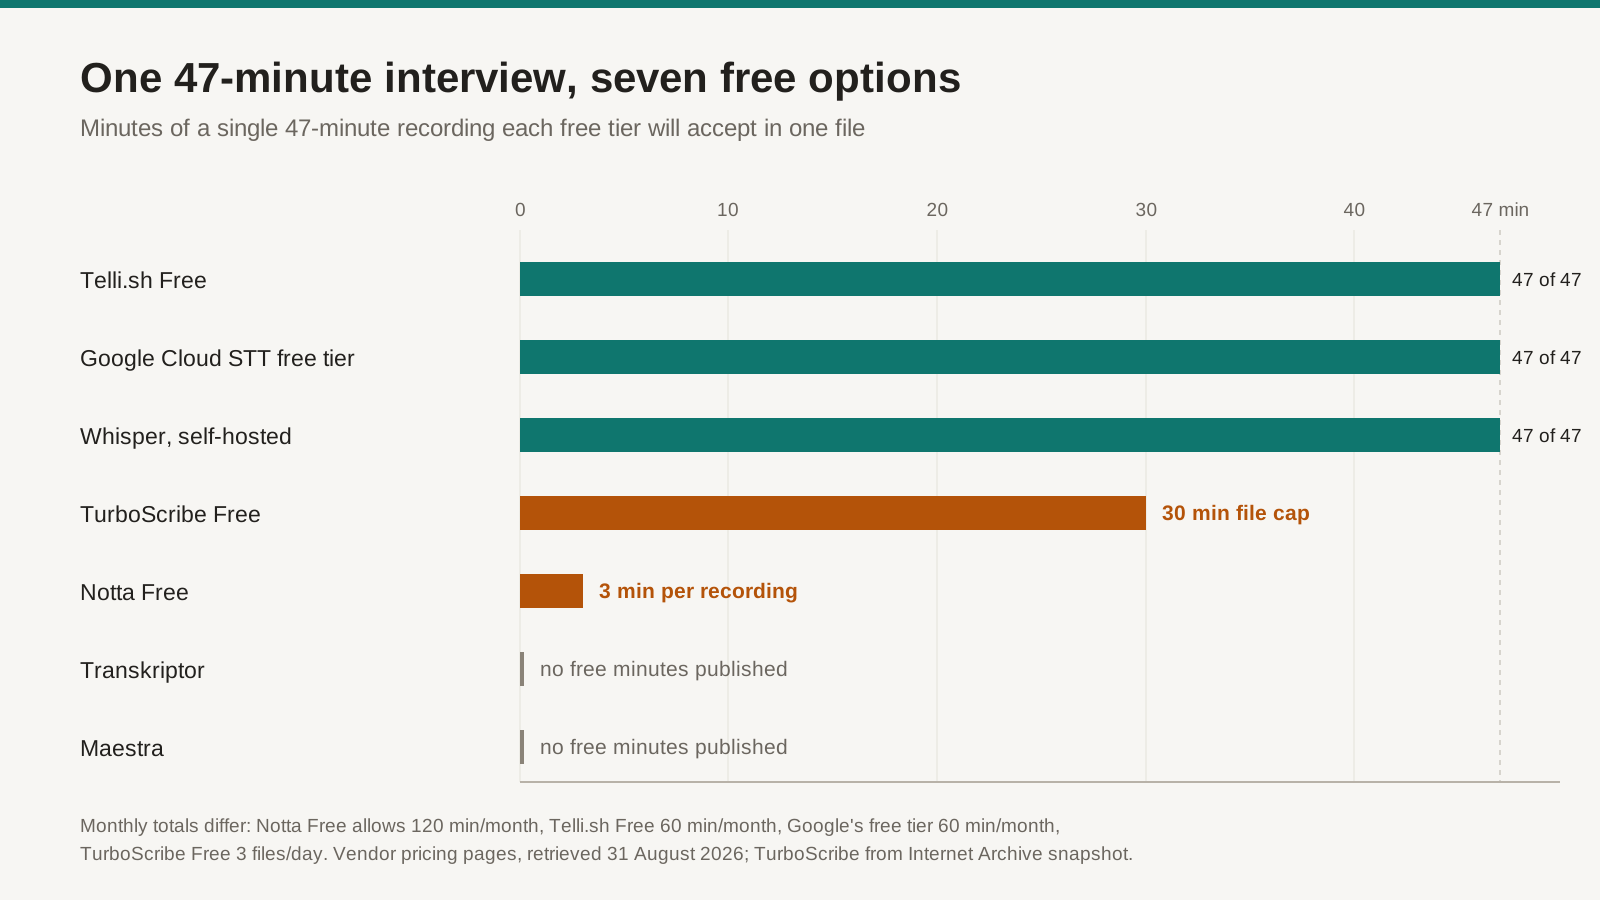
同一根轴,同一个单位:一场 47 分钟采访中,能作为单个文件被接收的分钟数。月度额度各不相同,标注在图表下方。
Notta 的 120 分钟是真的,把采访卡死的是那 3 分钟上限
认真读一遍 Notta 的免费套餐,其实并不小气:每月 120 分钟转写、50 次文件上传、10 次 AI 摘要、1,000 点 AI 额度、不需要信用卡。对语音备忘和短通话来说,这是一份真正好用的额度,而且月度分钟数比多数竞品给得都多。
然后把同一张对比表往下再读一行:Free 档是单条录音最长转写 3 分钟,Pro 档是 5 小时。你的 120 分钟,是 40 段各自独立的三分钟碎片。一场 47 分钟的采访,根本进不了这个系统。
关键在这里,而且它能推广到任何一家厂商之外:免费套餐不是一个数字,而是三道上限,营销永远引用其中最高的那一个。 每月分钟数是标题。单文件分钟数决定你的采访能不能被转写。每天文件数决定你能不能在周日一口气处理完一周的田野素材。
TurboScribe 把同一笔交易反了过来。它的免费套餐根本没有月度分钟池——每天 3 份转写,每份最长 30 分钟,一次只能传一个文件,排队优先级较低。每天三个 30 分钟文件就是 90 分钟音频,两天就远超 Notta 的月度 120 分钟。可 47 分钟的采访仍然放不进去,因为卡住你的还是单文件上限。你只能把录音切开,而每切一刀,就在切口处丢掉说话人的连续性。
Transkriptor 和 Maestra 用另一种方式化解这份张力:它们基本不设免费套餐。Transkriptor 公布的套餐从 Lite 起步,每月 $9.99 含 300 分钟转写,往上是 Pro,每月 $19.99 含 2,400 分钟(按年付 $99.99,折合每月 $8.33)。Maestra 卖按量付费的额度,每 60 分钟 $12,Lite 档每月 $23 含 180 分钟。两家都列了印尼语;Maestra 的语言表把印尼语标为在转写、翻译、配音和实时四项上都支持。两家都没有公布可循环的免费额度——这本身也是一种诚实。
印尼语在 8 月 7 日确实变好了,但只在一条路径上
这个月印尼语的语音识别真的发生了一件事,而几乎所有写「AI 转写工具」的文章都没提。
2026 年 8 月 7 日,Deepgram 发布了改进的 Nova-3 单语模型,并新增了亚美尼亚语。这份更新日志具体得不像厂商公告。在 Batch models 下面:泰米尔语和印尼语。在 Streaming models 下面:泰米尔语和白俄罗斯语。
印尼语出现在其中一份名单里,另一份里没有。
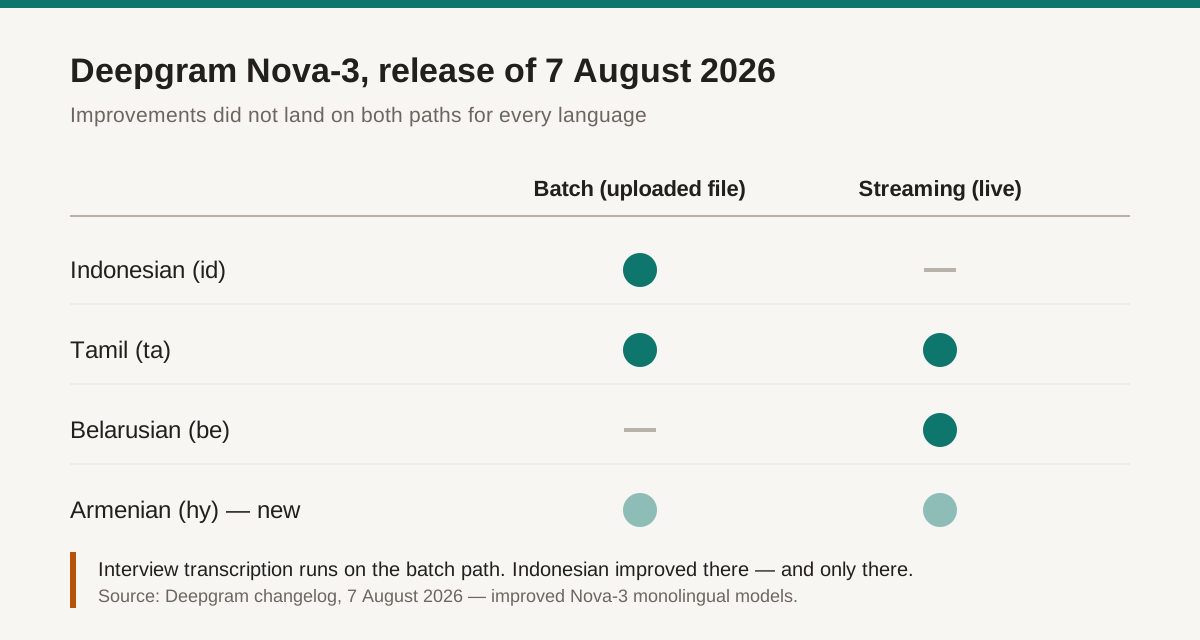
同一次发布,在批处理上改进了印尼语,在流式上改进了白俄罗斯语。「印尼语支持有改进」不是一个事实,而是两个。来源:Deepgram 更新日志,2026 年 8 月 7 日。
这个区分正好落在采访工作上。批处理是上传文件走的那条路:引擎能看到整段录音,能用双向的上下文,也不必和实时音频缓冲赛跑。流式是实时字幕走的那条路。如果你先录采访、事后上传,你走的就是批处理,而这正是印尼语这个月变好的那条路。如果你指望的是采访进行中就有准确的印尼语实时字幕,那个模型在 8 月 7 日没有变。
这个论点的完整版我们写在语音识别语言覆盖里「支持」到底藏了什么里,因为这个模式在整个行业反复出现:一门语言不是「支持」或「不支持」,而是在某条路径上、某种模式下、某个质量档位上、截至某个日期被支持。就采访转写而言,好消息是:你需要的那条路,正好就是变好的那条。
没人公布印尼语的准确率基准,所以你得自己当基准
写一份诚实的对比,最难受的部分就在这里:我们给不出印尼语的 WER 表,因为不存在可信的公开数据。
Open ASR 排行榜是这个领域最接近中立记分牌的东西,而它的多语言标签页在 2026 年 8 月 28 日之前只覆盖欧洲语言——那天 Hugging Face 与 Voice Arena 把印地语加了进来,作为第一门全球南方语言。本土市场就有约 2.8 亿人的印尼语,仍然不在上面。厂商发布英语的准确率数据,对别的语言保持沉默。
Whisper 自身的结构也透着同样的不对称。OpenAI 的分词器声明了 100 个语言 token,印尼语排在那张表的第 17 位——不算差,稳稳领先名单上的大多数,但和英语、中文、西班牙语背后的数据量根本不在一个量级。一个被声明的 token 不是质量保证,它只是表明模型会尝试这门语言。
所以诚实的操作结论是:对印尼语来说,基准就是你自己的音频。 不是厂商的演示文件,不是排行榜,也不是测评站的星级。是你的录音设备、你的房间、你受访者的地方口音、你所在行业的词汇。这听上去像是在推卸责任,直到你发现认真做一遍大概只要二十分钟。
五分钟测试:给任何人付钱之前,先跑这一遍
从一段真实采访里截出五分钟——最好是有两个说话人、有背景噪声、并且至少出现三个专有名词的那一段。把它送进每一个候选工具。然后按下面这个顺序检查五件事。
- 数清专有名词的错误。 人名、公司名、地名、产品术语。这是印尼语 ASR 稳定翻车的地方,也是错误对下游伤害最大的地方,因为一个错的名字会悄无声息地渗进你之后生成的每一份摘要和每一句引用。五分钟里错五个,整场采访大约就是 47 个。
- 专门去看那些语言混用的句子。 找一句英语词嵌在印尼语从句里的话,看看工具吐出了什么。对专业场景的印尼语音频来说,这是预测力最强的单项测试,也是没有任何厂商页面会谈的一项。
- 在第五分钟核对说话人标签,不是第一分钟。 说话人分离在开头几秒通常看起来完美。真正要紧的是:在第一次插话、抢话或长停顿之后,说话人 A 还是不是说话人 A。
- 看有没有你真的能用的时间戳。 只要你以后有可能需要拿引用去比对音频,你就需要导出文件里带行级时间戳,而不只是网页播放器里有。记者和做质性研究的人应当把这一条当成硬性要求。
- 把文件导出来,换个地方打开。 TXT、DOCX、SRT、VTT——你的工作流需要哪种就哪种。免费套餐最常在这一步停住,而一份拿不出工具的文字稿是演示,不是记录。
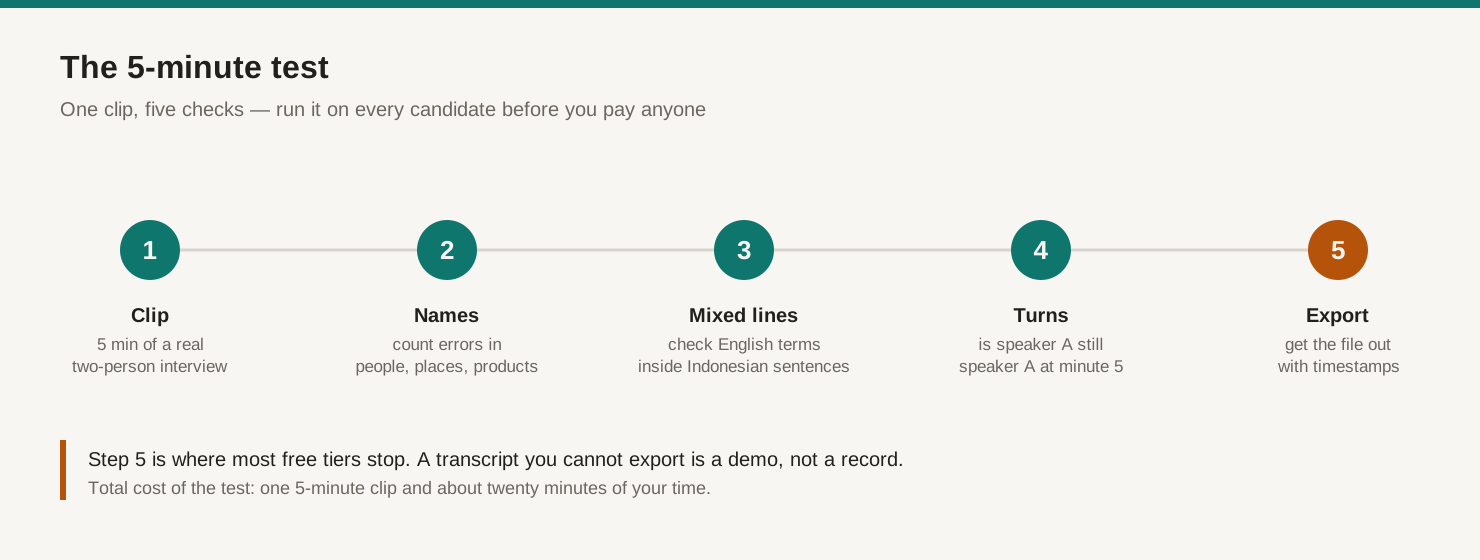
这五项检查,按真实评估中撞上它们的顺序排列。
如果你想知道选完工具之后的那套流程——在相信摘要之前先复查文字稿、把引用牢牢绑回原始音频——我们在把采访音频变成可复查的文字稿和摘要里单独写过。
印尼语采访真正翻车的地方,是句子中间那个英语词
职业场景里的印尼语不是单语的。「Nanti kita follow up setelah meeting dengan tim product」不是坏掉的印尼语,那就是雅加达的产品经理说话的样子,招聘、咨询和创业者大体也这么说。任何把英语片段揉烂的文字稿,揉烂的恰恰是你的笔记赖以成立的那些术语。
这是这个品类里最难的一件事,也值得弄清楚它为什么难。多数语音引擎每次请求只跑一个单语模型。你把语言设成印尼语,模型就在印尼语音系和印尼语词表上最强——这意味着一个在句中出现的英语词,要么被音译成一个长得像印尼语的东西,要么被丢掉。把语言设成英语,只是把伤害翻个面。多语言或代码切换模式确实存在,但它们的覆盖比单语名单窄得多:截至 2026 年 8 月,Deepgram 的 Nova-3 逐个记录了 58 种单语语言,代码切换恰好 10 种。
有两个实用的缓解办法,成本都很低。第一,把源语言明确设成印尼语,别开自动检测——自动检测要从整个文件里上下文最贫乏的那几秒押下一个判断,一旦押错,下游所有环节会同时变差。第二,如果工具提供自定义词表或关键词列表,在跑之前就把你反复出现的英语术语和专有名词填进去,而不是跑完再补。
不妨把它叫作 gado-gado 问题:这份音频天生就是拌在一起的,而每一个引擎都想把它当成一道菜端上来。
会写代码的话,转写比一杯咖啡还便宜
如果你愿意碰 API,免费套餐的对比会整个换一副样子——就算你最后决定不走这条路,这些数字也值得知道。
OpenAI 的 gpt-4o-transcribe 每分钟 $0.006,mini 版每分钟 $0.003。你那场 47 分钟的采访花 28 美分,用 mini 是 14 美分。Google Cloud Speech-to-Text 每月前 60 分钟免费,之后开启数据日志每分钟 $0.016、关闭为 $0.024,并在 asia-southeast1 区域的 chirp 和 chirp_2 两个模型上都列出了 id-ID。Whisper 是 MIT 许可,除了你自己的硬件不花一分钱。
在这个价位上,识别本身几乎是免费的。你真正从消费级产品那里买到的,是围着它的一切:上传界面、说话人标签、时间戳、编辑器、跨历史采访的搜索、摘要、导出,以及半年后这份记录仍然存在的那个地方。
这就是自建还是购买这道题的诚实框架。如果你一年做三场采访、又能跑 Python 脚本,那就跑脚本。如果你一周做三场,还得翻出三月份的某句引用,那你要买的就不是识别——你要买的是一套带识别功能的档案系统。
没有任何免费套餐会替你做的事
公平起见,下面这些限制适用于桌面上的每一个选项,包括我们自己。
免费套餐不会给你可靠的说话人分离。它是整条流水线里比较贵的环节之一,在这个品类里被普遍留给付费档。如果两人分离对你的工作不可或缺,就把它列进预算,别指望白拿。
免费套餐不承诺保留。存储要花钱,免费存储是一份可以随政策变更收回的善意。重要的东西都导出来,自己留一份——这同时也是那个「厂商锁定」问题的答案,而人们通常要到想走的那天才会问它。
免费套餐修不好你那些特定说话人的准确率下限。地方口音、年长的受访者、电话质量的音频、大量代码切换,都会让输出变差,而任何档位都改变不了底层模型见过多少你这类音频。多付钱买到的是分钟数和功能,不是另一个识别器。
而且没有任何工具,免费的或付费的,能省掉那一遍人工复查。建立在未经复查的文字稿之上的 AI 摘要,会把里面每一个错误都继承下来——自信满满,而且看不出来。
结论:该比的单位不是分钟,是采访场次
这个品类里的每一个免费套餐都在宣传一段时长。对采访工作来说,那是错的单位,因为时间只有在连成一整块的时候才算数。被切成三分钟一段的 120 分钟,对记者的价值低于不被打断的 30 分钟;而这两者的价值又都低于能完整装下一整场对话、说话人标签还完好的 60 分钟。
所以在比较工具的时候,请把每一个免费套餐都换算成对你唯一重要的那种货币:这个工具能把我实际的采访,一场不切地从头转到尾,转下来几场? 对好几个知名的免费套餐来说,诚实的答案是零,而价格页不会告诉你这一点。
识别这一层正在变成一件大路货,朝着每分钟三分之一美分走。对印尼语来说仍然稀缺的,是一份能搜索、能修正、能引用、下个季度还找得到的记录。
Telli.sh 在这里的位置: 我们是上面那几个选项中的一个,而且会把话说具体。Telli.sh 的免费套餐是每月 60 分钟——标题上的分钟数比 Notta 的 120 少,但我们刻意没有用「单条录音 3 分钟」这样的限制把它切碎,所以一整场采访可以作为一个文件传进来。你会拿到印尼语文字稿、译成 44 种目标语言中任意一种的译文、由文字稿生成的 AI 摘要,以及一个提供 15 种语言、其中包含印尼语的界面。超过每月 60 分钟之后它就是付费产品;如果你的量很小又能跑脚本,走 API 的确更便宜。请像对待任何其他工具那样,也对我们跑一遍五分钟测试。
来源
- Deepgram,"Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian",更新日志日期为 2026 年 8 月 7 日 —— 泰米尔语与印尼语的批处理模型改进,泰米尔语与白俄罗斯语的流式模型改进,亚美尼亚语(
hy)两条路径均新增。 - Hugging Face 与 Voice Arena,"The Open ASR Leaderboard Adds Its First Global South Language",2026 年 8 月 28 日 —— 印地语成为该排行榜第一门全球南方语言。
- Notta 价格页,2026 年 8 月 31 日查阅 —— 免费套餐每月 120 分钟、单条录音最长 3 分钟、每月 50 次文件上传、每月 10 次 AI 摘要;Pro 按年付合每月 $8.17,每月 1,800 分钟。
- Transkriptor 价格页,2026 年 8 月 31 日查阅 —— Lite 每月 $9.99(300 分钟)、Pro 每月 $19.99(2,400 分钟,按年付 $99.99)、Team 每席位每月 $30(每席位 3,000 分钟)。
- Maestra 价格页与 Maestra 支持语言,2026 年 8 月 31 日查阅 —— 按量付费每 60 点额度 $12,Lite 每月 $23 含 180 分钟;印尼语在转写、翻译、配音和实时项下均有列出。
- 互联网档案馆抓取的 TurboScribe 价格页 —— 免费套餐每天 3 份转写,单文件上限 30 分钟,一次只能传一个文件;Unlimited 每月 $10,按年付 $120,10 小时文件。实时页面对自动抓取返回 HTTP 403,请把这些数字当作方向性参考,并到站上确认。
- Google Cloud Speech-to-Text 价格页与支持语言,2026 年 8 月 31 日查阅 —— 每月前 60 分钟免费,开启数据日志每分钟 $0.016、关闭为每分钟 $0.024;
asia-southeast1区域的chirp与chirp_2上均有id-ID。 - OpenAI API 价格页,2026 年 8 月 31 日查阅 ——
gpt-4o-transcribe每分钟 $0.006,gpt-4o-mini-transcribe每分钟 $0.003。 - OpenAI Whisper,MIT 许可;其分词器的
LANGUAGES表声明了 100 门语言,印尼语(id)排在第 17 位,2026 年 8 月 31 日查阅。