120 minutos grátis que não seguram uma entrevista: o que a transcrição de IA gratuita realmente entrega em indonésio
O plano gratuito da Notta concede 120 minutos de transcrição por mês e limita cada gravação a 3 minutos. O TurboScribe dá 3 arquivos por dia com teto de 30 minutos. A API do Google entrega 60 minutos gratuitos e nenhuma interface. Em 7 de agosto de 2026, a Deepgram lançou um modelo indonésio melhorado — só no caminho em lote. Uma comparação testada dos planos gratuitos em que um jornalista, um pesquisador ou um entrevistador de RH na Indonésia realmente esbarra, e os limites que nenhum deles anuncia.
Você tem uma entrevista de 47 minutos parada no celular. Uma fonte em Surabaia, gravada hoje de manhã, quase toda em indonésio com a pitada de costume de inglês — deadline, stakeholder, follow up. Você precisa da transcrição hoje e preferiria muito não pagar por ela.
Então pesquisa, cai numa ferramenta que anuncia 120 minutos gratuitos de transcrição por mês e cria a conta. Seu arquivo de 47 minutos cabe folgado dentro dos 120. Aí o upload falha, e enterrado na tabela de comparação de planos está um segundo número que ninguém coloca na manchete: transcrição máxima por gravação, 3 minutos.
Esse é o formato da categoria inteira. Planos gratuitos são anunciados pelo número que soa mais generoso e limitados por um número diferente três linhas abaixo. Este texto é a comparação que gostaríamos que existisse: o que cada plano gratuito realmente oferece a uma entrevista em indonésio, o que ele recusa em silêncio e como testar qualquer um deles em cinco minutos antes de se comprometer.
Resumo rápido
- Planos gratuitos têm três tetos independentes — minutos por mês, minutos por arquivo e arquivos por dia — e o que quebra entrevistas é quase sempre o limite por arquivo, não o total mensal.
- O reconhecimento de fala em indonésio melhorou de verdade neste mês: em 7 de agosto de 2026 a Deepgram lançou um modelo indonésio Nova-3 atualizado, mas só no caminho em lote, não em streaming. Subir uma gravação se beneficia; legendar ao vivo, não.
- Nenhum ranking público mede a precisão em indonésio. O Open ASR Leaderboard incluiu seu primeiro idioma do Sul Global em 28 de agosto de 2026, e foi o híndi. Enquanto isso não mudar, seu próprio clipe de teste de 5 minutos é o único benchmark que descreve o seu áudio.
Os planos gratuitos, lado a lado
Cada número abaixo vem da própria página de preços ou da documentação publicada pelo fornecedor, consultadas em 31 de agosto de 2026. O trabalho de referência é uma entrevista de 47 minutos com duas pessoas, porque é o arquivo que as pessoas realmente têm.
| Ferramenta | Plano gratuito | Arquivo único mais longo, no grátis | Indonésio | Porta de entrada paga |
|---|---|---|---|---|
| Notta | 120 min/mês, 50 uploads/mês, 10 resumos de IA/mês, 1 assento | 3 minutos | Não confirmado | Pro US$ 8,17/mês na cobrança anual — 1.800 min/mês, arquivos de 5 horas |
| TurboScribe | 3 transcrições por dia, prioridade menor na fila | 30 minutos | Sim | Unlimited US$ 10/mês, US$ 120 na cobrança anual — arquivos de 10 horas |
| Transkriptor | Nenhum minuto mensal gratuito publicado | — | Sim | Lite US$ 9,99/mês — 300 min/mês |
| Maestra | Nenhum minuto mensal gratuito publicado | — | Sim | Pagamento por uso US$ 12 a cada 60 minutos; Lite US$ 23/mês — 180 min/mês |
| Google Cloud Speech-to-Text | 60 min/mês, depois US$ 0,016/min | Sem teto prático | Sim, id-ID | US$ 0,016/min com registro de dados, US$ 0,024/min sem |
| API de transcrição da OpenAI | Nenhum | Sem teto prático | Sim | US$ 0,006/min (gpt-4o-transcribe), US$ 0,003/min (mini) |
| Whisper, auto-hospedado | Ilimitado, licença MIT | Seu hardware | Sim | Software gratuito, o tempo de GPU é seu |
| Telli.sh | 60 min/mês | Até o limite da franquia | Sim | Planos pagos começam em 300 min/mês |
Fontes: a página de preços de cada fornecedor, consultada em 31 de agosto de 2026; a documentação de idiomas suportados do Google para id-ID; a tabela de preços da API publicada pela OpenAI. A página de preços ao vivo do TurboScribe bloqueia coleta automatizada, então seus números vêm do instantâneo dessa página no Internet Archive e batem com a forma como o plano é descrito hoje em outros lugares — confirme antes de depender deles. Em 31 de agosto de 2026 não conseguimos recuperar da Notta uma lista por idioma, por isso o suporte a indonésio está marcado como não confirmado em vez de presumido.
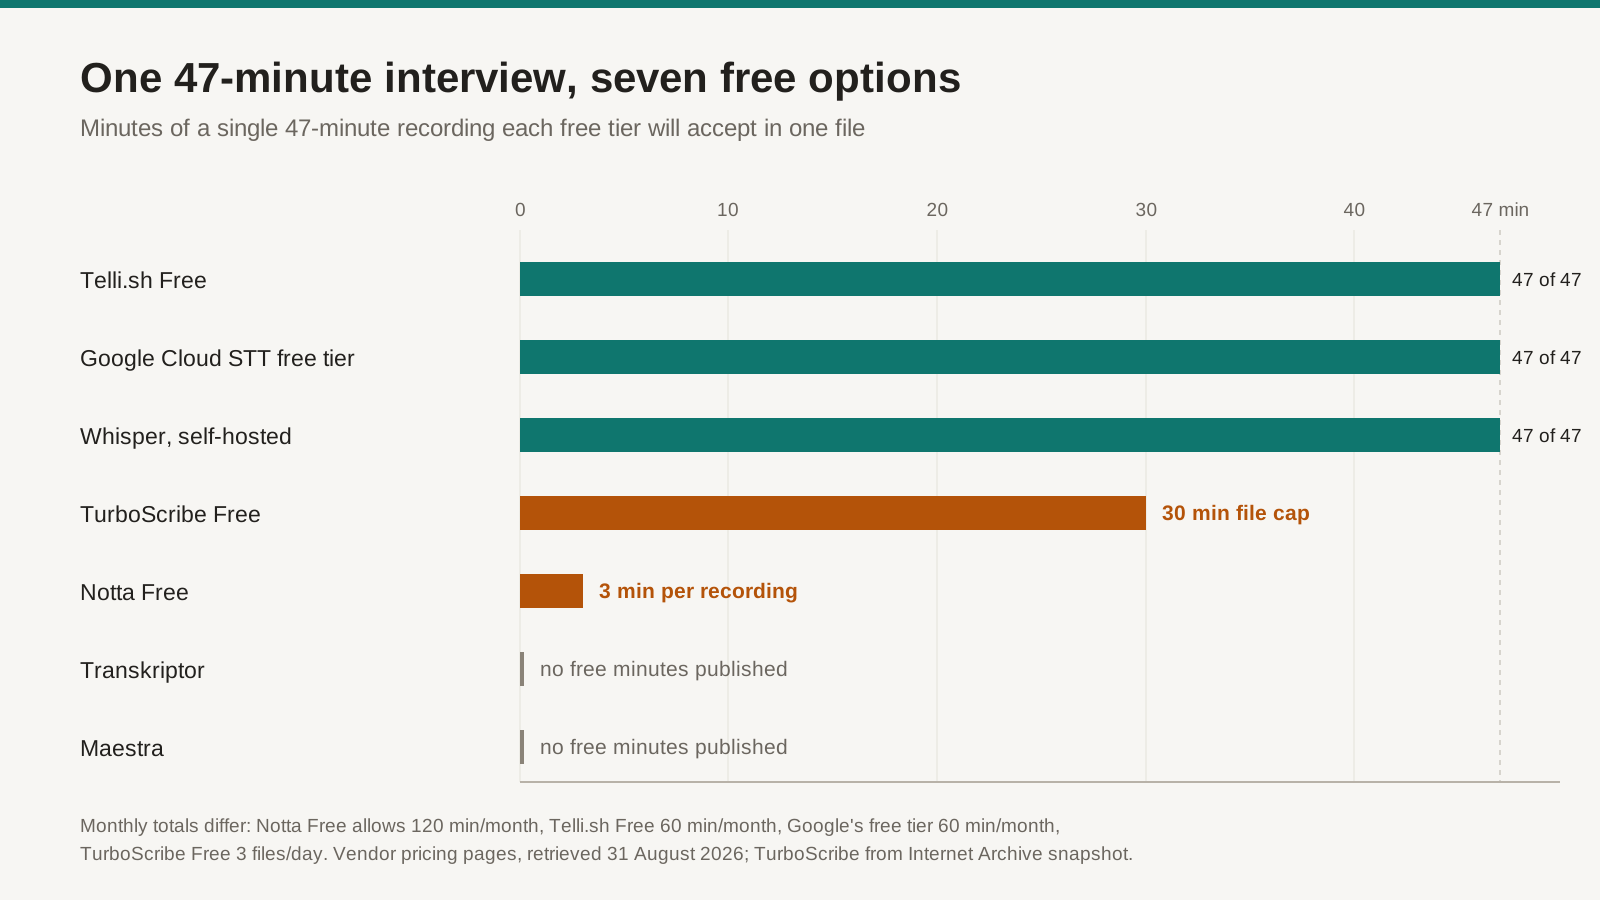
Uma unidade só em um eixo só: minutos de uma entrevista de 47 minutos aceitos em um único arquivo. As franquias mensais são diferentes e estão anotadas abaixo do gráfico.
Os 120 minutos da Notta são reais. Quem quebra a entrevista é o teto de três minutos.
Leia o plano gratuito da Notta com atenção e ele não é mesquinho — 120 minutos de transcrição por mês, 50 uploads de arquivo, 10 resumos de IA, 1.000 créditos de IA, sem cartão de crédito. Para recados de voz e ligações curtas é uma franquia realmente útil, e são mais minutos mensais do que a maioria dos concorrentes dá de graça.
Aí leia uma linha mais abaixo na mesma tabela de comparação: transcrição máxima por gravação, 3 minutos no Free, contra 5 horas no Pro. Seus 120 minutos são 40 fragmentos separados de três minutos. Uma entrevista de 47 minutos não consegue nem entrar no sistema.
O ponto é este, e ele vale além de qualquer fornecedor: um plano gratuito não é um número, são três tetos, e o marketing cita o mais alto. Minutos por mês é a manchete. Minutos por arquivo é o que decide se sua entrevista é transcritível. Arquivos por dia é o que decide se você consegue processar uma semana de campo num domingo.
O TurboScribe inverte a mesma troca. O plano gratuito dele não anuncia franquia mensal de minutos nenhuma — três transcrições por dia, cada uma de até 30 minutos, um arquivo por vez, com prioridade menor na fila. Três arquivos de 30 minutos por dia dão 90 minutos de áudio, bem além dos 120 mensais da Notta em dois dias. Mas uma entrevista de 47 minutos continua não cabendo, porque a restrição que aperta é de novo o limite por arquivo. Você teria de dividir a gravação, e cada corte custa a continuidade de quem fala através do corte.
Transkriptor e Maestra resolvem a tensão de outro jeito: em boa medida, não têm plano gratuito. Os planos publicados do Transkriptor começam no Lite, US$ 9,99 por mês por 300 minutos de transcrição, subindo até o Pro a US$ 19,99 por 2.400 minutos (US$ 8,33 por mês se você pagar US$ 99,99 pelo ano). A Maestra vende créditos por uso a US$ 12 a cada 60 minutos, com o Lite a US$ 23 por mês por 180 minutos. Os dois listam indonésio; a tabela de idiomas da Maestra marca indonésio como suportado para transcrição, tradução, locução e tempo real igualmente. Nenhum dos dois publica franquia gratuita recorrente, o que é um tipo próprio de honestidade.
O indonésio ficou mensuravelmente melhor em 7 de agosto — em exatamente um caminho
Algo real aconteceu com o reconhecimento de fala em indonésio neste mês, e quase ninguém que escreve sobre «ferramentas de transcrição com IA» mencionou.
Em 7 de agosto de 2026 a Deepgram lançou modelos monolíngues Nova-3 melhorados e adicionou o armênio. O changelog é específico de um jeito raro em anúncios de fornecedor. Em Batch models: tâmil e indonésio. Em Streaming models: tâmil e bielorrusso.
O indonésio aparece em uma lista e não na outra.
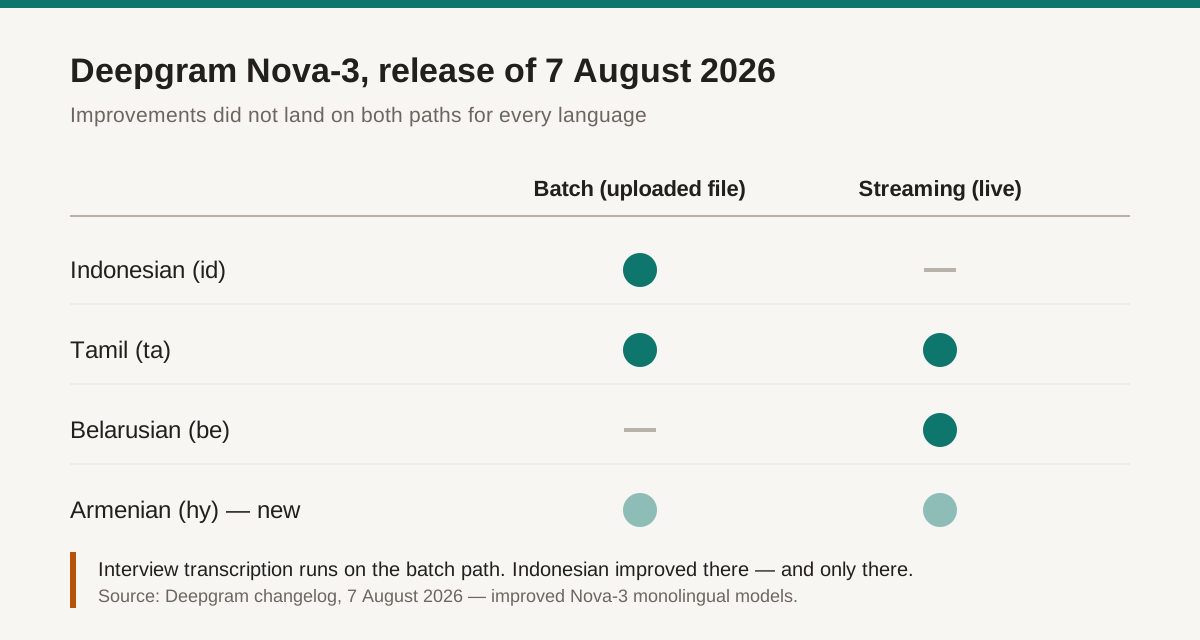
O mesmo lançamento melhorou o indonésio em lote e o bielorrusso em streaming. «Suporte melhorado para indonésio» não é um fato só. Fonte: changelog da Deepgram, 7 de agosto de 2026.
Essa distinção cai em cheio no trabalho de entrevista. Lote é o caminho que um arquivo enviado percorre — o motor vê a gravação inteira, pode usar contexto nas duas direções e não está correndo atrás de um buffer de áudio ao vivo. Streaming é o caminho das legendas ao vivo. Se você grava uma entrevista e faz o upload depois, está no caminho em lote, que é justamente o caminho em que o indonésio melhorou neste mês. Se você esperava legendas ao vivo precisas em indonésio durante a própria entrevista, aquele modelo específico não mudou em 7 de agosto.
A versão longa desse argumento escrevemos em o que a palavra «suportado» realmente esconde na cobertura de idiomas do reconhecimento de fala, porque o padrão se repete no setor inteiro: um idioma não é suportado ou não suportado, ele é suportado em um caminho, num modo, num patamar de qualidade, numa data. Para transcrição de entrevistas em particular, a boa notícia é que o caminho de que você precisa é justamente o que melhorou.
Ninguém publica benchmark de precisão em indonésio, então o benchmark tem de ser você
Aqui está a parte desconfortável de escrever uma comparação honesta: não podemos entregar uma tabela de WER para indonésio, porque nenhuma pública e confiável existe.
O Open ASR Leaderboard — o mais próximo de um placar neutro que a área tem — manteve uma aba multilíngue só com idiomas europeus até 28 de agosto de 2026, quando Hugging Face e Voice Arena adicionaram o híndi como seu primeiro idioma do Sul Global. O indonésio, com cerca de 280 milhões de pessoas no mercado de origem, ainda não está lá. Fornecedores publicam alegações de precisão para o inglês e ficam calados no resto.
A própria estrutura do Whisper sugere a mesma assimetria. O tokenizador da OpenAI declara 100 tokens de idioma, e o indonésio ocupa a posição 17 nessa tabela — respeitável, confortavelmente à frente da maior parte da lista, e muito longe do volume de dados que sustenta inglês, chinês ou espanhol. Um token declarado não é garantia de qualidade; é a afirmação de que o modelo vai tentar o idioma.
Então a conclusão operacional honesta é esta: para indonésio, o benchmark é o seu áudio. Não o arquivo de demonstração do fornecedor, não um ranking, não a nota em estrelas de um site de resenhas. Seu gravador, sua sala, o sotaque regional de quem você entrevista, o vocabulário do seu setor. Isso soa como desculpa até você perceber que fazer direito leva cerca de vinte minutos.
O teste de 5 minutos: faça antes de pagar qualquer um
Pegue uma fatia de cinco minutos de uma entrevista real — de preferência com duas vozes, ruído de fundo e pelo menos três nomes próprios. Passe por todos os candidatos. Depois cheque cinco coisas, nesta ordem.
- Conte os erros em nomes próprios. Nomes de pessoas, empresas, lugares e termos de produto. É aí que o ASR em indonésio falha de forma confiável e é aí que um erro causa o maior estrago rio abaixo, porque um nome errado se propaga em silêncio para cada resumo e cada citação que você gerar depois. Cinco erros em cinco minutos são aproximadamente 47 na sua entrevista.
- Confira especificamente as linhas com idiomas misturados. Ache uma frase em que uma palavra em inglês está dentro de uma oração em indonésio e leia o que a ferramenta produziu. É o teste isolado mais preditivo para áudio profissional em indonésio, e é o que nenhuma página de fornecedor aborda.
- Verifique os rótulos de quem fala no minuto cinco, não no minuto um. A diarização quase sempre parece perfeita nos primeiros segundos. O que importa é se o Falante A continua sendo o Falante A depois da primeira interrupção, fala sobreposta ou pausa longa.
- Procure carimbos de tempo com os quais você possa trabalhar. Se em algum momento você precisar conferir uma citação contra o áudio, precisa de carimbos de tempo por linha na exportação, não só no player web. Jornalistas e pesquisadores qualitativos deveriam tratar isso como obrigatório.
- Exporte o arquivo e abra em outro lugar. TXT, DOCX, SRT, VTT — o que o seu fluxo de trabalho exigir. É aqui que os planos gratuitos param com mais frequência, e uma transcrição que você não consegue tirar da ferramenta é uma demonstração, não um registro.
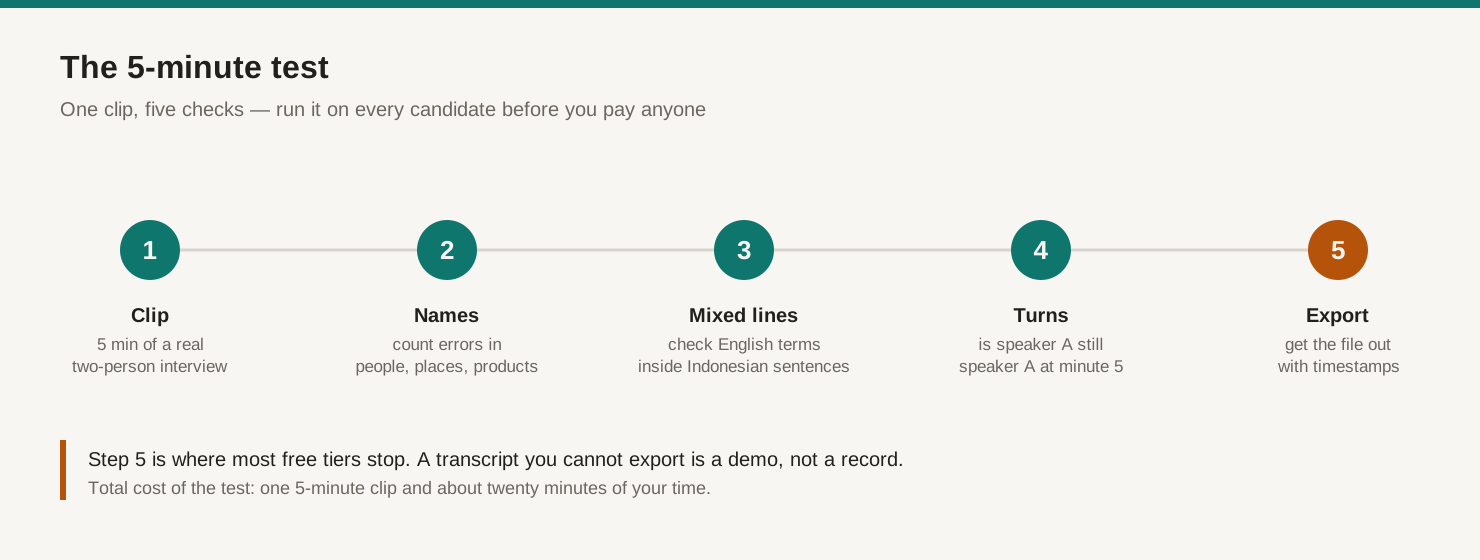
As cinco verificações, na ordem em que uma avaliação real esbarra nelas.
Se você quer o fluxo de trabalho que vem depois da escolha da ferramenta — revisar a transcrição antes de confiar no resumo, manter citações amarradas ao áudio de origem — tratamos disso à parte em transformar o áudio de uma entrevista em transcrição e resumo revisáveis.
Onde as entrevistas em indonésio realmente quebram: a palavra em inglês no meio da frase
Indonésio profissional não é monolíngue. «Nanti kita follow up setelah meeting dengan tim product» não é indonésio quebrado; é como fala um gerente de produto em Jacarta, e mais ou menos como falam também um recrutador, um consultor e um fundador de startup. Qualquer transcrição que estropie os fragmentos em inglês estropiou exatamente os termos de que suas anotações dependem.
Essa é a coisa mais difícil da categoria, e vale entender por quê. A maioria dos motores de fala roda um modelo monolíngue por requisição. Você define o idioma como indonésio, e o modelo fica mais forte na fonética e no vocabulário indonésios — o que significa que uma palavra em inglês chegando no meio da frase é transliterada em algo com forma indonésia ou simplesmente descartada. Definir o idioma como inglês só inverte o estrago. Modos multilíngues ou de code-switching existem, mas são mais estreitos que as listas monolíngues: em agosto de 2026, o Nova-3 da Deepgram documenta 58 idiomas um de cada vez e code-switching em exatamente 10.
Duas mitigações práticas, ambas baratas. Primeiro, defina o idioma de origem explicitamente como indonésio em vez de deixar a detecção automática ligada — a detecção se compromete com um palpite tirado dos segundos menos contextuais do arquivo inteiro, e um palpite errado degrada tudo o que vem depois de uma vez só. Segundo, se a ferramenta oferecer vocabulário personalizado ou lista de palavras-chave, coloque seus termos em inglês recorrentes e seus nomes próprios ali antes do processamento, não depois.
Chame isso de problema gado-gado, pelo prato indonésio em que ingredientes diferentes chegam misturados sob um molho só: o áudio é misto por projeto, e todo motor quer servi-lo como um prato único.
Se você sabe escrever código, transcrever custa menos que um café
A comparação de planos gratuitos muda de forma por completo se você estiver disposto a encostar numa API, e vale conhecer os números mesmo que decida não fazer isso.
A OpenAI cobra US$ 0,006 por minuto por gpt-4o-transcribe e US$ 0,003 por minuto pela variante mini. Sua entrevista de 47 minutos custa 28 centavos, ou 14 centavos no mini. O Google Cloud Speech-to-Text dá os primeiros 60 minutos por mês de graça, depois US$ 0,016 por minuto com registro de dados ativado e US$ 0,024 sem ele, e lista id-ID tanto no modelo chirp quanto no chirp_2 na região asia-southeast1. O Whisper tem licença MIT e não custa nada além do seu próprio hardware.
A esses preços, o reconhecimento em si é praticamente de graça. O que você compra de fato de qualquer produto de consumo é tudo o que está em volta: uma interface de upload, rótulos de quem fala, carimbos de tempo, um editor, busca nas entrevistas antigas, resumos, exportações e um lugar onde o registro ainda vai existir daqui a seis meses.
Esse é o enquadramento honesto da pergunta construir-ou-comprar. Se você faz três entrevistas por ano e sabe rodar um script em Python, rode o script. Se faz três por semana e precisa achar uma citação de março, você não está procurando reconhecimento — está procurando um arquivo organizado com reconhecimento acoplado.
O que nenhum plano gratuito vai fazer por você
Justiça é justiça, então aqui estão os limites que valem para todas as opções da mesa, a nossa inclusive.
Planos gratuitos não dão diarização confiável de quem fala. É uma das partes mais caras do processo e é rotineiramente reservada aos planos pagos em toda a categoria. Se separar duas vozes é essencial no seu trabalho, coloque isso no orçamento em vez de torcer.
Planos gratuitos não prometem retenção. Armazenamento custa dinheiro; armazenamento gratuito é uma cortesia que pode ser revogada com uma mudança de política. Exporte tudo o que importa e guarde sua própria cópia — que é também a resposta para a pergunta sobre aprisionamento a fornecedor, aquela que ninguém faz até precisar sair.
Planos gratuitos não corrigem o piso de precisão para os seus falantes específicos. Sotaques regionais, entrevistados mais velhos, áudio com qualidade de telefone e code-switching pesado degradam a saída, e nenhum nível de plano muda a exposição do modelo subjacente ao seu áudio. Pagar mais compra minutos e recursos, não um reconhecedor diferente.
E nenhuma ferramenta, gratuita ou paga, elimina a passagem de revisão. Um resumo de IA construído sobre uma transcrição não revisada herda todos os erros dela, com confiança e de forma invisível.
Em resumo: o número a comparar não são minutos, são entrevistas
Todo plano gratuito desta categoria anuncia uma quantidade de tempo. Essa é a unidade errada para trabalho de entrevista, porque tempo só importa se vier num pedaço contínuo. Cento e vinte minutos picados em fatias de três minutos valem menos para um jornalista do que trinta minutos ininterruptos, e os dois valem menos do que sessenta minutos que seguram uma conversa inteira com os rótulos de quem fala intactos.
Então, quando comparar ferramentas, converta cada plano gratuito na única moeda que importa para você: quantas das minhas entrevistas reais isto transcreve, de ponta a ponta, sem dividir o arquivo? Para vários planos gratuitos bem conhecidos, a resposta honesta é zero, e eles não vão dizer isso na página de preços.
A camada de reconhecimento é uma commodity caminhando para um terço de centavo por minuto. O que continua escasso para o indonésio é um registro que você possa consultar, corrigir, citar e ainda encontrar no próximo trimestre.
Onde o Telli.sh se encaixa: somos uma opção entre as várias acima, e vamos ser específicos sobre isso. O plano Free do Telli.sh é de 60 minutos por mês — menos minutos de manchete que os 120 da Notta, e deliberadamente não fatiados por um limite de três minutos por gravação, de modo que uma entrevista inteira entra como um arquivo só. Você recebe a transcrição em indonésio, tradução para qualquer um dos 44 idiomas de destino, um resumo de IA gerado a partir da transcrição e uma interface disponível em 15 idiomas, incluindo indonésio. Passando dos 60 minutos por mês, é um produto pago, e se o seu volume é baixo e você sabe rodar um script, o caminho da API custa genuinamente menos. Faça o teste de 5 minutos com a gente do mesmo jeito que faria com qualquer outro.
Envie a gravação de uma entrevista
Fontes
- Deepgram, "Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian", changelog datado de 7 de agosto de 2026 — modelos em lote melhorados para tâmil e indonésio, modelos de streaming melhorados para tâmil e bielorrusso, armênio (
hy) adicionado a ambos. - Hugging Face e Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 de agosto de 2026 — o híndi como primeiro idioma do Sul Global do ranking.
- Preços da Notta, consultados em 31 de agosto de 2026 — plano Free com 120 minutos/mês, máximo de 3 minutos por gravação, 50 uploads de arquivo/mês, 10 resumos de IA/mês; Pro a US$ 8,17/mês na cobrança anual com 1.800 minutos/mês.
- Preços do Transkriptor, consultados em 31 de agosto de 2026 — Lite US$ 9,99/mês (300 minutos), Pro US$ 19,99/mês (2.400 minutos, US$ 99,99/ano na cobrança anual), Team US$ 30/assento/mês (3.000 minutos por assento).
- Preços da Maestra e idiomas suportados pela Maestra, consultados em 31 de agosto de 2026 — pagamento por uso a US$ 12 a cada 60 créditos, Lite a US$ 23/mês por 180 minutos; indonésio listado para transcrição, tradução, locução e tempo real.
- Preços do TurboScribe conforme capturados pelo Internet Archive — plano gratuito de 3 transcrições diárias com teto de 30 minutos por arquivo e upload de um arquivo por vez; Unlimited a US$ 10/mês, US$ 120 na cobrança anual, arquivos de 10 horas. A página ao vivo retorna HTTP 403 a coleta automatizada; trate esses números como indicativos e confirme no site.
- Preços do Google Cloud Speech-to-Text e idiomas suportados, consultados em 31 de agosto de 2026 — primeiros 60 minutos por mês gratuitos, US$ 0,016/min com registro de dados e US$ 0,024/min sem;
id-IDemchirpechirp_2emasia-southeast1. - Preços da API da OpenAI, consultados em 31 de agosto de 2026 —
gpt-4o-transcribea US$ 0,006/minuto,gpt-4o-mini-transcribea US$ 0,003/minuto. - OpenAI Whisper, licenciado sob MIT; a tabela
LANGUAGESdo tokenizador declara 100 idiomas com o indonésio (id) na posição 17, consultada em 31 de agosto de 2026.