120 Gratisminuten, die kein einziges Interview fassen: Was kostenlose KI-Transkription auf Bahasa Indonesia wirklich leistet
Nottas Gratis-Tarif gewährt 120 Transkriptionsminuten im Monat und begrenzt eine einzelne Aufnahme auf 3 Minuten. TurboScribe gibt 3 Dateien pro Tag mit einer Obergrenze von 30 Minuten. Googles API liefert 60 Freiminuten und keine Oberfläche. Am 7. August 2026 hat Deepgram ein verbessertes Indonesisch-Modell ausgeliefert — nur auf dem Batch-Pfad. Ein geprüfter Vergleich der Gratis-Tarife, auf die Journalistinnen, Forschende und HR-Interviewer in Indonesien tatsächlich stoßen, und der Grenzen, die keiner davon bewirbt.
Auf Ihrem Telefon liegt ein 47-minütiges Interview. Eine Quelle in Surabaya, heute Morgen aufgenommen, überwiegend Bahasa Indonesia mit den üblichen englischen Einsprengseln — deadline, stakeholder, follow up. Sie brauchen das Transkript heute und würden dafür sehr ungern bezahlen.
Also suchen Sie, landen bei einem Anbieter, der 120 kostenlose Transkriptionsminuten pro Monat bewirbt, und legen ein Konto an. Ihre 47 Minuten liegen bequem unter 120. Dann scheitert der Upload, und tief in der Tarifübersicht steht eine zweite Zahl, die niemand in die Überschrift setzt: maximale Transkription pro Aufnahme, 3 Minuten.
So ist diese ganze Kategorie gebaut. Gratis-Tarife werden mit der Zahl beworben, die am großzügigsten klingt, und von einer anderen Zahl drei Zeilen tiefer begrenzt. Dieser Text ist der Vergleich, den wir uns gewünscht hätten: was jeder Gratis-Tarif einem indonesischsprachigen Interview tatsächlich gibt, was er stillschweigend verweigert, und wie Sie jeden davon in fünf Minuten prüfen, bevor Sie sich festlegen.
Kurzfassung
- Gratis-Tarife haben drei voneinander unabhängige Obergrenzen — Minuten pro Monat, Minuten pro Datei und Dateien pro Tag — und die, an der Interviews scheitern, ist fast immer das Limit pro Datei, nicht das Monatskontingent.
- Die indonesische Spracherkennung ist in diesem Monat messbar besser geworden: Deepgram hat am 7. August 2026 ein verbessertes Nova-3-Modell für Indonesisch ausgeliefert, aber nur auf dem Batch-Pfad, nicht im Streaming. Wer eine Aufnahme hochlädt, profitiert; wer live untertitelt, nicht.
- Kein öffentliches Leaderboard misst die Genauigkeit für Indonesisch. Das Open ASR Leaderboard hat am 28. August 2026 seine erste Sprache des Globalen Südens aufgenommen, und das war Hindi. Solange sich das nicht ändert, ist Ihr eigener 5-Minuten-Testclip der einzige Benchmark, der Ihr Audio beschreibt.
Die Gratis-Tarife nebeneinander
Jede Zahl unten stammt aus der veröffentlichten Preisliste oder Dokumentation des jeweiligen Anbieters, abgerufen am 31. August 2026. Referenzaufgabe ist ein 47-minütiges Interview mit zwei Personen, weil das die Datei ist, die man tatsächlich hat.
| Tool | Gratis-Tarif | Längste Einzeldatei, gratis | Indonesisch | Kostenpflichtiger Einstieg |
|---|---|---|---|---|
| Notta | 120 Min./Monat, 50 Uploads/Monat, 10 KI-Zusammenfassungen/Monat, 1 Platz | 3 Minuten | Unbestätigt | Pro 8,17 $/Monat bei jährlicher Zahlung — 1.800 Min./Monat, 5-Stunden-Dateien |
| TurboScribe | 3 Transkripte pro Tag, niedrigere Warteschlangenpriorität | 30 Minuten | Ja | Unlimited 10 $/Monat, 120 $ jährlich — 10-Stunden-Dateien |
| Transkriptor | Keine kostenlosen Monatsminuten veröffentlicht | — | Ja | Lite 9,99 $/Monat — 300 Min./Monat |
| Maestra | Keine kostenlosen Monatsminuten veröffentlicht | — | Ja | Pay-as-you-go 12 $ pro 60 Minuten; Lite 23 $/Monat — 180 Min./Monat |
| Google Cloud Speech-to-Text | 60 Min./Monat, danach 0,016 $/Min. | Keine praktische Grenze | Ja, id-ID | 0,016 $/Min. mit Datenprotokollierung, 0,024 $/Min. ohne |
| OpenAI Transkriptions-API | Keiner | Keine praktische Grenze | Ja | 0,006 $/Min. (gpt-4o-transcribe), 0,003 $/Min. (mini) |
| Whisper, selbst gehostet | Unbegrenzt, MIT-Lizenz | Ihre Hardware | Ja | Freie Software, Ihre eigene GPU-Zeit |
| Telli.sh | 60 Min./Monat | Bis zum Kontingent | Ja | Bezahltarife starten bei 300 Min./Monat |
Quellen: die Preisseite des jeweiligen Anbieters, abgerufen am 31. August 2026; Googles Dokumentation zu unterstützten Sprachen für id-ID; OpenAIs veröffentlichte API-Preise. TurboScribes Live-Preisseite blockiert den automatisierten Abruf, deshalb stammen die Werte aus dem Snapshot des Internet Archive und decken sich mit der Beschreibung des Tarifs an anderer Stelle — prüfen Sie sie, bevor Sie sich darauf verlassen. Eine Sprachliste von Notta konnten wir am 31. August 2026 nicht abrufen, deshalb ist die Indonesisch-Unterstützung als unbestätigt markiert und nicht angenommen.
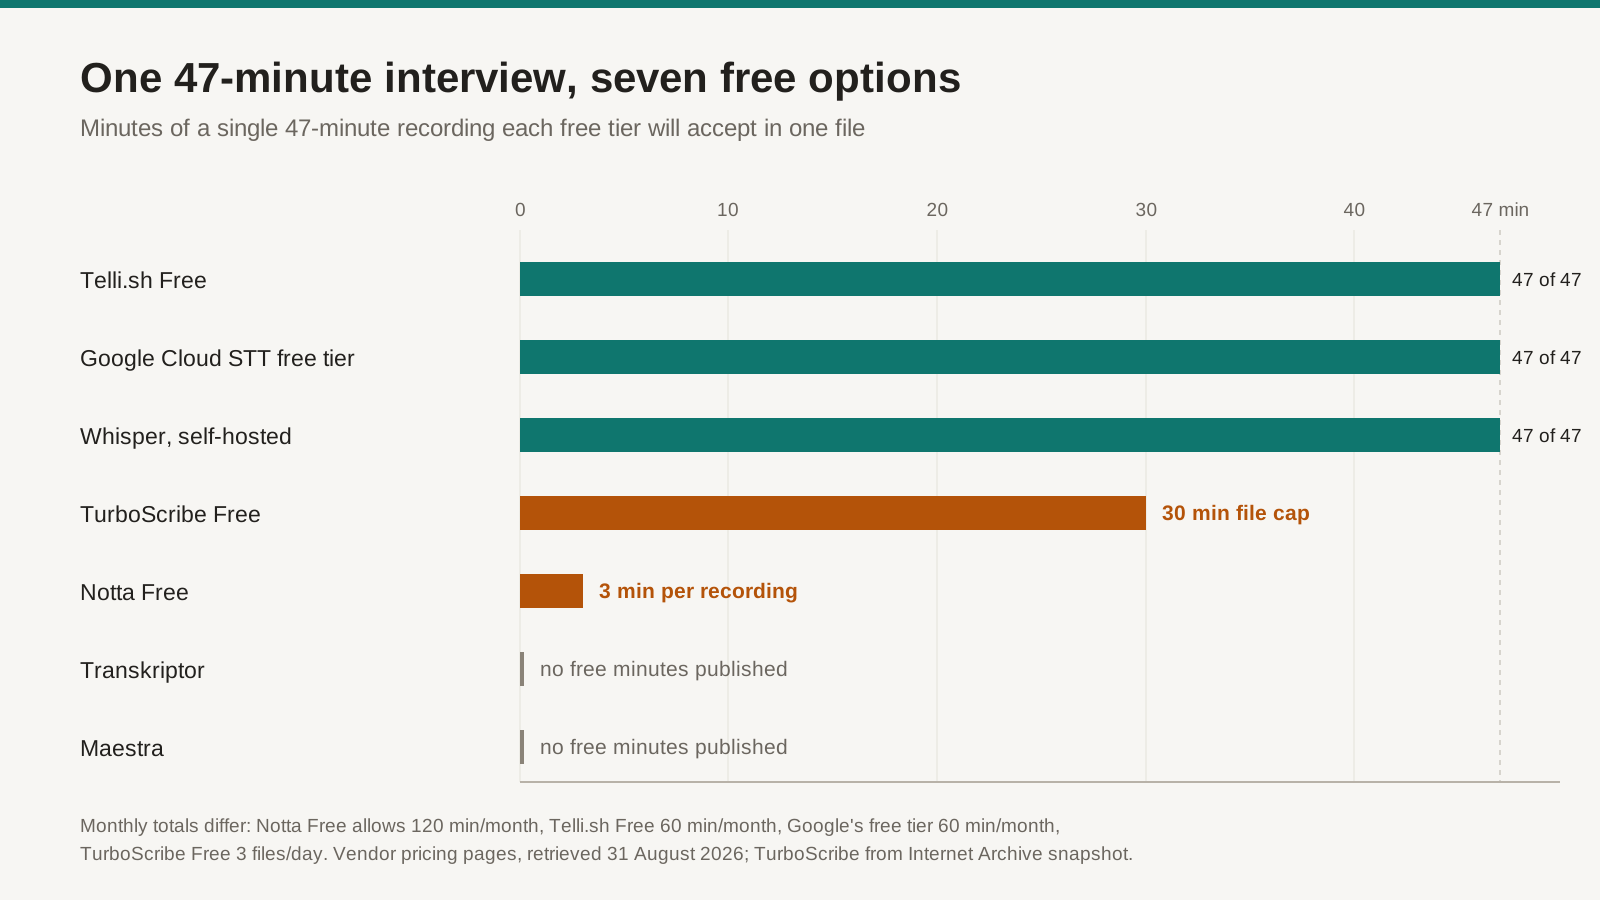
Eine Einheit auf einer Achse: Minuten eines 47-minütigen Interviews, die in einer einzigen Datei angenommen werden. Die Monatskontingente unterscheiden sich und stehen unter dem Diagramm.
Nottas 120 Minuten sind echt. Die Drei-Minuten-Grenze ist das, woran das Interview scheitert.
Wer den Gratis-Tarif von Notta genau liest, findet ihn nicht knauserig — 120 Transkriptionsminuten im Monat, 50 Datei-Uploads, 10 KI-Zusammenfassungen, 1.000 KI-Credits, keine Kreditkarte. Für Sprachnotizen und kurze Telefonate ist das ein wirklich brauchbares Kontingent, und es sind mehr Monatsminuten, als die meisten Wettbewerber verschenken.
Dann lesen Sie eine Zeile tiefer in derselben Vergleichstabelle: maximale Transkription pro Aufnahme, 3 Minuten im Gratis-Tarif, gegenüber 5 Stunden bei Pro. Ihre 120 Minuten sind 40 einzelne Drei-Minuten-Fragmente. Ein 47-minütiges Interview kommt gar nicht erst ins System.
Der Punkt lässt sich über jeden einzelnen Anbieter hinaus verallgemeinern: Ein Gratis-Tarif ist nicht eine Zahl, sondern drei Obergrenzen, und das Marketing nennt jeweils die höchste. Minuten pro Monat ist die Schlagzeile. Minuten pro Datei entscheidet, ob Ihr Interview überhaupt transkribierbar ist. Dateien pro Tag entscheidet, ob Sie eine Woche Feldarbeit an einem Sonntag abarbeiten können.
TurboScribe dreht denselben Handel um. Der Gratis-Tarif bewirbt gar kein Monatskontingent — drei Transkripte pro Tag, jeweils bis zu 30 Minuten, eine Datei zur Zeit, mit niedrigerer Warteschlangenpriorität. Drei 30-Minuten-Dateien am Tag sind 90 Minuten Audio, also innerhalb von zwei Tagen deutlich mehr als Nottas 120 Monatsminuten. Ein 47-minütiges Interview passt trotzdem nicht, weil erneut das Limit pro Datei bindet. Sie müssten die Aufnahme teilen, und jede Teilung kostet Sie die Sprecherkontinuität über den Schnitt hinweg.
Transkriptor und Maestra lösen die Spannung anders: Sie haben schlicht meist keinen Gratis-Tarif. Transkriptors veröffentlichte Tarife beginnen bei Lite, 9,99 $ im Monat für 300 Transkriptionsminuten, und reichen bis Pro für 19,99 $ mit 2.400 Minuten (8,33 $ im Monat, wenn Sie 99,99 $ für das Jahr zahlen). Maestra verkauft Pay-as-you-go-Credits zu 12 $ pro 60 Minuten, mit Lite für 23 $ im Monat und 180 Minuten. Beide führen Indonesisch; Maestras Sprachtabelle markiert Indonesisch für Transkription, Übersetzung, Voiceover und Echtzeit gleichermaßen als unterstützt. Keiner der beiden veröffentlicht ein wiederkehrendes Gratiskontingent, was auf seine Art auch ehrlich ist.
Indonesisch wurde am 7. August messbar besser — auf genau einem Pfad
Mit der indonesischen Spracherkennung ist in diesem Monat etwas Reales passiert, und fast niemand, der über „KI-Transkriptionstools" schreibt, hat es erwähnt.
Am 7. August 2026 hat Deepgram verbesserte einsprachige Nova-3-Modelle veröffentlicht und Armenisch ergänzt. Das Changelog ist auf eine Weise präzise, wie es Anbieterankündigungen selten sind. Unter Batch models: Tamil und Indonesisch. Unter Streaming models: Tamil und Belarussisch.
Indonesisch steht in der einen Liste und nicht in der anderen.
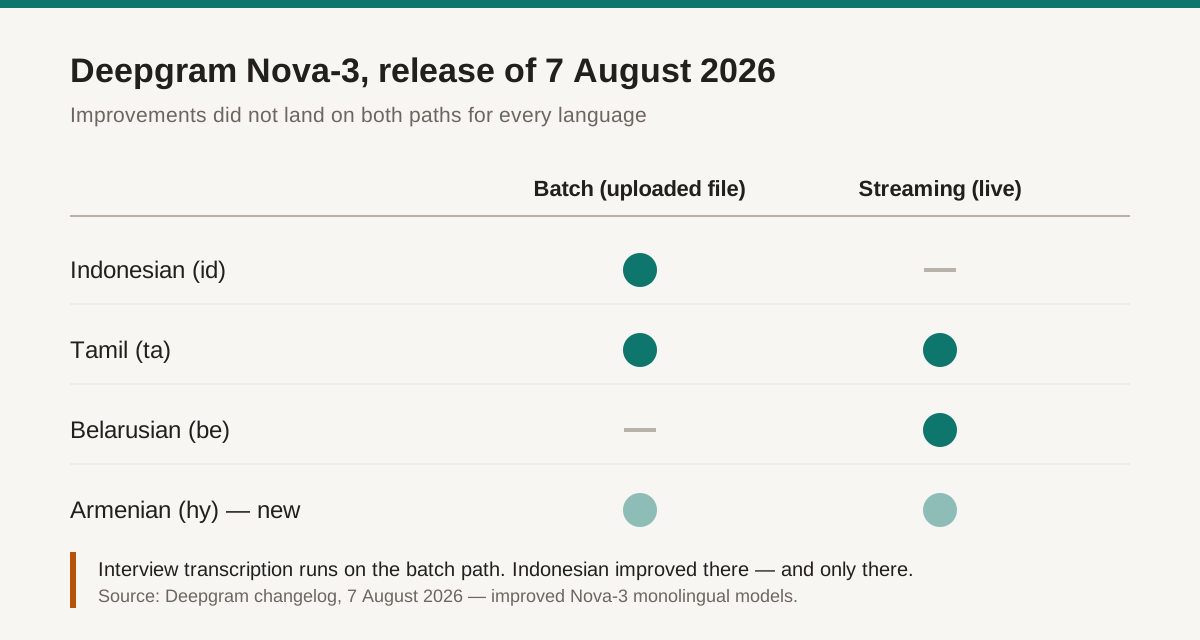
Dasselbe Release verbesserte Indonesisch im Batch und Belarussisch im Streaming. „Verbesserte Indonesisch-Unterstützung" ist nicht eine einzelne Tatsache. Quelle: Deepgram-Changelog, 7. August 2026.
Dieser Unterschied trifft die Interviewarbeit direkt. Batch ist der Pfad einer hochgeladenen Datei — die Engine sieht die gesamte Aufnahme, kann Kontext aus beiden Richtungen nutzen und rennt keinem Live-Audiopuffer hinterher. Streaming ist der Pfad von Live-Untertiteln. Wenn Sie ein Interview aufnehmen und danach hochladen, sind Sie auf dem Batch-Pfad — also genau dem Pfad, auf dem Indonesisch in diesem Monat besser wurde. Wenn Sie auf präzise indonesische Live-Untertitel während des Interviews gehofft haben: Dieses Modell hat sich am 7. August nicht verändert.
Die längere Fassung dieses Arguments haben wir in was „unterstützt" bei Sprachabdeckung in der Spracherkennung tatsächlich verbirgt aufgeschrieben, denn das Muster wiederholt sich in der ganzen Branche: Eine Sprache ist nicht unterstützt oder nicht unterstützt, sie ist unterstützt auf einem Pfad, in einem Modus, auf einer Qualitätsstufe, zu einem Stichtag. Für die Interviewtranskription lautet die gute Nachricht: Der Pfad, den Sie brauchen, ist der, der besser geworden ist.
Niemand veröffentlicht einen Genauigkeits-Benchmark für Indonesisch, also müssen Sie der Benchmark sein
Hier der unangenehme Teil eines ehrlichen Vergleichs: Wir können Ihnen keine WER-Tabelle für Indonesisch geben, weil keine glaubwürdige öffentliche existiert.
Das Open ASR Leaderboard — das Nächste, was das Feld an einer neutralen Anzeigetafel hat — führte bis zum 28. August 2026 einen mehrsprachigen Tab, der nur europäische Sprachen enthielt; an diesem Tag nahmen Hugging Face und Voice Arena Hindi als erste Sprache des Globalen Südens auf. Indonesisch, mit rund 280 Millionen Menschen im Heimatmarkt, steht weiterhin nicht darauf. Anbieter veröffentlichen Genauigkeitsangaben für Englisch und schweigen sonst.
Whispers eigener Aufbau deutet auf dieselbe Asymmetrie. OpenAIs Tokenizer deklariert 100 Sprach-Token, und Indonesisch steht in dieser Tabelle an Position 17 — respektabel, deutlich vor dem Großteil der Liste und weit entfernt von der Datenmenge hinter Englisch, Chinesisch oder Spanisch. Ein deklariertes Token ist keine Qualitätsgarantie; es ist die Aussage, dass das Modell die Sprache versuchen wird.
Die ehrliche operative Schlussfolgerung lautet deshalb: Für Indonesisch ist Ihr eigenes Audio der Benchmark. Nicht die Demodatei des Anbieters, kein Leaderboard, keine Sternebewertung einer Testseite. Ihr Aufnahmegerät, Ihr Raum, der regionale Akzent Ihres Gegenübers, das Vokabular Ihrer Branche. Das klingt nach einer Ausrede, bis Sie merken, dass es sauber gemacht etwa zwanzig Minuten dauert.
Der 5-Minuten-Test: Führen Sie ihn aus, bevor Sie irgendwem Geld geben
Nehmen Sie einen fünfminütigen Ausschnitt aus einem echten Interview — idealerweise mit zwei sprechenden Personen, Hintergrundgeräuschen und mindestens drei Eigennamen. Lassen Sie ihn durch jeden Kandidaten laufen. Prüfen Sie dann fünf Dinge, in dieser Reihenfolge.
- Zählen Sie die Fehler bei Eigennamen. Namen von Personen, Unternehmen, Orten und Produktbegriffe. Genau hier scheitert die indonesische Spracherkennung verlässlich, und genau hier richtet ein Fehler den größten nachgelagerten Schaden an, weil ein falscher Name unbemerkt in jede Zusammenfassung und jedes Zitat weiterwandert, das Sie danach erzeugen. Fünf Fehler in fünf Minuten sind rund 47 in Ihrem Interview.
- Prüfen Sie gezielt die gemischtsprachigen Zeilen. Suchen Sie einen Satz, in dem ein englisches Wort innerhalb eines indonesischen Satzteils steht, und lesen Sie, was das Tool daraus gemacht hat. Das ist der aussagekräftigste Einzeltest für professionelles indonesisches Audio, und der einzige, den keine Anbieterseite behandelt.
- Kontrollieren Sie die Sprecherzuordnung bei Minute fünf, nicht bei Minute eins. Die Diarisierung sieht in den ersten Sekunden fast immer perfekt aus. Entscheidend ist, ob Sprecher A nach der ersten Unterbrechung, dem ersten Durcheinanderreden oder der ersten langen Pause noch Sprecher A ist.
- Achten Sie auf Zeitstempel, mit denen Sie arbeiten können. Wenn Sie je ein Zitat gegen das Audio prüfen müssen, brauchen Sie zeilengenaue Zeitstempel im Export, nicht nur im Webplayer. Journalistinnen und qualitativ Forschende sollten das als Pflicht behandeln.
- Exportieren Sie die Datei und öffnen Sie sie woanders. TXT, DOCX, SRT, VTT — was auch immer Ihr Arbeitsablauf braucht. Hier hören Gratis-Tarife am häufigsten auf, und ein Transkript, das Sie nicht aus dem Tool herausbekommen, ist eine Demo und kein Protokoll.
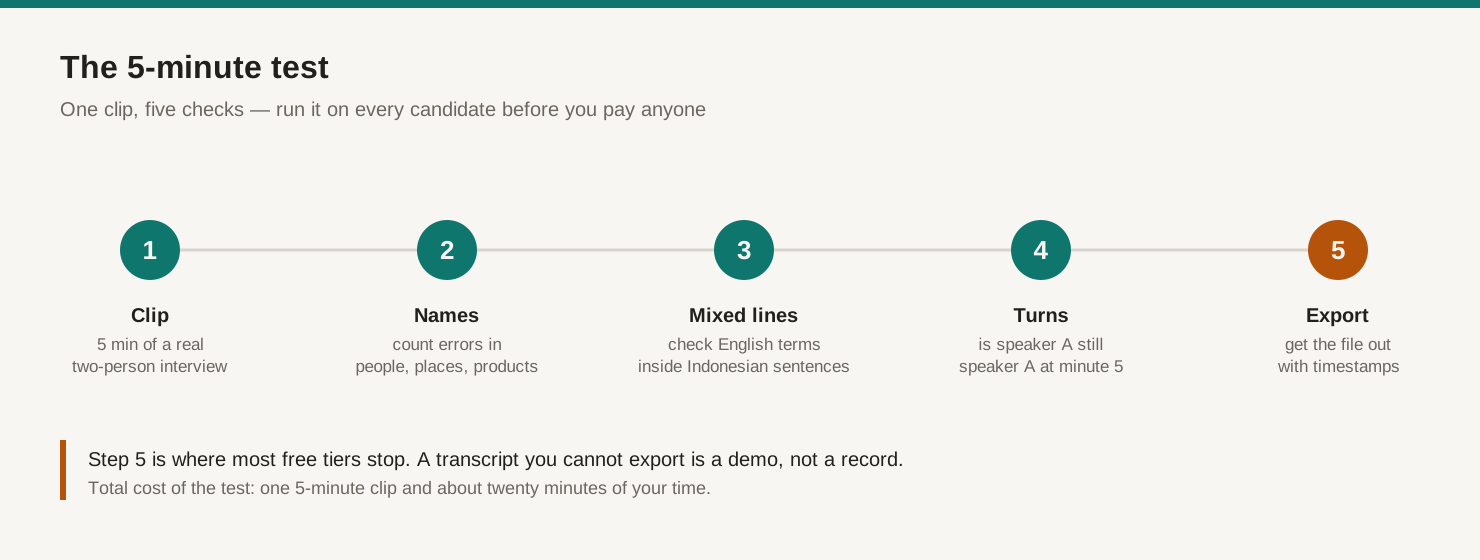
Die fünf Prüfungen, in der Reihenfolge, in der sie einer echten Bewertung begegnen.
Wenn Sie den Arbeitsablauf nach der Toolwahl suchen — das Transkript prüfen, bevor Sie der Zusammenfassung trauen, Zitate an das Quellaudio gebunden halten —, haben wir das separat behandelt: Interviewaudio in ein überprüfbares Transkript samt Zusammenfassung verwandeln.
Wo indonesische Interviews wirklich brechen: beim englischen Wort mitten im Satz
Professionelles Indonesisch ist nicht einsprachig. „Nanti kita follow up setelah meeting dengan tim product" ist kein gebrochenes Indonesisch; so spricht eine Produktmanagerin in Jakarta, und ungefähr so sprechen auch Recruiter, Beratende und Start-up-Gründerinnen. Jedes Transkript, das die englischen Fragmente verstümmelt, hat genau die Begriffe verstümmelt, auf denen Ihre Notizen beruhen.
Das ist das Schwierigste in dieser Kategorie, und es lohnt sich zu verstehen, warum. Die meisten Sprach-Engines fahren ein einsprachiges Modell pro Anfrage. Sie stellen die Sprache auf Indonesisch, und das Modell ist am stärksten bei indonesischer Phonetik und indonesischem Wortschatz — was bedeutet, dass ein englisches Wort mitten im Satz entweder in etwas Indonesisch-Förmiges transliteriert oder verworfen wird. Auf Englisch zu stellen kehrt den Schaden nur um. Mehrsprachige Modi und Code-Switching gibt es, aber sie sind schmaler als die einsprachigen Listen: Stand August 2026 dokumentiert Deepgrams Nova-3 58 Sprachen einzeln und Code-Switching in genau 10.
Zwei praktische Gegenmaßnahmen, beide billig. Erstens: Setzen Sie die Ausgangssprache explizit auf Indonesisch, statt die automatische Erkennung laufen zu lassen — die Automatik legt sich anhand der kontextärmsten Sekunden der gesamten Datei fest, und ein Fehlgriff verschlechtert alles Nachgelagerte auf einmal. Zweitens: Wenn das Tool eine eigene Wortliste oder Keyword-Funktion anbietet, tragen Sie Ihre wiederkehrenden englischen Fachbegriffe und Eigennamen vor dem Lauf ein, nicht danach.
Nennen wir das Gado-Gado-Problem, nach dem indonesischen Salat, in dem alles vermischt auf einem Teller landet: Das Audio ist von Haus aus gemischt, und jede Engine will es als ein einziges Gericht servieren.
Wer programmieren kann, transkribiert für weniger als eine Tasse Kaffee
Der Vergleich der Gratis-Tarife bekommt eine ganz andere Form, sobald Sie bereit sind, eine API anzufassen — und die Zahlen sind es wert, auch wenn Sie sich dagegen entscheiden.
OpenAI verlangt 0,006 $ pro Minute für gpt-4o-transcribe und 0,003 $ pro Minute für die Mini-Variante. Ihr 47-Minuten-Interview kostet 28 Cent, mit Mini 14 Cent. Google Cloud Speech-to-Text gibt die ersten 60 Minuten pro Monat gratis, danach 0,016 $ pro Minute mit aktivierter Datenprotokollierung und 0,024 $ ohne, und listet id-ID sowohl für chirp als auch für chirp_2 in der Region asia-southeast1. Whisper steht unter MIT-Lizenz und kostet nichts außer Ihrer eigenen Hardware.
Zu diesen Preisen ist die Erkennung selbst nahezu kostenlos. Was Sie bei einem Endkundenprodukt tatsächlich kaufen, ist alles darum herum: eine Upload-Oberfläche, Sprecherzuordnung, Zeitstempel, ein Editor, Suche über alte Interviews, Zusammenfassungen, Exporte und ein Ort, an dem das Protokoll auch in sechs Monaten noch liegt.
Das ist die ehrliche Fassung der Build-oder-Buy-Frage. Wenn Sie drei Interviews im Jahr haben und ein Python-Skript ausführen können, führen Sie das Skript aus. Wenn Sie drei pro Woche haben und ein Zitat aus dem März wiederfinden müssen, suchen Sie keine Erkennung — Sie suchen ein Ablagesystem mit angeschlossener Erkennung.
Was kein Gratis-Tarif für Sie tun wird
Fairerweise gehören hierher die Grenzen, die für jede Option auf dem Tisch gelten, unsere eingeschlossen.
Gratis-Tarife geben Ihnen keine verlässliche Sprechertrennung. Sie ist einer der teureren Teile der Pipeline und wird in der ganzen Kategorie routinemäßig den Bezahltarifen vorbehalten. Wenn die Trennung von zwei Sprechenden für Ihre Arbeit unverzichtbar ist, planen Sie Geld dafür ein, statt zu hoffen.
Gratis-Tarife versprechen keine Aufbewahrung. Speicher kostet Geld; kostenloser Speicher ist eine Gefälligkeit, die eine Richtlinienänderung widerrufen kann. Exportieren Sie alles, was zählt, und behalten Sie eine eigene Kopie — was zugleich die Antwort auf die Frage nach dem Anbieter-Lock-in ist, die niemand stellt, bis er gehen will.
Gratis-Tarife heben die Genauigkeitsuntergrenze für Ihre konkreten Sprechenden nicht an. Regionale Akzente, ältere Interviewte, Telefonqualität und starkes Code-Switching verschlechtern das Ergebnis, und keine Tarifstufe ändert etwas daran, wie viel von Ihrem Audio das zugrunde liegende Modell je gesehen hat. Mehr zu zahlen kauft Ihnen Minuten und Funktionen, keinen anderen Erkenner.
Und kein Tool, gratis oder bezahlt, erspart Ihnen den Prüfdurchgang. Eine KI-Zusammenfassung auf einem ungeprüften Transkript erbt jeden Fehler darin — selbstbewusst und unsichtbar.
Fazit: Die Einheit, die Sie vergleichen sollten, sind nicht Minuten, sondern Interviews
Jeder Gratis-Tarif dieser Kategorie bewirbt eine Menge Zeit. Für Interviewarbeit ist das die falsche Einheit, denn Zeit zählt nur, wenn sie am Stück kommt. Einhundertzwanzig Minuten, in Drei-Minuten-Scheiben zerlegt, sind einer Journalistin weniger wert als dreißig ununterbrochene Minuten, und beide sind weniger wert als sechzig Minuten, die ein ganzes Gespräch mit intakter Sprecherzuordnung fassen.
Rechnen Sie beim Vergleich also jeden Gratis-Tarif in die einzige Währung um, die für Sie zählt: Wie viele meiner tatsächlichen Interviews transkribiert das von Anfang bis Ende, ohne die Datei zu teilen? Für mehrere bekannte Gratis-Tarife lautet die ehrliche Antwort null, und das werden sie Ihnen auf der Preisseite nicht sagen.
Die Erkennungsschicht ist eine Massenware auf dem Weg zu einem Drittel Cent pro Minute. Knapp bleibt für Indonesisch ein Protokoll, das Sie durchsuchen, korrigieren, zitieren und im nächsten Quartal noch wiederfinden können.
Wo Telli.sh hineinpasst: Wir sind eine Option unter den mehreren oben, und wir werden konkret. Der Gratis-Tarif von Telli.sh umfasst 60 Minuten im Monat — weniger Schlagzeilenminuten als Nottas 120, dafür bewusst nicht in Drei-Minuten-Scheiben pro Aufnahme zerlegt, sodass ein vollständiges Interview als eine Datei hineingeht. Sie bekommen das indonesische Transkript, Übersetzung in eine von 44 Zielsprachen, eine aus dem Transkript erzeugte KI-Zusammenfassung und eine Oberfläche, die in 15 Sprachen verfügbar ist, darunter Bahasa Indonesia. Jenseits von 60 Minuten im Monat ist es ein kostenpflichtiges Produkt, und wenn Ihr Volumen gering ist und Sie ein Skript ausführen können, ist der API-Weg tatsächlich billiger. Machen Sie den 5-Minuten-Test mit uns genauso, wie Sie ihn mit allen anderen machen würden.
Quellen
- Deepgram, "Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian", Changelog vom 7. August 2026 — verbesserte Batch-Modelle für Tamil und Indonesisch, verbesserte Streaming-Modelle für Tamil und Belarussisch, Armenisch (
hy) für beide ergänzt. - Hugging Face und Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28. August 2026 — Hindi als erste Sprache des Globalen Südens auf dem Leaderboard.
- Notta-Preise, abgerufen am 31. August 2026 — Gratis-Tarif mit 120 Minuten/Monat, maximal 3 Minuten pro Aufnahme, 50 Datei-Uploads/Monat, 10 KI-Zusammenfassungen/Monat; Pro für 8,17 $/Monat bei jährlicher Zahlung mit 1.800 Minuten/Monat.
- Transkriptor-Preise, abgerufen am 31. August 2026 — Lite 9,99 $/Monat (300 Minuten), Pro 19,99 $/Monat (2.400 Minuten, 99,99 $ jährlich), Team 30 $/Platz/Monat (3.000 Minuten pro Platz).
- Maestra-Preise und Maestra-Sprachliste, abgerufen am 31. August 2026 — Pay-as-you-go 12 $ pro 60 Credits, Lite 23 $/Monat für 180 Minuten; Indonesisch gelistet für Transkription, Übersetzung, Voiceover und Echtzeit.
- TurboScribe-Preise im Snapshot des Internet Archive — Gratis-Tarif mit 3 Transkripten täglich, 30-Minuten-Limit pro Datei und Einzeldatei-Upload; Unlimited für 10 $/Monat, 120 $ jährlich, 10-Stunden-Dateien. Die Live-Seite antwortet automatisierten Abrufen mit HTTP 403; behandeln Sie diese Zahlen als Richtwerte und prüfen Sie sie auf der Website.
- Preise für Google Cloud Speech-to-Text und unterstützte Sprachen, abgerufen am 31. August 2026 — die ersten 60 Minuten pro Monat gratis, 0,016 $/Min. mit Datenprotokollierung und 0,024 $/Min. ohne;
id-IDaufchirpundchirp_2inasia-southeast1. - OpenAI-API-Preise, abgerufen am 31. August 2026 —
gpt-4o-transcribezu 0,006 $/Minute,gpt-4o-mini-transcribezu 0,003 $/Minute. - OpenAI Whisper, MIT-lizenziert; die
LANGUAGES-Tabelle des Tokenizers deklariert 100 Sprachen mit Indonesisch (id) auf Position 17, abgerufen am 31. August 2026.