Quand un agent téléphonique IA doit-il s’arrêter de parler ?
ElevenLabs a présenté un moteur qui gère les tours de parole, les interruptions et le choix du modèle. Une modification de rendez-vous montre comment tester toute la conversation.
Un agent téléphonique automatique commence à confirmer un rendez-vous pour jeudi matin. La personne l’interrompt. « Pardon, je voulais dire jeudi prochain. » Même avec une voix fluide, l’agent peut compliquer l’échange s’il poursuit l’ancienne confirmation ou modifie la date avant d’entendre la fin de la demande. Peut-il céder la parole, puis reprendre avec les bonnes informations ?
Le 11 novembre 2026, ElevenLabs a présenté Interaction Engine en avant-première lors de son sommet à New York. Selon l’entreprise, le système gère les tours de parole et les interruptions, et peut choisir un modèle de langage différent selon le moment de l’échange. ElevenLabs a décrit un modèle moins coûteux pour le tri initial et un modèle plus capable pour les tâches complexes. L’annonce ne donne pas de date de disponibilité générale. Annonce du sommet par ElevenLabs
Une modification de rendez-vous offre un bon test. Il faut entendre la personne, remplacer son ancienne intention par la nouvelle et donner une confirmation qui corresponde à l’état du système de réservation. Repérer les silences et les chevauchements n’est que la première étape.
Une bonne pause laisse la personne finir
Une personne peut parler pendant que l’agent parle pour au moins trois raisons. Elle peut corriger une information importante, dire « d’accord » pour signaler qu’elle suit ou s’adresser à quelqu’un à côté. Le détecteur doit distinguer ces cas assez souvent pour rester utile. S’arrêter au moindre son paraît réactif la première fois et devient gênant sur un appel entier. Continuer pendant une correction peut transformer cinq secondes d’échange en une explication à répéter.
Écoutez deux versions du rendez-vous. Dans la première, la personne dit « oui » pendant que l’agent relit l’heure. Il peut poursuivre. Dans la seconde, elle dit « attendez, je voulais dire jeudi prochain, après le déjeuner ». L’agent doit couper l’ancienne phrase et attendre assez longtemps pour entendre le changement de semaine et le nouvel horaire souhaité. La réponse suivante doit reprendre les deux détails.
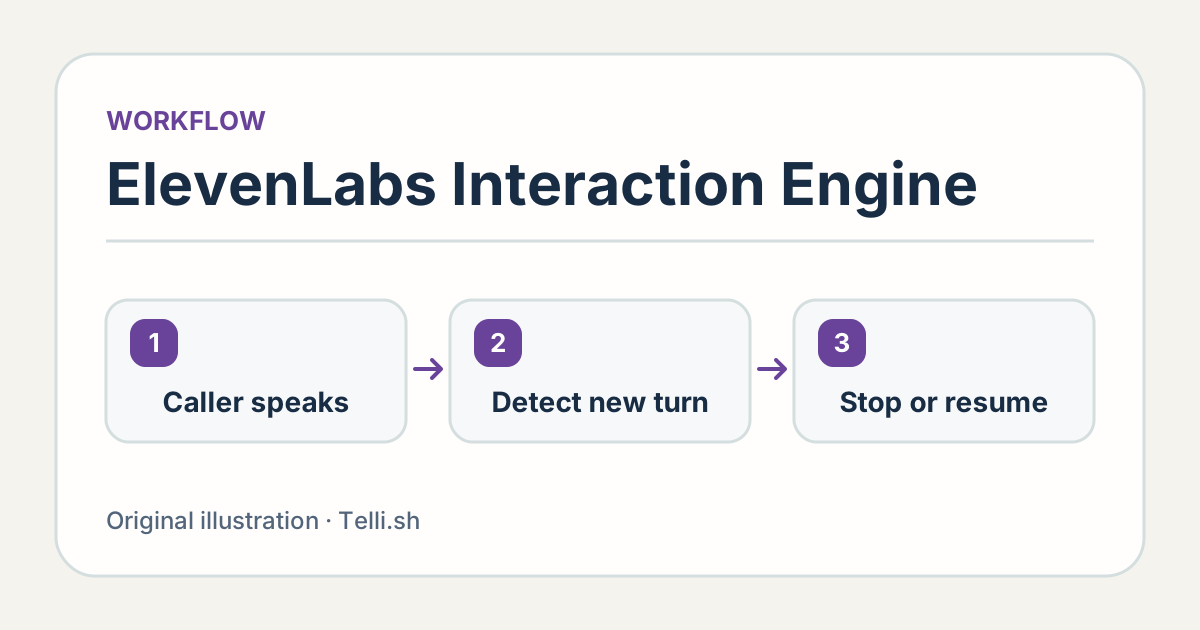
Céder la parole laisse le temps à une correction de devenir une consigne complète. Illustration originale de Telli.sh.
La qualité audio du téléphone rend la limite plus difficile à juger. Une personne peut marquer une pause avant la date, hésiter ou répéter une phrase lorsque la connexion coupe. Testez les canaux réellement utilisés et notez les conditions audio. Une démonstration nette montre que l’approche est possible. Des appels ordinaires et bruyants montrent si votre version tolère les interruptions habituelles.
Mesurez de son à son. Pour une correction réelle, relevez le temps entre le premier son significatif de la personne et la fin du son de l’agent. Incluez ce qui était déjà en mémoire tampon. Mesurez aussi le temps entre la fin du tour de parole et le premier mot utile de la réponse. Un « un instant » rapide peut rendre l’attente prévisible. Comptez-le à part si la réponse utile arrive plusieurs secondes après.
L’échange et la réservation peuvent se désynchroniser
Supposons que l’agent ait seulement trouvé un créneau pour ce jeudi au moment de l’interruption. Il peut abandonner l’ancienne proposition, chercher jeudi prochain et offrir une heure disponible. Un autre système peut envoyer la modification dès que la personne dit « jeudi me va », avant de relire la date entière. Lorsque la correction arrive, le premier changement a peut-être déjà atteint le service de réservation. Couper le son ne peut pas l’annuler.
Prévoyez ces cas dans le test. Une réservation encore au stade de proposition demande une nouvelle lecture des détails. Si une modification est en cours, l’agent a besoin d’un résultat confirmé côté serveur. Si elle a réussi, il doit décrire l’état actuel et suivre la procédure de correction approuvée. Si elle a échoué ou dépassé son délai, il doit vérifier l’état avant d’annoncer une réussite ou de réessayer. La réparation dépend des règles du système de réservation.
| Événement côté appelant | Comportement audible attendu | Résultat attendu pour la réservation |
|---|---|---|
| « Oui » pendant la relecture | Poursuivre, sauf si la personne prend la parole | Aucune écriture supplémentaire |
| « Attendez, jeudi prochain » avant l’accord | Arrêter l’ancienne relecture et recueillir toute la correction | Pas de modification avant confirmation de la nouvelle date |
| Correction pendant une modification en cours | Accuser réception et vérifier le résultat | Décrire l’état vérifié avant l’action suivante |
| Demande de parler à une personne | Confirmer et lancer la procédure de transfert existante | Transmettre l’état actuel et la demande non résolue |
Testez dans un environnement isolé avec des rendez-vous fictifs. Enregistrez la chronologie de l’appel et celle de la réservation. Les horodatages doivent partager une référence ou avoir un décalage connu. Cherchez les moments où l’agent annonce un changement absent du système ou où une écriture réussit après le retrait de la consigne. Ces défauts diffèrent d’une salutation trop lente.
Le choix du modèle doit suivre la tâche pendant l’échange
ElevenLabs présente son aperçu comme un moyen de choisir le modèle en cours de conversation. Un appel pour un rendez-vous rend l’idée concrète. Reconnaître une demande de report, chercher le dossier dans un outil autorisé, interpréter une règle inhabituelle et décider d’un transfert demandent des niveaux de raisonnement différents. Une recherche de date ordinaire peut être simple. Un changement qui combine plusieurs services et des règles contradictoires peut demander davantage d’examen ou un spécialiste.
Orientez le travail selon ses conséquences et préservez l’état de l’échange à chaque transfert. Illustration originale de Telli.sh.
Ces frontières comptent davantage qu’une liste de modèles. Lorsqu’une demande courante se complique, transmettez les informations vérifiées, telles que l’identifiant de réservation, l’état actuel et les incertitudes. Pour un transfert, résumez brièvement le souhait de la personne et les étapes déjà achevées. Une bonne escalade évite de lui faire répéter des informations et laisse la personne suivante les vérifier.
Mesurez la fréquence des erreurs de routage. « Déplacez les deux rendez-vous » peut demander un autre processus qu’un changement de date unique. Vérifiez si l’agent repère les deux réservations avant de demander l’accord. Si un cas complexe passe d’abord par le tri initial et remonte rapidement avec assez de contexte, la reprise peut être acceptable. Si les rendez-vous deviennent incohérents, le choix moins coûteux a des conséquences en aval.
L’aperçu présente une consommation réduite de jetons comme un avantage potentiel d’un modèle moins cher pour le tri. Le coût réel d’un centre de contact dépend aussi des rappels, des escalades et des abandons. Comparez le coût par tâche correctement résolue, y compris le suivi humain. Un appel de 40 secondes qui en impose un autre le lendemain déplace le coût.
Concevez un petit test reproductible
Commencez avec un cas dont le résultat est connu, par exemple déplacer un rendez-vous fictif du jeudi à la semaine suivante. Notez la réponse attendue et l’état final de la réservation. Ajoutez des versions avec interruption avant confirmation, correction au milieu d’une phrase et bref signe d’écoute. Insérez un silence volontaire. Une personne qui regarde son calendrier doit pouvoir reprendre sans être devancée par une réponse hors sujet.
- Marquez le début et la fin de chaque correction, puis l’arrêt effectif du son de l’agent.
- Vérifiez si la réponse conserve tous les détails corrigés et notez ceux que la personne a dû répéter.
- Comparez l’échange à l’état côté serveur. Cherchez les écritures en double, les dates erronées et les affirmations de réussite non étayées.
- Répétez le même script au calme et dans le bruit, avec différentes voix et conditions de connexion.
- Comparez les taux de résolution, le délai jusqu’au résultat vérifié et les erreurs de routage.
L’évaluation doit couvrir les problèmes importants tout en restant assez petite pour qu’une personne écoute les appels. Si deux systèmes diffèrent d’une fraction de seconde lors d’un échange net, examinez d’abord les cas aux conséquences plus fortes. Une confirmation fiable et un transfert clair peuvent compter davantage. Si le même écart change le nombre de personnes obligées d’interrompre deux fois, il devient significatif.
Mesurez les réponses tardives autant que la moyenne
Imaginons dix appels fictifs. Dans neuf cas, l’agent entend rapidement la correction. Au dixième, la personne parle par-dessus une longue phrase et doit répéter avant qu’il cède la parole. Le délai moyen paraît raisonnable, même si ce dernier appel risque le plus d’abîmer la confiance. Conservez les exemples et indiquez l’extrémité lente de la distribution lorsque le volume le permet. Dans un petit pilote, montrez l’étendue observée et écoutez les cas les plus lents.
Une pause peut donner une impression trompeuse de progrès si l’agent s’arrête pour des sons étrangers à l’échange. Faites jouer les mêmes voix de fond pendant une brève confirmation et une explication longue. Mesurez les arrêts intempestifs et vérifiez si la reprise se fait à un point intelligible. Rejouez un appel équivalent avec une correction réelle au même instant. Les deux essais distinguent un détecteur réactif d’un détecteur trop sensible. Incluez les façons dont votre public exprime son désaccord, puisqu’un « attendez » préparé n’en est qu’une.
Évaluez ce que chaque résultat coûte à la personne. Un arrêt intempestif sur un « hum hum » peut n’ajouter qu’une courte pause. Une correction manquée peut laisser planer un doute sur la date enregistrée. Une erreur de routage peut imposer plusieurs répétitions. Un tableau qui relève fréquence et effort de reprise aide à choisir les problèmes à traiter en premier. Vérifiez si l’agent suivant ou l’opérateur peut expliquer l’état de la réservation sans demander de recommencer.
Le canal change aussi le rythme. Un appel dans un navigateur au calme et un appel mobile compressé renseignent différemment sur les tours de parole. Notez où chaque enregistrement a été fait, s’il y avait un haut-parleur et si les horodatages désignent le son côté appelant ou un événement interne. Gardez la même méthode entre l’ancien et le nouveau système. La comparaison doit expliquer quand une personne remarquera un changement.
Avant de déployer plus largement, demandez à un petit groupe d’évaluer les appels sans connaître le système utilisé. Donnez-lui le résultat attendu de la réservation et demandez si le souhait a été compris, si la correction a dû être répétée et si la dernière confirmation était exacte. Rapprochez les réponses du journal de réservation. Vous verrez ainsi les écarts entre une voix naturelle et une tâche correctement terminée.
ElevenLabs propose déjà ElevenAgents pour configurer et exploiter des agents vocaux et de messagerie. L’article du sommet présente Interaction Engine comme une avant-première distincte et donne à chaque autre annonce son propre calendrier. L’essai proposé fonctionne avec votre système vocal actuel. Répétez-le si la fonction d’aperçu devient accessible, avec les mêmes scripts et résultats attendus. Annonce du sommet et de la plateforme par ElevenLabs
Une correction est une meilleure démonstration qu’un script sans accroc
Si un client peut changer d’avis au milieu d’une phrase, entendre une nouvelle confirmation et retrouver ensuite le bon rendez-vous, l’ensemble du système a géré une conversation ordinaire. C’est un objectif plus solide qu’une voix naturelle dans un exemple où l’interlocuteur suit un scénario parfait.
Sources
- Annonce du sommet ElevenLabs à New York et aperçu d’Interaction Engine, 11 novembre 2026
- Programme et démonstrations du sommet ElevenLabs
Pour organiser et retrouver les notes d’appels clients et de séances de revue, créez un compte Telli.sh.