Eleven Realtime przenosi rywalizację głosowych AI poza sam głos
ElevenLabs przedstawia modele Mini i Max działające w czasie rzeczywistym. Najciekawsze są prostszy stos rozmowy i wyraźniejsze rozróżnienie między naturalnym brzmieniem a wykonaniem zadania.
Oficjalny podgląd komponentu rozmowy głosowej ElevenLabs UI dla obsługi klienta. Źródło: elevenlabs/ui; copyright 2025 Eleven Labs Inc., licencja MIT. To ilustracja interfejsu głosowego, nie test modelu Realtime.

Niezręczny moment rozmowy głosowej często pojawia się jeszcze przed odpowiedzią. Zatrzymujesz się, próbując przypomnieć sobie datę, a asystent zaczyna mówić. Poprawiasz nazwisko, lecz on kończy wcześniej przygotowane zdanie. Głos może brzmieć doskonale, a sama wymiana zdań sprawiać wrażenie zaskakująco nieprzyjaznej. Dla twórców asystentów telefonicznych, korepetytorów i interaktywnych postaci te drobne potknięcia mogą być równie istotne jak jakość generowanej mowy.
20 października ElevenLabs przedstawiło Eleven Realtime v1 Mini i v1 Max, pozycjonując je jako kompletne modele agentów głosowych, a nie kolejny element do samodzielnego połączenia. Mini służy codziennym rozmowom przy niższym koszcie, a Max — złożonym instrukcjom i pracy wieloetapowej. Premiera jest istotna, bo więcej aspektów rozmowy obejmuje jedną decyzją produktową. Jednocześnie trudniej uniknąć starego pytania: jeśli głos brzmi kompetentnie, skąd wiemy, że zadanie rzeczywiście wykonano? Oficjalna zapowiedź.
Naszym zdaniem obiecujące jest przede wszystkim ograniczenie czasu poświęcanego na dopracowywanie połączeń między komponentami. Sprawdzianem tej obietnicy jest rozmowa, która radzi sobie z poprawkami i prowadzi do prawidłowego wyniku. Dopracowana demonstracja pokazuje pierwsze wrażenie. Zwyczajne, nieuporządkowane zgłoszenie klienta pokazuje, czy produkt zasługuje na swoje miejsce.
ElevenLabs rozszerza znaną mocną stronę na większe zadanie
Dla czytelników znających ElevenLabs głównie z syntetycznych głosów: firma opisuje dziś trzy platformy — ElevenCreative do tworzenia treści, ElevenAgents do wdrażania agentów konwersacyjnych oraz ElevenAPI dla programistów. Realtime wpisuje się w szerszy zamiar wykorzystania dźwięku wewnątrz aplikacji, zamiast traktowania go wyłącznie jako gotowego pliku. To tło wyjaśnia połączenie jakości głosu z mechaniką interakcji. Informacje prasowe o ElevenLabs.
Klip dźwiękowy ma wyraźną granicę. Powstaje tekst, następnie mowa, a odbiorca słucha wyniku. Agent działający na żywo funkcjonuje w zmiennej sytuacji. Rozmówca może przerwać, zmienić pytanie, dopowiedzieć brakujące informacje albo odkryć, że pierwotna prośba była błędna. Oprogramowanie musi rozpoznać, czy pauza oznacza „teraz twoja kolej”, czy „jeszcze się zastanawiam”. Musi na bieżąco rozumieć człowieka, jednocześnie obsługując systemy stojące za rozmową.
To inny problem produktowy niż przekonujące wypowiedzenie pojedynczego zdania. Pomyślmy o asystencie rezerwacji. Może idealnie wymówić imię klienta, a mimo to zarezerwować zły dzień, bo przeoczył poprawkę. Udany produkt głosowy wymaga spójności zarówno rytmu społecznej wymiany, jak i zapisu transakcji. Poprawa jednego bez drugiego daje przyjemny sposób robienia niewłaściwych rzeczy.
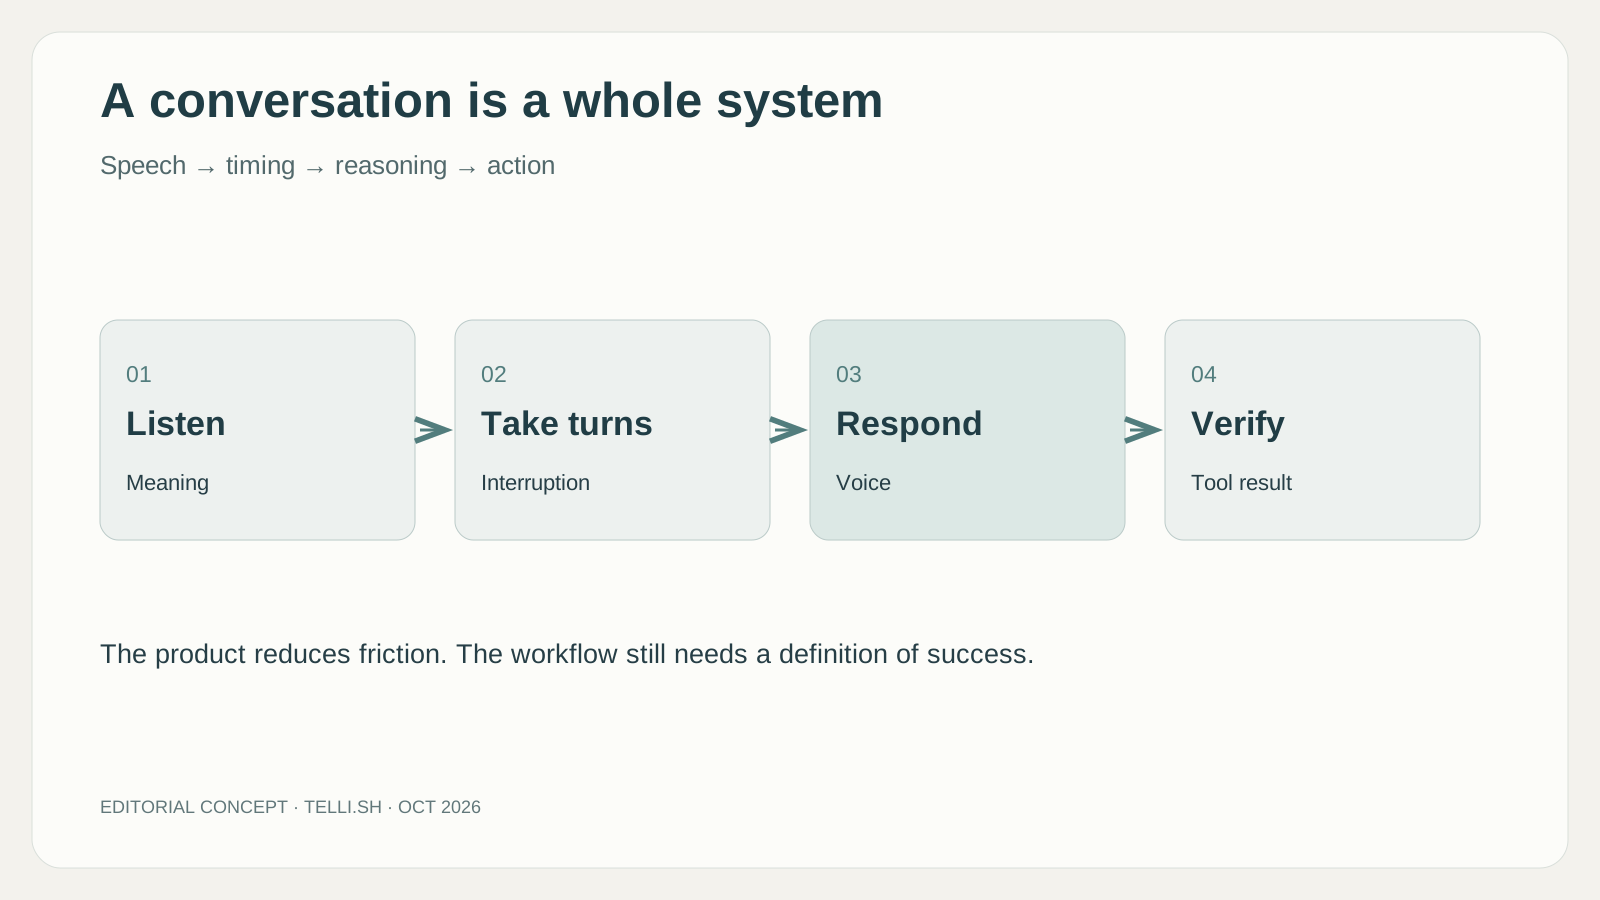
Autorska infografika redakcyjna. Opisuje doświadczenie użytkownika, a nie wewnętrzną architekturę modelu.
Zarządzany stos ogranicza konfigurację, zmieniając zakres kontroli
Rozróżnienie w dokumentacji jest praktyczne. W trybie Custom twórca wybiera model językowy, model mowy i ustawienia rozpoznawania. W trybie Realtime wybory te przejmuje ElevenLabs, pozostawiając instrukcje agenta, głos, narzędzia i inne obsługiwane ustawienia rozmowy. Dostęp jest udostępniany stopniowo, więc ustawienie może jeszcze nie być widoczne w każdym obszarze roboczym. Realtime ma również wymagania dotyczące zgodności i regionu, które istniejący agent musi spełniać. Dokumentacja modeli Realtime.
Taka wymiana może być korzystna. Mały zespół może znacznie bardziej interesować się obsługą przerwań niż wyborem każdego komponentu. Zarządzana konfiguracja zapewnia spójny punkt startu i mniej kombinacji wymagających diagnozowania. Zespół może poświęcić czas pytaniom klientów, informacjom rzeczywiście dostępnym w firmie i momentowi, w którym sprawę powinien przejąć człowiek.
Mniej ustawień oznacza jednak również mniej niezależnych zamienników. Jeśli część zachowania jest nieodpowiednia, zespół musi wiedzieć, czy może ją dostosować, zmienić model albo wrócić do własnej konfiguracji. Właściwe porównanie obejmuje cały wysiłek utrzymania użytecznego agenta. Konfigurowalny stos bywa uciążliwy, a zintegrowany — ograniczający. To, który koszt ma znaczenie, zależy od zadania i od tego, kto będzie obsługiwał system po demonstracji.
Ma to szczególne znaczenie, gdy prototyp staje się wspólną usługą. Jego autor może znać wszystkie osobliwości. Zespół wsparcia, klient i kolejny programista doświadczą działania bez tego kontekstu. Produkt konsekwentnie podejmujący typowe decyzje może być wartościowy, nawet jeśli oferuje ich mniej. Spójność pomaga, gdy jest widoczna, sprawdzalna i zgodna z odpowiedzialnością usługi.
Inne stosy głosowe umieszczają kontrolę w różnych miejscach
Podejście ElevenLabs staje się wyraźniejsze obok alternatyw. Przewodnik OpenAI po agentach głosowych rozróżnia interakcję głosową w czasie rzeczywistym oraz łańcuch, w którym mowa jest transkrybowana, przetwarzana przez agenta tekstowego i ponownie zamieniana w mowę. Opis systemów łańcuchowych podkreśla możliwość sprawdzania pośredniego tekstu i wymiany poszczególnych komponentów. Jest to porównanie architektoniczne, a nie informacja o nieujawnionych wnętrznościach Eleven Realtime. Tę samą interakcję z klientem można zbudować wokół różnych miejsc obserwacji i zmiany działania.
Etap tekstowy przydaje się, gdy organizacja potrzebuje określonego punktu kontroli. Usługa szkoleniowa może analizować sposób interpretacji odpowiedzi ucznia, a specjalistyczne wsparcie — przetwarzać terminologię przed wypowiedzeniem odpowiedzi. Pośredni zapis daje zespołowi konkretny materiał do sprawdzenia. Wprowadza też kolejną granicę między komponentami wymagającą utrzymania. Dla dynamicznej postaci czy swobodnej rozmowy twórca może wybrać bardziej zintegrowaną interakcję i zaakceptować inny zestaw elementów sterowania.
| Podejście | Co przyciąga twórcę | Co nadal wymaga decyzji |
|---|---|---|
| Zarządzany tryb czasu rzeczywistego | Mniej wyborów komponentów i jedna wspierana konfiguracja rozmowy | Czy obsługiwane ustawienia pasują do usługi |
| Łańcuch mowy i tekstu | Wgląd w pośredni tekst i niezależna wymiana komponentów | Jak połączone etapy zachowują tempo i poprawki |
| Orkiestracja oparta na frameworku | Jawne zachowanie aplikacji wokół tur, narzędzi i przekazania sprawy | Kto utrzymuje to zachowanie, gdy zmieniają się dostawcy |
Decyduje miejsce, w którym zespół potrzebuje wiarygodnego punktu kontroli: pośredniej transkrypcji, zdarzenia w rozmowie lub ukończonego działania. Pomaga to wyjaśnić, dlaczego zespół może rozsądnie zachować własny system mimo obiecującej zintegrowanej premiery. Szansa biznesowa ElevenLabs polega na uczynieniu zarządzanej opcji wystarczająco dobrą do większej liczby zadań, tak aby szczegółowe składanie stało się wyborem, a nie ceną wstępu do tworzenia usług głosowych.
Zawahanie i przerwanie zasługują na różne reakcje
Perspektywa frameworku dodaje kolejny wymiar. Dokumentacja obsługi tur LiveKit traktuje fałszywe przerwania jako osobne zachowanie: aktywność głosowa może przerwać agentowi, mimo że nie powstaje transkrypcja użytkownika, a po skonfigurowanym czasie mowa może zostać wznowiona. Nie dowodzi to stosowania tego samego mechanizmu przez ElevenLabs. Pokazuje, dlaczego pozorna uprzejmość produktu głosowego zależy od zachowania aplikacji oraz modelu dostarczającego słowa.
Wyobraźmy sobie różnicę między wypowiedzią „chwila, chodzi o inny adres” a kaszlnięciem podczas słuchania. Obie sytuacje wytwarzają dźwięk w czasie wypowiedzi asystenta. Tylko jedna musi zmieniać prośbę. Usługa zaczynająca wyjaśnienie od nowa po każdym hałasie staje się męcząca, a ignorująca prawdziwą poprawkę — niewiarygodna. Użyteczne porównanie dotyczy odzyskania właściwego kontekstu rozmowy, a nie jedynie szybkości wykrycia aktywności w kanale audio.
To rozróżnienie poszerza również grono uczestników pilotażu. Osoby szukające nieznanego słowa, mówiące w drugim języku lub wolniejszym rytmem mogą potrzebować dłuższej ciszy. To proponowane grupy ewaluacyjne, a nie twierdzenia o zmierzonej dostępności czy pokryciu językowym. Zespół powinien słuchać, czy użytkownicy dostają czas na dokończenie i czy odzyskanie rozmowy wymaga powtórzenia całej prośby. Średni czas odpowiedzi może ukrywać ten ciężar.
Obiecująca jest możliwość poprawy doświadczenia przez zarządzany model rozmowy bez implementowania własnej logiki czasowej przez każdego klienta. Pozostaje pytanie, ile aplikacja może zmienić, gdy domyślny rytm nie pasuje. To konkretne zagadnienie do demonstracji: pozwól rozmówcy się zawahać, poprawić szczegół i kontynuować, a następnie sprawdź, co agent zrozumiał i co rzeczywiście otrzymało podłączone narzędzie. Łączy to komfort rozmowy z weryfikowalnym wynikiem.
Mini i Max rozdzielają rozmowę od wymagającego wykonania
Dwie nazwy powinny zachęcać do wyboru według obciążenia, zamiast odruchowego kupowania większego modelu. Postać do ćwiczenia języka i agent realizujący procedurę zwrotu mierzą się z różnymi problemami. Pierwsza musi podtrzymywać rozmowę i odpowiednio reagować na błędy. Drugi może potrzebować odczytania zasad, identyfikacji zamówienia, sprawdzenia uprawnień i przekazania wyniku zewnętrznego działania.
Większy model może być zbędny do lekkiej rozmowy, a tańszy — kosztowny, jeśli stale przekazuje nierozwiązane sprawy personelowi. Koszt minuty pomaga oszacować rachunek. Koszt prawidłowo zakończonej interakcji lepiej pokazuje, czy system pasuje do procesu pracy. Ten drugi obejmuje odzyskiwanie działania, ponowne telefony i pracę ludzi naprawiających wiarygodnie brzmiące błędy.
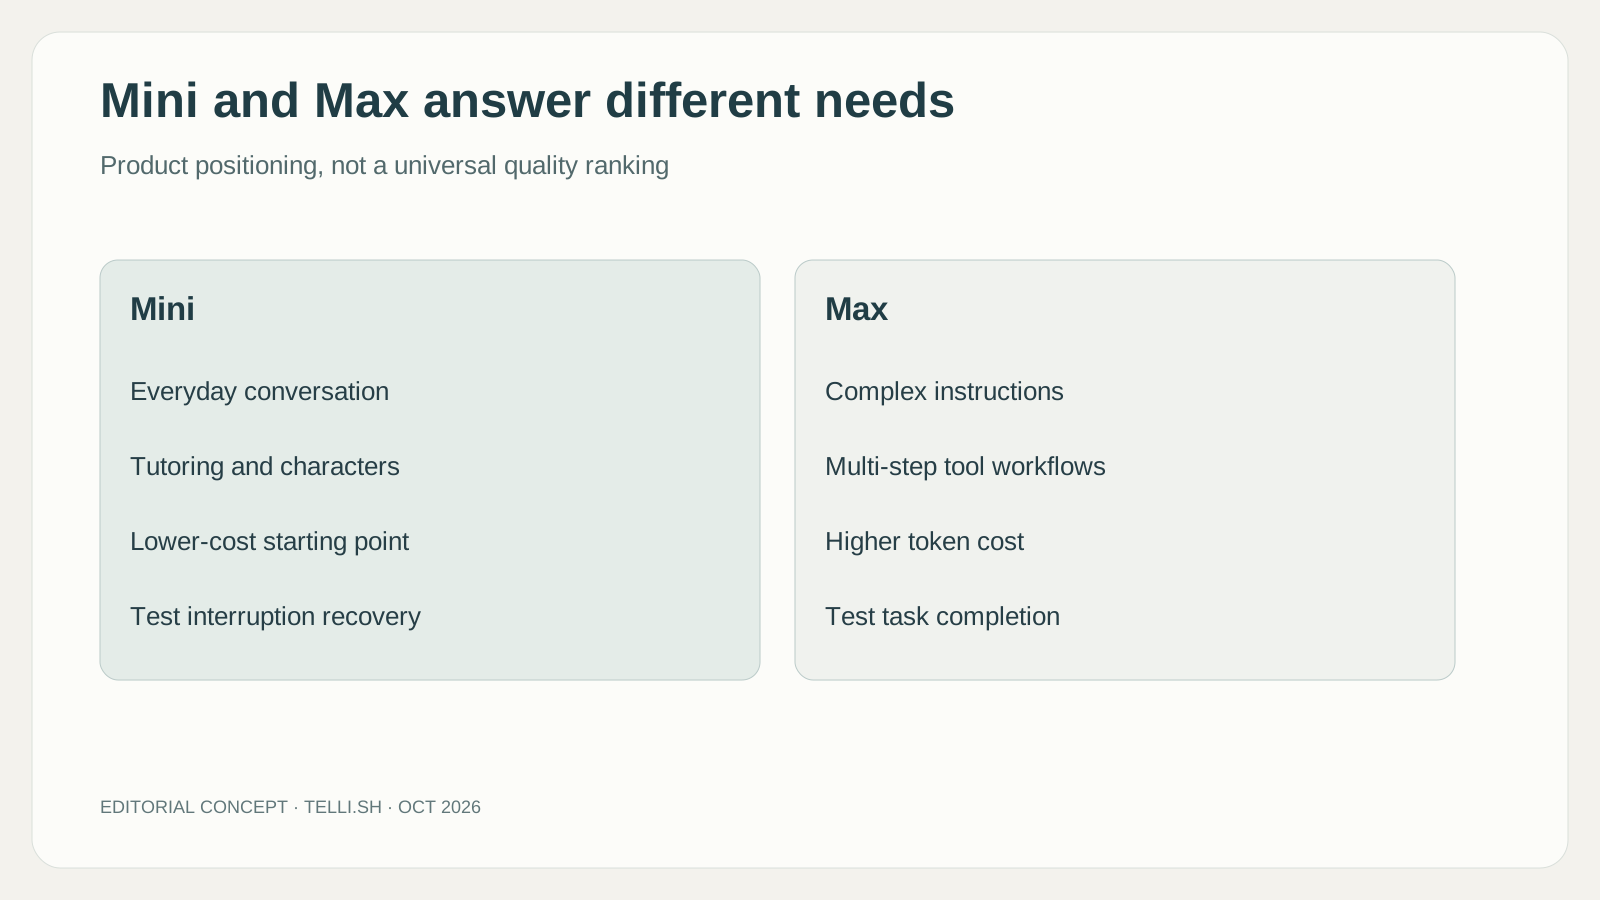
Autorska infografika oparta na pozycjonowaniu dostawcy. Nie jest zmierzonym rankingiem wszystkich języków i zadań.
Zapowiedź publikuje wyniki benchmarków przypisane Artificial Analysis. Dla zadań z użyciem narzędzi podano 87.1% ukończeń dla Max i 60.3% dla Mini, natomiast wyniki dynamiki rozmowy nieznacznie faworyzują Mini. To benchmarki opublikowane przez dostawcę, a nie nasze pomiary wdrożenia. Ich użyteczny przekaz brzmi: płynność rozmowy i wykonanie narzędzi mogą się rozchodzić. Nie ustalają skuteczności połączeń w konkretnej firmie. Zapowiedź i kontekst benchmarków.
Zespół powinien więc unikać sprowadzania jakości do jednej pozycji w tabeli. Jeśli agent głównie objaśnia eksponat muzealny, rytm rozmowy może dominować. Jeśli zmienia rezerwację, ważniejszy jest dokładny stan końcowy. Premiera daje twórcom dwa punkty startu, lecz definicję jakości nadal określa zadanie.
Trzy zwyczajne sytuacje pokazują różne mocne strony
Wyobraźmy sobie ucznia ćwiczącego rozmowę w restauracji w innym języku. Zatrzymuje się w połowie zamówienia, szuka słowa i zaczyna ponownie. Użyteczny nauczyciel zostawia miejsce na zawahanie i pomaga bez przejmowania rozmowy. Korzyścią jest odwaga dalszej nauki. Porażką — asystent uznający każdą pauzę za pozwolenie na wykład. Ten przykładowy przypadek dotyczy przede wszystkim współpracy w rozmowie, a jakość nauczania wymaga osobnej oceny.
Rozważmy teraz umawianie wizyty. Dzwoniący najpierw prosi o piątek, po czym mówi: „Właściwie w następny poniedziałek, po obiedzie”. Asystent powinien przenieść poprawkę do proponowanej rezerwacji i potwierdzić istotne dane przed wykonaniem wiążącego kroku. Gdy system rezerwacyjny odpowie, wypowiedziane potwierdzenie powinno odzwierciedlać tę odpowiedź. Przyjazne „gotowe” przed przyjęciem zmiany byłoby błędem, nawet gdy każde zdanie brzmi naturalnie.
Interaktywna postać tworzy trzeci rodzaj równowagi. Może odpowiadać pomysłowo w swoim fikcyjnym świecie, ale gracz nadal oczekuje pamiętania aktualnej sceny i zatrzymania po przerwaniu. Wynikiem biznesowym może być angażująca wymiana zamiast ukończonej transakcji. Zachowanie ożywiające postać może brzmieć wymijająco w obsłudze klienta. To powody, by oceniać odrębne zadania, zamiast traktować „agenta głosowego” jako jedną jednolitą kategorię.
Zgodność obniża koszt próby, ale warto przeczytać ograniczenia
ElevenLabs oferuje dostęp przez ElevenAgents oraz zgodny z OpenAI Realtime API. Przykład API w zapowiedzi zmienia adres i model w istniejącym kliencie, ale wskazuje też połączenie wyłącznie WebSocket i oddziela API od zarządzanej platformy. Integracja WebRTC wymaga więc więcej niż zamiany nazwy modelu, a zarządzanych kanałów czy bazy wiedzy nie należy uznawać za automatyczną część API. Dostęp do API i uwagi migracyjne.
Wartością zgodności jest łatwiejsze porównanie. Programista może zachować większą część aplikacji, próbując innego dostawcy. Urealnia to porównywanie tego samego zadania, instrukcji i narzędzi zamiast niepowiązanych demonstracji. Nie usuwa potrzeby sprawdzenia zdarzeń, ponownych połączeń, odpowiedzi narzędzi i sposobu prezentowania awarii przez aplikację.
Te mniej efektowne szczegóły kształtują doświadczenie klienta. Jeśli po żądaniu rezerwacji połączenie się zerwie, aplikacja musi wiedzieć, czy rezerwacja powstała, zanim poprosi o powtórzenie. Przekroczenie czasu oczekiwania narzędzia może sprawić, że ponowienie wywołania będzie miało inne konsekwencje niż powtórzenie pytania. Migracja modelu jest udana, gdy cała aplikacja zachowuje się poprawnie również w takich sytuacjach, a nie tylko odtwarza pierwszą odpowiedź audio.
Naturalny głos może sprawić, że niedokończona czynność zabrzmi na zakończoną
Wybierając model, zachowuj stałe warunki porównania. Jeśli większy dostanie czystszą bazę wiedzy, lepszą instrukcję i bardziej niezawodne narzędzia, próba nie wyjaśni, która zmiana pomogła. Zacznij od tych samych reprezentatywnych próśb i przeanalizuj błędy przed zmianą otoczenia procesu. Problem z rytmem może wymagać dostrojenia rozmowy, błędna odpowiedź o zasadach — lepszych źródeł, a niedokończona rezerwacja — naprawy integracji. Kupno sprawniejszego modelu może pomóc w części problemów, ale nie powinno zasłaniać wadliwego połączenia, które pozostanie wadliwe w obu wariantach.
Największa zaleta produktu może również utrudniać dostrzeżenie błędów. Ludzie traktują ton, tempo i pewność jako sygnały rozmowy. Płynny asystent może brzmieć, jakby coś sprawdził, choć tylko ułożył prawdopodobną odpowiedź. W tekście użytkownik może mieć więcej okazji do jej przeanalizowania. Podczas połączenia rozmowa idzie dalej, a sporny szczegół znika w jej toku.
Odpowiedź projektowa powinna być konkretna, nie teatralna. Rozdzielaj wyjaśnienie, proponowaną czynność i potwierdzony wynik. Pozwól agentowi powiedzieć, że sprawdza, że prośba nadal czeka albo potrzebna jest pomoc człowieka. Powiąż te stany z aplikacją, zamiast pozostawiać je jako uspokajające zwroty w instrukcji. Uczciwa pauza często daje lepszą obsługę niż natychmiastowa odpowiedź tworząca późniejszą pracę naprawczą.
Przekazanie człowiekowi też potrzebuje ciągłości. Osoba docierająca do pracownika po kilku minutach nie powinna odtwarzać każdego szczegółu z pamięci. Przydatne przekazanie obejmuje aktualną prośbę, istotne poprawki i nierozwiązany krok. Powinno zachować niepewność tam, gdzie agent nie był pewny. W przeciwnym razie automatyzacja oszczędza czas na początku rozmowy, przenosząc ciężar na osobę rozwiązującą sprawę.
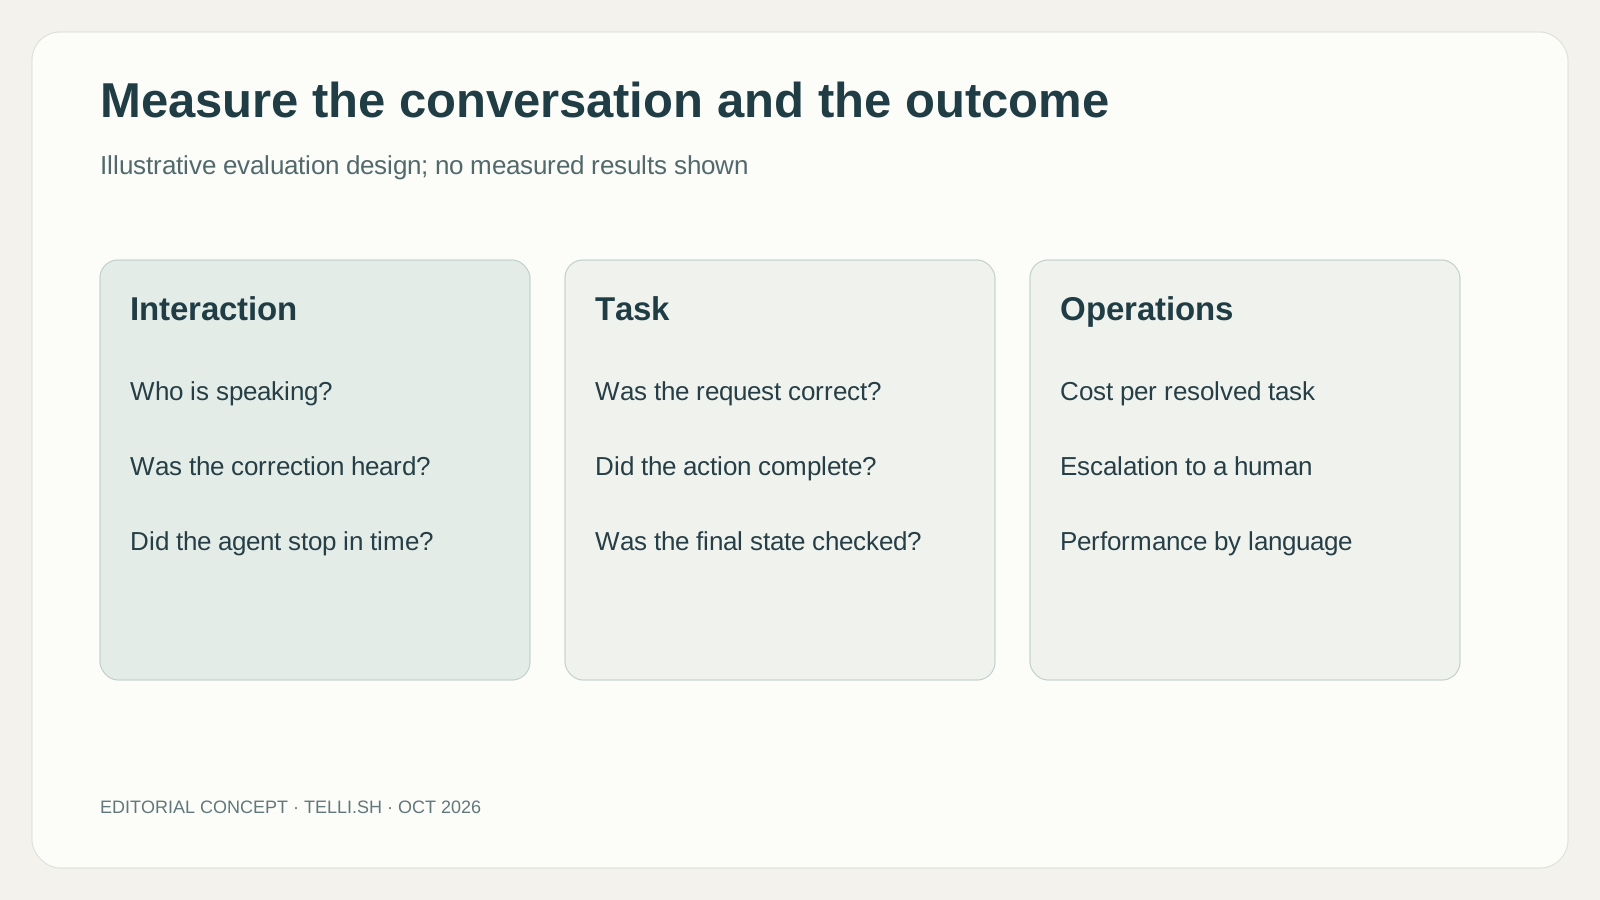
Autorski redakcyjny schemat oceny. Nie przedstawia wyników testów.
Następnym benchmarkiem jest rozwiązana rozmowa
Rozsądny pilotaż wykorzystywałby reprezentatywne rozmowy za zgodą uczestników: krótkie i długie prośby, przerwania, poprawki, różne języki i sprawy wymagające przekazania człowiekowi. Sprawdzałby wykonanie zamierzonej czynności, częstotliwość interwencji ludzi i koszt zakończonej interakcji. Zachowałby czas do pierwszego dźwięku jako jedną z miar, ale liczyłby też szybkie odpowiedzi wymagające późniejszego poprawienia. Są to propozycje oceny, a nie testy, które przeprowadziliśmy na Realtime.
Najbardziej obiecującym wynikiem byłby agent zadający mniej zbędnych pytań, ale gotowy zadać konieczne. Nauczyciel powinien pozwolić uczniowi dokończyć myśl. Asystent rezerwacji — sprawdzić poprawioną datę. Agent wsparcia — przekazać kontekst. Łatwo opisać te usprawnienia skromnie, ale odczuwa się je mocno, bo usuwają drobne tarcia wyczerpujące w zautomatyzowanych rozmowach.
Eleven Realtime nadaje temu kierunkowi konkretną formę produktu. Może pozwolić większej liczbie zespołów tworzyć przydatne interakcje głosowe bez specjalizowania się w każdym komponencie stosu audio. Długofalowe znaczenie będzie zależeć od tego, czy zintegrowana rozmowa prowadzi również do niezawodnie ukończonej pracy. Głos wprowadza użytkownika do rozmowy. Wynik decyduje, czy zechce odbyć następną.
Źródła
-
Zapowiedź Eleven Realtime i kontekst benchmarków, 20 października 2026 r.
-
Tryby, wdrażanie i ograniczenia modeli Realtime, sprawdzono 21 października 2026 r.
-
Informacje o platformach ElevenLabs, sprawdzono 21 października 2026 r.
-
Architektury agentów głosowych OpenAI, sprawdzono 21 października 2026 r.
-
Obsługa tur w LiveKit, sprawdzono 21 października 2026 r.
Zachowaj rozmowę do późniejszego przeglądu
Jeśli potrzebujesz osobnego miejsca na nagrania, do których masz uprawnienia, i sprawdzone notatki, jedną z opcji jest Telli.sh. Zacznij od notatki audio.