Eleven Realtime porta la sfida dell'IA vocale oltre la voce
ElevenLabs presenta i modelli realtime Mini e Max. La novità interessante è uno stack conversazionale più semplice e una distinzione più netta tra sembrare naturale e portare a termine il lavoro.
Anteprima ufficiale del componente di chat vocale di ElevenLabs UI per l'assistenza clienti. Fonte: elevenlabs/ui; copyright 2025 Eleven Labs Inc., licenza MIT. Illustra un'interfaccia vocale, non un test del modello Realtime.

Il momento imbarazzante di una conversazione vocale arriva spesso prima della risposta. Fai una pausa per ricordare una data e l'assistente comincia a parlare. Correggi un nome e lui termina la frase che aveva già preparato. La voce può essere eccellente mentre lo scambio sembra stranamente poco collaborativo. Per chi sviluppa un assistente telefonico, un tutor o un personaggio interattivo, questi piccoli fallimenti possono contare quanto la qualità del parlato generato.
Il 20 ottobre ElevenLabs ha presentato Eleven Realtime v1 Mini e v1 Max, posizionandoli come modelli completi per agenti vocali, anziché come un altro componente da assemblare. Mini punta alle conversazioni quotidiane a costo inferiore; Max alle istruzioni complesse e al lavoro in più passaggi. Il lancio conta perché racchiude una parte maggiore della conversazione in un'unica scelta di prodotto. Rende anche più difficile evitare una vecchia domanda: quando una voce sembra competente, come sappiamo che il compito è stato davvero svolto? Annuncio ufficiale.
La nostra lettura: l'aspetto promettente è spendere meno tempo a regolare i collegamenti tra componenti. La prova di quella promessa è una conversazione che regge alle correzioni e produce un risultato corretto. Una dimostrazione curata può mostrare la prima impressione. È una normale richiesta disordinata di un cliente a far meritare al prodotto il proprio posto.
ElevenLabs estende un punto di forza familiare a un compito più ampio
Per chi conosce ElevenLabs soprattutto attraverso le voci sintetiche, l'azienda descrive oggi tre piattaforme: ElevenCreative per creare contenuti, ElevenAgents per gli agenti conversazionali in produzione ed ElevenAPI per gli sviluppatori. Realtime rientra nel tentativo più ampio di rendere l'audio utile dentro un'applicazione, anziché soltanto come file audio finito. Questo contesto spiega perché il lancio unisce qualità della voce e meccanica dell'interazione. Informazioni stampa di ElevenLabs.
Una clip audio ha confini chiari. Si scrive il testo, si genera il parlato e qualcuno ascolta il risultato. Un agente dal vivo opera in una situazione in movimento. Chi ascolta può interrompere, cambiare domanda, fornire un'informazione mancante o scoprire che la richiesta originale era sbagliata. Il software deve decidere se una pausa significhi «tocca a te» oppure «sto ancora pensando». Deve mantenere la propria comprensione allineata alla persona, gestendo anche i sistemi dietro la conversazione.
È un problema di prodotto diverso dal rendere convincente una frase isolata. Pensiamo a un assistente per prenotazioni. Può pronunciare perfettamente il nome del cliente e prenotare comunque il giorno sbagliato perché ha perso una correzione. Un prodotto vocale riuscito richiede coerenza sia nel ritmo sociale sia nel registro della transazione. Migliorare l'uno ignorando l'altro crea un modo piacevole di fare la cosa sbagliata.
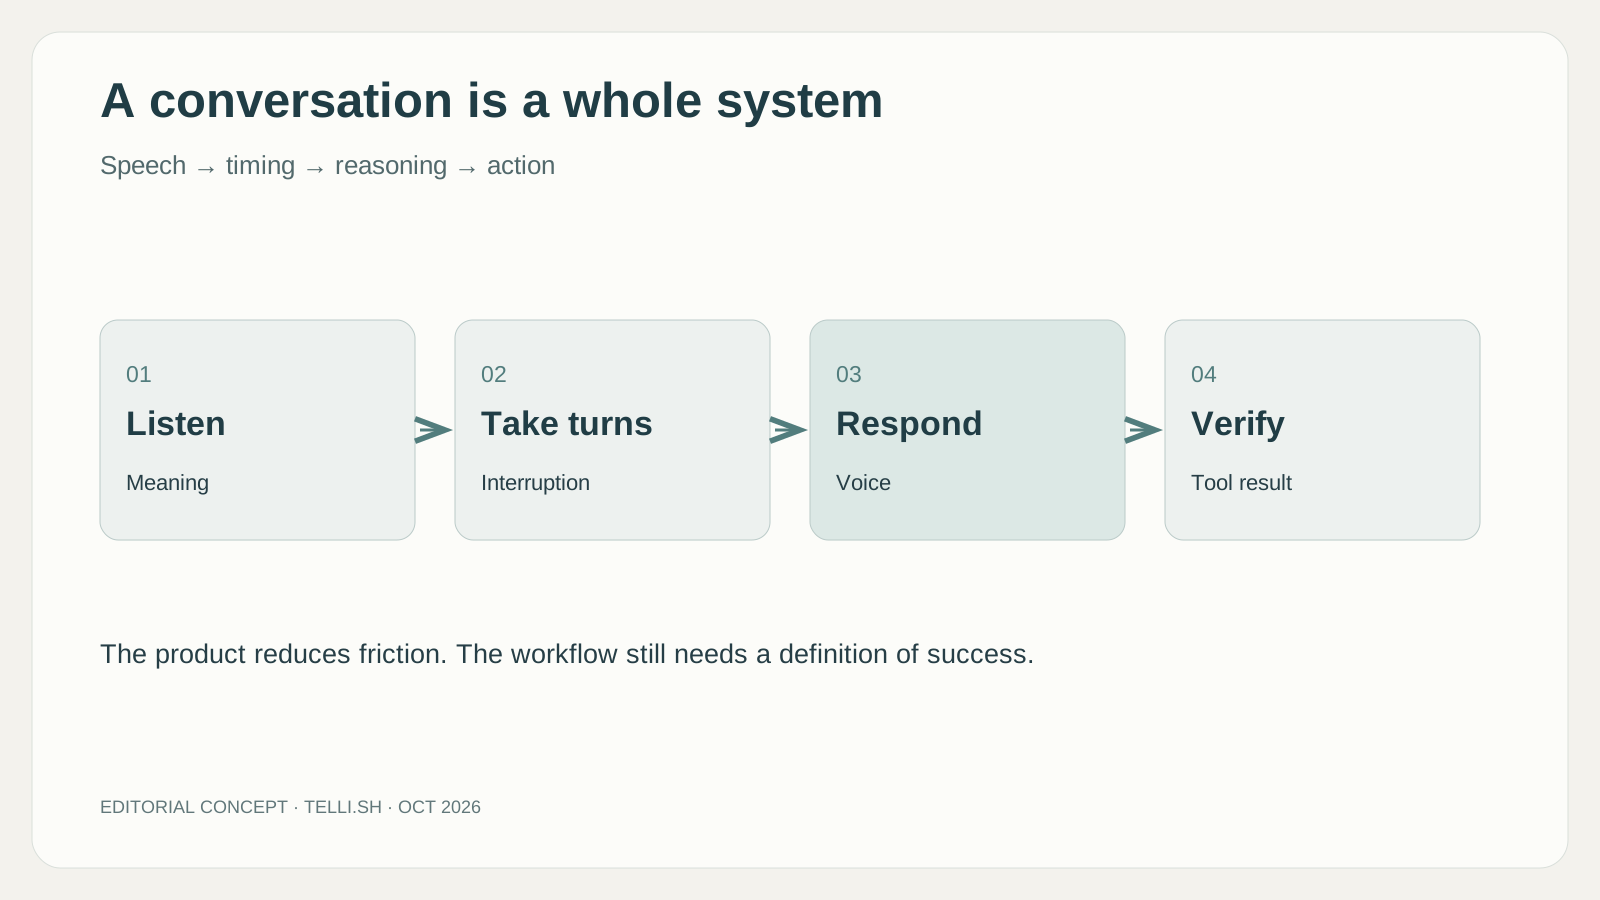
Infografica editoriale originale. Descrive l'esperienza utente, non l'architettura interna del modello.
Uno stack gestito riduce la configurazione e cambia ciò che controlli
La distinzione nella documentazione è pratica. In modalità Custom, chi sviluppa sceglie il modello linguistico, quello vocale e le impostazioni di riconoscimento. La modalità Realtime affida queste scelte a ElevenLabs, mantenendo istruzioni dell'agente, voce, strumenti e altre impostazioni conversazionali supportate. L'accesso viene distribuito gradualmente, quindi l'opzione potrebbe non apparire ancora in ogni spazio di lavoro. Realtime prevede inoltre vincoli di compatibilità e regionali che un agente esistente deve rispettare. Documentazione dei modelli Realtime.
Può essere uno scambio utile. A un piccolo team può importare molto di più che l'assistente gestisca un'interruzione che scegliere ogni componente sottostante. Una configurazione gestita offre un punto di partenza coerente e meno combinazioni da diagnosticare. Il team può concentrarsi sulle domande dei clienti, sulle informazioni realmente disponibili all'azienda e sul momento in cui deve subentrare una persona.
Ma meno impostazioni significano anche meno sostituzioni indipendenti. Se un comportamento è inadatto, il team deve sapere se può modificarlo, cambiare modello o tornare a una configurazione personalizzata. Il confronto corretto riguarda il lavoro totale necessario a mantenere un agente utilizzabile. Uno stack configurabile può essere oneroso; uno integrato può risultare restrittivo. Quale costo pesi di più dipende dal compito e da chi gestirà il sistema dopo la dimostrazione.
Questo è particolarmente rilevante quando un prototipo diventa un servizio condiviso. Chi lo ha assemblato può conoscerne le peculiarità. L'assistenza, il cliente e lo sviluppatore successivo ne incontreranno il comportamento senza quel contesto. Un prodotto che gestisce coerentemente le scelte comuni può essere prezioso anche offrendo meno opzioni. La coerenza diventa utile quando è visibile, verificabile e compatibile con le responsabilità del servizio.
Altri stack vocali collocano il controllo in punti diversi
L'approccio di ElevenLabs si chiarisce accanto alle alternative. La guida agli agenti vocali di OpenAI distingue l'interazione vocale in tempo reale da un flusso concatenato che trascrive il parlato, esegue un agente testuale e genera successivamente la voce. La trattazione dei sistemi concatenati evidenzia la possibilità di esaminare il testo intermedio e sostituire singoli componenti. È un confronto architetturale, non una prova sul funzionamento interno non divulgato di Eleven Realtime. La stessa interazione con il cliente può essere costruita attorno a punti diversi in cui osservare e modificare ciò che accade.
Una fase testuale può essere preziosa quando un'organizzazione richiede un punto di controllo preciso. Un servizio formativo potrebbe esaminare come l'agente interpreta la risposta di un allievo; un'assistenza specializzata potrebbe applicare una gestione terminologica prima di pronunciare la risposta. Il registro intermedio offre al team qualcosa di specifico da ispezionare. Introduce però un altro confine tra componenti da mantenere. Per un personaggio vivace o una conversazione esplorativa, chi sviluppa può preferire un'interazione più integrata e accettare controlli diversi.
| Approccio | Cosa attira chi sviluppa | Quale decisione rimane |
|---|---|---|
| Modalità realtime gestita | Meno scelte di componenti e una configurazione conversazionale supportata | Se le impostazioni disponibili sono adatte al servizio |
| Voce e testo concatenati | Testo intermedio ispezionabile e sostituzione indipendente dei componenti | Come le fasi assemblate preservano tempi e correzioni |
| Orchestrazione tramite framework | Comportamento esplicito dell'applicazione per turni, strumenti e passaggi di consegne | Chi mantiene quel comportamento quando cambiano i fornitori |
Il fattore decisivo è dove il team necessita di un punto di controllo affidabile: in una trascrizione intermedia, in un evento conversazionale o nell'azione completata. Questo spiega perché possa ragionevolmente mantenere un sistema personalizzato anche dopo un promettente lancio integrato. L'opportunità commerciale di ElevenLabs è rendere l'opzione gestita abbastanza valida per più compiti, affinché l'assemblaggio dettagliato diventi una scelta anziché il prezzo d'ingresso per costruire un servizio vocale.
Un'esitazione e un'interruzione meritano risposte diverse
La prospettiva del framework aggiunge un'altra dimensione. La documentazione sulla gestione dei turni di LiveKit tratta le false interruzioni come un comportamento da gestire esplicitamente: l'attività vocale può interrompere un agente anche senza produrre una trascrizione dell'utente, e il parlato può riprendere dopo un timeout configurato. Questo non dimostra che ElevenLabs usi lo stesso meccanismo. Mostra perché l'apparente cortesia di un prodotto vocale dipenda dal comportamento dell'applicazione oltre che dal modello che fornisce le parole.
Immaginiamo la differenza tra qualcuno che dice «aspetta, l'altro indirizzo» e qualcuno che tossisce mentre ascolta. Entrambi possono produrre suoni durante il turno dell'assistente. Solo uno modifica necessariamente la richiesta. Un servizio che ricomincia la spiegazione a ogni rumore di fondo diventa stancante; uno che ignora una vera correzione diventa inaffidabile. Il confronto utile riguarda il recupero della conversazione con il contesto corretto, non soltanto la rapidità con cui il canale audio rileva attività.
Questa distinzione amplia anche le persone da includere in un progetto pilota. Chi cerca una parola poco familiare, usa una seconda lingua o parla con un ritmo più lento può aver bisogno di quantità diverse di silenzio. Sono gruppi proposti per la valutazione, non affermazioni su accessibilità misurata o copertura linguistica. I team dovrebbero ascoltare se gli utenti hanno spazio per finire e se il recupero richiede di ripetere l'intera richiesta. Un tempo medio di risposta può nascondere tale peso.
La possibilità incoraggiante è che un modello conversazionale gestito migliori questa esperienza senza costringere ogni cliente a implementare la propria logica temporale. Resta da capire quanto una specifica applicazione possa regolare il ritmo quando quello predefinito non va bene. È una domanda concreta per una dimostrazione: lasciare esitare una persona, correggere un dettaglio e riprendere, poi esaminare cosa ha capito l'agente e cosa ha davvero ricevuto lo strumento collegato. Collega il comfort conversazionale a un risultato verificabile dal team.
Mini e Max separano la conversazione dall'esecuzione impegnativa
I due nomi dovrebbero incoraggiare una scelta basata sul carico di lavoro, non l'acquisto automatico del modello maggiore. Un personaggio per esercitarsi con una lingua e un agente che segue una procedura di rimborso affrontano problemi diversi. Il primo deve mantenere viva la conversazione e rispondere adeguatamente agli errori. Il secondo può dover recuperare una policy, identificare un ordine, verificare l'idoneità e comunicare il risultato di un'azione esterna.
Un modello maggiore potrebbe essere inutile per uno scambio leggero, mentre quello più economico potrebbe diventare costoso se trasferisce ripetutamente casi irrisolti al personale. Il costo al minuto è utile per stimare la fattura. Il costo per interazione completata correttamente è più utile per decidere se il sistema appartiene a un flusso di lavoro. Quel secondo numero include recuperi, chiamate ripetute e il lavoro umano necessario per riparare errori plausibili.
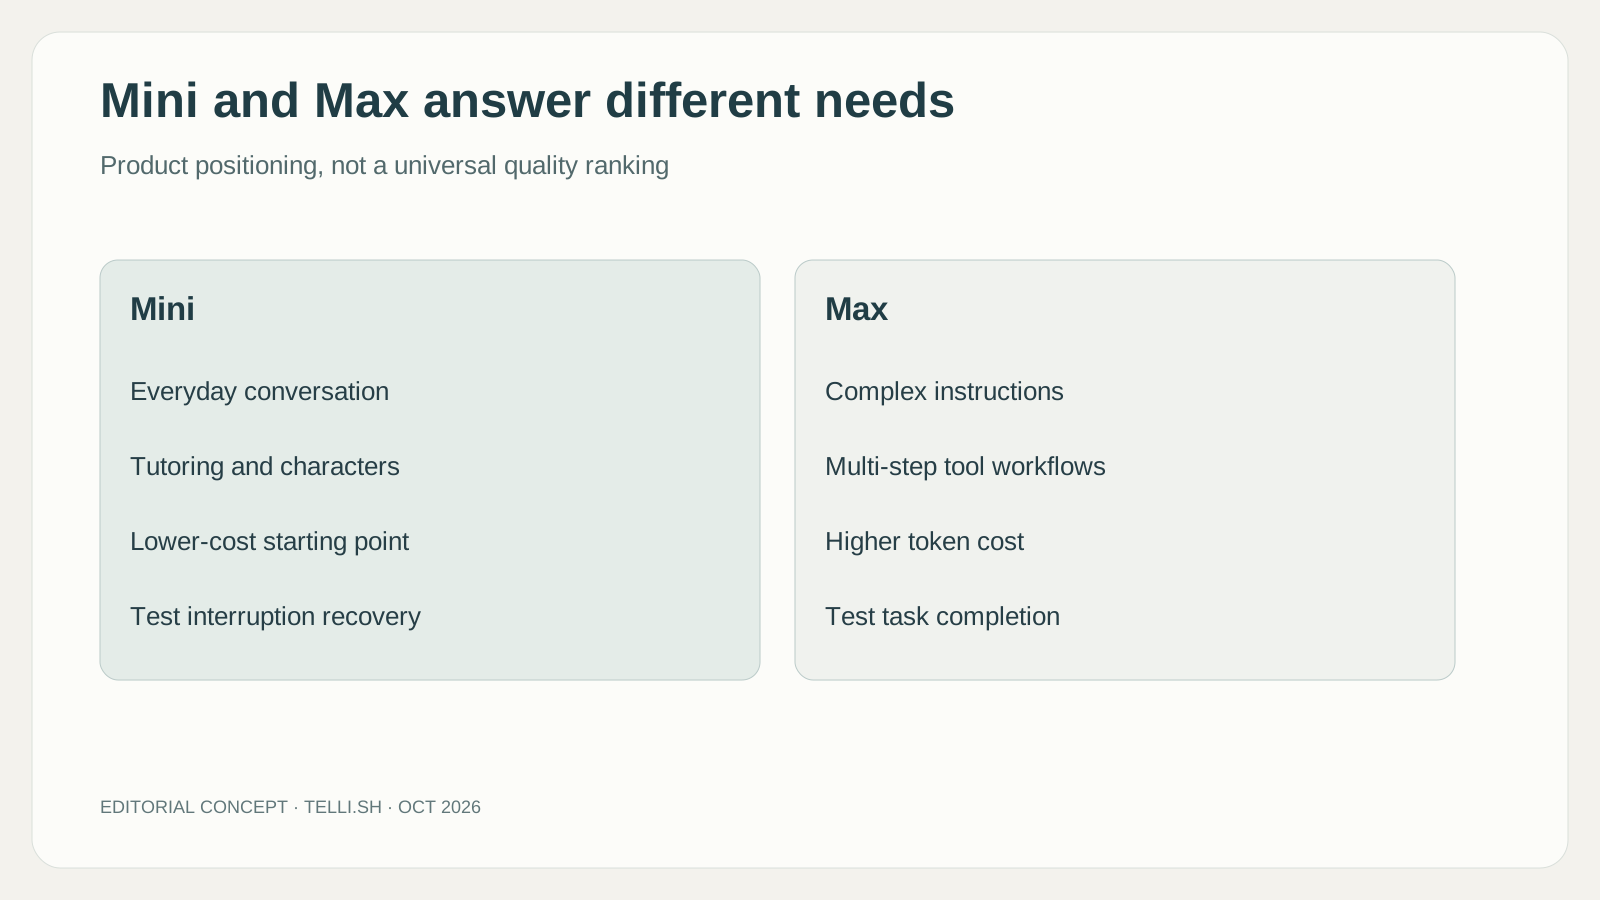
Infografica originale basata sul posizionamento del fornitore. Non è una classifica misurata in tutte le lingue o per tutti i compiti.
L'annuncio pubblica risultati di benchmark attribuiti ad Artificial Analysis. Le cifre sull'uso degli strumenti indicano un completamento dell'87.1% per Max e del 60.3% per Mini, mentre i punteggi riportati sulle dinamiche conversazionali favoriscono leggermente Mini. Sono risultati pubblicati dal fornitore, non misurazioni di una nostra implementazione. Il messaggio utile è che fluidità conversazionale e completamento tramite strumenti possono divergere; non stabiliscono un tasso di successo per le chiamate di un'azienda specifica. Annuncio e contesto dei benchmark.
Un team dovrebbe quindi evitare di comprimere tutta la qualità in una posizione di classifica. Se l'agente spiega soprattutto un'esposizione museale, il ritmo conversazionale può dominare. Se aggiorna una prenotazione, conta di più l'esatto stato finale. Il lancio offre due punti di partenza, ma è ancora il compito a definire la qualità.
Tre situazioni normali rivelano punti di forza diversi
Immaginiamo un allievo che si esercita in un'altra lingua con una conversazione al ristorante. Si ferma a metà dell'ordine, cerca una parola e ricomincia. Un tutor utile lascia spazio all'esitazione e offre aiuto senza prendere il controllo. Il beneficio è la fiducia necessaria a continuare l'esercizio. Il fallimento è un assistente che interpreta ogni pausa come un invito a fare lezione. Questo esempio illustrativo riguarda soprattutto la cooperazione conversazionale; la qualità didattica richiede comunque una valutazione propria.
Consideriamo ora un servizio per appuntamenti. Una persona chiede inizialmente venerdì, poi dice: «Anzi, lunedì prossimo, dopo pranzo». L'assistente dovrebbe riportare la correzione nella prenotazione proposta e confermare i dettagli rilevanti prima del passaggio con conseguenze concrete. Quando il sistema di prenotazione risponde, la conferma vocale dovrebbe riflettere quella risposta. Un cordiale «tutto fatto» prima che il sistema accetti il cambiamento sarebbe un fallimento, anche se ogni frase risultasse naturale.
Un personaggio interattivo crea un terzo equilibrio. Può tollerare una risposta fantasiosa nel proprio mondo narrativo, ma il giocatore si aspetta comunque che ricordi la scena attuale e si fermi quando interrotto. Qui il risultato commerciale potrebbe essere uno scambio coinvolgente anziché una transazione completata. Lo stesso comportamento vivace in un personaggio può sembrare evasivo nell'assistenza clienti. Sono ragioni per valutare compiti distinti anziché considerare «agente vocale» una categoria uniforme.
La compatibilità riduce il costo della prova, con limiti da leggere
ElevenLabs offre accesso tramite ElevenAgents e un'API Realtime compatibile con OpenAI. L'esempio API dell'annuncio cambia destinazione e modello in un client esistente, ma specifica anche una connessione solo WebSocket e distingue quell'API dalla piattaforma gestita. Un'integrazione WebRTC richiede quindi più della sostituzione del nome del modello, e non bisogna presumere che canali gestiti o funzioni della knowledge base arrivino automaticamente con l'API. Accesso API e note sulla migrazione.
Il valore della compatibilità è un confronto più semplice. Uno sviluppatore può conservare una parte maggiore dell'applicazione mentre prova un altro fornitore. Diventa più realistico confrontare lo stesso compito, gli stessi prompt e strumenti anziché dimostrazioni scollegate. Rimane però necessario esaminare eventi, riconnessioni, risposte degli strumenti e il modo in cui l'applicazione presenta un errore.
Questi dettagli meno appariscenti plasmano l'esperienza del cliente. Se la connessione cade dopo una richiesta di prenotazione, l'applicazione deve sapere se la prenotazione è avvenuta prima di chiedere di ripetere. Se uno strumento va in timeout, ripeterne la chiamata può avere conseguenze diverse dal ripetere la domanda parlata. Una migrazione di modello riesce quando l'intera applicazione si comporta correttamente in queste situazioni, non soltanto quando parte la prima risposta audio.
Una voce naturale può far sembrare conclusa un'azione incompleta
Mantieni stabile il confronto quando scegli tra modelli. Se quello maggiore riceve una knowledge base più pulita, un prompt migliore e strumenti più affidabili, la prova non può spiegare quale cambiamento sia servito. Parti dalle stesse richieste rappresentative ed esamina gli errori prima di modificare il flusso circostante. Un errore di ritmo può richiedere un aggiustamento conversazionale; una risposta sbagliata sulle policy può richiedere fonti migliori; una prenotazione incompleta può dipendere dall'integrazione dello strumento. Un modello più capace può aiutare con alcuni problemi, ma non dovrebbe nascondere un collegamento guasto che resterebbe tale con entrambe le scelte.
Il principale vantaggio del prodotto può anche rendere più difficili da notare gli errori. Le persone usano tono, ritmo e sicurezza come segnali conversazionali. Un assistente fluido può sembrare aver controllato qualcosa quando ha soltanto formulato una risposta plausibile. In un'interfaccia testuale l'utente può avere più occasioni di esaminare la risposta. Durante una chiamata la conversazione procede e il dettaglio contestato può perdersi nel flusso.
La risposta progettuale dovrebbe essere concreta, non teatrale. Distingui una spiegazione, un'azione proposta e un risultato confermato. Consenti all'agente di dire che sta verificando, che una richiesta è ancora in sospeso o che serve una persona. Fai corrispondere questi stati all'applicazione, affinché non siano soltanto parole rassicuranti in un prompt. Una pausa sincera spesso offre un servizio migliore di una risposta immediata che crea lavoro di riparazione più tardi.
Anche il passaggio a una persona richiede continuità. Chi raggiunge il personale dopo diversi minuti non dovrebbe ricostruire ogni dettaglio a memoria. Un passaggio utile contiene la richiesta attuale, le correzioni rilevanti e il punto irrisolto. Dovrebbe preservare l'incertezza dove l'agente non era sicuro. Altrimenti l'automazione risparmia tempo all'inizio della chiamata trasferendo lo stesso peso alla persona che deve risolvere il caso.
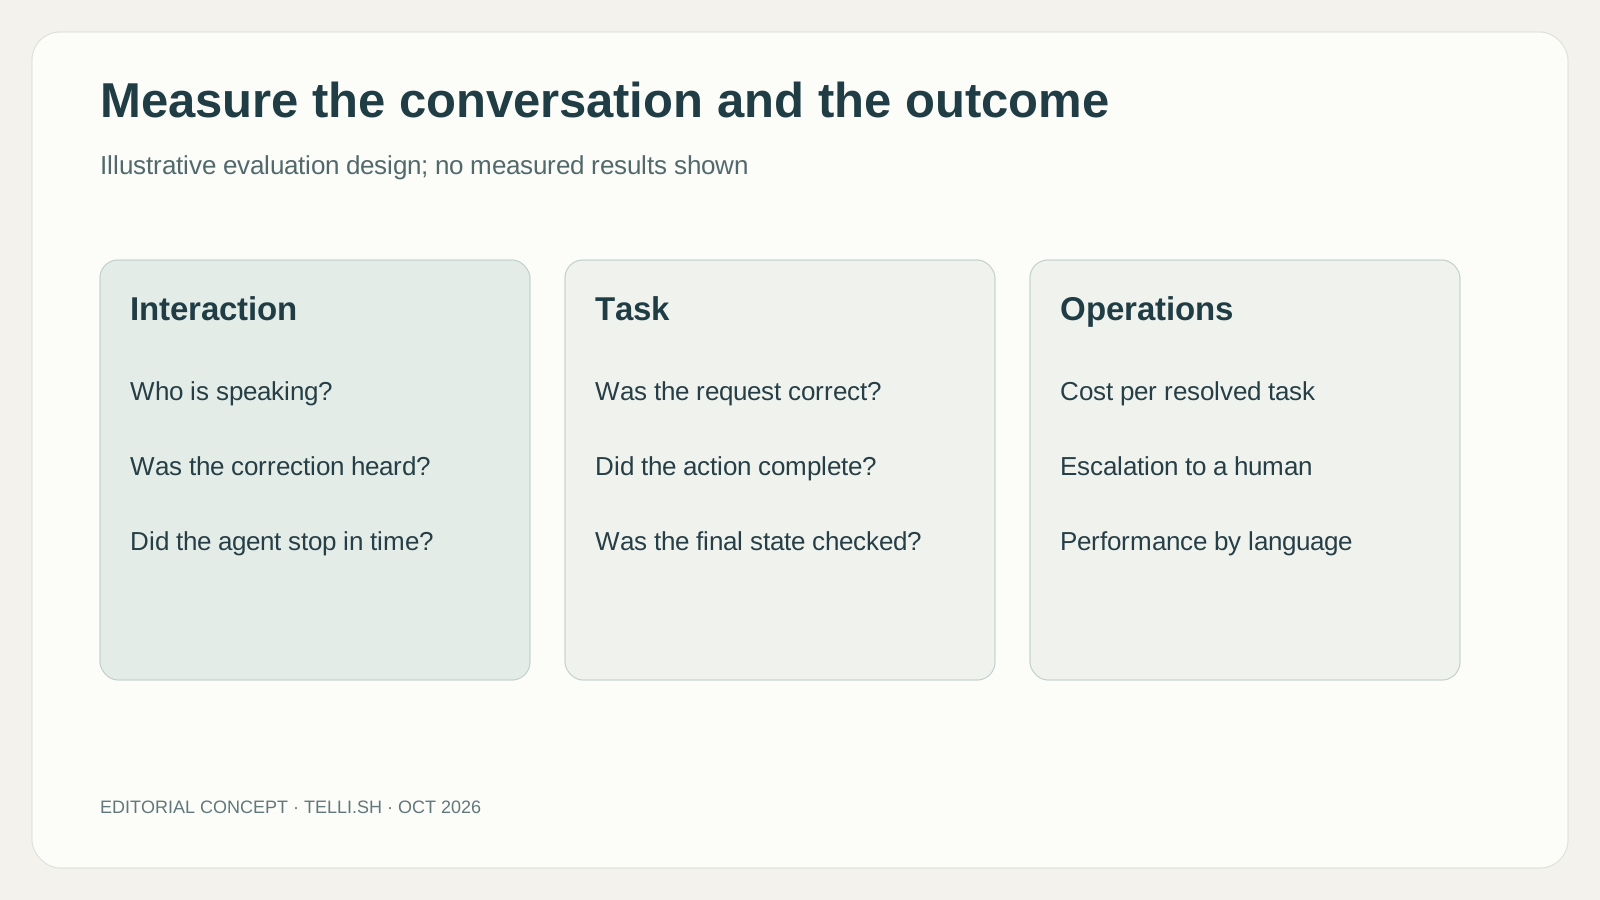
Quadro editoriale di valutazione originale. Non rappresenta risultati di test.
Il prossimo benchmark è una conversazione risolta
Un progetto pilota sensato userebbe conversazioni rappresentative con autorizzazione: richieste brevi e lunghe, interruzioni, correzioni, lingue diverse e casi che richiedono un passaggio al personale. Esaminerebbe se l'azione prevista è avvenuta, quanto spesso sono intervenute persone e quanto è costata l'interazione completata. Terrebbe la velocità del primo audio tra le misure, contando però anche una risposta rapida che ha richiesto una correzione successiva. Queste misure descrivono una valutazione proposta, non prove che abbiamo eseguito su Realtime.
L'esito più promettente è un agente che pone meno domande inutili pur restando disposto a fare quella necessaria. Un tutor dovrebbe lasciare finire il ragionamento allo studente. Un assistente per prenotazioni dovrebbe verificare la data corretta. Un agente di supporto dovrebbe trasferire il contesto nel passaggio di consegne. Sono miglioramenti modesti da descrivere e sostanziali da vivere, perché rimuovono i piccoli attriti che rendono estenuanti le conversazioni automatizzate.
Eleven Realtime dà a questa direzione una forma concreta di prodotto. Potrebbe permettere a più team di costruire interazioni vocali utili senza diventare esperti di ogni componente dello stack audio. La sua importanza a lungo termine dipenderà dalla capacità del comportamento conversazionale integrato di produrre anche lavoro completato in modo affidabile. La voce porta l'utente nella conversazione. Il risultato determina se vorrà affrontare la prossima.
Fonti
-
Annuncio di Eleven Realtime e contesto dei benchmark, 20 ottobre 2026.
-
Modalità dei modelli Realtime, distribuzione e limitazioni, consultato il 21 ottobre 2026.
-
Contesto delle piattaforme ElevenLabs, consultato il 21 ottobre 2026.
-
Architetture degli agenti vocali OpenAI, consultato il 21 ottobre 2026.
-
Gestione dei turni LiveKit, consultato il 21 ottobre 2026.
Conserva la conversazione per poterla rivedere
Se desideri un luogo separato per conservare registrazioni autorizzate e appunti revisionati, Telli.sh è un'opzione. Inizia con una nota audio.