Eleven Realtime déplace la compétition de l’IA vocale au-delà de la voix
ElevenLabs présente les modèles temps réel Mini et Max. L’enjeu est une architecture de conversation plus simple et une distinction plus nette entre une voix naturelle et un travail réellement accompli.
Aperçu officiel d’un composant de conversation vocale ElevenLabs UI pour l’assistance client. Source : elevenlabs/ui ; copyright 2025 Eleven Labs Inc., licence MIT. Il illustre une interface vocale, pas un test du modèle Realtime.

Le moment gênant d’une conversation vocale arrive souvent avant la réponse. Vous faites une pause pour retrouver une date, et l’assistant commence à parler. Vous corrigez un nom, et il termine la phrase qu’il avait déjà préparée. La voix peut être excellente alors que l’échange semble étrangement peu coopératif. Pour qui développe un assistant téléphonique, un tuteur ou un personnage interactif, ces petits ratés peuvent compter autant que la qualité de la parole générée.
Le 20 octobre, ElevenLabs a présenté Eleven Realtime v1 Mini et v1 Max, en les positionnant comme des modèles complets d’agents vocaux plutôt que comme une nouvelle brique à assembler. Mini vise les conversations courantes à moindre coût ; Max, les instructions complexes et les tâches à plusieurs étapes. Cette sortie importe parce qu’elle regroupe davantage de composantes de la conversation dans un même choix de produit. Elle rend aussi une vieille question incontournable : quand une voix paraît compétente, comment savoir si le travail a vraiment été fait ? Annonce officielle.
Notre lecture : la promesse réside surtout dans le temps économisé à régler les raccords entre composants. Elle doit se vérifier dans une conversation qui supporte les corrections et aboutit à un résultat juste. Une démonstration soignée donne la première impression. Une demande client ordinaire et désordonnée montre si le produit mérite sa place.
ElevenLabs étend une force connue à une mission plus vaste
Si vous connaissez surtout ElevenLabs pour ses voix synthétiques, l’entreprise décrit désormais trois plateformes : ElevenCreative pour la création de contenus, ElevenAgents pour les agents conversationnels déployés et ElevenAPI pour les développeurs. Realtime s’inscrit dans cette volonté de rendre l’audio utile à l’intérieur d’une application, plutôt que de produire uniquement un fichier fini. Ce contexte explique l’association entre qualité vocale et mécanique de l’interaction. Présentation d’ElevenLabs pour la presse.
Un extrait audio possède une limite claire. On rédige un texte, on génère la parole et quelqu’un écoute le résultat. Un agent en direct évolue dans une situation mouvante. Son interlocuteur peut l’interrompre, changer de question, compléter une information ou découvrir que sa demande initiale était incorrecte. Le logiciel doit déterminer si un silence signifie « à vous » ou « je réfléchis encore ». Il doit rester en phase avec la personne tout en sollicitant les systèmes derrière la conversation.
C’est un problème de produit différent de celui qui consiste à rendre une phrase isolée convaincante. Un assistant de réservation peut prononcer parfaitement le nom du client et réserver malgré tout le mauvais jour, faute d’avoir intégré une correction. Un produit vocal réussi exige à la fois un rythme social cohérent et un historique transactionnel juste. Améliorer l’un en négligeant l’autre revient à rendre agréable une opération erronée.
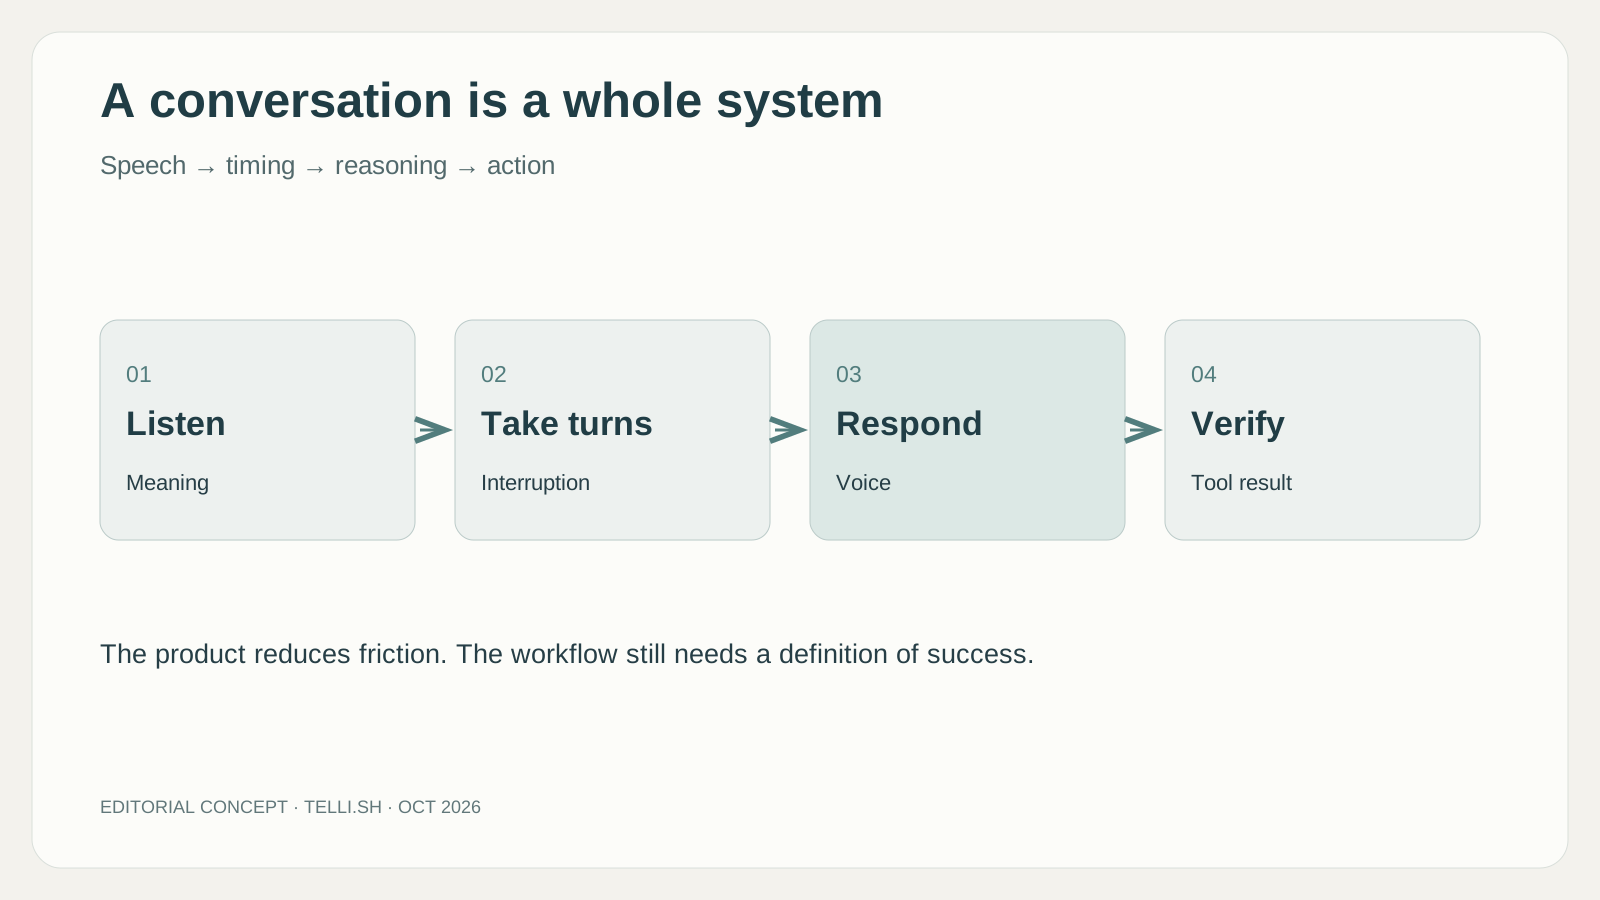
Infographie éditoriale originale. Elle décrit l’expérience utilisateur, pas l’architecture interne du modèle.
Une architecture gérée réduit les réglages et déplace votre contrôle
La distinction documentaire est concrète. En mode Custom, le concepteur choisit le modèle de langage, le modèle vocal et les paramètres de reconnaissance. Le mode Realtime confie ces choix à ElevenLabs, tout en conservant les instructions de l’agent, sa voix, ses outils et les autres paramètres de conversation pris en charge. L’accès est déployé progressivement : le réglage peut donc ne pas encore apparaître dans tous les espaces de travail. Un agent existant doit aussi satisfaire les contraintes de compatibilité et de région de Realtime. Documentation des modèles Realtime.
L’échange peut être intéressant. Une petite équipe se souciera parfois bien davantage de la façon dont son assistant gère une interruption que du choix de chaque composant sous-jacent. Une configuration gérée lui fournit un point de départ cohérent et moins de combinaisons à dépanner. Elle peut consacrer son temps aux questions des clients, aux informations réellement disponibles dans l’entreprise et au moment où un humain doit prendre le relais.
Mais moins de réglages signifie aussi moins de substitutions indépendantes. Lorsqu’un comportement ne convient pas, l’équipe doit savoir si elle peut l’ajuster, changer de modèle ou revenir à une configuration personnalisée. La bonne comparaison porte sur le travail total nécessaire pour maintenir un agent utilisable. Une architecture configurable peut être lourde ; une architecture intégrée, restrictive. Le coût déterminant dépend de la mission et des personnes qui exploiteront le système après la démonstration.
Cela devient particulièrement important quand un prototype devient un service partagé. Son créateur peut connaître ses particularités. L’équipe d’assistance, le client et le développeur suivant découvriront son comportement sans ce contexte. Un produit qui prend les décisions courantes de manière cohérente peut avoir de la valeur même s’il offre moins de choix. Cette cohérence devient utile lorsqu’elle est visible, testable et compatible avec les responsabilités du service.
Les autres architectures vocales placent le contrôle ailleurs
L’approche d’ElevenLabs apparaît plus clairement face aux alternatives. Le guide des agents vocaux d’OpenAI distingue l’interaction vocale temps réel d’un enchaînement qui transcrit la parole, exécute un agent textuel puis génère la voix. Sa présentation des systèmes en chaîne souligne la possibilité d’inspecter le texte intermédiaire et de remplacer séparément les composants. C’est une comparaison architecturale, pas une preuve sur les mécanismes internes non dévoilés d’Eleven Realtime. La même interaction client peut s’organiser autour de différents points d’observation et d’intervention.
Une étape textuelle peut être précieuse lorsqu’une organisation a besoin d’un point de contrôle nommé. Un service pédagogique pourrait examiner l’interprétation d’une réponse d’élève ; une assistance spécialisée pourrait traiter la terminologie avant de prononcer une réponse. La trace intermédiaire donne à l’équipe un élément précis à inspecter. Elle introduit aussi une frontière de composants supplémentaire à maintenir. Pour un personnage vivant ou une conversation exploratoire, le concepteur préférera peut-être une interaction plus intégrée et acceptera d’autres moyens de contrôle.
| Approche | Ce qui attire le concepteur | Ce qui reste à décider |
|---|---|---|
| Mode temps réel géré | Moins de composants à choisir et une configuration conversationnelle prise en charge | Si les réglages disponibles conviennent au service |
| Chaîne voix et texte | Texte intermédiaire inspectable et remplacement indépendant des composants | Comment les étapes assemblées préservent le rythme et les corrections |
| Orchestration par framework | Comportement applicatif explicite pour les tours de parole, les outils et les relais | Qui maintient ce comportement lorsque les fournisseurs changent |
Le facteur décisif est l’endroit où l’équipe a besoin d’un contrôle fiable : une transcription intermédiaire, un événement de conversation ou l’action terminée. Cela explique qu’une équipe puisse raisonnablement conserver son système personnalisé après une sortie intégrée prometteuse. L’opportunité commerciale d’ElevenLabs consiste à rendre l’option gérée assez bonne pour davantage de missions. L’assemblage détaillé devient alors un choix, plutôt que le prix d’entrée de tout service vocal.
Une hésitation et une interruption appellent des réactions différentes
Le point de vue des frameworks ajoute une dimension. La documentation de LiveKit sur les tours de parole traite les fausses interruptions comme un comportement à gérer explicitement : une activité vocale peut interrompre un agent sans produire de transcription utilisateur, et la parole peut reprendre après un délai configuré. Cela ne démontre pas qu’ElevenLabs emploie le même mécanisme. Cela montre pourquoi la politesse apparente d’un produit vocal dépend aussi de son comportement applicatif, au-delà du modèle qui fournit ses mots.
Imaginez la différence entre quelqu’un disant « attendez, l’autre adresse » et quelqu’un qui tousse en écoutant. Les deux produisent un son pendant le tour de l’assistant. Un seul modifie nécessairement la demande. Un service qui recommence son explication à chaque bruit de fond devient fatigant ; celui qui ignore une véritable correction devient peu fiable. La comparaison utile porte sur la reprise avec le bon contexte, plutôt que sur la vitesse de détection d’une activité dans le canal audio.
Cette distinction élargit aussi le public d’un pilote. Les personnes qui cherchent un mot inconnu, s’expriment dans une seconde langue ou parlent plus lentement peuvent avoir besoin de silences différents. Ce sont des groupes proposés pour l’évaluation, pas des affirmations sur une accessibilité ou une couverture linguistique mesurées. Les équipes devraient observer si les utilisateurs peuvent finir et s’ils doivent répéter toute leur demande après une rupture. Un score moyen de temps de réponse peut masquer cette charge.
La perspective encourageante est qu’un modèle conversationnel géré améliore cette expérience sans obliger chaque client à construire sa propre logique temporelle. Reste à savoir ce qu’une application donnée peut ajuster lorsque le rythme par défaut ne convient pas. C’est une question concrète pour une démonstration : laissez une personne hésiter, corriger un détail et reprendre, puis examinez ce que l’agent a compris et ce que l’outil connecté a réellement reçu. Le confort conversationnel rejoint ainsi un résultat vérifiable.
Mini et Max séparent conversation et exécution exigeante
Les deux noms devraient inviter à choisir selon la charge de travail, plutôt qu’à acheter mécaniquement le plus grand modèle. Un personnage d’entraînement linguistique et un agent de service suivant une procédure de remboursement affrontent des problèmes différents. Le premier doit entretenir l’échange et réagir correctement aux erreurs. Le second peut devoir retrouver une politique, identifier une commande, vérifier l’éligibilité et rapporter le résultat d’une action externe.
Un modèle plus grand peut être inutile pour un échange léger ; le moins cher peut devenir coûteux s’il transmet sans cesse des dossiers non résolus aux équipes. Le coût par minute aide à estimer une facture. Le coût par interaction correctement terminée aide davantage à déterminer si le système appartient à un processus. Ce second montant comprend la récupération, les appels répétés et le travail humain nécessaire pour réparer des erreurs plausibles.
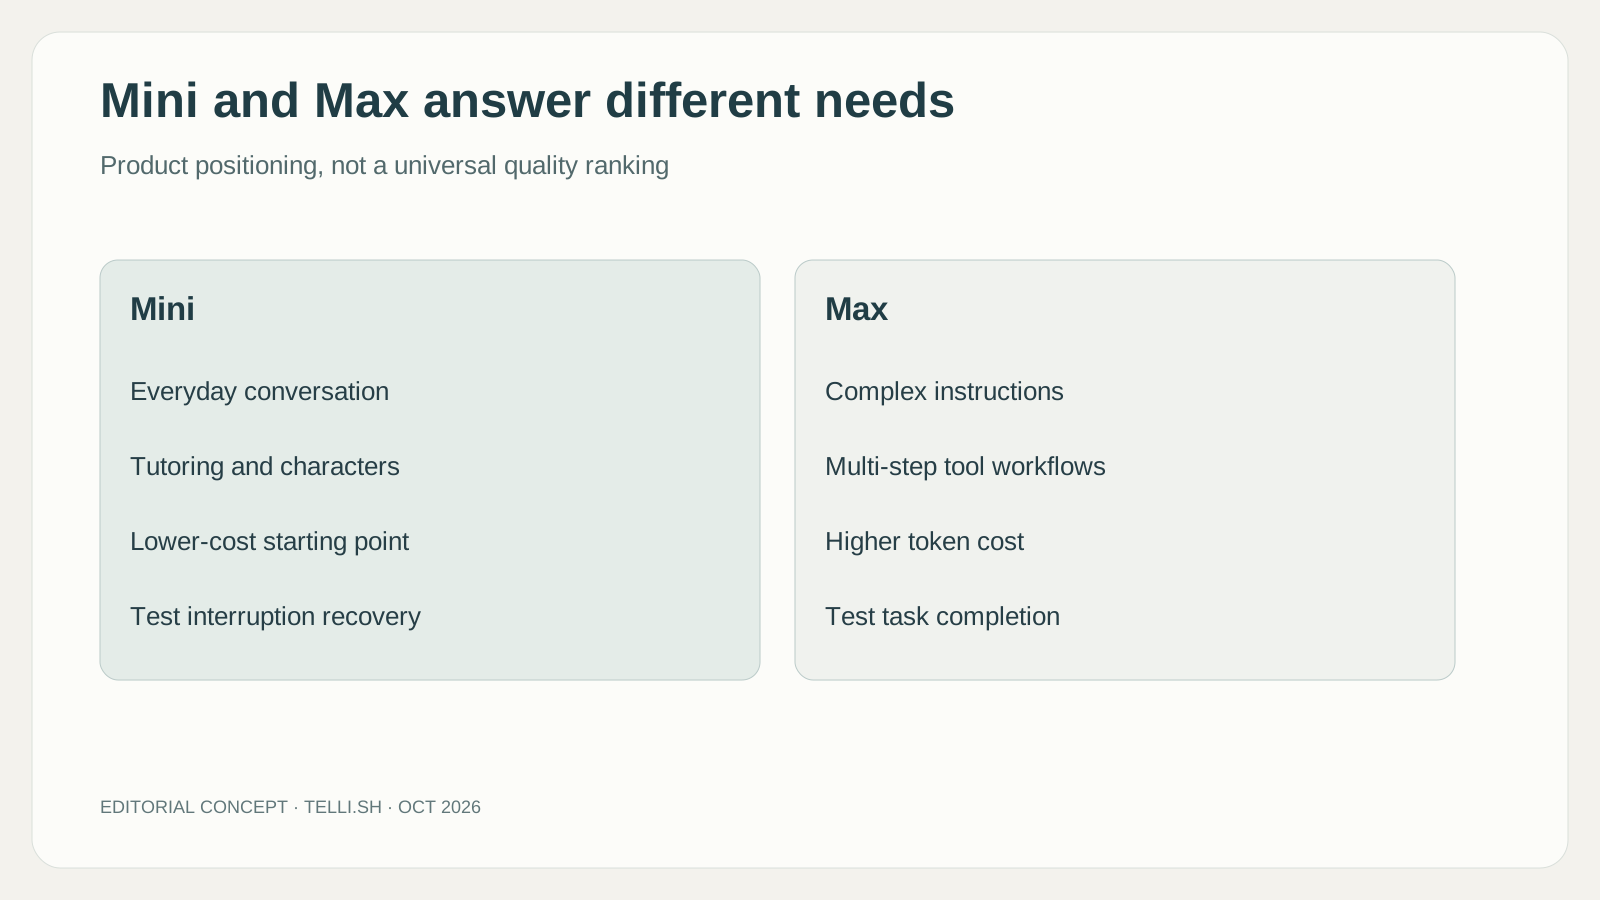
Infographie originale fondée sur le positionnement du fournisseur. Ce n’est pas un classement mesuré pour toutes les langues ou toutes les tâches.
L’annonce publie des résultats de benchmark attribués à Artificial Analysis. Pour l’utilisation d’outils, elle indique 87.1% d’achèvement pour Max et 60.3% pour Mini, tandis que les scores publiés de dynamique conversationnelle favorisent légèrement Mini. Il s’agit de résultats publiés par le fournisseur, pas de nos mesures en déploiement. Leur enseignement utile est que fluidité conversationnelle et exécution d’outils peuvent diverger ; ils ne déterminent pas le taux de réussite des appels d’une entreprise particulière. Annonce et contexte du benchmark.
Une équipe devrait donc éviter de ramener toute la qualité à une position dans un classement. Si l’agent explique surtout une exposition de musée, le rythme de conversation peut primer. S’il modifie une réservation, l’état final exact compte davantage. La sortie fournit deux points de départ, mais c’est toujours la tâche qui définit la qualité.
Trois situations ordinaires révèlent des forces différentes
Imaginez un apprenant qui s’exerce à commander au restaurant dans une autre langue. Il s’arrête au milieu de sa commande, cherche un mot et recommence. Un tuteur utile laisse de la place à cette hésitation et propose son aide sans confisquer la parole. Le bénéfice est la confiance nécessaire pour continuer. L’échec serait un assistant qui prend chaque pause pour une invitation à faire cours. Cet exemple illustratif concerne surtout la coopération conversationnelle ; la qualité pédagogique doit encore être évaluée séparément.
Prenons maintenant un service de rendez-vous. Une personne demande d’abord vendredi, puis dit : « Finalement, lundi prochain, après le déjeuner. » L’assistant devrait intégrer cette correction à la réservation proposée et confirmer les détails pertinents avant l’étape engageante. Une fois la réponse du système de réservation reçue, sa confirmation orale doit refléter cette réponse. Un sympathique « c’est réglé » avant l’acceptation du changement serait un échec, même avec des phrases parfaitement naturelles.
Un personnage interactif impose un troisième équilibre. Il peut tolérer une réponse imaginative dans son univers fictionnel, mais le joueur attend tout de même qu’il se souvienne de la scène et s’arrête lorsqu’on l’interrompt. Le résultat commercial peut être un échange captivant plutôt qu’une transaction. Un comportement vivant chez un personnage peut sembler évasif dans l’assistance client. Voilà pourquoi il faut évaluer des missions distinctes plutôt que considérer « agent vocal » comme une catégorie uniforme.
La compatibilité réduit le coût d’essai, avec des limites à lire
ElevenLabs propose l’accès via ElevenAgents et une API Realtime compatible avec OpenAI. L’exemple de l’annonce modifie la destination et le modèle dans un client existant, mais précise une connexion exclusivement WebSocket et distingue cette API de la plateforme gérée. Une intégration WebRTC demande donc davantage qu’un changement de nom de modèle. Il ne faut pas non plus supposer que les canaux gérés ou les fonctions de base de connaissances sont automatiquement inclus dans l’API. Accès API et notes de migration.
La compatibilité permet surtout une comparaison plus facile. Un développeur peut conserver davantage de son application en essayant un autre fournisseur. Il devient plus réaliste de comparer la même tâche, les mêmes instructions et les mêmes outils que des démonstrations sans rapport. Cela ne dispense pas d’examiner les événements, les reconnexions, les réponses des outils et la présentation d’un échec dans l’application.
Ces détails moins spectaculaires façonnent l’expérience client. Si la connexion tombe après une demande de réservation, l’application doit savoir si celle-ci a abouti avant de demander de recommencer. Si un outil dépasse son délai, répéter son appel peut avoir des conséquences différentes de répéter la question orale. Une migration de modèle réussit lorsque l’application complète traverse correctement ces situations, pas simplement lorsque la première réponse audio est audible.
Une voix naturelle peut faire passer une action inachevée pour terminée
Gardez une comparaison stable pour choisir entre modèles. Si le plus grand bénéficie d’une base de connaissances mieux nettoyée, d’un meilleur prompt et d’outils plus fiables, l’essai ne peut pas expliquer quel changement a aidé. Commencez par les mêmes demandes représentatives et examinez les échecs avant de modifier le processus environnant. Un problème de rythme peut appeler un réglage conversationnel ; une mauvaise réponse de politique, de meilleures sources ; une réservation incomplète, une correction d’intégration. Un modèle plus puissant peut aider certains de ces problèmes, mais ne doit pas masquer une connexion cassée qui le resterait dans les deux cas.
L’atout le plus fort du produit peut aussi rendre les erreurs moins visibles. Les gens interprètent le ton, le débit et l’assurance comme des signaux conversationnels. Un assistant fluide peut donner l’impression d’avoir vérifié quelque chose alors qu’il a seulement formulé une réponse plausible. Dans une interface textuelle, l’utilisateur dispose parfois de davantage de temps pour inspecter la réponse. Au téléphone, la conversation avance et le détail litigieux se perd dans le flux.
La réponse de conception doit être concrète. Distinguez une explication, une action proposée et un résultat confirmé. Autorisez l’agent à dire qu’il vérifie, qu’une demande reste en attente ou qu’une personne doit aider. Faites correspondre ces états à l’application, pour qu’ils ne soient pas de simples phrases rassurantes dans un prompt. Une pause honnête vaut souvent mieux qu’une réponse immédiate créant des réparations ultérieures.
Le relais humain exige lui aussi une continuité. Un appelant qui rejoint un employé après plusieurs minutes ne devrait pas reconstruire chaque détail de mémoire. Un relais utile contient la demande actuelle, les corrections importantes et l’étape non résolue. Il doit préserver l’incertitude lorsque l’agent hésitait. Sinon, l’automatisation économise du temps au début de l’appel en déplaçant la même charge sur la personne chargée de le résoudre.
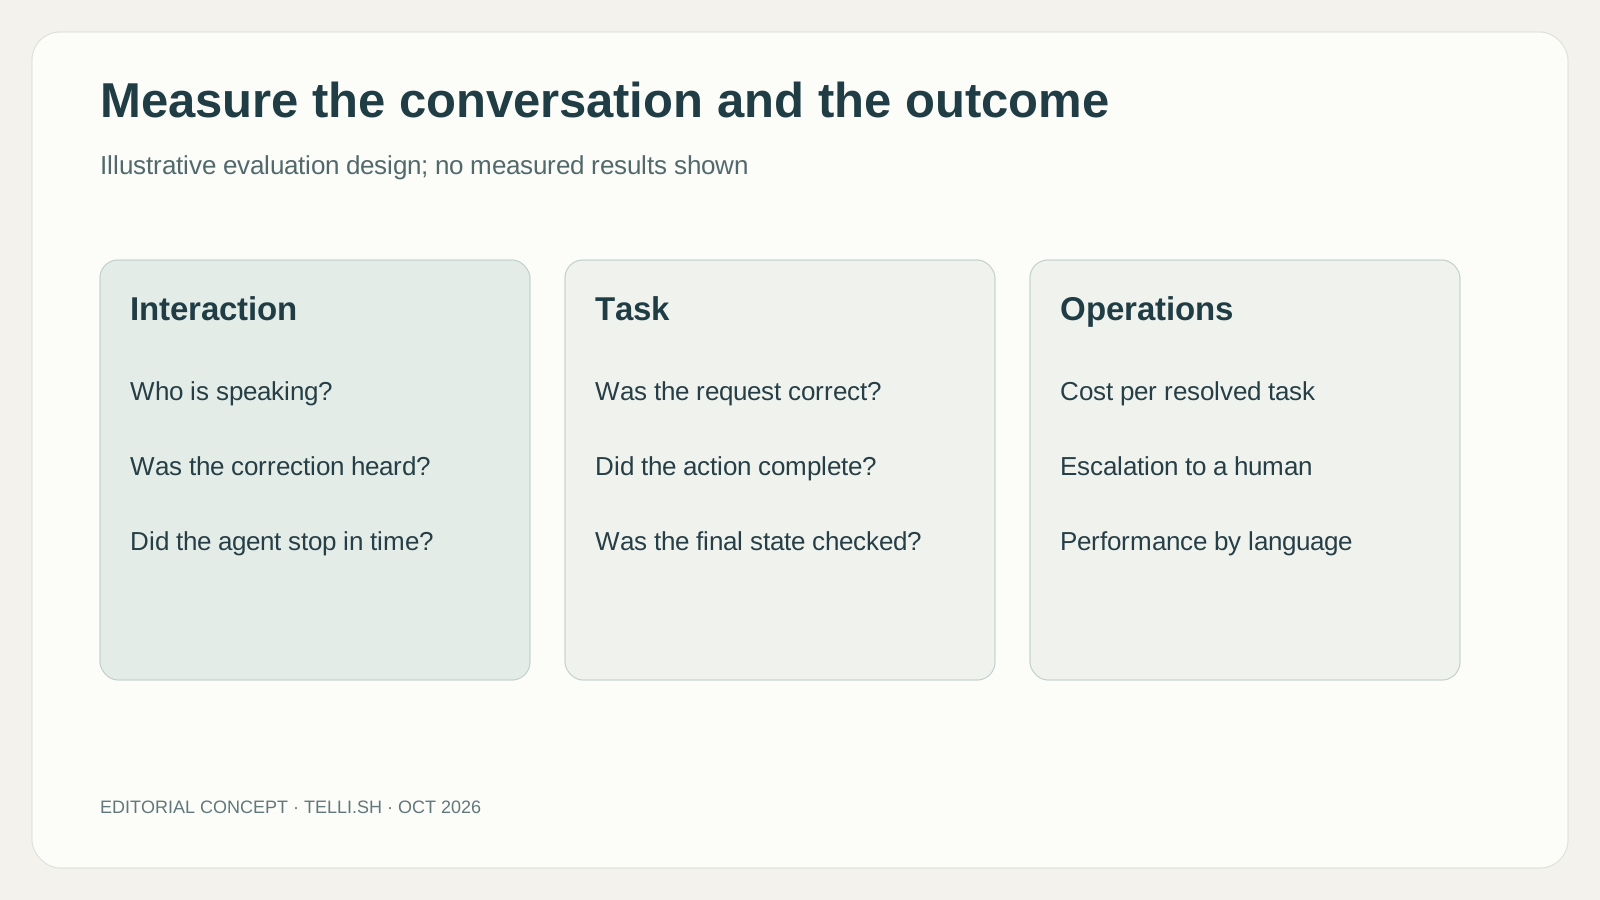
Cadre éditorial original d’évaluation. Aucun résultat de test n’est représenté.
Le prochain benchmark est une conversation résolue
Un pilote raisonnable utiliserait des conversations représentatives autorisées : demandes courtes et longues, interruptions, corrections, différentes langues et cas nécessitant un relais. Examinez si l’action voulue a eu lieu, la fréquence des interventions humaines et le coût de l’interaction achevée. Gardez la rapidité du premier son parmi les mesures, mais comptez aussi les réponses rapides qu’il a fallu corriger. Ce sont des critères d’évaluation proposés, pas des tests que nous avons réalisés sur Realtime.
Le résultat le plus prometteur serait un agent posant moins de questions inutiles, tout en restant prêt à poser celle qui est nécessaire. Un tuteur doit laisser l’élève finir de réfléchir. Un assistant de réservation doit vérifier la date corrigée. Un agent d’assistance doit transmettre le contexte. Ces progrès sont modestes à décrire et considérables à vivre, car ils retirent les petites frictions qui rendent les conversations automatisées épuisantes.
Eleven Realtime donne à cette direction une forme concrète de produit. Il pourrait permettre à davantage d’équipes de créer des interactions vocales utiles sans maîtriser chaque composant de la chaîne audio. Son importance à long terme dépendra de la capacité du comportement conversationnel intégré à produire aussi un travail terminé fiable. La voix fait entrer l’utilisateur dans la conversation. Le résultat détermine s’il voudra entamer la suivante.
Sources
-
Annonce d’Eleven Realtime et contexte des benchmarks, 20 octobre 2026.
-
Modes des modèles Realtime, déploiement et limites, consulté le 21 octobre 2026.
-
Présentation des plateformes ElevenLabs, consulté le 21 octobre 2026.
-
Architectures d’agents vocaux d’OpenAI, consulté le 21 octobre 2026.
-
Gestion des tours de parole de LiveKit, consulté le 21 octobre 2026.
Gardez la conversation disponible pour la relire
Si vous cherchez un espace distinct pour conserver vos enregistrements autorisés et vos notes vérifiées, Telli.sh est une possibilité. Commencer par une note audio.