Eleven Realtime lleva la competencia de la IA de voz más allá de la voz
ElevenLabs presenta los modelos Mini y Max en tiempo real. Lo interesante es una arquitectura conversacional más sencilla y una distinción más clara entre sonar natural y completar el trabajo.
Vista previa oficial del componente de chat de voz de ElevenLabs UI para atención al cliente. Fuente: elevenlabs/ui; copyright 2025 Eleven Labs Inc., licencia MIT. Ilustra una interfaz de voz, no una prueba del modelo Realtime.

El momento incómodo de una conversación de voz suele llegar antes de la respuesta. Haces una pausa para recordar una fecha y el asistente empieza a hablar. Corriges un nombre y termina la frase que ya tenía preparada. La voz puede sonar excelente mientras el intercambio resulta extrañamente poco colaborativo. Para quien desarrolla un asistente telefónico, un tutor o un personaje interactivo, esos pequeños fallos pueden importar tanto como la calidad del habla generada.
El 20 de octubre, ElevenLabs presentó Eleven Realtime v1 Mini y v1 Max, planteados como modelos completos para agentes de voz, en lugar de otro componente que el desarrollador debe integrar. Mini se dirige a la conversación cotidiana con un coste menor; Max, a instrucciones complejas y tareas de varios pasos. El lanzamiento importa porque convierte una parte mayor de la conversación en una sola decisión de producto. También hace más difícil esquivar una vieja pregunta: cuando una voz suena competente, ¿cómo sabemos que el trabajo se ha realizado? Anuncio oficial.
Nuestra lectura: lo prometedor es dedicar menos tiempo a ajustar las uniones entre componentes. La prueba de esa promesa es una conversación que admite correcciones y produce un resultado correcto. Una demostración pulida puede mostrar la primera impresión. Una petición corriente y desordenada de un cliente es donde el producto se gana su lugar.
ElevenLabs amplía una fortaleza conocida hacia una tarea mayor
Para quienes conocen ElevenLabs principalmente por sus voces sintéticas, la empresa describe ahora tres plataformas: ElevenCreative para crear contenidos, ElevenAgents para agentes conversacionales desplegados y ElevenAPI para desarrolladores. Realtime forma parte de ese esfuerzo más amplio por hacer que el audio sea útil dentro de una aplicación, y no solo como archivo terminado. Ese contexto explica por qué el lanzamiento combina la calidad de voz con la mecánica de la interacción. Información de ElevenLabs para prensa.
Un clip de audio tiene límites claros. Se escribe el texto, se genera el habla y alguien escucha el resultado. Un agente en directo opera dentro de una situación cambiante. La persona puede interrumpir, modificar la pregunta, aportar información que faltaba o descubrir que su petición original era incorrecta. El software debe decidir si una pausa significa «te toca» o «todavía estoy pensando». Tiene que mantener su interpretación alineada con la persona y, al mismo tiempo, gestionar los sistemas que hay detrás de la conversación.
Es un problema de producto distinto al de conseguir que una frase aislada resulte convincente. Pensemos en un asistente de reservas. Puede pronunciar perfectamente el nombre del cliente y aun así reservar el día equivocado por no captar una corrección. Un buen producto de voz necesita tanto un ritmo social adecuado como un registro transaccional coherente. Mejorar uno e ignorar el otro crea una forma agradable de hacer lo incorrecto.
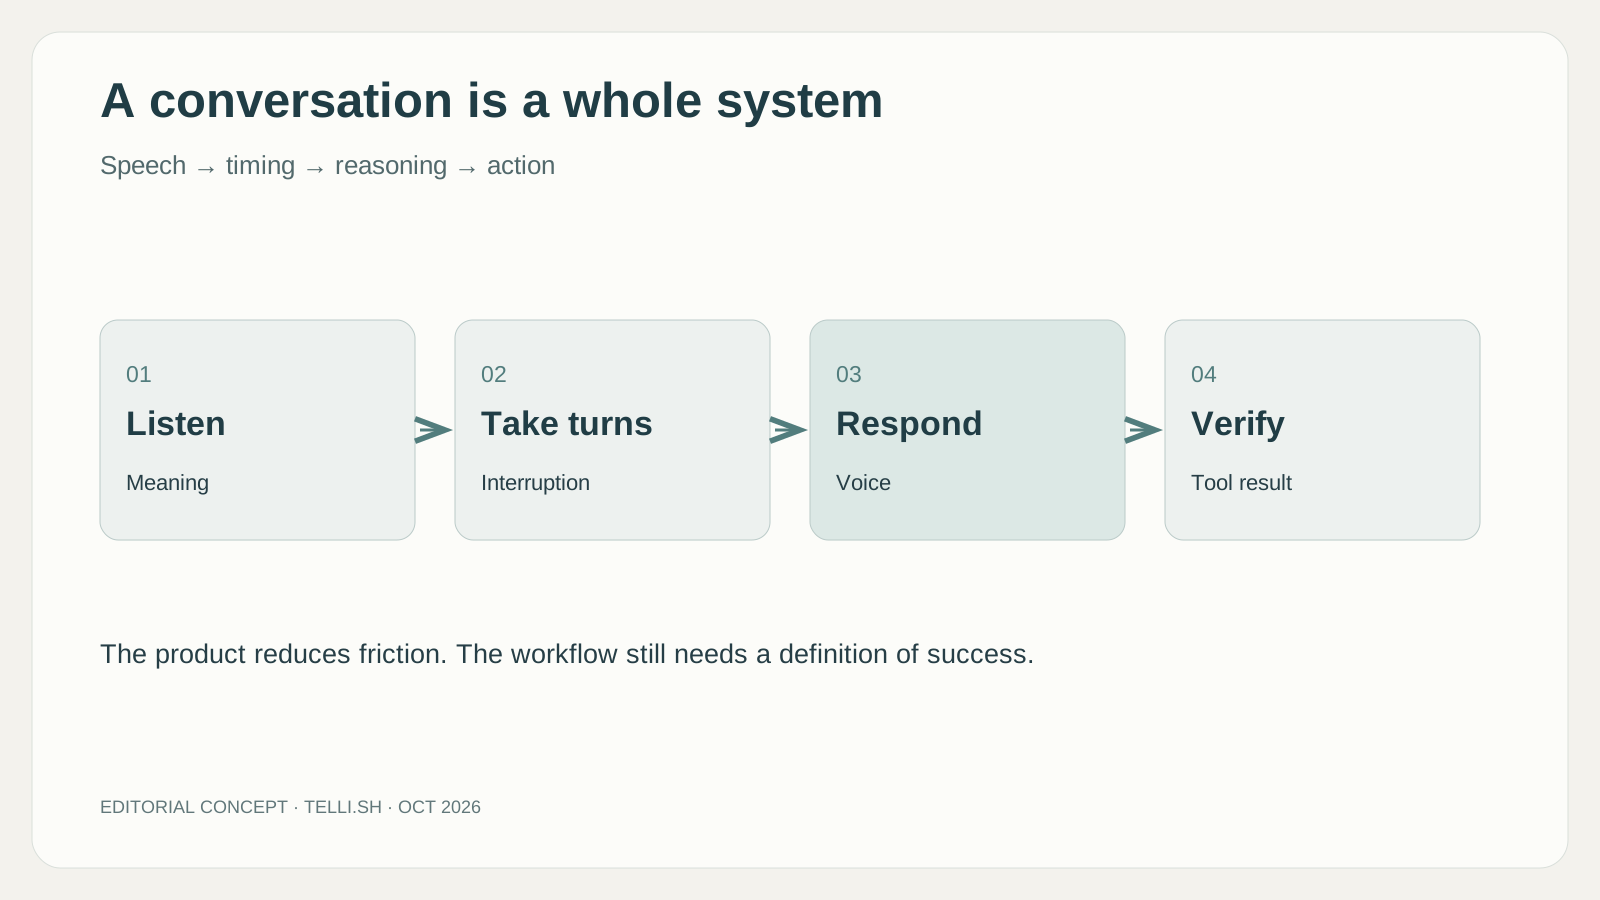
Infografía editorial original. Describe la experiencia del usuario, no la arquitectura interna del modelo.
Una arquitectura gestionada reduce la configuración y cambia qué puedes controlar
La distinción de la documentación es práctica. En el modo Custom, quien construye el agente elige el modelo de lenguaje, el de voz y los ajustes de reconocimiento. El modo Realtime delega esas decisiones en ElevenLabs, manteniendo las instrucciones del agente, su voz, sus herramientas y otros ajustes conversacionales compatibles. El acceso se está desplegando gradualmente, así que la opción puede no aparecer todavía en todos los espacios de trabajo. Realtime también impone restricciones regionales y de compatibilidad que un agente existente debe cumplir. Documentación de los modelos Realtime.
Puede ser un intercambio útil. A un equipo pequeño puede importarle mucho más que su asistente gestione una interrupción que seleccionar cada componente subyacente. Una configuración gestionada le ofrece un punto de partida coherente y menos combinaciones que diagnosticar. Puede dedicar su tiempo a las preguntas de los clientes, a la información que realmente tiene la empresa y al momento en que debe intervenir una persona.
Pero tener menos ajustes también significa disponer de menos sustituciones independientes. Si una parte del comportamiento no encaja, el equipo necesita saber si puede modificarlo, cambiar de modelo o volver a una configuración personalizada. La comparación adecuada es el trabajo total de mantener un agente utilizable. Una arquitectura configurable puede resultar laboriosa; una integrada, restrictiva. Qué coste pesa más depende de la tarea y de quién operará el sistema después de la demostración.
Esto resulta especialmente relevante cuando un prototipo se convierte en un servicio compartido. Quien lo montó puede conocer sus peculiaridades. El equipo de soporte, el cliente y el siguiente desarrollador se encontrarán con su comportamiento sin ese contexto. Un producto que resuelve de forma consistente decisiones habituales puede ser valioso aunque ofrezca menos opciones. Esa consistencia sirve cuando es visible, comprobable y compatible con las responsabilidades del servicio.
Otras arquitecturas de voz sitúan el control en lugares distintos
El enfoque de ElevenLabs se entiende mejor junto a las alternativas. La guía de agentes de voz de OpenAI distingue la interacción de voz en tiempo real de un flujo encadenado que transcribe el habla, ejecuta un agente de texto y genera voz después. Su explicación de los sistemas encadenados destaca la inspección del texto intermedio y la sustitución de componentes individuales. Es una comparación arquitectónica, no una prueba sobre el funcionamiento interno no divulgado de Eleven Realtime. La misma interacción con un cliente puede organizarse alrededor de distintos puntos donde observar y modificar lo que sucede.
Una etapa de texto puede ser valiosa cuando una organización necesita un punto de control concreto. Un servicio educativo podría revisar cómo interpreta el agente la respuesta de un alumno; un soporte especializado podría tratar la terminología antes de pronunciar la respuesta. El registro intermedio da al equipo algo específico que inspeccionar. También introduce otra unión entre componentes que mantener. Para un personaje vivaz o una conversación exploratoria, quien desarrolla puede preferir una interacción más integrada y aceptar otro conjunto de controles.
| Enfoque | Qué atrae a quien desarrolla | Qué decisión sigue pendiente |
|---|---|---|
| Modo gestionado en tiempo real | Menos elecciones de componentes y una configuración conversacional respaldada | Si los ajustes admitidos encajan con el servicio |
| Voz y texto encadenados | Texto intermedio inspeccionable y sustitución independiente de componentes | Cómo conservan las etapas ensambladas los tiempos y las correcciones |
| Orquestación mediante un framework | Comportamiento explícito de la aplicación para turnos, herramientas y transferencias | Quién mantiene ese comportamiento cuando cambian los proveedores |
El factor decisivo es dónde necesita el equipo un punto de control fiable: en una transcripción intermedia, en un evento conversacional o en la acción completada. Eso explica que un equipo pueda mantener razonablemente un sistema personalizado incluso tras un lanzamiento integrado prometedor. La oportunidad comercial de ElevenLabs consiste en hacer que la opción gestionada sirva para más tareas, de modo que el ensamblaje detallado sea una elección y no el precio de entrada para crear un servicio de voz.
Una vacilación y una interrupción merecen respuestas distintas
La perspectiva del framework añade otra dimensión. La documentación de gestión de turnos de LiveKit trata las falsas interrupciones como un comportamiento que debe gestionarse explícitamente: la actividad de voz puede interrumpir al agente aunque no genere una transcripción del usuario, y el habla puede reanudarse tras un tiempo de espera configurado. Esto no demuestra que ElevenLabs utilice el mismo mecanismo. Muestra por qué la aparente cortesía de un producto de voz depende tanto del comportamiento de la aplicación como del modelo que aporta las palabras.
Imaginemos la diferencia entre alguien que dice «espera, la otra dirección» y alguien que tose mientras escucha. Ambos producen sonido durante el turno del asistente. Solo uno cambia necesariamente la petición. Un servicio que reinicia su explicación ante cada ruido de fondo resulta agotador; uno que ignora una corrección real pierde credibilidad. La comparación útil es si la conversación se recupera con el contexto correcto, y no si el canal de audio detectó actividad rápidamente.
Esa distinción también amplía quién debe participar en una prueba piloto. Quienes buscan una palabra poco familiar, usan un segundo idioma o hablan con un ritmo más lento pueden necesitar distintas duraciones de silencio. Son grupos de evaluación propuestos, no afirmaciones sobre accesibilidad medida o cobertura lingüística. Los equipos deben observar si el usuario tiene espacio para terminar y si recuperarse le obliga a repetir toda la petición. Una media de tiempo de respuesta puede ocultar esa carga.
La posibilidad alentadora es que un modelo conversacional gestionado mejore esta experiencia sin que cada cliente implemente su propia lógica temporal. La pregunta pendiente es cuánto puede ajustar una aplicación cuando el ritmo predeterminado no funciona. Es una cuestión concreta para una demostración: dejar que alguien vacile, corrija un detalle y continúe, y después inspeccionar qué entendió el agente y qué recibió realmente la herramienta conectada. Así se vincula la comodidad de la conversación con un resultado verificable por el equipo.
Mini y Max separan la conversación de la ejecución exigente
Los dos nombres deberían llevar a decidir según la carga de trabajo, no a comprar por reflejo el modelo mayor. Un personaje para practicar idiomas y un agente que sigue un proceso de reembolso afrontan problemas distintos. El primero necesita mantener la conversación y responder adecuadamente a los errores. El segundo puede tener que recuperar una política, identificar un pedido, comprobar requisitos y comunicar el resultado de una acción externa.
Un modelo mayor puede ser innecesario para un intercambio ligero, mientras que el más barato puede salir caro si deriva repetidamente casos sin resolver al personal. El coste por minuto sirve para estimar una factura. El coste por interacción correctamente completada sirve mejor para decidir si el sistema encaja en un flujo de trabajo. Esa segunda cifra incluye la recuperación, las llamadas repetidas y el trabajo de reparar errores plausibles.
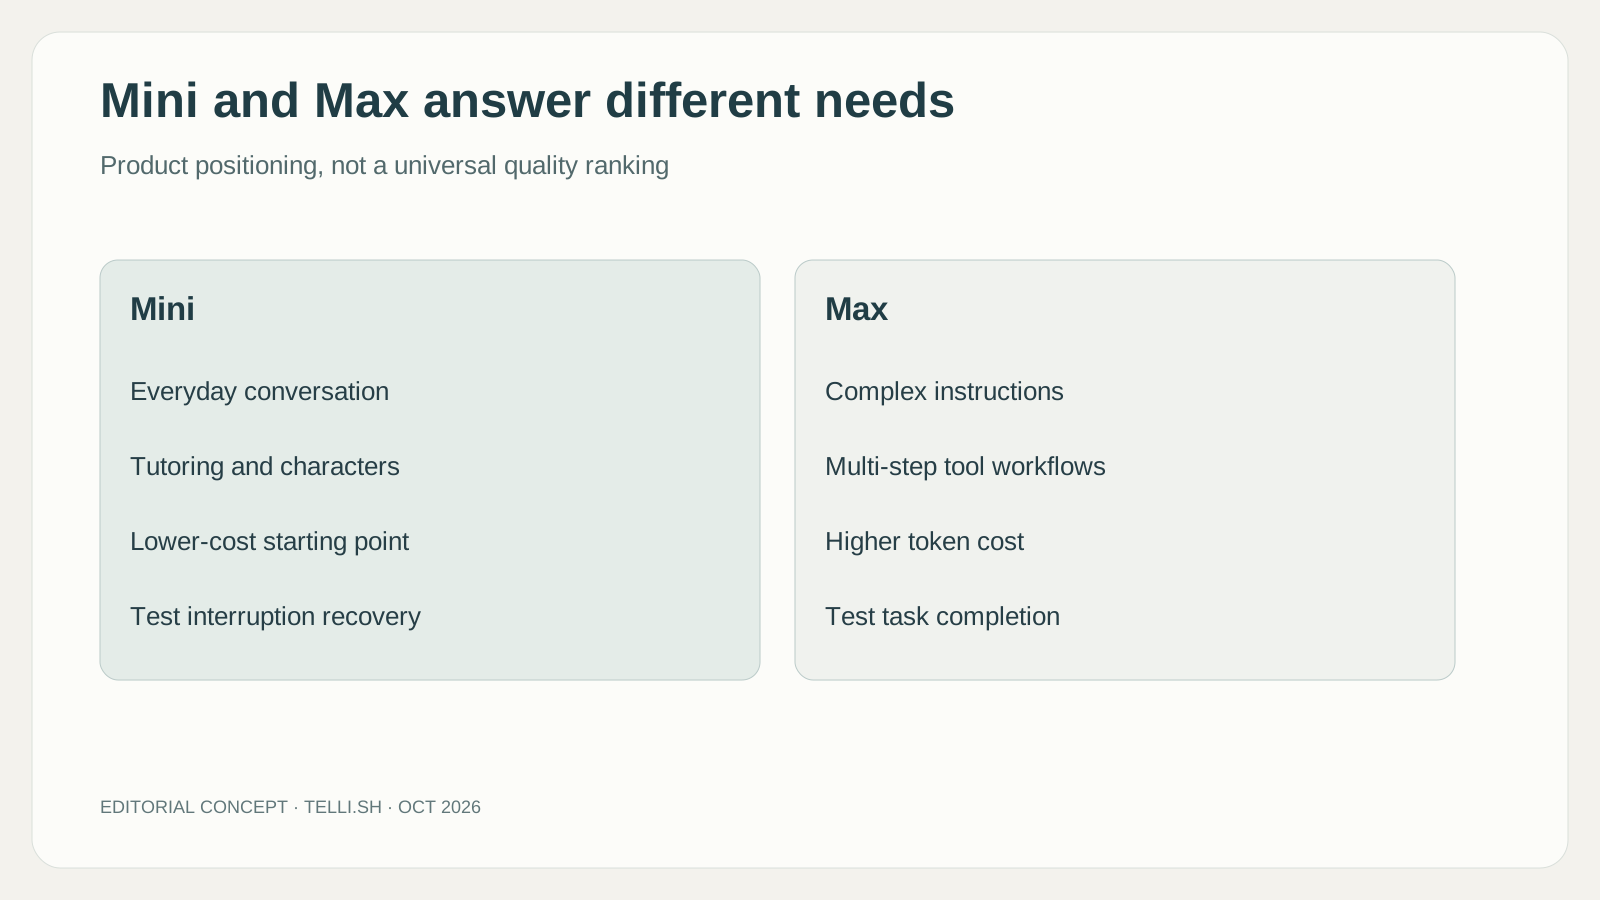
Infografía original basada en el posicionamiento del proveedor. No es una clasificación medida en todos los idiomas o tareas.
El anuncio publica resultados de pruebas atribuidos a Artificial Analysis. Sus cifras de uso de herramientas son un 87.1% de finalización para Max y un 60.3% para Mini, mientras que las puntuaciones comunicadas sobre dinámica conversacional favorecen ligeramente a Mini. Son resultados publicados por el proveedor, no mediciones de una implementación nuestra. Su mensaje útil es que la fluidez conversacional y la ejecución con herramientas pueden divergir; no establecen una tasa de éxito para las llamadas de una empresa concreta. Anuncio y contexto de las pruebas.
Por tanto, un equipo debería evitar comprimir toda la calidad en una posición de clasificación. Si el agente explica principalmente una exposición de museo, el ritmo conversacional puede ser lo más importante. Si modifica una reserva, el estado final exacto importa más. El lanzamiento ofrece dos puntos de partida, pero la tarea sigue definiendo qué significa calidad.
Tres situaciones corrientes revelan fortalezas distintas
Imaginemos a una persona que practica en otro idioma una conversación de restaurante. Se detiene a mitad del pedido, busca una palabra y empieza de nuevo. Un tutor útil deja espacio para esa vacilación y ofrece ayuda sin apropiarse de la conversación. El beneficio es ganar confianza para seguir practicando. El fallo sería un asistente que confunde cada pausa con permiso para dar una lección. Este caso ilustrativo trata sobre todo de cooperación conversacional; la calidad docente requiere una revisión propia.
Pensemos ahora en un servicio de citas. Una persona pide primero el viernes y después dice: «En realidad, el próximo lunes, después de comer». El asistente debería incorporar la corrección a la reserva propuesta y confirmar los datos relevantes antes del paso con consecuencias. Cuando responda el sistema de reservas, la confirmación hablada debe reflejar esa respuesta. Un amable «ya está todo» antes de que el sistema acepte el cambio sería un fallo aunque cada frase sonara natural.
Un personaje interactivo crea un tercer equilibrio. Puede admitir una respuesta imaginativa dentro de su ficción, pero el jugador sigue esperando que recuerde la escena actual y se calle cuando lo interrumpen. Aquí el resultado comercial podría ser un intercambio atractivo y no una transacción completada. El mismo comportamiento que resulta animado en un personaje puede parecer evasivo en atención al cliente. Son motivos para evaluar trabajos distintos, en lugar de tratar al «agente de voz» como una categoría uniforme.
La compatibilidad reduce el coste de probar, con límites que conviene leer
ElevenLabs ofrece acceso mediante ElevenAgents y una API Realtime compatible con OpenAI. El ejemplo de API del anuncio cambia el destino y el modelo de un cliente existente, pero también especifica una conexión exclusivamente WebSocket y separa esa API de la plataforma gestionada. Una integración WebRTC exige, por tanto, más que sustituir el nombre del modelo, y no debe suponerse que los canales gestionados o las funciones de base de conocimiento acompañen automáticamente a la API. Acceso a la API y notas de migración.
El valor de la compatibilidad es facilitar una comparación. Un desarrollador puede conservar más elementos de su aplicación al probar otro proveedor. Eso hace más realista comparar la misma tarea, los mismos prompts y herramientas, en lugar de demostraciones sin relación. No elimina la necesidad de inspeccionar los eventos, las reconexiones, las respuestas de herramientas y cómo presenta la aplicación un fallo.
Esos detalles menos vistosos determinan la experiencia del cliente. Si la conexión cae después de solicitar una reserva, la aplicación necesita saber si se realizó antes de pedir que se repita. Si una herramienta agota el tiempo de espera, repetir su llamada puede tener consecuencias distintas a repetir la pregunta hablada. Una migración de modelo tiene éxito cuando la aplicación completa se comporta correctamente en esas situaciones, no solo cuando reproduce la primera respuesta de audio.
Una voz natural puede hacer que una acción pendiente parezca terminada
Mantén estable la comparación al decidir entre modelos. Si el mayor recibe una base de conocimiento más limpia, un prompt mejor y herramientas más fiables, la prueba no explica qué cambio ayudó. Empieza con las mismas peticiones representativas e inspecciona los fallos antes de modificar el flujo que las rodea. Un fallo de ritmo puede requerir un ajuste conversacional; una respuesta incorrecta sobre políticas, mejores fuentes; una reserva incompleta, revisar la integración. Comprar un modelo más capaz puede resolver algunos problemas, pero no debe ocultar una conexión rota que seguiría rota con cualquiera de las dos opciones.
La principal ventaja del producto también puede dificultar detectar sus errores. Las personas utilizan el tono, el ritmo y la seguridad como señales conversacionales. Un asistente fluido puede sonar como si hubiera comprobado algo cuando solo ha formulado una respuesta plausible. En una interfaz de texto, el usuario puede tener más oportunidades de revisar la respuesta. Durante una llamada, la conversación avanza y el detalle discutido puede perderse en el flujo.
La respuesta de diseño debe ser concreta, no teatral. Diferencia una explicación, una acción propuesta y un resultado confirmado. Permite que el agente diga que está comprobando algo, que una petición sigue pendiente o que necesita ayuda humana. Haz que esos estados correspondan a la aplicación para que no sean solo palabras tranquilizadoras en un prompt. Una pausa sincera suele ofrecer mejor servicio que una respuesta inmediata que genera reparaciones posteriores.
La derivación a una persona también necesita continuidad. Quien llega al personal después de varios minutos no debería reconstruir cada detalle de memoria. Una transferencia útil contiene la petición actual, las correcciones relevantes y el paso sin resolver. Debe conservar la incertidumbre donde el agente no estaba seguro. De lo contrario, la automatización ahorra tiempo al comienzo de la llamada y traslada la misma carga a quien debe resolverla.
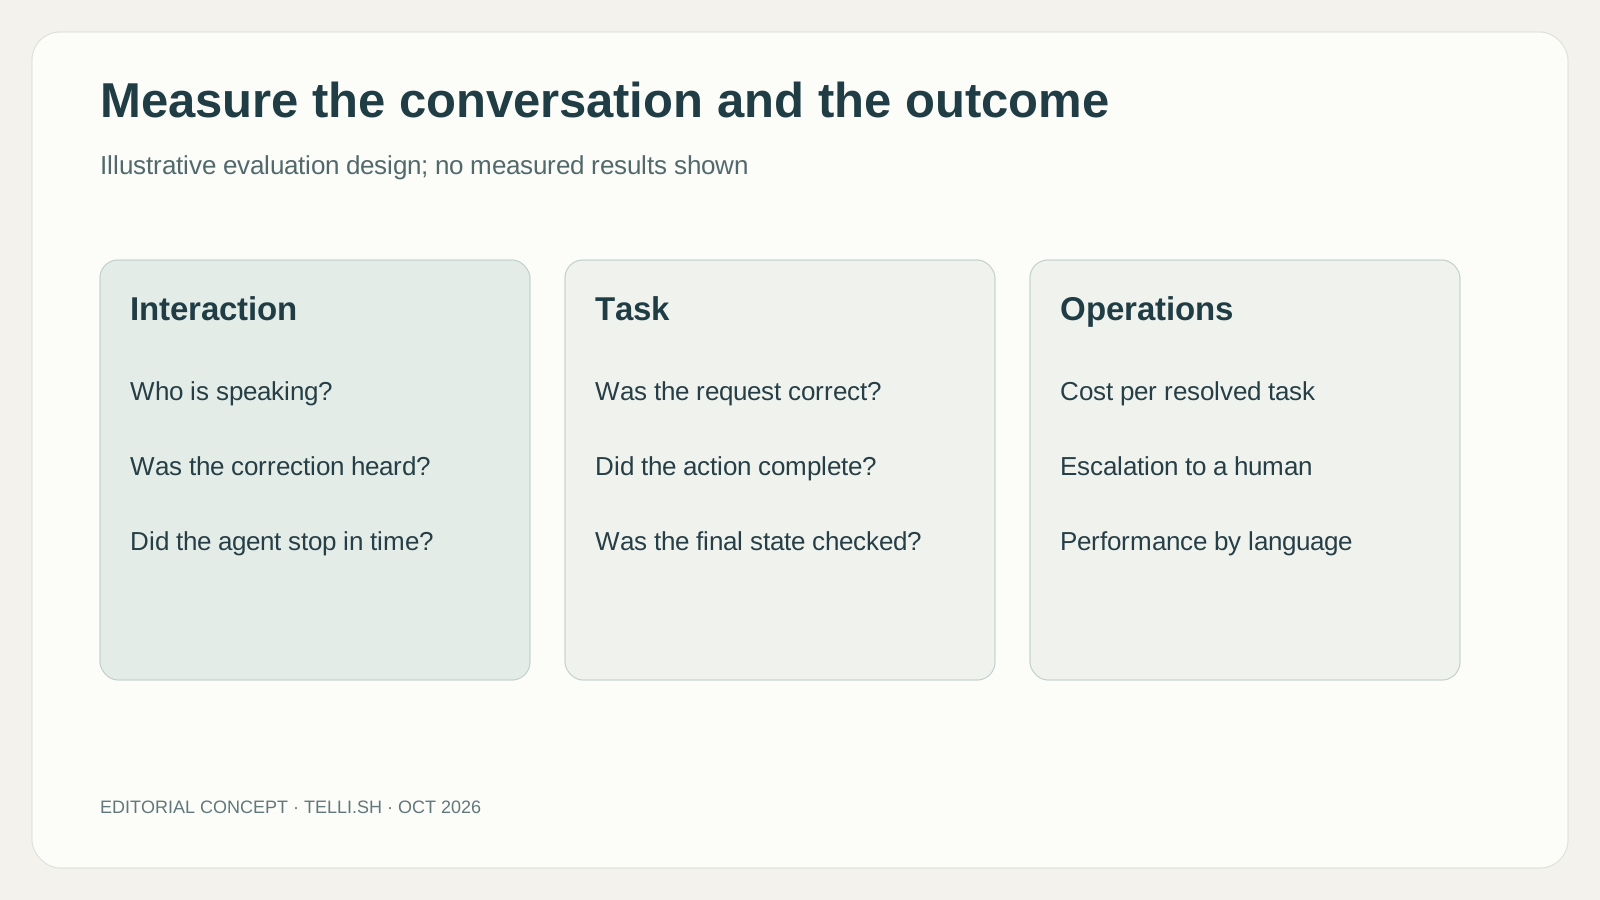
Marco editorial de evaluación original. No representa resultados de pruebas.
La próxima prueba de referencia es una conversación resuelta
Una prueba piloto razonable utilizaría conversaciones representativas con permiso: peticiones breves y largas, interrupciones, correcciones, distintos idiomas y casos que requieren derivación. Revisaría si se realizó la acción prevista, cuántas veces tuvieron que intervenir personas y cuánto costó la interacción completada. Mantendría la rapidez del primer audio como una medida, pero también contabilizaría una respuesta rápida que después necesitó corrección. Estas medidas describen una evaluación propuesta, no pruebas que hayamos realizado con Realtime.
El resultado más prometedor es un agente que hace menos preguntas innecesarias y sigue dispuesto a plantear la necesaria. Un tutor debe dejar que el estudiante termine de pensar. Un asistente de reservas debe verificar la fecha corregida. Un agente de soporte debe trasladar el contexto al derivar el caso. Son mejoras modestas al describirlas y sustanciales al experimentarlas, porque eliminan las pequeñas fricciones que vuelven agotadoras las conversaciones automatizadas.
Eleven Realtime da a esa dirección una forma de producto concreta. Podría permitir a más equipos crear interacciones de voz útiles sin convertirse en expertos en cada componente de la arquitectura de audio. Su importancia a largo plazo dependerá de si el comportamiento conversacional integrado produce también trabajo terminado y fiable. La voz introduce al usuario en la conversación. El resultado determina si querrá tener la siguiente.
Fuentes
-
Anuncio de Eleven Realtime y contexto de las pruebas, 20 de octubre de 2026.
-
Modos de los modelos Realtime, despliegue y limitaciones, consultado el 21 de octubre de 2026.
-
Información sobre las plataformas de ElevenLabs, consultado el 21 de octubre de 2026.
-
Arquitecturas de agentes de voz de OpenAI, consultado el 21 de octubre de 2026.
-
Gestión de turnos de LiveKit, consultado el 21 de octubre de 2026.
Conserva la conversación para revisarla
Si quieres un lugar separado donde conservar grabaciones autorizadas y tus notas revisadas, Telli.sh es una opción. Empieza con una nota de audio.