Dessa od Block pyta, czego model głosowy nauczy się, zanim zacznie czytać
Dessa to badawcza zapowiedź Block trenowana tylko na mowie. Demonstracje pełnego dupleksu stawiają pytania o rytm, poprawność i znaczenie naturalnej rozmowy.
Powiedz „W porządku” z ulgą, a potem po długiej pauzie, płaskim głosem. Słowa się nie zmieniają. Rozmowa tak.
Block zaprezentował Dessę 23 października 2026 r. jako model uczony na ludzkich rozmowach bez tekstu i bez wstępnie wytrenowanego modelu. Firma stojąca za Square i Cash App opisuje system pełnego dupleksu: może słuchać podczas mówienia. To wersja badawcza z publicznymi nagraniami i ograniczonym dostępem dla badaczy bezpieczeństwa, a nie powszechnie dostępne API głosowe.
Ciekawe jest, co się dzieje, gdy czas i ekspresja głosu należą do materiału nauki od początku. Wyjaśniamy różnicę, proponujemy sposób słuchania demonstracji i analizujemy trzy zadania, w których zachowanie w rozmowie ma znaczenie. Naszym zdaniem kolejny użyteczny system głosowy musi równie starannie traktować przestrzeń między słowami jak same słowa.
Grafika główna: autorska ilustracja mowy i czasu rozmowy. Nie przedstawia instalacji Dessy ani zmierzonego przebiegu audio.
Mowa zawiera informacje pomijane przez czystą transkrypcję
Transkrypcja umożliwia wyszukiwanie, cytowanie i kontrolę rozmowy. Zwykle jednak daje węższą reprezentację niż nagranie. Akcent, pauzy, nakładanie wypowiedzi i dźwięki niewerbalne wpływają na interpretację zdania.
Wyobraźmy sobie umawianie spotkania. Ktoś mówi „Czwartek pasuje”, po czym dodaje „Czekaj, po obiedzie”. Asystent powinien zachować poprawkę i nie uznać pierwszej części za zakończone polecenie. Moment jest ważny, bo system może już przygotowywać odpowiedź.
Krótkie „mhm” może znaczyć „nadal słucham”, a nie „chcę przejąć rozmowę”. Uznawanie każdego dźwięku za pełną nową turę męczy. Ignorowanie wszystkich krótkich wtrąceń grozi utratą prawdziwej korekty.
To problem rytmu rozmowy: kiedy kontynuować, czekać, potwierdzać lub ustąpić. Bardziej ekspresyjny głos syntetyczny sam tego nie rozwiązuje. System musi też decydować o przebiegu wymiany.
Autorzy Moshi, opublikowanego w 2024 r., wprost wskazali nakładającą się mowę i wtrącenia jako ograniczenia segmentowanych procesów naprzemiennych. To ważny kontekst: pełny dupleks istniał przed Dessą. Wyróżniająca deklaracja Block dotyczy nauki wyłącznie z mowy, co należy oceniać osobno od jednoczesnego słuchania i mówienia.
Trzy pytania zapobiegają myleniu trzech zdolności
„Natywny głosowo” może oznaczać dane treningowe, informacje przekazywane między komponentami podczas pracy lub czas interakcji. Postęp na jednej osi nie rozstrzyga pozostałych.
Tabela je rozdziela. To pojęciowe porównanie ułatwiające czytanie ogłoszeń, nie ranking benchmarków ani pełny opis wewnętrznej implementacji modelu.
| Pytanie | Co bada | Czego samo nie dowodzi |
|---|---|---|
| Na czym trenowano model? | Czy użyto mowy, tekstu, czy obu | Dokładności w konkretnym zadaniu lub języku |
| Co system przetwarza podczas pracy? | Czy audio trafia wprost do modelu czy przez inne reprezentacje | Sprawnej obsługi przerwań |
| Czy wejście i wyjście mogą się nakładać? | Czy słucha podczas generowania mowy | Poprawnego rozumienia emocji lub intencji |
Strona Dessy, sprawdzona 27 października 2026 r., deklaruje wszystkie trzy: naukę z samej mowy, interakcję audio–audio i pełny dupleks. To opis zespołu, nie opublikowany wynik jakości każdej możliwej rozmowy.
Moshi pokazuje wartość rozróżnienia. Publikacja opisuje pełnodupleksowy system mowy i tekstu oparty na tekstowym modelu językowym. Ścieżka nauki różni się od opisywanej dla Dessy, choć także obejmuje nakładający się dialog. Nazywanie każdego systemu głosowego potokiem transkrypcji zaciera tę różnicę.
Zespół produktu powinien pytać, która oś jest ważna dla zadania. Archiwum z wyszukiwaniem wymaga wiarygodnego tekstu; interaktywny tutor potrzebuje użytecznej informacji zwrotnej i tempa. Agent obsługi klienta potrzebuje również wiedzy i uprawnień do wykonania pracy biznesowej.
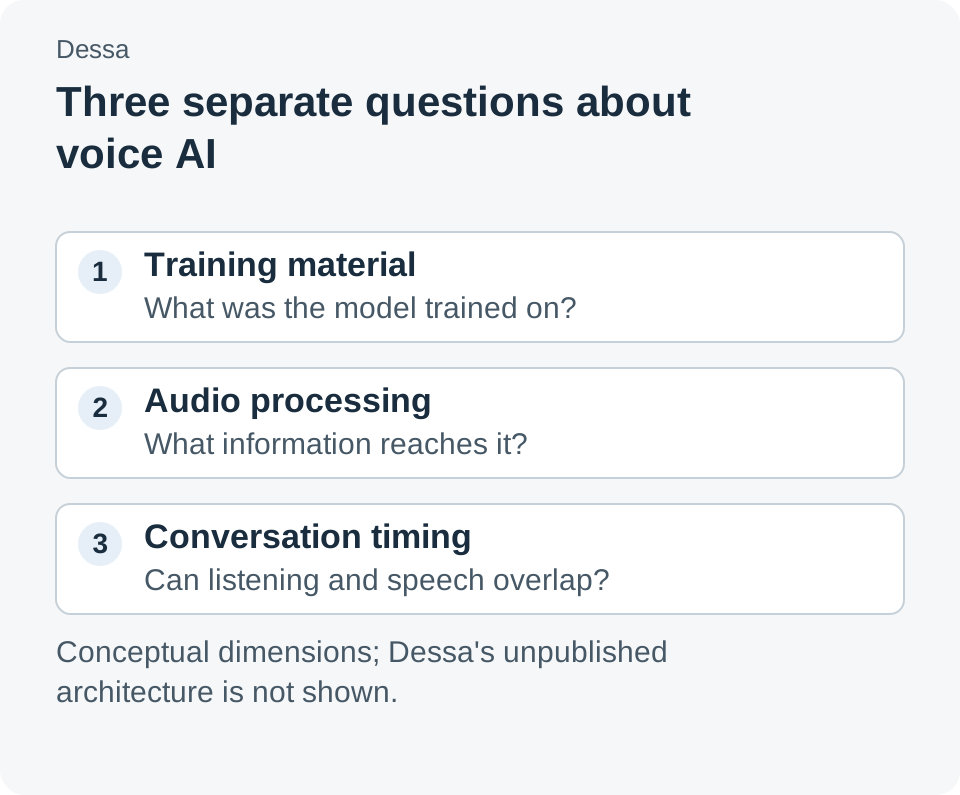
Autorski diagram rozdziela pytania, nie ujawnia nieopublikowanej architektury Dessy. Źródła: strona Dessy od Block oraz publikacja Moshi z 2024 r..
Przekonujący głos i poprawna odpowiedź wymagają osobnych testów
Ekspresyjnej odpowiedzi łatwo słuchać, ale może też uwiarygodniać niepoparte twierdzenie. Poczucie bycia rozumianym może zmniejszać skłonność do zatrzymania się i sprawdzenia szczegółu.
Dlatego odczuwana empatia, fakty i wykonanie zadania potrzebują osobnych kryteriów. Życzliwe potwierdzenie bywa właściwe nawet przy braku informacji. Wtedy lepsze jest jasne pytanie we właściwym momencie niż emocjonalnie dopracowane zgadywanie.
Wyobraźmy sobie obsługę opóźnionej paczki. Zirytowany klient przerywa, aby poprawić numer zamówienia. Użyteczny system pozwoli na korektę, zachowa identyfikator i wyjaśni następne działanie. Ciepły ton nie naprawi błędnego wyszukania ani nieuprawnionej obietnicy.
Podobnie jest z niepewnością. Pauza może oznaczać wahanie, szukanie słowa, rozproszenie lub koniec tury. Audio daje wskazówki, ale znaczenie zależy od kontekstu. Rozsądna ocena powinna nagradzać doprecyzowanie niejednoznaczności.
Block zaprasza ograniczoną grupę badaczy bezpieczeństwa do analizy Dessy. To użyteczny opis aktualnego etapu, nie dowód spełnienia wymagań niezawodności obsługi, edukacji czy innych wdrożeń.
Oficjalne demonstracje są ćwiczeniem słuchania, nie tabelą punktów
Publiczna strona zawiera wybrane rozmowy, między innymi o premierze i wspomnieniach filmowych. Firma mówi, że model wybiera odpowiedzi, a napisy dodano później. Nagrania pokazują zachowania, lecz nie ich częstość w dużym zestawie testowym.
Najpierw słuchaj czasu, bez napisów. Kiedy zaczyna się odpowiedź? Czy potwierdzenie wspiera człowieka czy z nim konkuruje? Czy zostaje miejsce na samodzielną korektę?
Potem sprawdź treść. Fakty oceniaj niezależnie od sposobu podania. Świetne tempo nie wyklucza błędu. Rozdzielenie ocen chroni przed zastąpieniem dowodów dotyczących zadania przyjemną demonstracją.
Na końcu obserwuj powrót po pomyłce. Szczególnie pouczająca jest reakcja na poprawienie nieporozumienia. Czy problem znika, czy system trzyma się starej interpretacji? Jeden powrót nie daje wskaźnika, ale pomaga zaprojektować dalszą ocenę.
Jest też granica: wybrane nagranie nie daje kontroli nad poleceniem, środowiskiem ani powtórzeniami. Traktuj je jako źródło pytań do próby, nie odpowiedzi na wszystkie pytania o wdrożenie.
Trzy możliwe zastosowania pokazują znaczenie czasu
Poniższe scenariusze ilustrują możliwości rozmowy. Nie są ogłoszonymi klientami Dessy ani obietnicą potrzebnych integracji w obecnej wersji. Oddzielają interesujące zachowanie od pracy niezbędnej do jego niezawodności.
Partner do ćwiczenia języka mógłby czekać podczas zawahania ucznia i zauważać udaną poprawkę. Ocena musi odróżniać pomocną zachętę od przeszkadzania. Potrzebne są dowody dla języka docelowego, jakości korekt i powtarzanych błędów; naturalna angielska demonstracja nie wystarczy.
Asystent prób wypowiedzi mógłby pomagać w prezentacji lub trudnej rozmowie. Powinien pozwolić skończyć myśl, dopytać i uwzględnić nowe polecenie. Zespół musi wybrać między próbą, oceną i wsparciem merytorycznym, bo kryteria się różnią.
Interfejs wstępnej obsługi zgłoszeń mógłby wysłuchać, doprecyzować i zachować korektę bez rozpoczynania od nowa. Trudność to przypisanie właściwej sprawy i kolejnej czynności. Wiedza, uwierzytelnianie, eskalacja i prawa transakcyjne pozostają osobnymi obowiązkami systemu.
Wspólny wzorzec: płynniejsza rozmowa ułatwia dojście do decyzji. Wartość zależy od użyteczności i możliwości jej poprawienia. Obsługa przerwań i naprawa nieporozumień to realne wymagania produktu.
Praca lokalna jest deklaracją sprzętową z warunkiem dostępu
Block podaje, że Dessa działa lokalnie na MacBooku Pro M4 Max lub lepszym, a trening wykorzystał jeden NVIDIA GB200 NVL72. Obie informacje pochodzą z oficjalnej strony, sprawdzonej 27 października 2026 r. To dane twórców, nie nasze pomiary.
Trening i inferencja odpowiadają na inne pytania. Maszyna do uczenia modelu nie jest wymaganiem dla użytkownika. Informacja o laptopie nie stanowi też opublikowanej tabeli pamięci i opóźnień.
Dostęp to odrębna kwestia. Linki uruchomienia nadal opisano jako przyszłe, a wczesny dostęp dotyczy wybranych badaczy. Brakuje ogólnych cen API, wag do pobrania i listy języków, na których można oprzeć wdrożenie produkcyjne.
Deweloper może wskazać pytania do śledzenia, ale nie ustalić migracji z aktualnego rozwiązania. Potrzebowałby użytecznych artefaktów, szczegółów integracji, pomiarów na docelowym sprzęcie i jasnego wsparcia.
Zbuduj ocenę obejmującą ciszę i korekty
Jeżeli pojawi się szerszy dostęp, zacznij od zadań z łatwym do sprawdzenia wynikiem. Używaj tych samych scenariuszy między systemami i za zgodą uczestników zachowaj audio potrzebne do wyjaśnienia sporów. Poniżej proponowana procedura, nie przeprowadzony eksperyment.
- Zdefiniuj wynik. Dla terminu zapisz datę i godzinę, dla próby — wymagany komentarz. Nie stosuj wyłącznie oceny „brzmi jak człowiek”.
- Przygotuj pary scenariuszy. Zachowaj podobną prośbę i zmieniaj jeden element: pauzę, potwierdzenie, przerwanie lub jawną korektę. Ułatwia to rozmowę o przyczynie błędu.
- Dodaj polecenie poprawki. Poproś o zmianę wcześniejszego szczegółu i sprawdź odpowiedź końcową oraz jasność zmiany w dialogu.
- Oceniaj czas i treść osobno. Notuj nieodpowiednie przerwania, przeoczone poprawki i niepoparte fakty. Wynik zbiorczy może ukryć słabość.
- Sprawdź planowane środowisko. Gdy dostęp pozwoli, powtórz zadania na właściwym urządzeniu i zestawie audio. Cichy test mikrofonowy jest dowodem dla tego układu, nie każdego pokoju i słuchawek.
- Rozstrzygaj różnice z nagraniem. Odtwórz moment i doprecyzuj kryteria. Spór może ujawnić niejasną definicję zadania, nie prosty błąd modelu.
Przykładowy pierwszy zestaw może liczyć 12 scenariuszy: cztery z pauzami, cztery z korektami, cztery z krótkimi potwierdzeniami. To punkt wyjścia, nie twierdzenie o naukowej wystarczalności ani opublikowany benchmark Dessy. Chodzi o ujawnienie różnych wymagań przed zwiększeniem skali.
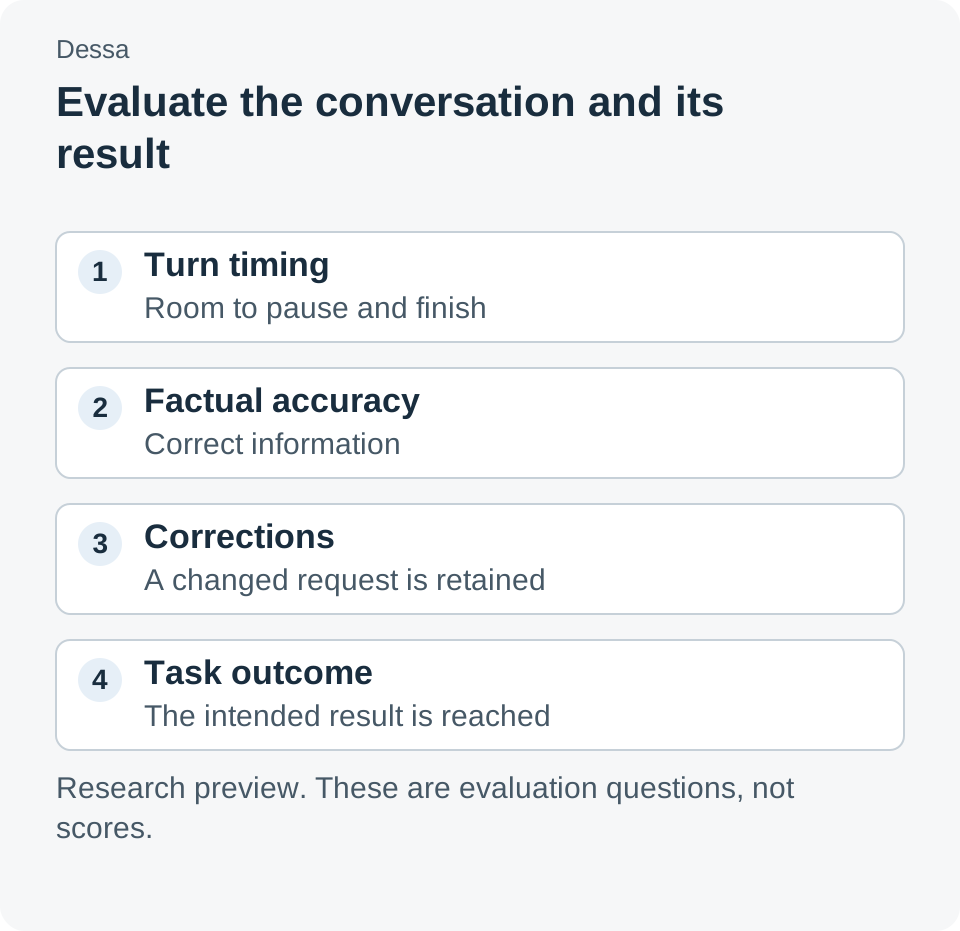
Autorski przewodnik. Nie sugeruje zmierzonego sukcesu, opóźnienia ani porównawczych punktów modeli.
Interfejs głosowy powinien uczynić poprawianie zwyczajnym
Najbardziej użyteczna obietnica nie polega na nieodróżnialności każdego asystenta od człowieka. Polega na mniejszym wysiłku dostosowania mowy do sztywnego interfejsu. Pauzy, przerwania i niedokończone myśli są normalne.
Dessa daje konkretny obiekt badania: model, który według autorów uczył się tylko z mowy. Następne pytanie dotyczy zachowania w rzeczywiście potrzebnych sytuacjach. Dobry interfejs ułatwia kontynuację, wyjaśnianie i poprawianie, zachowując zrozumiałość zadania.
Źródła
- Block: Dessa — oficjalny opis, nagrania, sprzęt i dostęp; sprawdzone 27 października 2026 r.
- Wiadomości Block — ogłoszenie z 23 października 2026 r.
- Défossez i współautorzy: Moshi, a speech-text foundation model for real-time dialogue — badanie pierwotne z 2024 r. o pełnodupleksowym dialogu mowy i tekstu.
Źródła sprawdzono 27 października 2026 r. Szczegóły przypisano wydawcom. Scenariusze i kroki są ilustracyjne; nie instalowaliśmy Dessy ani nie mierzyliśmy wydajności. Oficjalne nagrania są na stronie projektu.
Rekomendacja Telli.sh
Potrzebujesz miejsca z wyszukiwaniem dla nagrań, notatek i decyzji po rozmowie? Zbierz materiały w Telli.sh i zachowaj czytelność przekazywanej pracy.