Dessa di Block chiede cosa possa imparare un modello vocale prima di leggere
Dessa è un’anteprima di ricerca di Block addestrata solo sul parlato. Le demo full duplex pongono domande su tempi, accuratezza e valore della conversazione naturale.
Di’ «Va bene» con sollievo, poi ripeti dopo una lunga pausa e con voce piatta. Le parole restano le stesse. La conversazione cambia.
Block ha presentato Dessa il 23 ottobre 2026, descrivendo un modello addestrato sulle conversazioni umane senza testo né modelli preaddestrati. L’azienda di Square e Cash App parla di un sistema full duplex: può ascoltare mentre parla. È un’anteprima di ricerca con registrazioni pubbliche e accesso limitato a ricercatori sulla sicurezza, non un’API vocale generalmente disponibile.
La domanda interessante è cosa accade quando tempi ed espressione vocale entrano nel materiale di apprendimento fin dall’inizio. Questo articolo spiega la distinzione, propone come ascoltare le demo e considera tre lavori in cui il comportamento conversazionale conta. La nostra lettura: il prossimo sistema vocale utile deve trattare gli spazi fra le parole con la stessa cura delle parole.
Immagine principale: illustrazione editoriale originale di voce e tempi conversazionali. Non raffigura un’installazione Dessa o una traccia audio misurata.
Il parlato contiene informazioni che una trascrizione pulita può perdere
Una trascrizione rende una conversazione cercabile, citabile e verificabile, ma normalmente offre una rappresentazione più limitata della registrazione. Enfasi, tempi, sovrapposizioni e suoni non verbali possono cambiare l’interpretazione di una frase.
Pensiamo a un appuntamento immaginario. Una persona dice «Giovedì va bene» e aggiunge subito «Aspetta, dopo pranzo». Un assistente utile conserva la correzione e non tratta la prima parte come istruzione conclusa. Il momento conta, perché il sistema potrebbe già preparare la risposta.
Un breve «mh-mh» può significare «sto ancora ascoltando», non «voglio prendere la parola». Trattare ogni suono come un turno completo affatica l’interazione; ignorare ogni piccola interruzione può far perdere una vera correzione.
È il problema del ritmo della conversazione: decidere quando continuare, attendere, confermare o cedere. Non basta rendere espressiva una voce sintetica. Il sistema deve scegliere anche come far scorrere lo scambio.
I ricercatori di Moshi, pubblicato nel 2024, hanno indicato esplicitamente parlato sovrapposto e interiezioni come limiti dei processi a turni segmentati. È un contesto utile: il dialogo full duplex precede Dessa. La rivendicazione distintiva di Block riguarda l’apprendimento solo dal parlato, da valutare separatamente dalla capacità generale di ascoltare e parlare insieme.
Tre domande evitano di confondere tre capacità
«Nativo vocale» può riferirsi ai dati di addestramento, alle informazioni passate fra componenti durante l’esecuzione o ai tempi dell’interazione. Un progresso su una dimensione non risolve automaticamente le altre.
La tabella le distingue. È un confronto concettuale per leggere annunci, non una classifica di benchmark o una descrizione completa dell’implementazione interna di un modello.
| Domanda | Cosa verifica | Cosa non dimostra da sola |
|---|---|---|
| Su cosa è stato addestrato? | Uso di parlato, testo o entrambi | Accuratezza per un compito o una lingua |
| Cosa elabora durante l’esecuzione? | Audio diretto al modello o mediato da altre rappresentazioni | Qualità nella gestione delle interruzioni |
| Input e output possono sovrapporsi? | Ascolto mentre viene generata voce | Interpretazione corretta di emozione o intenzione |
La pagina Dessa, verificata il 27 ottobre 2026, si colloca su tutte e tre: apprendimento solo vocale, interazione audio-audio e tempi full duplex. Sono descrizioni del team, non punteggi pubblicati per ogni conversazione possibile.
Moshi mostra perché distinguere aiuta. L’articolo descrive un sistema full duplex di voce e testo costruito su un modello linguistico testuale. Il percorso di apprendimento è diverso da quello indicato per Dessa, pur affrontando dialoghi sovrapposti. Chiamare ogni sistema vocale una pipeline di trascrizione cancellerebbe questa differenza.
Un team prodotto dovrebbe chiedere quale dimensione conti per il compito. Un archivio consultabile richiede testo affidabile; un tutor interattivo, feedback utile e ritmo adeguato. Un agente per clienti richiede anche conoscenze e autorizzazioni per completare il lavoro aziendale.
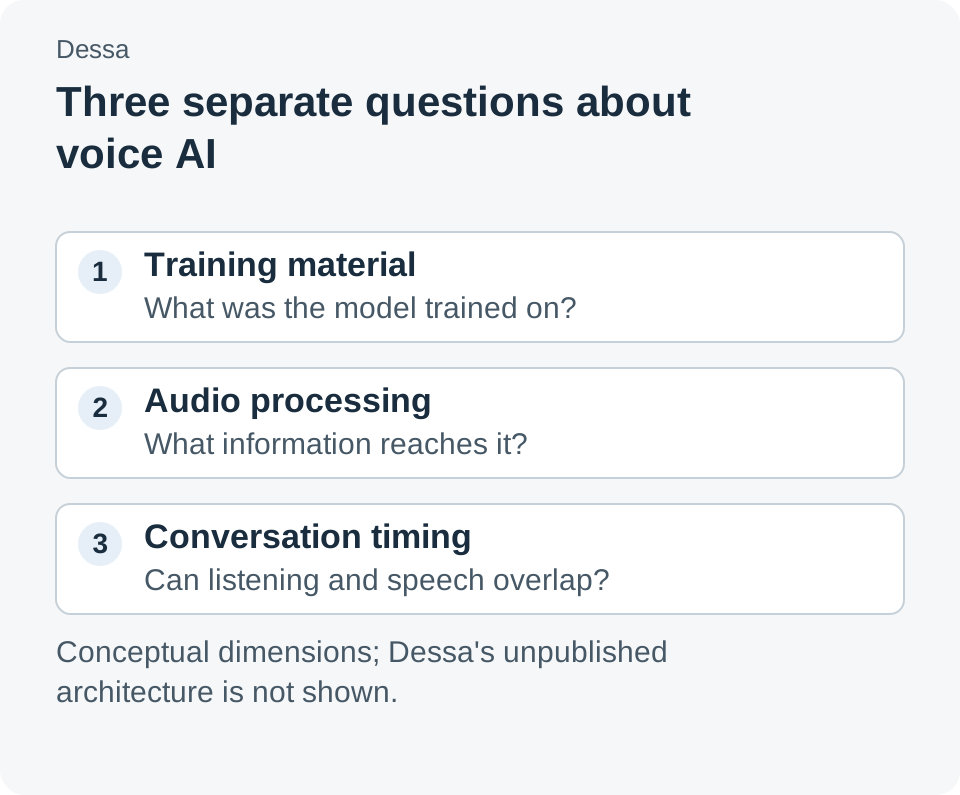
Diagramma originale che separa tre domande, senza pretendere di rivelare l’architettura inedita di Dessa. Fonti: pagina Dessa di Block e articolo Moshi del 2024.
Una voce convincente e una risposta corretta richiedono prove separate
Una risposta espressiva è facile da seguire, ma può rendere persuasiva anche un’affermazione priva di prove. Sentirsi capiti può ridurre la tendenza a fermarsi e verificare un dettaglio.
Empatia percepita, correttezza fattuale e completamento richiedono quindi criteri distinti. Un riscontro gentile può essere adatto anche quando mancano informazioni. In quel caso è spesso meglio una domanda chiara al momento giusto che una supposizione emotivamente rifinita.
Immaginiamo una chiamata su un pacco in ritardo. Il cliente è frustrato e interrompe per correggere il numero d’ordine. Un sistema utile consente la correzione, conserva l’identificativo giusto e spiega l’azione disponibile. Il tono caldo non ripara una ricerca sbagliata o una promessa non autorizzata.
Vale anche quando chi parla sembra incerto. Una pausa può essere esitazione, ricerca di una parola, distrazione nella stanza o fine del turno. L’audio dà indizi, ma il significato dipende dal contesto. Una valutazione ragionevole deve premiare la richiesta di chiarimento quando il segnale è ambiguo.
Block invita un gruppo limitato di ricercatori sulla sicurezza a esaminare Dessa. Descrive utilmente la fase attuale, senza dimostrare che siano già soddisfatti i requisiti di affidabilità di assistenza, istruzione o altri impieghi.
Le demo ufficiali sono un esercizio d’ascolto, non un tabellone di risultati
La pagina pubblica offre registrazioni selezionate, fra cui discussioni sul rilascio e ricordi cinematografici. L’azienda dice che il modello sceglie le risposte e i sottotitoli sono aggiunti dopo. Sono esempi osservabili, non una misura della loro frequenza in un ampio insieme di prove.
Ascolta i tempi prima di leggere i sottotitoli. Quando parte la risposta? Un cenno sostiene il turno umano o compete? Il sistema lascia spazio all’autocorrezione?
Poi esamina il contenuto. Ogni affermazione fattuale va giudicata separatamente dalla qualità espressiva. Una risposta può avere ritmo ottimo e richiedere correzione. Tenere distinti i giudizi evita che una demo piacevole sostituisca le prove su un compito.
Infine osserva il recupero. Un equivoco è particolarmente informativo quando viene corretto. Lo scambio risolve il problema o continua con l’interpretazione iniziale? Un singolo recupero non stabilisce una percentuale, ma aiuta a progettare una valutazione successiva.
Il limite è chiaro: una registrazione scelta non permette di controllare richiesta, ambiente o ripetizioni. Usala per formulare domande per una prova, non per risolvere in anticipo ogni dubbio di implementazione.
Tre usi possibili mostrano il valore del momento giusto
I seguenti scenari sono applicazioni illustrative delle capacità conversazionali, non clienti Dessa annunciati né dichiarazioni che l’anteprima supporti le integrazioni richieste. Distinguono il comportamento interessante dal lavoro necessario per renderlo affidabile.
Un compagno per esercitare una lingua potrebbe aspettare durante un’esitazione e riconoscere una correzione riuscita. La valutazione distingue incoraggiamento utile e interruzione che impedisce di esercitarsi. Servono prove sulla lingua scelta, sulla qualità delle correzioni e sugli errori ripetuti: una demo inglese naturale non basta.
Un assistente per prove orali potrebbe aiutare a preparare presentazioni o conversazioni difficili. Deve lasciare concludere un pensiero, fare domande e recepire istruzioni cambiate. Il team deve scegliere fra esercitazione, feedback e guida fattuale, perché i criteri differiscono.
Un’interfaccia di smistamento dell’assistenza potrebbe ascoltare, chiarire e conservare una correzione senza ricominciare. La difficoltà è collegare lo scambio al caso giusto e all’azione corretta. Accesso al sapere, autenticazione, escalation e permessi di transazione restano responsabilità distinte.
Il filo comune è che una conversazione fluida riduce l’attrito verso la decisione successiva. Il valore dipende dall’utilità della decisione e dalla possibilità di correggerla. Interruzioni e recupero sono requisiti pratici, non dettagli riservati alle demo.
L’esecuzione locale è un’affermazione hardware con una condizione d’accesso
Block dice che Dessa gira localmente su MacBook Pro M4 Max o superiore ed è stato addestrato con un NVIDIA GB200 NVL72. Entrambe le indicazioni vengono dalla pagina ufficiale, consultata il 27 ottobre 2026. Sono dati del produttore, non misure di una nostra installazione.
Addestramento e inferenza vanno separati. La macchina che allena un modello e quella che esegue un modello già pronto rispondono a domande diverse. L’hardware di training non è un requisito per il consumatore; l’indicazione sul portatile non è una matrice pubblicata di memoria e latenza.
L’accesso è un’altra questione. La pagina segna ancora i collegamenti di lancio come in arrivo e descrive accesso anticipato per ricercatori selezionati. Non fornisce prezzi API generali, pesi scaricabili o tabella delle lingue per pianificare la produzione.
Per uno sviluppatore basta a identificare questioni da seguire, non a fissare una migrazione dal sistema attuale. Servirebbero artefatti utilizzabili, dettagli di integrazione, misure sull’hardware previsto e supporto chiaro.
Progetta una valutazione che includa silenzio e correzioni
Se sarà disponibile una prova più ampia, parti da compiti con esiti corretti facili da controllare. Usa scenari uguali fra sistemi e conserva, con consenso dei partecipanti, l’audio necessario a capire giudizi controversi. La procedura è una proposta, non un esperimento svolto per l’articolo.
- Definisci il risultato desiderato. Per un appuntamento annota data e ora, per una prova orale il feedback richiesto. Non usare solo un voto di «sembra umano».
- Scrivi coppie di scenari. Mantieni simile la richiesta e cambia un evento: pausa, cenno, interruzione o correzione esplicita. Sarà più facile discutere concretamente la causa del fallimento.
- Inserisci un’istruzione di recupero. Chiedi di correggere un dettaglio precedente. Verifica che la risposta finale lo recepisca e che il cambiamento sia chiaro.
- Giudica tempi e contenuto separatamente. Registra interruzioni inappropriate, correzioni perse e fatti non sostenuti. Un punteggio unico può nascondere debolezze importanti.
- Prova l’ambiente previsto. Quando l’accesso lo consente, ripeti compiti rappresentativi con dispositivo e audio reali. Un test silenzioso dimostra quel contesto, non ogni stanza o cuffia.
- Riesamina i disaccordi con l’audio. Riascolta il momento e affina i criteri. Il dissenso può rivelare una definizione poco chiara del compito anziché un semplice errore del modello.
Un primo insieme illustrativo potrebbe contenere dodici scenari: quattro con pause, quattro con correzioni, quattro con brevi cenni. È una proposta iniziale, non una dichiarazione di sufficienza scientifica né un benchmark Dessa pubblicato. Serve a esporre esigenze diverse prima di aumentare la scala.
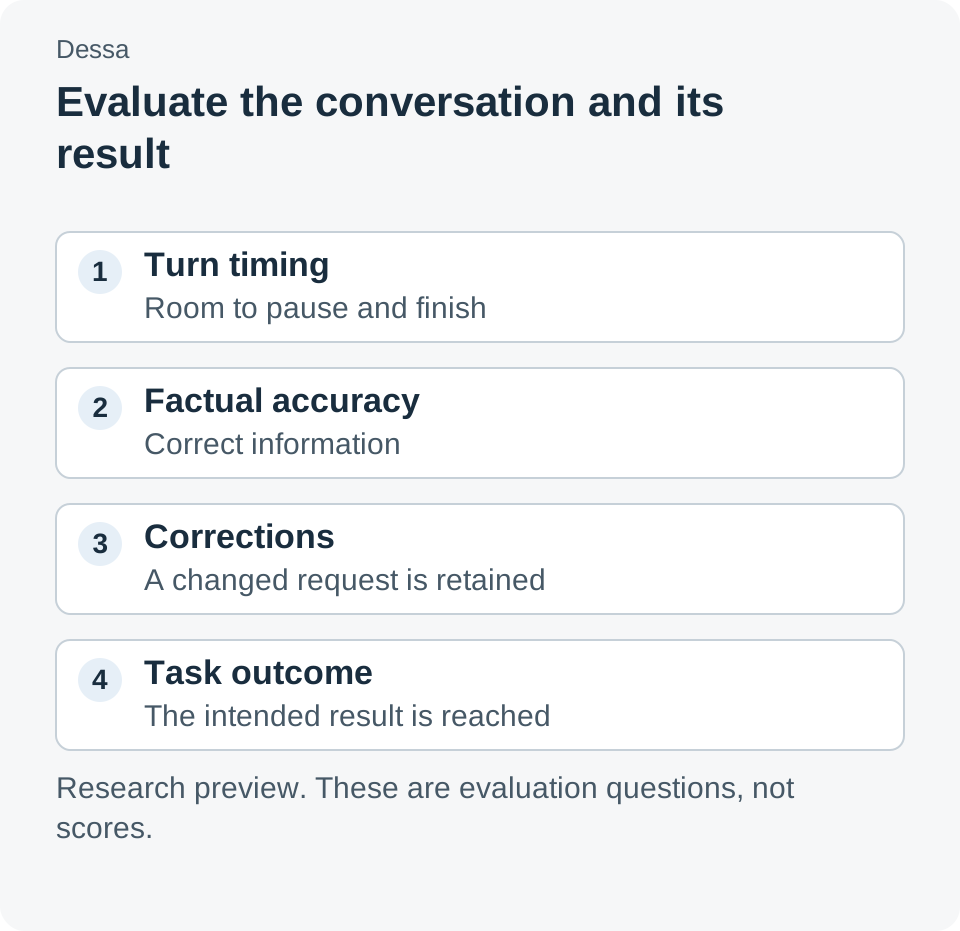
Guida originale. Non implica tassi di successo, latenze misurate o punteggi comparativi.
Un’interfaccia vocale dovrebbe rendere normale correggere
La promessa più utile non è rendere ogni assistente indistinguibile da una persona. È ridurre lo sforzo di adattare il parlato a un’interfaccia rigida. Pause, interruzioni e pensieri incompleti sono normali nel parlare.
Dessa rende concreta questa ricerca: un modello che, secondo gli sviluppatori, ha appreso solo attraverso il parlato. La domanda successiva è se regge nelle situazioni realmente necessarie. Una buona interfaccia facilita continuare, chiarire e correggere mantenendo comprensibile il compito.
Fonti
- Block: Dessa — descrizione, dimostrazioni, hardware e accesso ufficiali; verificati il 27 ottobre 2026.
- Notizie Block — annuncio del 23 ottobre 2026.
- Défossez e colleghi: Moshi, a speech-text foundation model for real-time dialogue — ricerca primaria del 2024 sul dialogo full duplex di voce e testo.
Fonti verificate il 27 ottobre 2026. I dettagli sono attribuiti ai rispettivi autori. Scenari e passaggi sono illustrativi; non abbiamo installato Dessa né misurato prestazioni. Le registrazioni ufficiali sono nella pagina collegata.
Un consiglio di Telli.sh
Vuoi un posto consultabile per registrazioni, riferimenti e decisioni dopo una conversazione? Raccogli i riferimenti in Telli.sh e rendi comprensibili i passaggi di consegne.