Avec Dessa, Block demande ce qu’un modèle vocal peut apprendre avant de lire
Dessa est un aperçu de recherche de Block entraîné uniquement sur la parole. Ses démonstrations en duplex intégral interrogent rythme, exactitude et conversation naturelle.
Dites « C’est bon » avec soulagement, puis répétez avec une longue pause et une voix plate. Les mots restent identiques. La conversation change.
Block a présenté Dessa le 23 octobre 2026 comme un modèle ayant appris à partir de conversations humaines, sans texte ni modèle préentraîné. L’entreprise derrière Square et Cash App le décrit comme un système vocal en duplex intégral : il peut écouter pendant qu’il parle. Il s’agit d’un aperçu de recherche, avec des enregistrements publics et un accès limité pour la recherche en sécurité, pas d’une API vocale ouverte à tous.
La question intéressante est ce qui change lorsque le rythme et l’expression vocale font partie du matériau d’apprentissage dès le départ. Cet article explique la distinction, propose une façon concrète d’écouter les démonstrations et examine trois activités où le comportement conversationnel compterait. Notre avis : le prochain système vocal utile devra traiter l’espace entre les mots aussi soigneusement que les mots eux-mêmes.
Image principale : illustration éditoriale originale de la parole et du rythme conversationnel. Elle ne montre ni installation Dessa ni trace audio mesurée.
La parole contient des informations qu’une transcription propre peut perdre
Une transcription rend une conversation consultable, citable et vérifiable. Elle donne toutefois généralement une représentation plus étroite que l’enregistrement original. Accentuation, pauses, chevauchements et sons non verbaux peuvent modifier l’interprétation d’une phrase.
Prenons une prise de rendez-vous fictive. Quelqu’un dit « Jeudi me va », puis ajoute immédiatement « Attendez, après déjeuner ». Un assistant utile doit conserver la correction et ne pas traiter la première proposition comme une instruction complète. Le moment de la correction compte, car le système peut déjà préparer une réponse.
Un bref « mm-hm » peut signifier « je continue à écouter », plutôt que « je veux reprendre la parole ». Traiter chaque son comme un nouveau tour complet rend l’échange fatigant. Ignorer toutes les petites interruptions risque de faire manquer une vraie correction.
C’est le problème du rythme de la conversation : décider de continuer, attendre, acquiescer ou céder la parole. Donner davantage d’expressivité à une voix synthétique ne le résout pas à lui seul. Le système doit aussi choisir comment l’échange se déroule.
Les chercheurs de Moshi, publié en 2024, ont explicitement identifié les paroles superposées et les interjections comme des limites des chaînes à tours segmentés. Leur travail apporte un contexte utile : le dialogue en duplex intégral précède Dessa. La revendication distinctive de Block concerne l’apprentissage uniquement à partir de parole, à évaluer séparément de la capacité générale à écouter et parler simultanément.
Trois questions évitent de confondre trois capacités
« Natif vocal » peut désigner les données d’apprentissage, l’information échangée entre composants à l’exécution ou le rythme de l’interaction. Un progrès sur un axe ne résout pas nécessairement les autres.
Le tableau sépare ces axes. C’est une comparaison conceptuelle pour lire les annonces, pas un classement de benchmarks ni une description complète de l’implémentation interne d’un modèle.
| Question | Ce qu’elle examine | Ce qu’elle ne prouve pas seule |
|---|---|---|
| Avec quoi le modèle a-t-il appris ? | Usage de parole, de texte ou des deux pendant l’apprentissage | Exactitude sur une tâche ou une langue donnée |
| Que traite le système à l’exécution ? | Arrivée directe de l’audio au modèle ou passage par d’autres représentations | Qualité de la gestion des interruptions |
| Entrée et sortie peuvent-elles se chevaucher ? | Capacité à écouter pendant la production de parole | Bonne interprétation de l’émotion ou de l’intention |
La page Dessa de Block, vérifiée le 27 octobre 2026, se positionne sur les trois axes : apprentissage exclusivement vocal, interaction audio vers audio et rythme en duplex intégral. Ce sont les descriptions de l’équipe. Elles ne fournissent pas un score publié pour la qualité de chaque conversation possible.
Moshi montre pourquoi ces distinctions aident. L’article décrit un système parole-texte en duplex intégral construit sur un modèle de langage textuel. Son parcours d’apprentissage diffère de celui décrit par Block pour Dessa, tout en traitant les dialogues oraux qui se chevauchent. Appeler tous les systèmes vocaux des chaînes de transcription effacerait cette différence.
Pour une équipe produit, la question pratique est l’axe important pour le travail. Une archive consultable exige un relevé textuel fiable. Un tuteur interactif demande un retour utile et un rythme adapté. Un agent destiné aux clients doit aussi posséder les connaissances et autorisations nécessaires pour accomplir la tâche métier.
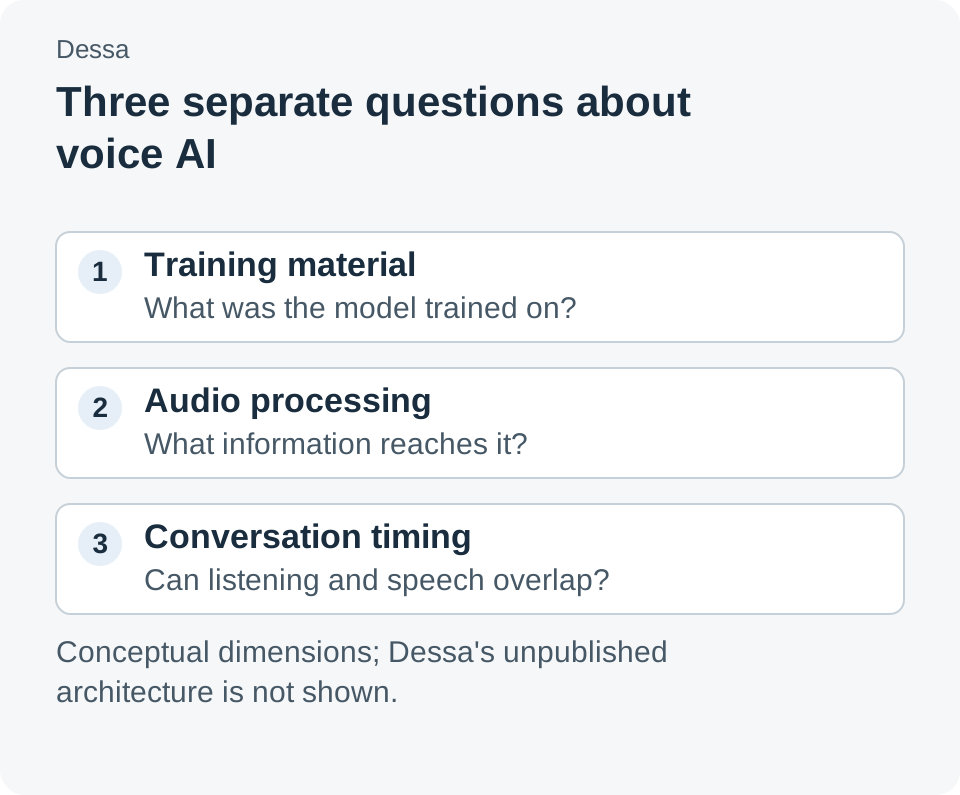
Schéma explicatif original. Il sépare trois questions sans prétendre révéler l’architecture non publiée de Dessa. Sources : page Dessa de Block et article Moshi de 2024.
Une voix convaincante et une réponse juste exigent des tests séparés
Une réponse expressive se suit facilement. Elle peut aussi rendre une affirmation sans fondement plus persuasive. Si l’auditeur se sent compris, il peut être moins enclin à interrompre l’échange pour vérifier un détail.
Il faut donc des critères distincts pour l’empathie perçue, l’exactitude factuelle et l’accomplissement de la tâche. Un acquiescement chaleureux peut convenir même quand des informations manquent. Dans ce cas, une question claire au bon moment vaut souvent mieux qu’une supposition émotionnellement soignée.
Imaginons un échange de support au sujet d’un colis retardé. L’appelant semble frustré et interrompt pour corriger un numéro de commande. Le système utile accepte la correction, conserve le bon identifiant et explique l’action disponible. Une voix chaleureuse ne répare ni une mauvaise recherche ni une promesse non autorisée.
Le principe vaut aussi lorsqu’une personne paraît incertaine. Une pause peut signifier hésitation, recherche d’un mot, distraction dans la pièce ou fin du tour. L’audio apporte des indices, mais leur sens dépend du contexte. Une évaluation raisonnable doit valoriser la clarification face à l’ambiguïté.
Block invite un groupe limité de chercheurs en sécurité à examiner Dessa. Pour le lecteur, cela décrit utilement le stade actuel. Cela n’établit pas que le système satisfait déjà les exigences de fiabilité du support, de l’éducation ou d’un autre déploiement.
Les démonstrations officielles sont un exercice d’écoute, pas un tableau de scores
La page publique contient une sélection de conversations enregistrées, dont une discussion sur la sortie et des souvenirs de films. L’entreprise indique que le modèle choisit ses réponses et que les sous-titres ont été ajoutés ensuite. Ces extraits permettent d’observer des comportements, sans indiquer leur fréquence sur un large jeu de tests.
Écoutez le rythme avant de lire les sous-titres. Quand la réponse commence-t-elle ? L’acquiescement accompagne-t-il la parole humaine ou entre-t-il en concurrence ? Le système laisse-t-il la place à une autocorrection ?
Examinez ensuite le contenu. Toute affirmation factuelle doit être évaluée indépendamment de sa présentation. Une réponse très bien rythmée peut nécessiter une correction. Séparer les jugements évite qu’une démonstration agréable remplace les preuves sur une tâche.
Enfin, observez la reprise après erreur. Un malentendu devient particulièrement instructif lorsque la personne le corrige. L’échange résout-il le problème ou poursuit-il l’interprétation initiale ? Une seule reprise ne donne pas un taux, mais aide à concevoir une future évaluation.
L’exercice a aussi une limite utile : un enregistrement sélectionné ne vous laisse contrôler ni demande, ni environnement, ni répétitions. Servez-vous-en pour formuler les questions d’un essai, pas pour répondre d’avance à toutes celles d’un déploiement.
Trois usages possibles montrent l’importance du rythme
Les scénarios suivants illustrent des applications possibles des capacités conversationnelles. Ce ne sont ni des déploiements clients annoncés de Dessa ni l’affirmation que l’aperçu prend en charge leurs intégrations. Chacun distingue le comportement à explorer du travail nécessaire pour le rendre fiable.
Un partenaire de pratique linguistique pourrait attendre pendant l’hésitation d’un apprenant et reconnaître une correction réussie. L’évaluation doit distinguer encouragement utile et interruption nuisible. Il faudrait aussi des preuves explicites pour la langue cible, la qualité des corrections et la gestion d’erreurs répétées ; une démonstration anglaise naturelle ne répond pas à ces questions.
Un assistant de répétition orale pourrait aider à préparer une présentation ou une conversation difficile. Il devrait laisser terminer une pensée, poser une question complémentaire et prendre en compte une consigne modifiée. L’équipe doit décider si elle vise répétition, retour critique ou accompagnement factuel, car les grilles d’examen diffèrent.
Une interface de triage de service pourrait écouter une explication, demander une précision et conserver une correction sans recommencer l’échange. La difficulté est de relier la conversation au bon dossier et à la bonne action. Accès aux connaissances, authentification, escalade et autorisations de transaction restent des responsabilités système distinctes.
Ces exemples partagent une logique : une conversation plus fluide peut réduire la difficulté d’atteindre la décision suivante. La valeur dépend de l’utilité de la décision et de la possibilité de la corriger. Gestion des interruptions et reprise deviennent des exigences produit concrètes, pas des détails de démonstration.
L’exécution locale est une affirmation matérielle assortie d’un accès limité
Block indique que Dessa fonctionne localement sur un MacBook Pro M4 Max ou supérieur et que son entraînement a utilisé un NVIDIA GB200 NVL72. Ces deux chiffres proviennent de la page officielle du projet, consultée le 27 octobre 2026. Ils sont rapportés par le développeur, pas mesurés dans notre installation.
Il faut distinguer entraînement et inférence. Une machine qui apprend un modèle et une machine qui exécute un modèle existant répondent à deux questions différentes. Le système d’entraînement n’est pas une exigence pour le consommateur ; l’affirmation sur l’ordinateur portable n’est pas un tableau publié de mémoire et de latence.
L’accès constitue encore une autre question. La page publique marque toujours les liens de lancement comme à venir et décrit un accès anticipé pour certains chercheurs en sécurité. Elle ne donne ni prix d’API générale, ni poids téléchargeables, ni tableau de langues permettant de planifier une mise en production.
Pour préparer un travail futur, ces éléments permettent de déterminer les questions à suivre. Ils ne suffisent pas à programmer une migration depuis une solution vocale existante. Il faudrait des artefacts utilisables, des détails d’intégration, des mesures sur le matériel prévu et un dispositif de support clair.
Concevoir une évaluation qui inclut le silence et la correction
Si un essai plus large devient possible, commencez par des tâches dont le résultat correct est facile à examiner. Utilisez les mêmes scénarios entre systèmes et conservez, avec l’accord des participants, l’audio nécessaire pour comprendre les désaccords. La procédure est une proposition d’évaluation, pas une expérience réalisée pour cet article.
- Définir le résultat voulu. Pour un rendez-vous, notez date et heure correctes ; pour une répétition, le retour demandé. Évitez de prendre « semble humain » comme seul objectif global.
- Rédiger des paires de scénarios. Gardez une demande proche et ne changez qu’un événement : pause, acquiescement, interruption ou correction explicite. L’origine d’un échec devient plus facile à discuter.
- Inclure une consigne de reprise. Demandez de corriger un détail antérieur. Vérifiez sa présence dans la réponse finale et la clarté du changement dans l’échange.
- Juger rythme et contenu séparément. Relevez interruptions inappropriées, corrections manquées et faits sans fondement. Un score composite peut masquer une faiblesse importante.
- Tester l’environnement prévu. Dès que l’accès le permet, répétez des tâches représentatives avec l’appareil et le dispositif audio réels. Un essai au calme vaut pour ce montage, pas pour toutes les pièces et tous les casques.
- Réexaminer les désaccords avec l’audio. Réécoutez le moment concerné et affinez la grille. Le désaccord peut révéler une définition imprécise de la tâche plutôt qu’une simple erreur du modèle.
Un premier ensemble illustratif pourrait comprendre douze scénarios : quatre avec pauses, quatre avec corrections et quatre avec brefs acquiescements. Ces nombres proposent un départ ; ils n’établissent pas une suffisance scientifique et ne constituent pas un benchmark Dessa publié. L’objectif est d’exposer plusieurs besoins conversationnels avant de changer d’échelle.
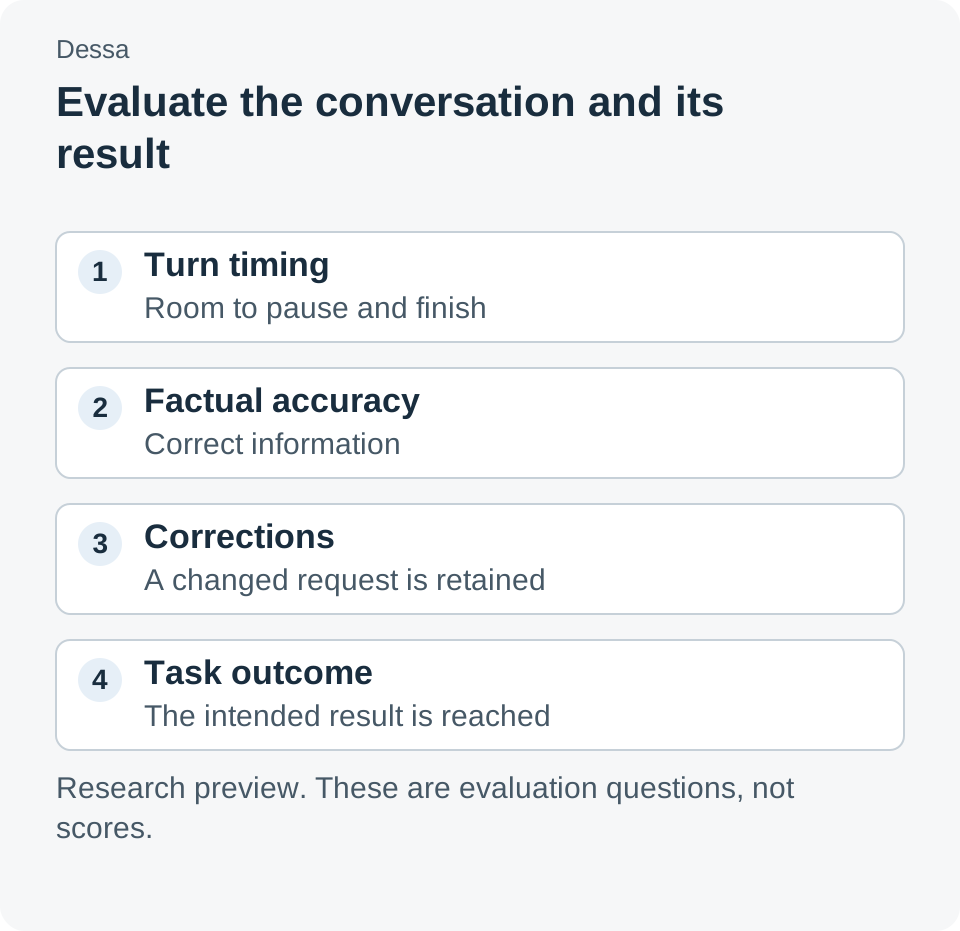
Guide d’évaluation original, sans taux de réussite, résultat de latence ni score comparatif implicite.
Une interface vocale devrait rendre la correction ordinaire
La promesse la plus utile de cette recherche n’est pas que chaque assistant devienne impossible à distinguer d’un humain. Elle est de réduire l’effort demandé pour adapter sa parole à une interface rigide. Pauses, interruptions et pensées inachevées font partie de la conversation ordinaire.
Dessa donne un objet concret à cette possibilité : un modèle dont les développeurs disent qu’il a appris par la seule parole. La question suivante est de savoir si ce comportement tient dans les situations réellement nécessaires. Une bonne interface facilite la poursuite, la clarification et la correction tout en gardant la tâche compréhensible.
Sources
- Block : Dessa — recherche officielle, démonstrations, matériel et état de l’accès ; vérifiés le 27 octobre 2026.
- Actualités Block — annonce du 23 octobre 2026.
- Défossez et collègues : Moshi, a speech-text foundation model for real-time dialogue — recherche primaire de 2024 sur le dialogue parole-texte en duplex intégral.
Sources vérifiées le 27 octobre 2026. Les détails produit sont attribués à leurs éditeurs. Scénarios et étapes sont illustratifs ; nous n’avons ni installé Dessa ni mesuré ses performances. Les enregistrements officiels se trouvent sur la page du projet.
Une recommandation de Telli.sh
Vous voulez un endroit consultable pour les enregistrements, les notes de référence et les décisions après une conversation ? Rassemblez vos références dans Telli.sh pour garder des transmissions compréhensibles.