Dessa de Block pregunta qué puede aprender un modelo de voz antes de leer
Dessa es un avance de investigación de Block entrenado solo con habla. Sus demos de dúplex completo plantean preguntas sobre ritmo, precisión y conversación natural.
Di «Está bien» con alivio y repítelo después de una pausa larga, con voz plana. Las palabras no cambian. La conversación sí.
Block presentó Dessa el 23 de octubre de 2026 como un modelo entrenado con conversaciones humanas, sin texto ni un modelo preentrenado. La empresa de Square y Cash App lo describe como un sistema de voz de dúplex completo: puede escuchar mientras habla. Es un avance de investigación con grabaciones públicas y acceso limitado para investigadores de seguridad, no una API de voz disponible de forma general.
Lo interesante es qué ocurre cuando el ritmo y la expresión vocal forman parte del aprendizaje desde el principio. Este artículo explica la distinción, propone una manera práctica de escuchar las demos y considera tres trabajos donde importaría el comportamiento conversacional. Nuestra opinión: el próximo sistema de voz útil debe tratar el espacio entre palabras con el mismo cuidado que las palabras.
Imagen principal: ilustración editorial original del habla y los tiempos de conversación. No representa una instalación de Dessa ni una señal de audio medida.
El habla contiene información que una transcripción limpia puede perder
Una transcripción permite buscar, citar e inspeccionar una conversación. Sin embargo, suele ofrecer una representación más limitada que la grabación. Énfasis, pausas, solapamientos y sonidos no verbales afectan a la interpretación de una frase.
Considera una conversación ilustrativa para fijar una cita. Alguien dice «El jueves me va bien» y añade inmediatamente «Espera, después de comer». Un asistente útil conserva la corrección y no considera la primera parte una instrucción cerrada. El momento importa porque el sistema quizá ya prepara una respuesta.
Otro ejemplo es un breve «ajá». Puede significar «sigo escuchando», no «quiero tomar la palabra». Tratar cada sonido como un turno completo hace agotadora la interacción. Ignorar toda interrupción breve puede hacer perder una corrección real.
Es el problema del ritmo de la conversación: decidir cuándo continuar, esperar, asentir o ceder. No basta con dar más expresividad a una voz sintetizada. El sistema también debe decidir cómo fluye el intercambio.
Los investigadores de Moshi, publicado en 2024, trataron explícitamente el habla solapada y las interjecciones como limitaciones de los procesos de turnos segmentados. Es un contexto útil: el diálogo de dúplex completo es anterior a Dessa. La afirmación distintiva de Block es el entrenamiento solo con habla, que debe evaluarse aparte de la categoría general de escuchar y hablar simultáneamente.
Tres preguntas evitan confundir tres capacidades
«Nativo de voz» puede aludir a los datos de entrenamiento, a la información que circula entre componentes durante la ejecución o a los tiempos de interacción. Avanzar en una dimensión no resuelve necesariamente las otras.
La tabla las separa. Es una comparación conceptual para leer anuncios, no una clasificación de benchmarks ni una descripción completa de la implementación interna de un modelo.
| Pregunta | Qué examina | Qué no demuestra por sí sola |
|---|---|---|
| ¿Con qué se entrenó? | Si el aprendizaje utilizó habla, texto o ambos | Precisión en una tarea o idioma concreto |
| ¿Qué procesa durante la ejecución? | Si el audio llega directamente al modelo o pasa por otras representaciones | Naturalidad al gestionar interrupciones |
| ¿Pueden solaparse entrada y salida? | Si escucha mientras produce habla | Interpretación correcta de emoción o intención |
La página de Dessa, comprobada el 27 de octubre de 2026, sitúa su propuesta en las tres dimensiones: aprendizaje solo con habla, interacción de audio a audio y tiempos de dúplex completo. Son descripciones del equipo, no una puntuación publicada para la calidad de cada conversación posible.
Moshi ilustra la utilidad de distinguirlas. Su artículo describe un sistema de habla y texto de dúplex completo construido sobre un modelo de lenguaje textual. Sigue un aprendizaje diferente al descrito para Dessa y también aborda diálogo oral solapado. Llamar a todo sistema de voz «proceso de transcripción» borraría esa diferencia.
Un equipo de producto debe preguntar qué dimensión importa para su trabajo. Un archivo consultable necesita texto fiable. Un tutor interactivo requiere comentarios útiles y ritmo adecuado. Un agente de atención al cliente también necesita conocimiento y permisos para completar la tarea empresarial.
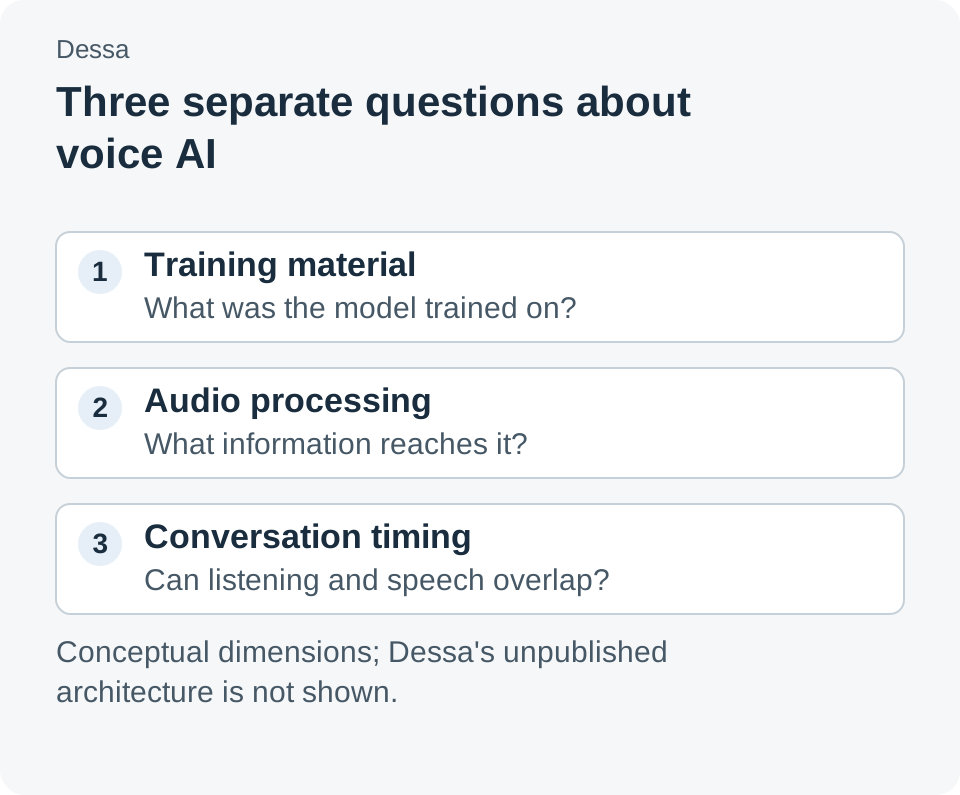
Diagrama explicativo original. Separa tres preguntas sin afirmar que revele la arquitectura inédita de Dessa. Fuentes: página de Dessa de Block y artículo de Moshi de 2024.
Una voz convincente y una respuesta correcta necesitan pruebas distintas
Una respuesta expresiva resulta fácil de seguir, pero también puede hacer más persuasiva una afirmación sin fundamento. Si alguien siente que el sistema le entiende, quizá se detenga menos a comprobar un detalle.
Por eso empatía percibida, exactitud factual y finalización de tarea requieren criterios propios. Un reconocimiento amable puede ser apropiado aunque falte información para responder. En ese caso, suele ser mejor preguntar con claridad y en buen momento que ofrecer una conjetura emocionalmente pulida.
Imagina una consulta ilustrativa sobre un paquete retrasado. La persona suena frustrada e interrumpe para corregir el número de pedido. Un sistema útil permite la corrección, conserva el identificador adecuado y explica la siguiente acción disponible. Un tono cálido no arregla una consulta errónea ni una promesa no autorizada.
Lo mismo ocurre si alguien parece inseguro. Una pausa puede ser duda, búsqueda de una palabra, distracción o final del turno. El audio aporta indicios, pero su significado depende del contexto. Una evaluación sensata debe valorar la aclaración ante señales ambiguas.
Block invita a un grupo limitado de investigadores de seguridad a examinar Dessa. Es una descripción significativa de la fase actual. No demuestra que cumpla ya la fiabilidad necesaria para soporte, educación u otro despliegue.
Las demos oficiales son un ejercicio de escucha, no una tabla de resultados
La página pública ofrece grabaciones seleccionadas, entre ellas una conversación sobre el lanzamiento y recuerdos de películas. La empresa dice que el modelo elige sus respuestas y que los subtítulos se añadieron después. Permiten inspeccionar ejemplos, pero no saber con qué frecuencia aparece ese comportamiento en un conjunto amplio.
Escucha el ritmo antes de leer subtítulos. ¿Cuándo empieza la respuesta? ¿El asentimiento acompaña el turno humano o compite con él? ¿Hay espacio para que la persona se corrija?
Después revisa el contenido. Evalúa cualquier afirmación factual por separado de la calidad de la expresión. Una respuesta puede tener ritmo excelente y necesitar corrección. Separar ambos juicios evita sustituir las pruebas sobre la tarea por una demo agradable.
Por último, observa la recuperación. Un malentendido es especialmente informativo cuando el hablante lo corrige. ¿Se resuelve o el sistema continúa con la interpretación inicial? Una recuperación no establece una tasa, aunque ayuda a diseñar una evaluación posterior.
También existe un límite claro: una grabación elegida no permite controlar instrucciones, entorno ni repeticiones. Úsala para formular preguntas de una prueba, no para resolver de antemano todas las dudas de despliegue.
Tres posibles usos muestran por qué importa el momento
Los escenarios siguientes ilustran aplicaciones de capacidad conversacional. No son despliegues de clientes anunciados ni afirman que la versión actual tenga las integraciones necesarias. Cada uno separa el comportamiento interesante del trabajo necesario para hacerlo fiable.
Un compañero de práctica de idiomas podría esperar durante las dudas de un alumno y reconocer una autocorrección acertada. La evaluación debe distinguir ánimo útil de interrupciones que impiden practicar. También hacen falta pruebas del idioma objetivo, calidad de correcciones y manejo de errores repetidos; una demo natural en inglés no responde a ello.
Un asistente de ensayo oral podría ayudar a practicar presentaciones o conversaciones difíciles. Debería dejar terminar una idea, hacer preguntas y responder a instrucciones cambiadas. El equipo debe decidir si busca ensayo, comentarios o orientación factual, porque requieren criterios distintos.
Una interfaz de clasificación inicial de consultas podría escuchar, pedir aclaraciones y conservar correcciones sin reiniciar el diálogo. Lo difícil es conectar la conversación con el caso y la acción correctos. Acceso al conocimiento, autenticación, escalado y permisos de transacción siguen siendo responsabilidades separadas.
Comparten un patrón: una conversación más fluida reduce fricción para llegar a la siguiente decisión. El valor depende de que sea útil y corregible. Gestionar interrupciones y recuperarse son requisitos prácticos del producto, no detalles exclusivos de una demo.
La ejecución local es una afirmación de hardware condicionada por el acceso
Block afirma que Dessa funciona localmente en un MacBook Pro M4 Max o superior y se entrenó con un NVIDIA GB200 NVL72. Ambos datos proceden de la página oficial, consultada el 27 de octubre de 2026. Los comunica el desarrollador; no los medimos en una instalación propia.
Entrenamiento e inferencia responden a preguntas distintas. La máquina que entrena un modelo no es la que necesariamente necesita su usuario. La mención del portátil tampoco equivale a una matriz publicada de memoria y latencia.
El acceso es otra cuestión. La página sigue marcando los enlaces de lanzamiento como próximos y describe acceso anticipado para investigadores seleccionados. No ofrece precios generales de API, pesos descargables ni una tabla de idiomas sobre la que planificar producción.
Para un desarrollador, esto basta para identificar preguntas que seguir. No basta para programar una migración desde su sistema de voz actual. Harían falta artefactos utilizables, detalles de integración, mediciones en el hardware previsto y soporte claro.
Diseña una evaluación con silencio y correcciones
Si se abre una prueba más amplia, empieza con tareas cuyos resultados correctos sean fáciles de inspeccionar. Usa los mismos escenarios entre sistemas y conserva, con consentimiento de los participantes, el audio necesario para entender juicios discutidos. El procedimiento es una propuesta, no un experimento realizado para el artículo.
- Define el resultado deseado. Para una cita, anota fecha y hora; para un ensayo, los comentarios pedidos. No uses solo una nota general de «suena humano».
- Escribe escenarios emparejados. Mantén la solicitud similar y cambia un evento: pausa, asentimiento, interrupción o corrección explícita. Facilita discutir la causa del fallo.
- Incluye una instrucción de recuperación. Pide corregir un detalle anterior. Comprueba que la respuesta final lo refleje y que el cambio quede claro en la conversación.
- Juzga tiempos y contenido por separado. Registra interrupciones inapropiadas, correcciones perdidas y hechos sin respaldo. Una puntuación compuesta puede ocultar debilidades importantes.
- Prueba el entorno previsto. Cuando el acceso lo permita, repite tareas representativas en el dispositivo y montaje de audio reales. Una prueba de micrófono en silencio demuestra ese entorno, no todos los espacios o auriculares.
- Revisa desacuerdos con el audio. Reproduce el momento relevante y afina los criterios. El desacuerdo puede revelar una tarea mal definida, no solo un error del modelo.
Un primer conjunto ilustrativo podría tener doce escenarios: cuatro con pausas, cuatro con correcciones y cuatro con asentimientos breves. Es un punto de partida sugerido, no una afirmación de suficiencia científica ni un benchmark de Dessa publicado. Busca mostrar exigencias distintas antes de ampliar la escala.
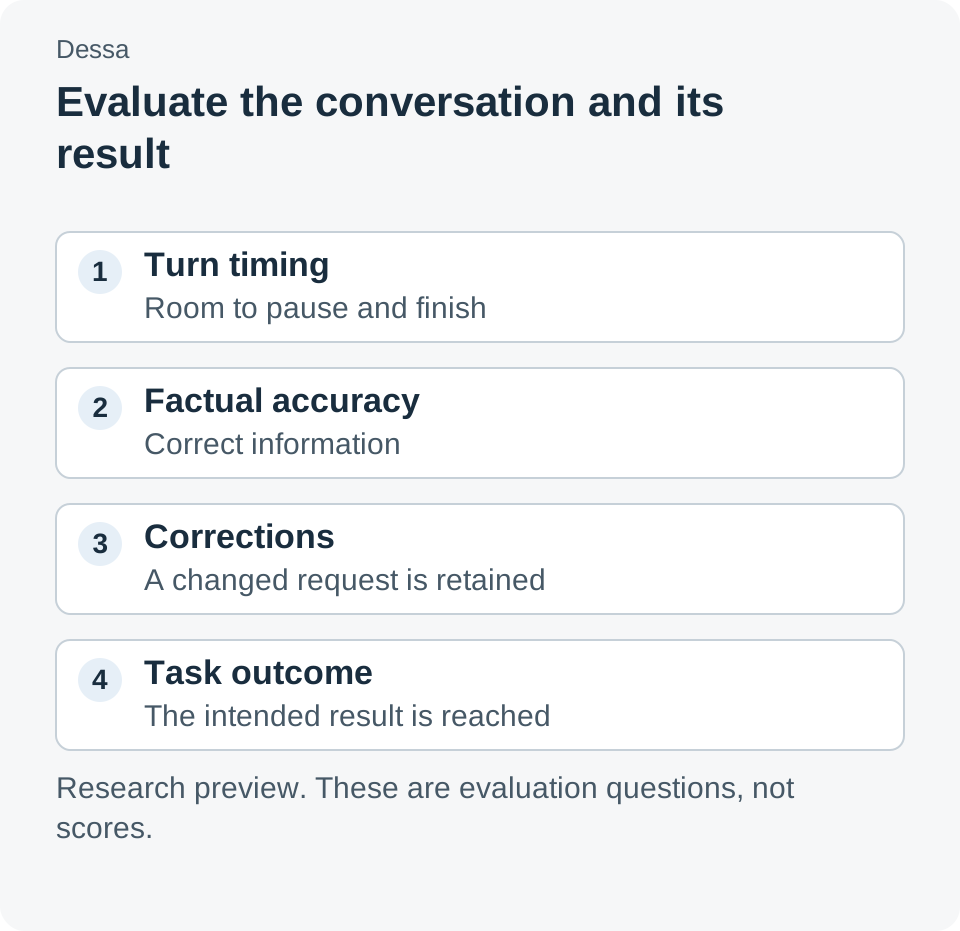
Guía original de evaluación. No implica tasa de éxito, latencia medida ni puntuación comparativa de modelos.
Una interfaz de voz debería convertir corregir en algo normal
La promesa más útil no es hacer que todo asistente resulte indistinguible de una persona. Es reducir el esfuerzo necesario para adaptar el habla a una interfaz rígida. Pausas, interrupciones e ideas a medio terminar forman parte de conversar.
Dessa aporta un objeto de investigación concreto: un modelo que, según sus creadores, aprendió solo mediante habla. La siguiente pregunta es si ese comportamiento resiste las situaciones que los usuarios necesitan. Una buena interfaz facilita continuar, aclarar y corregir sin perder la comprensión de la tarea.
Fuentes
- Block: Dessa — descripción, demos, hardware y acceso oficiales; comprobados el 27 de octubre de 2026.
- Noticias de Block — anuncio del 23 de octubre de 2026.
- Défossez y colaboradores: Moshi, a speech-text foundation model for real-time dialogue — investigación primaria de 2024 sobre diálogo de habla y texto de dúplex completo.
Fuentes comprobadas el 27 de octubre de 2026. Los detalles se atribuyen a sus publicadores. Los escenarios y pasos son ilustrativos; no instalamos Dessa ni medimos su rendimiento. Las grabaciones oficiales están en la página enlazada.
Una recomendación de Telli.sh
¿Quieres un lugar consultable para grabaciones, notas de referencia y decisiones posteriores a una conversación? Reúne tus referencias en Telli.sh y facilita la comprensión de los traspasos.