DeepSeek V4.1 Flash 1017: zbuduj pierwszy projekt, a potem podłącz API
Zacznij od działającego projektu w przeglądarce, podłącz DeepSeek Flash w Windows, Macu lub Linuksie i poznaj aktualizację z 17 października, tryb thinking, wizję, koszty i ograniczenia.
Model programistyczny staje się użyteczny, gdy napisany przez niego program naprawdę działa. Zacznij właśnie od tego: od małej aplikacji, którą można otworzyć, sprawdzić i ulepszać, zamiast od ogromnego promptu z prośbą o zbudowanie całej firmy.
DeepSeek wydał V4.1 Flash 10 września 2026 r.; aktualizacja 1017 pojawiła się 17 października, a nie była pierwszym wydaniem V4.1. Aktualizacja jest dostępna w witrynie, aplikacji i API DeepSeek, a identyfikator modelu API pozostaje deepseek-flash. Dziennik aktualizacji DeepSeek z datami
Ten przewodnik prowadzi od pierwszego projektu w przeglądarce do powtarzalnego procesu pracy nad oprogramowaniem, a potem przez konfigurację API w Windows, macOS i Linuksie. Następnie omówimy architekturę, benchmarki dostawcy, koszty tokenów i praktyczne ograniczenia, które warto rozważyć, zanim powierzysz agentowi większe zadanie.
Grafika nagłówkowa: oryginalna ilustracja objaśniająca, przedstawiająca specyfikację, budowanie, kontrolę i poprawianie. Pokazuje przepływ pracy, a nie zrzut ekranu produktu DeepSeek.
Najpierw uzyskaj pierwszy działający wynik, dopiero potem coś instaluj
Otwórz czat internetowy DeepSeek lub oficjalną aplikację i rozpocznij nową rozmowę. W tym pierwszym ćwiczeniu użyj wymyślonych danych. Publiczna usługa AI nie jest miejscem, w którym chcesz odkryć, że przykładowy plik zawiera listę klientów albo token dostępu.
Naszym pierwszym projektem będzie kolejka czytelnicza: niewielka strona z artykułami, do których chcesz wrócić. Nie potrzebuje konta, bazy w chmurze ani klucza API. To przykładowe ćwiczenie, a nie relacja z uruchomienia modelu.
-
Poproś o najmniejszy kompletny artefakt za pomocą takiego promptu:
Zwykły tekstBuild a reading queue as one self-contained index.html file. Use plain HTML, CSS and JavaScript, with no libraries or network calls. Include three fictional example articles, a title filter, and a read/unread toggle. Keep state in memory; reloading should reset it. Use accessible labels and make the layout work at 360px wide. Return the complete file, followed by five manual acceptance checks. Do not add login, analytics, remote fonts or a backend. -
Umieść wygenerowany plik w nowym, pustym folderze i otwórz
index.htmlw przeglądarce. Zanim otworzysz nieznany kod, sprawdź, czy nie zawiera nieoczekiwanych żądań sieciowych lub skryptów. Ćwiczenie nie powinno wymagać polecenia w terminalu, pobrania zależności ani dodatkowych uprawnień. -
Samodzielnie sprawdź działanie: filtruj po fragmencie tytułu, przełącz status artykułu, usuń filtr, zwęź okno i odśwież stronę. Przełącznik powinien działać również po filtrowaniu, ale po odświeżeniu wrócić do stanu początkowego, zgodnie z zakresem zadania.
-
Przekaż jedną konkretną usterkę: „Filtrowanie ukrywa wszystkie wiersze, gdy zapytanie ma spacje na końcu. Usuń nadmiarowe spacje z zapytania, zachowaj pozostałe zachowanie i zwróć poprawiony plik”. Ponownie wykonaj te same kontrole.
To pierwszy sukces, który da się rozpoznać. „Wygląda dobrze” jest subiektywne; „przełącznik nadal działa po filtrowaniu” to kryterium akceptacji. Celowo mały pierwszy projekt ułatwia też ocenę, czy poprawka rozwiązała problem, czy tylko zmieniła wygląd.
Październikowa aktualizacja dotyczy domykania projektów, nie tylko pisania fragmentów kodu
DeepSeek informuje, że aktualizacja 1017 wykorzystuje uczenie przez wzmacnianie z autorefleksją, aby poprawić kompleksowy rozwój projektów. W ogłoszeniu pokazano cztery przykłady: modelowanie 3D Zakazanego Miasta, wyścigową grę internetową, odtworzenie w Godot gry inspirowanej Portal 2 oraz Valley of Ages, trójwymiarową scenę obejmującą kolejne epoki historyczne. Obejrzyj oficjalne demonstracje projektów; to przykłady wydawcy, a nie gwarantowane rezultaty dowolnego promptu.
Ważne jest rozróżnienie: uczenie z autorefleksją to deklaracja dotycząca rozwoju modelu, natomiast informację zwrotną dla twojego projektu uzyskujesz przez uruchomienie programu. Sama odpowiedź czatu nie uruchamia przeglądarki, nie sprawdza repozytorium ani nie weryfikuje kompilacji gry tylko dlatego, że podczas treningu model uczył się z informacji zwrotnej. Do takich działań potrzebne są środowisko i narzędzia.
Pomyśl o tym procesie jak o pętli projektu: określ, zaimplementuj, sprawdź, popraw. Naszym zdaniem ważniejsza od rozmiaru pierwszej wygenerowanej odpowiedzi jest właśnie ta pętla. Niewielka zmiana, która przechodzi kryterium akceptacji, jest cenniejsza niż imponujące repozytorium, którego nikt nie uruchomił.
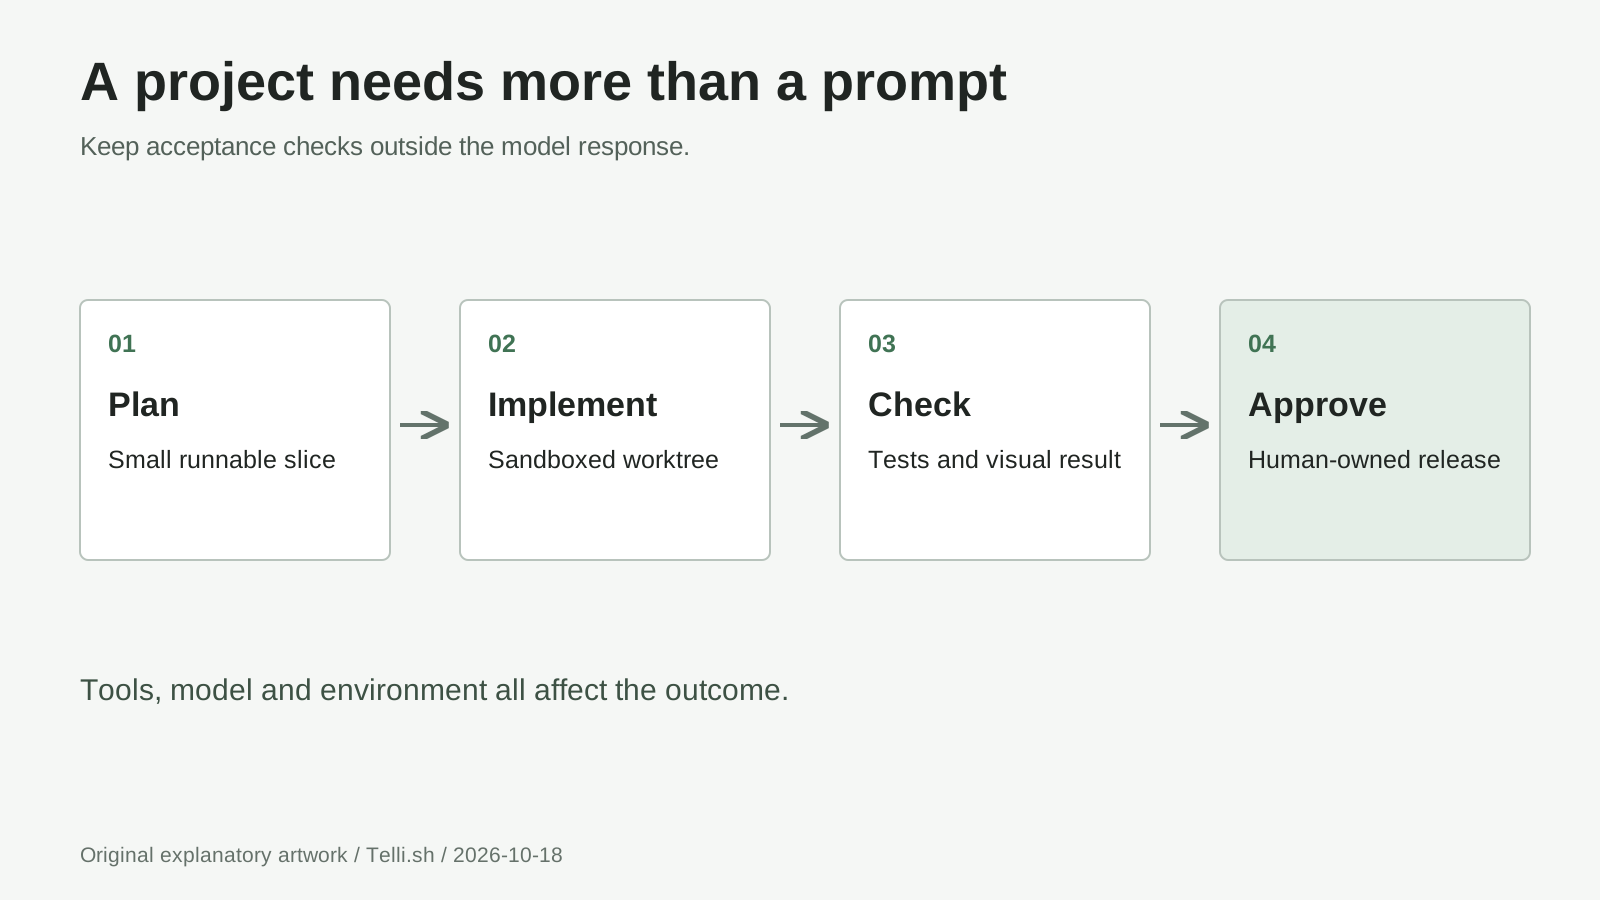
Oryginalny diagram: kryteria akceptacji i zgoda na wydanie pozostają poza odpowiedzią modelu. To narzędzia i środowisko wykonania określają, co da się rzeczywiście zweryfikować.
Rozbuduj kolejkę czytelniczą, wyznaczając jej jasny koniec
Wyobraź sobie drugą iterację: kolejkę czytelniczą dla małej grupy naukowej. Członkowie mają dodawać linki, oznaczać artykuły jako przeczytane i eksportować kolejkę. Zachowaj wersję jednoosobową i działającą w przeglądarce; współpraca i synchronizacja to osobne projekty.
- Opisz kontrakt. Wymagaj tytułu, adresu URL i statusu przeczytania; odrzucaj nieprawidłowe linki, zachowuj pozycje po odświeżeniu i eksportuj plik JSON. Określ zachowanie dla pustej listy, długiego tytułu i nieprawidłowego importu. Pomiń uwierzytelnianie i przechowywanie na serwerze.
- Przed zmianami poproś o plan. Niech model wskaże potrzebne pliki, sposób przechowywania danych i proponowane testy. Udostępnij mu pusty folder lub odizolowany worktree. Nie zaczynaj od oddania mu katalogu domowego, danych dostępowych produkcji ani zgody na instalowanie dowolnego oprogramowania.
- Wdrażaj jedną pionową część naraz. Dodaj jeden artykuł, zapisz go i odśwież stronę. Następnie dodaj filtrowanie, a potem eksport i import. Każda kolejna część powinna nadal dać się uruchomić, tak aby zepsuta funkcja eksportu nie splątała się z migracją pamięci i niezwiązaną zmianą wyglądu.
- Przekazuj dowody. Podaj dokładny błąd, dane wejściowe i oczekiwane zachowanie. Przy problemie układu dołącz przycięty zrzut ekranu bez prywatnych informacji. Poproś o wąską poprawkę i ponów te same kontrole, zamiast za każdym razem przyjmować całkiem nową wersję.
- Zatwierdź kandydata do wydania. Sprawdź nawigację klawiaturą, pustą kolejkę, duplikaty linków i długi tytuł. Wyeksportuj listę, wyczyść testowe dane, zaimportuj plik i potwierdź zachowanie pól. Przed zaakceptowaniem kolejnej zmiany zachowaj znaną, działającą kopię.
Model może też pomóc przygotować plan testów przed implementacją. Na przykład poproś o opis oczekiwanej struktury JSON i wskazanie pól, które importer powinien weryfikować. Następnie porównaj implementację z tym planem. Dzięki temu obietnicę oddzielasz od kodu, a różnice stają się widoczne.
Harness dostarcza wokół modelu edycję plików, wykonywanie poleceń i inne narzędzia. W ogłoszeniu o wydaniu DeepSeek zaleca Harness v0.2.1-rc.1 lub nowszy dla wersji 1017. Zamiast zakładać, że samo żądanie do API tworzy agenta programistycznego, skorzystaj z oficjalnego przewodnika Harness.
Podłącz API, nie umieszczając sekretu na stronie internetowej
Użyj API, jeśli twój program potrzebuje odpowiedzi modelu. Kolejka czytelnicza może pozostać lokalną aplikacją przeglądarkową; poniższy skrypt to osobny pomocnik programistyczny uruchamiany w terminalu. Nigdy nie umieszczaj klucza DeepSeek w index.html, JavaScripcie przeglądarkowym ani publicznym repozytorium.
1. Utwórz klucz API i wybierz małe zadanie
Utwórz klucz w platformie API DeepSeek i sprawdź saldo konta. Przewodnik pierwszego wywołania DeepSeek opisuje zgodny z OpenAI bazowy URL https://api.deepseek.com i model deepseek-flash. Konto czatu internetowego nie daje nieograniczonego, płatnego dostępu do API.
W pierwszym żądaniu poproś o kryteria akceptacji, a nie o całe repozytorium. Wynik będzie łatwiejszy do sprawdzenia, a przy błędnej konfiguracji wygeneruje się mniej treści.
2. Przygotuj Pythona w swoim systemie operacyjnym
Zainstaluj Python 3, jeśli nie jest jeszcze dostępny. W nowym folderze projektu utwórz odizolowane środowisko i zainstaluj SDK. Poniższe polecenia uruchamiają interpreter bezpośrednio, więc nie wymagają aktywacji skryptem ani zmiany zasad wykonywania PowerShell. Opierają się na dokumentacji środowisk wirtualnych Pythona.
Windows, PowerShell:
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install --upgrade openai
Jeśli py nie jest dostępne, ale python --version wskazuje instalację Pythona 3, w pierwszym poleceniu użyj python -m venv .venv.
macOS, terminal:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Linux, terminal:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
W niektórych dystrybucjach Linuksa pakiet venv jest instalowany osobno. Jeśli podczas tworzenia środowiska pojawi się informacja o jego braku, zainstaluj pakiet środowisk wirtualnych Pythona udokumentowany przez twoją dystrybucję i ponów tworzenie. Nie rozwiązuj problemu izolowanego środowiska przez globalne sudo pip install.
3. Utwórz pomocniczy skrypt uruchamiany w terminalu
Obok .venv utwórz plik first_request.py z poniższym przykładem. Używa on ukrytego promptu na klucz za pomocą modułu getpass Pythona, zamiast umieszczać sekret w kodzie źródłowym lub historii powłoki. Uruchom go w zwykłym terminalu obsługującym ukryte dane wejściowe.
from getpass import getpass

from openai import OpenAI

client = OpenAI(
    api_key=getpass("DeepSeek API key: "),
    base_url="https://api.deepseek.com",
    timeout=120.0,
    max_retries=0,
)

reply = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{
        "role": "user",
        "content": (
            "Propose five manual acceptance checks for a browser-only "
            "reading queue with filtering, read status and JSON export. "
            "Return checks only; do not claim to have executed them."
        ),
    }],
    max_tokens=2048,
    stream=False,
    extra_body={"thinking": {"type": "disabled"}},
)

print(reply.choices[0].message.content)
print("Finish reason:", reply.choices[0].finish_reason)
print("Usage:", reply.usage)
4. Uruchom skrypt i sprawdź odpowiedź
W Windows uruchom \.venv\Scripts\python.exe first_request.py. W macOS lub Linuksie użyj ./.venv/bin/python first_request.py. Po wyświetleniu monitu wklej swój klucz; oczekiwanym wynikiem jest lista kontroli, przyczyna zakończenia i informacje o zużyciu, a nie nowe pliki projektu.
W razie błędu przed ponowieniem sprawdź kod statusu. 401 dotyczy uwierzytelniania, 402 — niewystarczającego salda, a 429 — limitu; DeepSeek opisuje te kody w przewodniku błędów. Przyczyna zakończenia length oznacza osiągnięcie limitu, a nie kompletną odpowiedź. Podczas poznawania API ponawiaj żądania z namysłem.
Tryb thinking, wizja i narzędzia internetowe służą różnym celom
Tryb thinking jest domyślnie włączony z poziomem high. W przypadku trudniejszego pytania diagnostycznego zastąp extra_body z przykładu wartością {"thinking": {"type": "enabled"}} i dodaj reasoning_effort="high". Udokumentowane poziomy to low, high i max; tryb thinking ignoruje temperature, więc obniżenie tej wartości nie jest skrótem do bardziej niezawodnego rozumowania. Przewodnik trybu thinking, sprawdzony 18 października
Thinking również zużywa budżet generowania. Przechodząc z krótkich odpowiedzi bez tego trybu do złożonego rozumowania, świadomie zwiększ niski limit wyjściowy. Jeśli implementujesz wywołania narzędzi w trybie thinking, zachowuj reasoning_content asystenta w kolejnych żądaniach z narzędziami, zgodnie z wymaganiami przewodnika. Nie buduj rozmowy narzędziowej, zachowując wyłącznie widoczną odpowiedź końcową.
Wizja przyjmuje obrazy razem z tekstem; nie jest endpointem generowania obrazów. W Chat Completions umieść treść obrazu w wiadomości użytkownika jako blok image_url, adres URL danych base64 lub format udokumentowany przez Files API. Obsługiwane są JPEG, PNG, GIF i WebP. Limit treści żądania inline wynosi 48 MiB, a limit pojedynczego obrazu inline lub podlinkowanego — 32 MiB. Przewodnik Vision
W przypadku kolejki czytelniczej wyślij zanonimizowany zrzut ekranu i zapytaj, które etykiety nachodzą na siebie przy małej szerokości. Potraktuj odpowiedź jako diagnozę do sprawdzenia w przeglądarce, a nie dowód naprawienia układu. Rozumienie obrazu nie daje też API prawa do poruszania myszą ani modyfikowania plików.
Search znajduje strony, a Fetch pobiera stronę jako Markdown. Ich samodzielne endpointy to POST /v1/tools/search i POST /v1/tools/fetch; uwierzytelnianie odbywa się tym samym kluczem bearer. Żądanie Search może zawierać {"query":"browser storage documentation","count":3}, a Fetch — {"url":"https://developer.mozilla.org/en-US/docs/Web/API/Storage"}. Aplikacja musi jawnie wywołać te endpointy albo użyć integracji, która je udostępnia. Wspomnienie adresu URL w zwykłym żądaniu czatu nie uruchamia tego przepływu. Przewodnik Search i Fetch
Pobraną treść traktuj oddzielnie od instrukcji. Odnaleziona strona jest źródłem informacji, a nie upoważnieniem do uruchomienia polecenia, ujawnienia klucza ani zmiany wymagań projektu. Fetch nadal podlega zasadom dostępu danej witryny; nie zapewnia dostępu do prywatnych ani płatnych materiałów.
Duży model bazowy może aktywować mniej parametrów, ale nie zmieści się przez to w laptopie
Karta bazowego modelu V4.1 z września opisuje architekturę MoE o 552 miliardach parametrów, aktywującą około 8 miliardów parametrów na token wejściowy podczas prefill i 16 miliardów na token wyjściowy podczas dekodowania. Architektura Causal Encoder-Decoder rozdziela 20-warstwowy enkoder przyczynowy od 20-warstwowego dekodera. Te szczegóły dotyczą bazowego wydania V4.1, a nie nowej architektury ogłoszonej 17 października. Architektura modelu bazowego i odnośnik do raportu technicznego
Mówiąc prościej, prefill przetwarza istniejący prompt, a dekodowanie tworzy odpowiedź. Routing Mixture-of-Experts wybiera wyspecjalizowane części modelu zamiast aktywować wszystkie parametry bazowe dla każdego tokenu. Skompresowana uwaga i wspólna pamięć podręczna modelu mają ograniczyć koszt długich promptów. Mniejsza liczba aktywnych parametrów opisuje jednak obliczenia, a nie pełne wymagania dotyczące przechowywania i uruchomienia checkpointu.
Deklarowane okno kontekstu wynosi milion tokenów. To pojemność, a nie wymóg wklejania całego repozytorium do każdego żądania ani gwarancja doskonałego przypominania. Zacznij od zadania, odpowiednich plików i konkretnych błędów; rozszerz kontekst, gdy uzasadnia to brakująca zależność lub kontrakt.
Do samodzielnego hostowania użyj oficjalnych instrukcji inferencji dla 1017, które opisują konwersję checkpointu i wykonanie tensor-parallel. Ogólny program uruchamiający vLLM na stronie Hugging Face nie jest instrukcją wdrożenia dostosowaną do danego modelu. Przed pobraniem wag sprawdź sprzęt, obsługiwane jądra i zgodność serwowania. deepseek-recipe obsługuje konwersję promptów i protokołu; nie dostarcza inferencji ani nie wykonuje narzędzi. Zwykli użytkownicy laptopów powinni zacząć od dostępu hostowanego.
Szacuj koszt całego zadania, a nie najtańszego tokenu
Według cennika z 18 października 2026 r. DeepSeek podaje następujące stawki Flash w dolarach amerykańskich za milion tokenów. Oficjalny cennik
| Kategoria tokenów | Okres szczytowy | Poza szczytem |
|---|---|---|
| Wejściowe, brak trafienia w cache | $0.30 | $0.15 |
| Wejściowe, trafienie w cache | $0.006 | $0.003 |
| Wyjściowe | $1.20 | $0.60 |
Okresy szczytowe to 01:00–04:00 i 06:00–10:00 UTC od poniedziałku do piątku, z wyłączeniem chińskich świąt państwowych; pozostałe godziny są poza szczytem. Według tego harmonogramu cały weekend jest poza szczytem. Planując wywołania, używaj UTC zamiast zakładać, że lokalne godziny dzienne są droższe.
Dla przykładowego, hipotetycznego zadania z 100 000 wejściowych tokenów bez trafienia w cache, 200 000 z trafieniem i 20 000 wyjściowych obliczenie w okresie szczytowym wygląda tak:
(0.1 x $0.30) + (0.2 x $0.006) + (0.02 x $1.20)
= $0.0300 + $0.0012 + $0.0240
= $0.0552
Przy stawkach poza szczytem te same założone ilości kosztują $0.0276. To rachunek, a nie zmierzony koszt projektu. Do obliczeń używaj rzeczywistego zużycia przy trafieniach i braku trafień w cache; nie zakładaj, że powtarzany kontekst zawsze otrzyma tańszą stawkę.
Search i Fetch kosztują po $0.75 za 1000 udanych żądań zwracających wyniki. Zatem 40 rozliczanych wyszukiwań i 60 pobrań dodają $0.075, bez uwzględnienia tokenów modelu zużytych na odczyt wyników. Tymczasowy okres bez opłat dotyczy wywołań po stronie serwera przez wymienione integracje API DeepSeek; rozliczanie rozpoczyna się 31 października 2026 r. o 16:00 UTC. To nie jest ogólny darmowy okres dla bezpośredniego użycia endpointu. Zasady rozliczania narzędzi
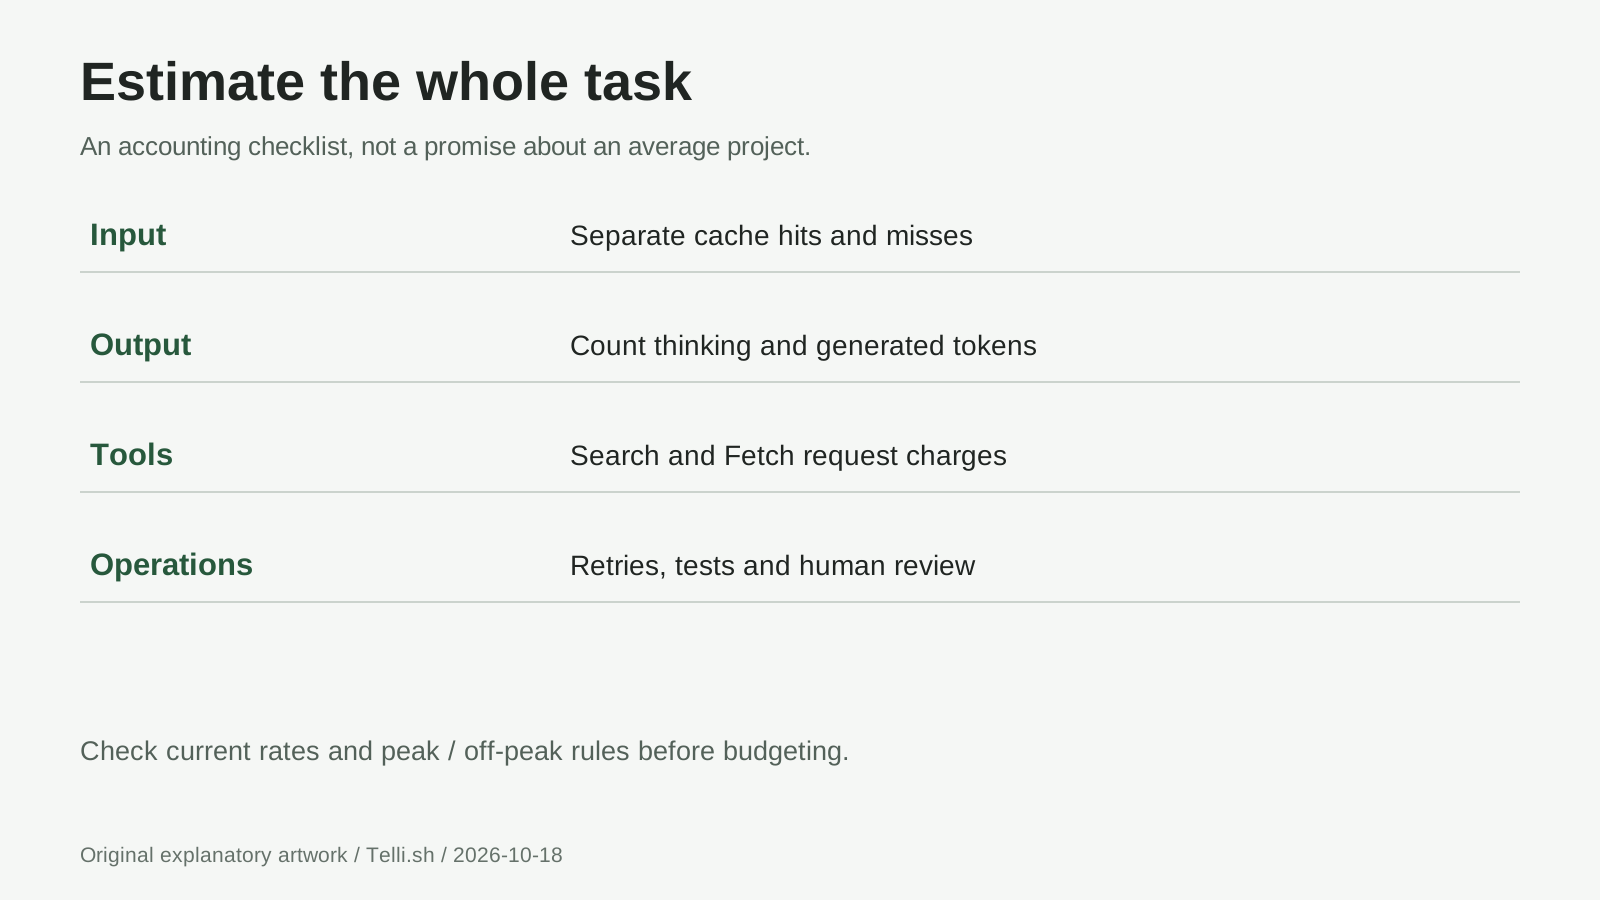
Oryginalny diagram rozliczenia: uwzględnij tokeny generowane podczas thinking, ponowienia, wywołania narzędzi i pracę przy weryfikacji. Nie przedstawia średniego kosztu projektu.
Oceniaj wzrosty benchmarków razem z harness
DeepSeek podaje następujące zmiany między bazowym V4.1 Flash a 1017. To wyniki zgłoszone przez dostawcę, a nie niezależne pomiary z tego przewodnika. Porównanie na karcie modelu 1017
| Benchmark | V4.1 Flash | 1017 | Zmiana |
|---|---|---|---|
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 pkt |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 pkt |
| ProgramBench | 20.3 | 29.1 | +8.8 pkt |
Karta modelu 1017 wymienia Claude Code dla Terminal-Bench 4.0 i Mini-SWE-V2 dla DeepSWE v1.1. Harness zapewnia narzędzia, zarządzanie kontekstem i zasady wykonania; zmiana harness zmienia eksperyment. Nie traktuj różnicy wyników w odmiennych konfiguracjach jako czystego pomiaru możliwości modelu.
Porównując modele samodzielnie, utrzymuj stałe repozytorium, kryteria akceptacji, uprawnienia i budżet. Zapisuj, czy projekt działa, ilu poprawek wymagał, jakie było całkowite zużycie i ile czasu upłynęło. Wyższy publiczny wynik pomaga wybrać kandydata; to powtarzalne zadanie w twoim środowisku rozstrzyga, czy model zasługuje na tę pracę.
Co ustalić przed powierzeniem mu większego zadania?
Czy 1017 to osobna nazwa modelu API?
Nie. Użyj deepseek-flash. Nazwa checkpointu z datą identyfikuje aktualizację, natomiast hostowane API DeepSeek zachowuje dotychczasowy identyfikator. Jeśli zależy ci na odtwarzalności, zapisuj datę i informacje o zwróconym modelu. Dokumentacja pierwszego wywołania
Czy wagi MIT sprawiają, że API jest bezpłatne?
Nie. Karta modelu 1017 udostępnia repozytorium i wagi na licencji MIT. Dostęp hostowany wiąże się z osobnymi opłatami. Licencja wag nie daje również praw do prywatnych danych wejściowych, zasobów stron trzecich ani mediów z demonstracji.
Czy zbuduje kompletną grę na podstawie jednego promptu?
Traktuj oficjalne demonstracje jako przykłady wyników wydawcy, a nie gwarancję dostarczenia. Przed dopracowaniem wyglądu określ ruch, kolizje, zachowanie restartu i warunek końcowy. Gra, którą można sprawdzić i uruchomić ponownie, jest lepszym kamieniem milowym niż duża baza wygenerowanego kodu.
Czy zawsze używać maksymalnego thinking i pełnego kontekstu?
Nie. Zacznij od ograniczonego zadania i zwiększ wysiłek lub kontekst dopiero wtedy, gdy wymaga tego konkretna usterka. Więcej generowanego rozumowania i dłuższe prompty zużywają zasoby; żadne z nich nie zastępuje kryteriów akceptacji ani ostrożnego zarządzania uprawnieniami narzędzi.
Czy mogę od razu opublikować wygenerowany projekt?
Najpierw sprawdź działanie, bezpieczeństwo, licencje zależności i pochodzenie zasobów. Usuń przykładowe dane uwierzytelniające i sprawdź zdalne żądania. Zgodę na wdrożenie zachowaj jako osobną decyzję od upoważnienia do edycji lokalnego projektu.
Konkluzja: projekt jest ukończony, gdy ktoś sprawdził wynik
Użyteczna obietnica 1017 to lepsze domykanie projektów, a nie powód, by przestać je kontrolować. Daj modelowi mały cel, ograniczone środowisko i obserwowalne kryteria. Rozwijaj projekt dopiero wtedy, gdy jego obecne działanie zasłuży na twoją akceptację.
Źródła
Dokumentację produktu i ceny sprawdzono 18 października 2026 r. Benchmarki i deklaracje dotyczące treningu przypisano DeepSeek; ćwiczenia są przykładami dydaktycznymi, a nie deklarowanymi wynikami testów praktycznych. Wszystkie trzy diagramy to oryginalne ilustracje objaśniające. Media z demonstracji dostawcy są podlinkowane, a nie reprodukowane.
- Aktualizacja z 17 października i demonstracje projektów
- Bazowe wydanie z 10 września
- Dziennik aktualizacji z datami
- Karta modelu 1017, benchmarki i licencja MIT
- Architektura bazowego V4.1 i raport techniczny
- Pierwsze wywołanie API, thinking, vision, Search i Fetch oraz cennik
- Oficjalna dokumentacja inferencji i deepseek-recipe
Ułatw sobie powrót do kolejnego projektu
Rekomendacja Telli.sh: zachowuj linki do źródeł, opis projektu, prompty i notatki z przeglądu razem, aby kolejna sesja zaczynała się od podjętych decyzji, a nie zgadywania. Telli.sh może porządkować wiedzę o projekcie; nie jest integracją z agentem programistycznym DeepSeek. Utwórz konto Telli.sh