DeepSeek V4.1 Flash 1017: crea il primo progetto, poi collega l'API
Comincia con un progetto funzionante nel browser, collega DeepSeek Flash su Windows, Mac o Linux e scopri aggiornamento del 17 ottobre, thinking, visione, costi e limiti.
Un modello per programmare diventa utile quando ciò che scrive funziona davvero. Parti da lì: una piccola applicazione che puoi aprire, esaminare e migliorare, non un prompt enorme che chiede di costruire un'intera azienda.
DeepSeek ha pubblicato V4.1 Flash il 10 settembre 2026; l'aggiornamento 1017 è arrivato il 17 ottobre, non è il primo rilascio di V4.1. L'aggiornamento è disponibile sul sito, nell'app e nell'API DeepSeek; l'identificativo del modello API resta deepseek-flash. Registro aggiornamenti datato di DeepSeek
Questa guida ti porta dal primo progetto nel browser a un flusso di sviluppo ripetibile, poi alla configurazione API su Windows, macOS e Linux. Infine esaminiamo architettura, benchmark del fornitore, costi dei token e limiti pratici da conoscere prima di assegnare un compito più ampio a un agente.
Immagine principale: illustrazione esplicativa originale che mostra specifica, costruzione, verifica e revisione. Illustra un flusso di lavoro, non uno screenshot del prodotto DeepSeek.
Ottieni un primo successo prima di installare alcunché
Apri la chat web di DeepSeek o l'app ufficiale e avvia una nuova conversazione. Per questo primo esercizio usa dati inventati. Un servizio AI pubblico non è il luogo adatto per scoprire che il file d'esempio contiene l'elenco dei clienti o un token di accesso.
Il primo progetto sarà una lista di lettura: una piccola pagina con gli articoli che vuoi leggere. Non richiede account, database cloud né chiave API. È un esercizio illustrativo, non il resoconto di un'esecuzione del modello.
-
Chiedi l'artefatto completo più piccolo con questo prompt:
Testo sempliceBuild a reading queue as one self-contained index.html file. Use plain HTML, CSS and JavaScript, with no libraries or network calls. Include three fictional example articles, a title filter, and a read/unread toggle. Keep state in memory; reloading should reset it. Use accessible labels and make the layout work at 360px wide. Return the complete file, followed by five manual acceptance checks. Do not add login, analytics, remote fonts or a backend. -
Inserisci il file generato in una cartella nuova e altrimenti vuota e apri
index.htmlnel browser. Prima di aprire codice generato che non conosci, controlla che non contenga richieste di rete o script inattesi. Questo esercizio non dovrebbe richiedere comandi da terminale, dipendenze scaricate o richieste di autorizzazione. -
Verifica personalmente il comportamento: filtra per una parte del titolo, cambia lo stato di lettura di un articolo, rimuovi il filtro, restringi la finestra e ricarica. Il cambio di stato dovrebbe sopravvivere al filtro ma azzerarsi al ricaricamento, come richiesto.
-
Comunica un errore concreto: «Il filtro nasconde tutte le righe quando la ricerca ha spazi finali. Rimuovi gli spazi dalla ricerca, conserva il resto del comportamento e restituisci il file aggiornato». Ripeti gli stessi controlli.
Questo è un primo successo riconoscibile. «Sembra a posto» è soggettivo; «il selettore continua a funzionare dopo il filtro» è un criterio di accettazione. Mantenere piccolo il primo progetto aiuta anche a capire se una revisione abbia risolto il problema o soltanto cambiato l'aspetto.
L'aggiornamento di ottobre riguarda il completamento dei progetti, non solo gli snippet
DeepSeek afferma che la versione 1017 usa apprendimento per rinforzo con autovalutazione per migliorare lo sviluppo di progetti completi. L'annuncio mostra quattro esempi: modellazione 3D della Città Proibita, un gioco di corse web, una ricreazione in Godot ispirata a Portal 2 e Valley of Ages, scena 3D che attraversa epoche storiche. Segui le dimostrazioni ufficiali dei progetti per esaminarli: sono demo del fornitore, non risultati garantiti per qualsiasi prompt.
Ecco la distinzione importante: l'addestramento con autovalutazione è un'affermazione sullo sviluppo del modello; il riscontro sul tuo progetto viene dall'eseguire il software. Una risposta in chat non esegue il browser, non ispeziona il repository e non verifica una build di gioco solo perché il modello ha appreso dal riscontro durante l'addestramento. Queste attività richiedono un ambiente e strumenti.
Considera il processo un ciclo di progetto: specificare, implementare, verificare, correggere. Secondo noi conta più del volume della prima risposta generata. Una modifica compatta con un criterio di accettazione superato vale più di un repository impressionante che nessuno ha avviato.
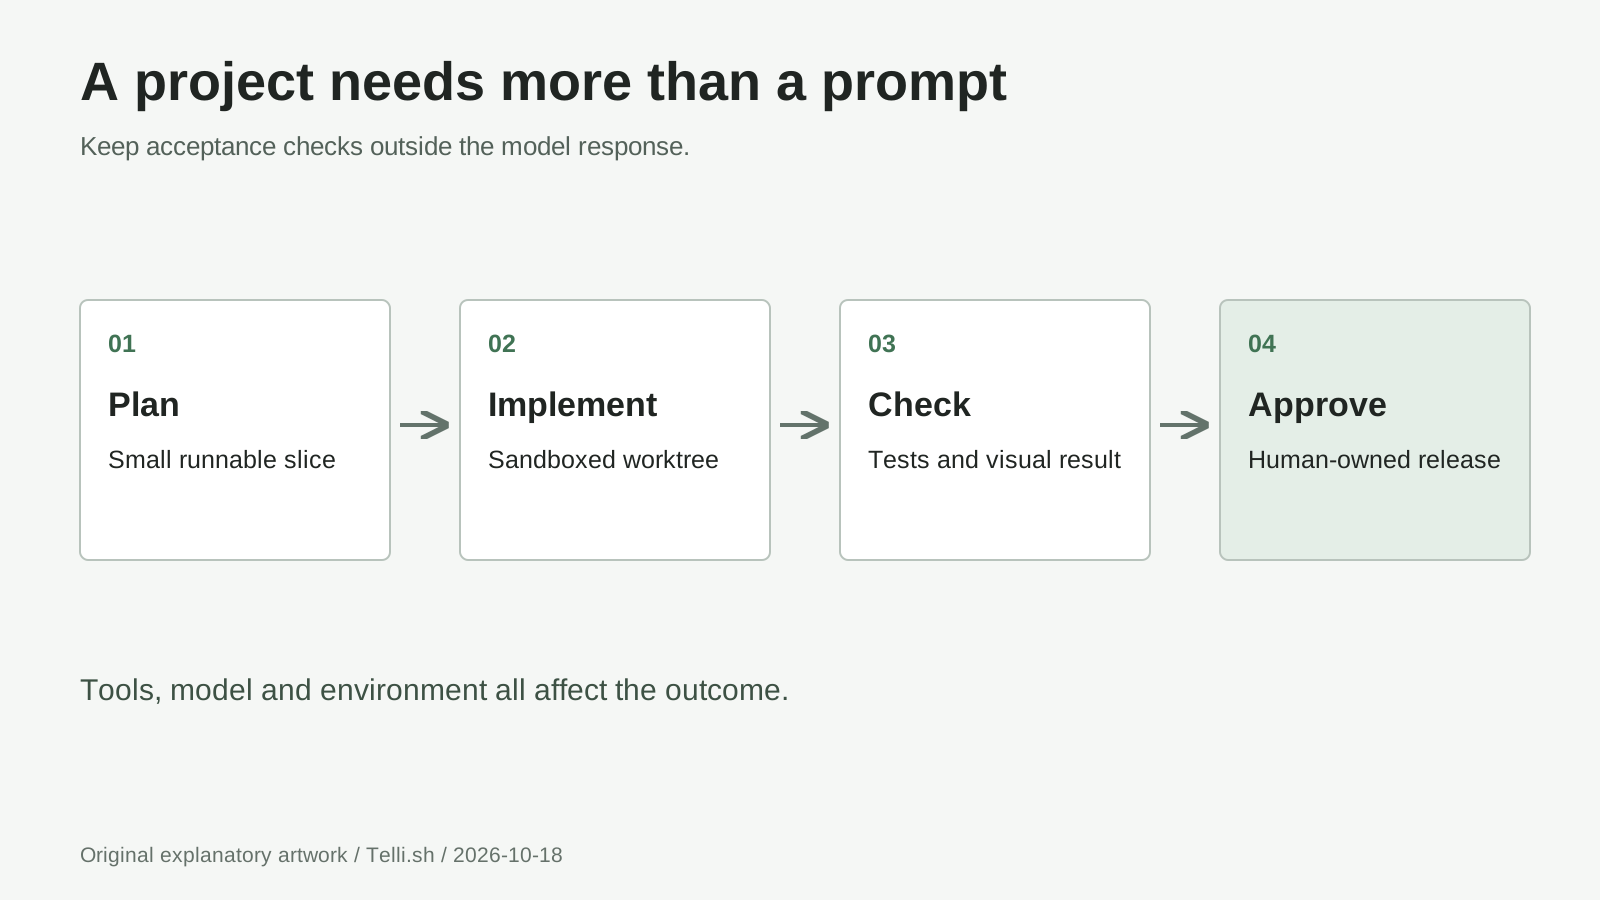
Diagramma originale: criteri di accettazione e approvazione del rilascio restano al di fuori della risposta del modello. Strumenti e ambiente di esecuzione determinano cosa si può davvero verificare.
Trasforma la lista di lettura in un progetto con un traguardo chiaro
Per una seconda iterazione, immagina una lista di lettura per un piccolo gruppo di studio. I membri devono aggiungere link, contrassegnare gli articoli come letti ed esportare la lista. Mantieni questa versione a utente singolo e basata sul browser; collaborazione e sincronizzazione sono progetti separati.
- Definisci il contratto. Richiedi titolo, URL e stato di lettura; rifiuta i link non validi; conserva le voci dopo il ricaricamento ed esporta un file JSON. Specifica cosa succede quando non ci sono voci, un titolo è lungo o un file importato è malformato. Escludi autenticazione e archiviazione server.
- Chiedi un piano prima delle modifiche. Fai indicare al modello i file necessari, la strategia di archiviazione e i test proposti. Fornisci una cartella pulita o un worktree isolato. Non cominciare dandogli la tua cartella home, credenziali di produzione o il permesso di installare software arbitrario.
- Implementa una fetta verticale per volta. Aggiungi un articolo, salvalo e ricarica. Poi aggiungi il filtro, seguito da esportazione e importazione. Ogni incremento deve restare eseguibile: così una funzione di esportazione rotta non si intreccia con una migrazione di archiviazione e un restyling non correlato.
- Fornisci prove come riscontro. Dai l'errore preciso, l'input e il comportamento atteso. Per un problema di layout, allega uno screenshot ritagliato e privo di informazioni private. Chiedi una correzione circoscritta e ripeti gli stessi controlli invece di accettare ogni volta una riscrittura completa.
- Approva una versione candidata al rilascio. Prova navigazione da tastiera, lista vuota, link duplicati e titolo lungo. Esporta, svuota la lista di prova, importa e verifica che i campi abbiano superato il ciclo. Conserva una copia funzionante prima di accettare un'altra revisione.
Il modello può aiutare a scrivere un piano di test prima dell'implementazione. Per esempio, chiedigli di descrivere la struttura JSON prevista e individuare i campi che l'importatore deve convalidare. Poi confronta l'implementazione con quel piano. In questo modo promessa e codice restano distinti, e i disaccordi diventano visibili.
Un harness di progetto fornisce attorno al modello modifica dei file, esecuzione di comandi e altri strumenti. Per la versione 1017 DeepSeek consiglia Harness v0.2.1-rc.1 o successivo nel proprio annuncio di rilascio. Segui la guida ufficiale di Harness per l'installazione, invece di presumere che una richiesta all'API chat crei un agente di coding.
Collega l'API senza mettere un segreto nella pagina web
Usa l'API quando un tuo programma ha bisogno di risposte del modello. La lista di lettura può restare un'applicazione browser locale; lo script seguente è un helper di sviluppo separato che gira nel terminale. Non inserire mai la chiave DeepSeek in index.html, JavaScript del browser o un repository pubblico.
1. Crea una chiave API e scegli un compito piccolo
Crea una chiave nella piattaforma API DeepSeek e controlla il saldo del tuo account. La guida alla prima chiamata documenta l'URL base compatibile con OpenAI https://api.deepseek.com e il modello deepseek-flash. Un account di chat web non rende illimitato l'uso API a pagamento.
Per la prima richiesta chiedi criteri di accettazione, non un intero repository. Così l'output resta facile da controllare e si limita la quantità generata in caso di configurazione errata.
2. Prepara Python sul tuo sistema operativo
Installa Python 3 se non è già presente. In una nuova cartella di progetto, crea un ambiente isolato e installa l'SDK. Questi comandi invocano direttamente il suo interprete, senza bisogno di attivare uno script né modificare i criteri di esecuzione di PowerShell. Seguono la documentazione Python degli ambienti virtuali.
Windows, PowerShell:
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install --upgrade openai
Se py non è disponibile ma python --version identifica l'installazione Python 3, usa python -m venv .venv come primo comando.
macOS, Terminale:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Linux, terminale:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Alcune distribuzioni Linux forniscono venv in un pacchetto separato. Se la creazione dell'ambiente segnala che manca, installa il pacchetto per ambienti virtuali documentato dalla tua distribuzione e riprova. Non risolvere un problema di ambiente isolato con sudo pip install a livello di sistema.
3. Crea un helper per il terminale
Crea accanto a .venv il file d'esempio first_request.py. Usa la richiesta nascosta della chiave attraverso il modulo Python getpass, invece di inserire il segreto nel sorgente o in un comando conservato nella cronologia della shell. Eseguilo in un terminale normale che supporti l'input nascosto.
from getpass import getpass

from openai import OpenAI

client = OpenAI(
    api_key=getpass("DeepSeek API key: "),
    base_url="https://api.deepseek.com",
    timeout=120.0,
    max_retries=0,
)

reply = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{
        "role": "user",
        "content": (
            "Propose five manual acceptance checks for a browser-only "
            "reading queue with filtering, read status and JSON export. "
            "Return checks only; do not claim to have executed them."
        ),
    }],
    max_tokens=2048,
    stream=False,
    extra_body={"thinking": {"type": "disabled"}},
)

print(reply.choices[0].message.content)
print("Finish reason:", reply.choices[0].finish_reason)
print("Usage:", reply.usage)
4. Esegui lo script ed esamina la risposta
Su Windows esegui \.venv\Scripts\python.exe first_request.py. Su macOS o Linux, ./.venv/bin/python first_request.py. Quando richiesto, inserisci la chiave: il risultato previsto è un elenco di controlli, un motivo di completamento e dati d'uso, non nuovi file di progetto.
Se la richiesta fallisce, prima di riprovare esamina il codice di stato. 401 riguarda l'autenticazione, 402 un saldo insufficiente e 429 un limite; DeepSeek documenta questi casi nella guida ai codici d'errore. Un motivo di completamento length indica che la risposta ha raggiunto un limite, quindi non dimostra che sia completa. Mentre impari l'API, gestisci i tentativi con attenzione.
Thinking, visione e strumenti web fanno lavori diversi
Il thinking è attivo per impostazione predefinita, con intensità high. Per una domanda di debug più impegnativa, sostituisci l'extra_body dell'esempio con {"thinking": {"type": "enabled"}} e aggiungi reasoning_effort="high". I livelli documentati sono low, high e max; la modalità thinking ignora temperature, quindi abbassarla non è una scorciatoia per ottenere ragionamenti più affidabili. Guida alla modalità thinking, verificata il 18 ottobre
Il thinking consuma anche il budget di generazione. Quando passi da risposte brevi senza thinking a ragionamenti complessi, aumenta intenzionalmente il limite dell'output. Se implementi chiamate a strumenti in modalità thinking, conserva reasoning_content dell'assistente nelle richieste successive che includono strumenti, come prescrive la guida. Non costruire la conversazione degli strumenti mantenendo soltanto la risposta finale visibile.
La visione accetta immagini insieme al testo; non è un endpoint di generazione d'immagini. In Chat Completions inserisci il contenuto immagine in un messaggio user usando un blocco image_url, un data URL base64 o il formato documentato della Files API. Sono supportati JPEG, PNG, GIF e WebP. Il limite del corpo della richiesta in linea è 48 MiB; ciascuna immagine in linea o collegata esternamente è limitata a 32 MiB. Guida alla visione
Per la lista di lettura, invia uno screenshot oscurato e chiedi quali etichette si sovrappongono a larghezza ridotta. Considera la risposta una diagnosi da verificare nel browser, non una prova che il layout sia stato corretto. La comprensione delle immagini non autorizza l'API a muovere il mouse o modificare file.
Search trova pagine; Fetch recupera una pagina in formato Markdown. Gli endpoint indipendenti sono POST /v1/tools/search e POST /v1/tools/fetch, autenticati con la stessa chiave bearer. Una richiesta Search può usare {"query":"browser storage documentation","count":3}; Fetch usa {"url":"https://developer.mozilla.org/en-US/docs/Web/API/Storage"}. L'applicazione deve chiamare esplicitamente questi endpoint o usare un'integrazione che li fornisca. Menzionare un URL in una semplice richiesta chat non equivale a questo flusso. Guida a Search e Fetch
Mantieni separato il contenuto recuperato dalle istruzioni. Una pagina acquisita è una prova, non l'autorità per eseguire un comando, divulgare una chiave o modificare un requisito del progetto. Fetch resta soggetto alle regole di accesso del sito di destinazione: non concede accesso a materiale privato o a pagamento.
Un grande modello di base può attivare meno parametri senza entrare in un laptop
La scheda del modello V4.1 di settembre descrive un backbone MoE da 552 miliardi di parametri, con circa 8 miliardi di parametri attivati per token di input durante il prefill e 16 miliardi per token di output durante la decodifica. Il Causal Encoder-Decoder separa un encoder causale di 20 livelli da un decoder di 20 livelli. Questi dettagli architetturali riguardano il rilascio V4.1 di base, non una nuova architettura annunciata il 17 ottobre. Architettura del modello base e collegamento al rapporto tecnico
In parole semplici, il prefill elabora il prompt già presente; la decodifica produce la risposta. Il routing Mixture-of-Experts seleziona esperti invece di attivare ogni parametro del backbone per ogni token. L'attenzione compressa e l'architettura della cache condivisa mirano a ridurre il costo di memoria dei prompt lunghi. I parametri attivi descrivono però il calcolo, non tutto lo spazio e la memoria necessari per ospitare il checkpoint.
Il contesto pubblicizzato è di un milione di token. È una capacità, non un invito a incollare l'intero repository in ogni richiesta, né una garanzia di richiamo perfetto. Parti dal compito, dai file pertinenti e dagli errori concreti; amplia il contesto quando lo richiede una dipendenza o un contratto mancante.
Per l'hosting autonomo, usa le istruzioni ufficiali d'inferenza 1017, che descrivono la conversione del checkpoint e l'esecuzione tensor-parallel. Il launcher vLLM generico della pagina Hugging Face non è una ricetta di distribuzione specifica per il modello. Prima di scaricare i pesi, verifica hardware, kernel supportati e compatibilità del servizio. deepseek-recipe gestisce conversione di prompt e protocollo; non fornisce inferenza né esegue strumenti. Chi usa un laptop comune dovrebbe partire dall'accesso ospitato.
Stima il costo del compito completo, non il token più economico
Al 18 ottobre 2026, DeepSeek indica questi prezzi Flash in dollari USA per un milione di token. Prezzi ufficiali
| Categoria token | Fascia di punta | Fuori punta |
|---|---|---|
| Input, cache miss | $0.30 | $0.15 |
| Input, cache hit | $0.006 | $0.003 |
| Output | $1.20 | $0.60 |
Le fasce di punta sono 01:00-04:00 e 06:00-10:00 UTC, dal lunedì al venerdì, esclusi i giorni festivi cinesi; tutti gli altri orari sono fuori punta. Nel fine settimana l'intera giornata rientra nella fascia fuori punta secondo questo calendario. Per pianificare usa UTC, invece di presumere che le ore diurne locali siano costose.
Per un compito illustrativo con 100.000 token di input cache miss, 200.000 token di input cache hit e 20.000 token di output, il calcolo di punta è:
(0.1 x $0.30) + (0.2 x $0.006) + (0.02 x $1.20)
= $0.0300 + $0.0012 + $0.0240
= $0.0552
Alle tariffe fuori punta, le stesse quantità ipotizzate costano $0.0276. È un calcolo aritmetico, non una fattura di progetto misurata. Usa l'effettivo utilizzo cache hit e miss invece di presumere che il contesto ripetuto riceva sempre la tariffa inferiore.
Search e Fetch costano ciascuno $0.75 per 1.000 richieste riuscite che producono risultati. Quindi 40 ricerche e 60 acquisizioni fatturabili aggiungono $0.075, esclusi i token del modello usati per leggere i risultati. Il periodo temporaneo gratuito si applica alle chiamate lato server tramite le integrazioni API DeepSeek nominate; la fatturazione inizia il 31 ottobre 2026 alle 16:00 UTC. Non è un periodo gratuito generalizzato per le chiamate dirette agli endpoint. Regole di fatturazione degli strumenti
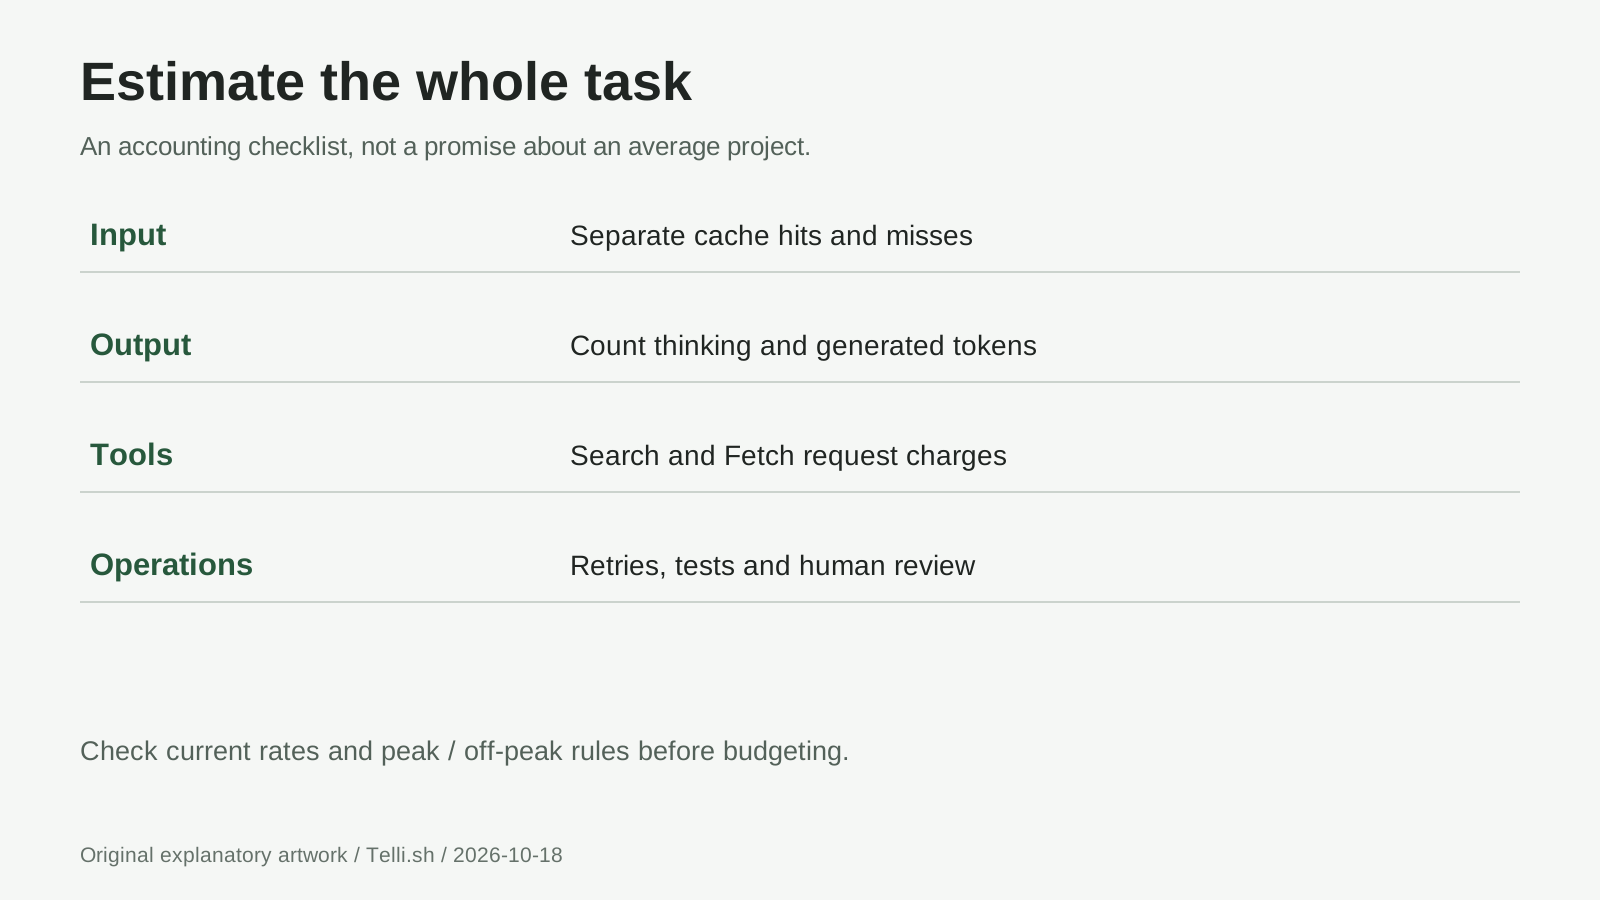
Diagramma contabile originale: nel budget includi output del thinking, tentativi, chiamate agli strumenti e revisione. Non implica un costo medio per progetto.
Leggi i miglioramenti dei benchmark insieme all'harness
DeepSeek riporta le seguenti differenze tra V4.1 Flash base e 1017. Sono punteggi dichiarati dal fornitore, non risultati indipendenti di questa guida. Confronto nella scheda 1017
| Benchmark | V4.1 Flash | 1017 | Variazione |
|---|---|---|---|
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 punti |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 punti |
| ProgramBench | 20.3 | 29.1 | +8.8 punti |
La scheda 1017 specifica Claude Code per Terminal-Bench 4.0 e Mini-SWE-V2 per DeepSWE v1.1. Un harness fornisce strumenti, gestione del contesto e policy di esecuzione; cambiandolo cambia l'esperimento. Non trattare la differenza di punteggio tra configurazioni diverse come una misura pura delle capacità del modello.
Per il tuo confronto, mantieni fissi repository, criteri di accettazione, permessi e budget. Registra se il progetto funziona, quante correzioni ha richiesto, uso totale e tempo trascorso. Un punteggio pubblico più alto aiuta a scegliere un candidato; a stabilire se merita il compito è una prova ripetibile nel tuo ambiente.
Domande da chiarire prima di assegnargli un compito più grande
1017 è un nome API separato per il modello?
No. Usa deepseek-flash. Il nome datato del checkpoint identifica l'aggiornamento, mentre l'API ospitata di DeepSeek mantiene l'identificativo esistente. Quando la riproducibilità conta, annota la data e le informazioni del modello restituite. Documentazione della prima chiamata
I pesi MIT rendono gratuita l'API?
No. La scheda del modello 1017 distribuisce repository e pesi con licenza MIT. L'uso ospitato ha costi distinti. La licenza dei pesi non concede neppure diritti su input privati, asset di terzi o contenuti multimediali delle demo.
Può creare un gioco completo con un solo prompt?
Considera le demo ufficiali esempi dei risultati dell'editore, non garanzie di consegna. Definisci movimento, collisioni, riavvio e condizione di completamento prima di chiedere rifiniture visive. Un gioco che puoi esaminare e rigiocare è una tappa migliore di una grande codebase generata.
Dovrei usare sempre il thinking massimo e tutto il contesto?
No. Comincia con una richiesta circoscritta e aumenta sforzo o contesto quando uno specifico problema lo richiede. Più ragionamento generato e prompt più ampi consumano risorse; nessuno dei due sostituisce i criteri di accettazione o permessi attenti sugli strumenti.
Posso pubblicare subito il lavoro generato?
Prima controlla funzionalità, sicurezza, licenze delle dipendenze e provenienza degli asset. Rimuovi le credenziali d'esempio e ispeziona eventuali richieste remote. L'approvazione della distribuzione deve restare distinta dal permesso di modificare un progetto locale.
In sintesi: finito significa che qualcuno ha verificato il risultato
La promessa utile di 1017 è un completamento dei progetti più efficace, non un motivo per smettere di revisionarli. Assegna al modello un obiettivo piccolo, un ambiente delimitato e controlli osservabili. Poi amplia il progetto soltanto dopo aver approvato il comportamento corrente.
Fonti
Documentazione e prezzi verificati il 18 ottobre 2026. Le affermazioni sui benchmark e sull'addestramento sono attribuite a DeepSeek; gli esercizi sono esempi didattici, non risultati dichiarati di prove pratiche. Tutti e tre i diagrammi sono illustrazioni esplicative originali. I contenuti multimediali demo del fornitore sono collegati, non riprodotti.
- Aggiornamento del 17 ottobre e dimostrazioni di progetto
- Rilascio base del 10 settembre
- Registro aggiornamenti datato
- Scheda modello 1017, benchmark e licenza MIT
- Architettura V4.1 di base e rapporto tecnico
- Prima chiamata API, thinking, visione, Search e Fetch e prezzi
- Riferimento ufficiale d'inferenza e deepseek-recipe
Semplifica la ripresa del prossimo progetto
Consiglio Telli.sh: conserva insieme link alle fonti, brief del progetto, prompt e note di revisione, così la sessione successiva riparte dalle decisioni e non dalle ipotesi. Telli.sh può organizzare le conoscenze sul progetto; non è un'integrazione per agenti di coding DeepSeek. Crea un account Telli.sh