DeepSeek V4.1 Flash 1017 : créez votre premier projet, puis connectez l’API
Lancez un projet fonctionnel dans le navigateur, connectez DeepSeek Flash sous Windows, Mac ou Linux et comprenez la mise à jour du 17 octobre, le mode réflexion, la vision, les coûts et les limites.
Un modèle de programmation devient utile quand ce qu’il écrit fonctionne vraiment. Commencez par là : une petite application que vous pouvez ouvrir, examiner et améliorer, plutôt qu’un immense prompt lui demandant de créer toute une entreprise.
DeepSeek a lancé V4.1 Flash le 10 septembre 2026 ; la mise à jour 1017 est arrivée le 17 octobre, et non la première version V4.1. La mise à jour est disponible sur le site, dans l’application et dans l’API de DeepSeek, et l’identifiant du modèle API reste deepseek-flash. Journal des mises à jour daté de DeepSeek
Ce guide vous fait passer d’un premier projet dans le navigateur à un workflow de développement reproductible, puis à la configuration de l’API sous Windows, macOS et Linux. Nous examinerons ensuite l’architecture, les benchmarks du fournisseur, le coût des jetons et les limites pratiques à connaître avant de confier une tâche plus importante à un agent.
Visuel d’ouverture : illustration explicative originale montrant la spécification, la réalisation, l’inspection et la révision. Elle illustre un workflow, pas une capture d’écran d’un produit DeepSeek.
Obtenez un premier résultat concluant avant toute installation
Ouvrez le chat Web de DeepSeek ou son application officielle et démarrez une nouvelle conversation. Pour ce premier exercice, utilisez des informations fictives. Un service d’IA public n’est pas l’endroit où découvrir que votre fichier d’exemple contient une liste de clients ou un jeton d’accès.
Notre premier projet est une liste de lecture : une petite page qui regroupe les articles que vous souhaitez lire. Elle ne nécessite ni compte, ni base de données dans le cloud, ni clé API. L’exercice suivant est illustratif ; il ne rapporte pas une exécution réelle du modèle.
-
Demandez le plus petit livrable complet avec ce prompt :
Texte brutBuild a reading queue as one self-contained index.html file. Use plain HTML, CSS and JavaScript, with no libraries or network calls. Include three fictional example articles, a title filter, and a read/unread toggle. Keep state in memory; reloading should reset it. Use accessible labels and make the layout work at 360px wide. Return the complete file, followed by five manual acceptance checks. Do not add login, analytics, remote fonts or a backend. -
Placez le fichier généré dans un nouveau dossier vide et ouvrez
index.htmldans un navigateur. Avant d’ouvrir du code généré que vous ne connaissez pas, vérifiez qu’il ne contient pas de requêtes réseau ni de scripts inattendus. Cet exercice ne devrait nécessiter ni commande de terminal, ni dépendance téléchargée, ni demande d’autorisation. -
Vérifiez vous-même le comportement : filtrez à partir d’un fragment de titre, changez l’état de lecture d’un article, retirez le filtre, réduisez la largeur de la fenêtre et rechargez la page. Le changement d’état doit survivre au filtrage, mais être réinitialisé au rechargement puisque c’est le périmètre demandé.
-
Signalez un problème concret : « Le filtre masque toutes les lignes quand la requête contient des espaces à la fin. Supprime ces espaces, préserve le reste du comportement et renvoie le fichier révisé. » Relancez les mêmes vérifications.
C’est un premier résultat dont vous pouvez reconnaître la réussite. « Ça a l’air bien » est subjectif ; « le changement d’état fonctionne toujours après le filtrage » est un critère d’acceptation. Garder le premier projet volontairement petit aide aussi à déterminer si une révision a vraiment corrigé le problème ou n’a fait que changer l’apparence.
La mise à jour d’octobre vise à terminer des projets, pas seulement à écrire des extraits
DeepSeek indique que 1017 utilise l’apprentissage par renforcement avec auto-rétroaction pour améliorer le développement de projets de bout en bout. Son annonce présente quatre exemples : une modélisation 3D de la Cité interdite, un jeu de course sur le Web, une reconstitution dans Godot inspirée de Portal 2 et Valley of Ages, une scène 3D qui traverse plusieurs périodes historiques. Consultez les démonstrations officielles de projets pour examiner ces exemples ; ce sont des démonstrations du fournisseur, pas des résultats garantis pour un prompt donné.
Voici la distinction essentielle : l’entraînement par auto-rétroaction est une affirmation sur le développement du modèle, tandis que la rétroaction sur votre projet provient de l’exécution du logiciel. Une réponse du chat n’exécute pas votre navigateur, n’inspecte pas votre dépôt et ne vérifie pas la compilation d’un jeu au seul motif que le modèle a appris grâce à de la rétroaction pendant son entraînement. Ces opérations nécessitent un environnement et des outils.
Voyez ce processus comme une boucle de projet : spécifier, implémenter, vérifier, réviser. À notre avis, cette boucle compte davantage que la taille de la première réponse générée. Une modification modeste qui satisfait un critère d’acceptation est plus utile qu’un dépôt impressionnant que personne n’a lancé.
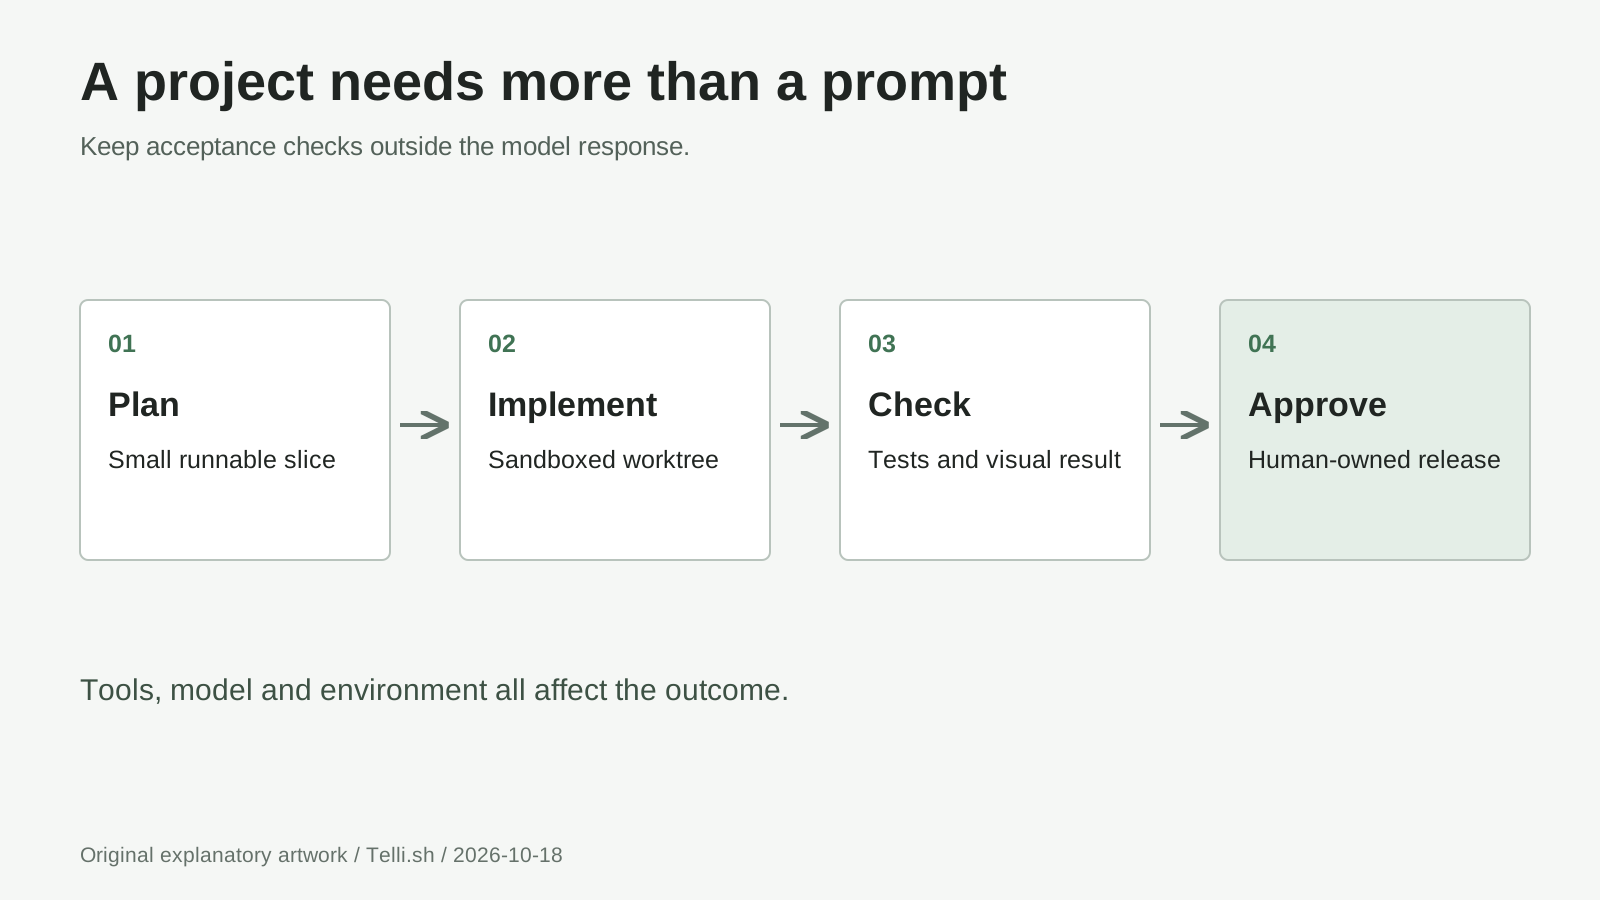
Schéma original : les critères d’acceptation et l’approbation de mise en production ne font pas partie de la réponse du modèle. Les outils et l’environnement d’exécution déterminent ce qui peut réellement être vérifié.
Donnez un objectif final à votre liste de lecture
Pour une deuxième itération, imaginez une liste de lecture destinée à un petit groupe d’étude. Les membres doivent pouvoir ajouter des liens, marquer les articles comme lus et exporter la liste. Gardez cette version limitée à un seul utilisateur et au navigateur ; la collaboration et la synchronisation sont des projets distincts.
-
Définissez le contrat. Exigez un titre, une URL et un état de lecture ; rejetez les liens invalides ; conservez les entrées après rechargement ; exportez un fichier JSON. Précisez ce qui doit se passer si la liste est vide, si un titre est long ou si un fichier importé est mal formé. Laissez de côté l’authentification et le stockage serveur.
-
Demandez un plan avant les modifications. Demandez au modèle d’identifier les fichiers nécessaires, la méthode de stockage et les tests qu’il propose. Fournissez-lui un dossier propre ou un worktree isolé. Ne commencez pas par lui donner accès à votre répertoire personnel, à des identifiants de production ou à l’installation de logiciels quelconques.
-
Implémentez une tranche fonctionnelle à la fois. Ajoutez un article, enregistrez-le, puis rechargez la page. Ajoutez ensuite le filtrage, puis l’export et l’import. Chaque étape doit rester exécutable afin qu’un export défectueux ne se retrouve pas mêlé à une migration de stockage et à une refonte sans rapport.
-
Fournissez des éléments de preuve. Donnez l’erreur exacte, l’entrée et le comportement attendu. Pour un problème de mise en page, joignez une capture recadrée dont les informations privées ont été retirées. Demandez un correctif ciblé et répétez les mêmes vérifications au lieu d’accepter une réécriture complète à chaque fois.
-
Approuvez une version candidate. Testez la navigation au clavier, une liste vide, des liens en double et un titre long. Exportez la liste, videz la liste de test, importez-la et confirmez que les champs ont survécu à l’aller-retour. Conservez une copie dont le bon fonctionnement est établi avant d’accepter une nouvelle révision.
Le modèle peut également aider à rédiger un plan de test avant l’implémentation. Demandez-lui, par exemple, de décrire la structure JSON attendue et de préciser les champs que l’importateur doit valider. Comparez ensuite l’implémentation à ce plan. Cela distingue la promesse du code et rend les désaccords visibles.
Un harness de projet fournit au modèle des outils d’édition de fichiers, d’exécution de commandes et d’autres capacités. Dans son annonce de version, DeepSeek recommande Harness v0.2.1-rc.1 ou une version ultérieure pour 1017. Suivez le guide officiel de Harness pour l’installation ; ne supposez pas qu’une requête à l’API de chat suffit à créer un agent de programmation.
Connectez l’API sans exposer de secret dans votre page Web
Utilisez l’API lorsque votre propre programme a besoin de réponses du modèle. La liste de lecture peut rester une application locale dans le navigateur ; le script suivant est un outil distinct qui s’exécute dans le terminal. N’intégrez jamais votre clé DeepSeek dans index.html, du JavaScript côté navigateur ou un dépôt public.
1. Créez une clé API et choisissez une petite tâche
Créez une clé sur la plateforme API de DeepSeek et vérifiez le solde de votre compte. Le guide DeepSeek du premier appel indique l’URL de base compatible avec OpenAI, https://api.deepseek.com, et le modèle deepseek-flash. Un compte de chat Web ne rend pas illimitée l’utilisation payante de l’API.
Pour la première requête, demandez des critères d’acceptation plutôt que tout un dépôt. Le résultat sera plus facile à examiner et vous limiterez le contenu généré si la configuration est incorrecte.
2. Préparez Python sur votre système d’exploitation
Installez Python 3 si ce n’est pas déjà fait. Dans un nouveau dossier de projet, créez un environnement isolé et installez le SDK. Ces commandes appellent directement son interpréteur ; aucun script d’activation ni changement de la stratégie d’exécution de PowerShell n’est donc nécessaire. La procédure suit la documentation Python sur les environnements virtuels.
Windows, PowerShell :
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install --upgrade openai
Si py n’est pas disponible mais que python --version identifie votre installation Python 3, utilisez python -m venv .venv pour la première commande.
macOS, Terminal :
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Linux, terminal :
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Certaines distributions Linux fournissent venv dans un paquet séparé. Si la création de l’environnement indique qu’il manque, installez le paquet d’environnement virtuel Python documenté par votre distribution, puis recommencez. Ne résolvez pas un problème d’environnement isolé par une commande sudo pip install à l’échelle du système.
3. Créez un outil auxiliaire à lancer dans le terminal
Créez first_request.py à côté de .venv à partir de l’exemple suivant. Il demande la clé sans l’afficher à l’aide du module getpass de Python, au lieu d’inscrire le secret dans le code source ou dans une commande conservée par l’historique du shell. Lancez-le dans un terminal classique qui prend en charge la saisie masquée.
from getpass import getpass

from openai import OpenAI

client = OpenAI(
    api_key=getpass("DeepSeek API key: "),
    base_url="https://api.deepseek.com",
    timeout=120.0,
    max_retries=0,
)

reply = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{
        "role": "user",
        "content": (
            "Propose five manual acceptance checks for a browser-only "
            "reading queue with filtering, read status and JSON export. "
            "Return checks only; do not claim to have executed them."
        ),
    }],
    max_tokens=2048,
    stream=False,
    extra_body={"thinking": {"type": "disabled"}},
)

print(reply.choices[0].message.content)
print("Finish reason:", reply.choices[0].finish_reason)
print("Usage:", reply.usage)
4. Lancez-le et examinez la réponse
Sous Windows, lancez .\.venv\Scripts\python.exe first_request.py. Sous macOS ou Linux, lancez ./.venv/bin/python first_request.py. Saisissez votre clé à l’invite ; le résultat attendu est une liste de vérifications, une raison d’arrêt et des informations d’utilisation, et non de nouveaux fichiers de projet.
Si la requête échoue, examinez le statut avant de réessayer. 401 concerne l’authentification, 402 un solde insuffisant et 429 une limite ; DeepSeek les décrit dans son guide des codes d’erreur. Une raison d’arrêt length signifie que la réponse a atteint une limite ; elle ne prouve donc pas que la réponse soit complète. Pendant la découverte de l’API, ne relancez les requêtes qu’à bon escient.
La réflexion, la vision et les outils Web ont des rôles différents
Le mode réflexion est activé par défaut avec un effort high. Pour une question de débogage plus difficile, remplacez le extra_body de l’exemple par {"thinking": {"type": "enabled"}} et ajoutez reasoning_effort="high". Les niveaux d’effort documentés sont low, high et max ; le mode réflexion ignore temperature, dont la réduction ne constitue donc pas un raccourci vers un raisonnement plus fiable. Guide du mode réflexion, consulté le 18 octobre
Le mode réflexion consomme lui aussi le budget de génération. Augmentez délibérément une petite limite de sortie lorsque vous passez de réponses courtes sans réflexion à un raisonnement complexe. Si vous implémentez des appels d’outils en mode réflexion, conservez le reasoning_content de l’assistant dans les requêtes ultérieures qui transportent des outils, comme l’exige le guide. Ne construisez pas la conversation avec les outils en ne gardant que la réponse finale visible.
La vision accepte des images avec du texte ; ce n’est pas un endpoint de génération d’images. Dans Chat Completions, placez le contenu image dans un message user, sous forme de bloc image_url, d’URL de données base64 ou selon le format documenté de l’API Files. Les formats JPEG, PNG, GIF et WebP sont pris en charge. La limite du corps de requête envoyé en ligne est de 48 Mio, et chaque image intégrée ou liée extérieurement est limitée à 32 Mio. Guide de la vision
Pour la liste de lecture, envoyez une capture expurgée et demandez quelles étiquettes se chevauchent à faible largeur. Vérifiez ce diagnostic dans le navigateur : il ne prouve pas que la mise en page est corrigée. La compréhension des images ne donne pas non plus à l’API l’autorisation de déplacer votre souris ou de modifier des fichiers.
Search trouve des pages ; Fetch récupère une page au format Markdown. Leurs endpoints autonomes sont POST /v1/tools/search et POST /v1/tools/fetch, authentifiés avec la même clé Bearer. Une requête Search peut utiliser {"query":"browser storage documentation","count":3} ; Fetch utilise {"url":"https://developer.mozilla.org/en-US/docs/Web/API/Storage"}. Votre application doit appeler explicitement ces endpoints ou utiliser une intégration qui les fournit. Mentionner simplement une URL dans une requête de chat standard ne correspond pas au même workflow. Guide Search et Fetch
Séparez le contenu récupéré des instructions. Une page récupérée est un élément de preuve, pas une autorisation d’exécuter une commande, de divulguer une clé ou de modifier une exigence du projet. Fetch reste également soumis aux règles d’accès du site visé ; il ne donne pas accès aux contenus privés ou payants.
Un grand modèle peut n’activer qu’une partie de ses paramètres sans pour autant tenir sur un portable
La fiche du modèle V4.1 de septembre décrit un modèle MoE de 552 milliards de paramètres, qui en active environ 8 milliards par jeton d’entrée pendant le préremplissage et 16 milliards par jeton de sortie pendant le décodage. Son architecture Causal Encoder-Decoder sépare un encodeur causal de 20 couches d’un décodeur de 20 couches. Ces détails architecturaux concernent la version de base V4.1, et non une nouvelle architecture annoncée le 17 octobre. Architecture du modèle de base et lien vers le rapport technique
En termes simples, le préremplissage traite votre prompt existant ; le décodage produit la réponse. Le routage Mixture-of-Experts fait appel à certains experts au lieu d’activer tous les paramètres du modèle pour chaque jeton. L’attention compressée et le cache partagé du modèle visent à réduire le coût mémoire des prompts longs. Le nombre inférieur de paramètres actifs décrit toutefois le calcul, pas l’espace de stockage ni toute la mémoire nécessaires pour héberger le checkpoint.
La taille de contexte annoncée est de un million de jetons. C’est une capacité, pas une invitation à coller tout un dépôt dans chaque requête ni une garantie de mémorisation parfaite. Commencez par décrire la tâche, les fichiers pertinents et les erreurs concrètes ; élargissez le contexte lorsqu’une dépendance manquante ou un contrat le justifie.
Pour l’auto-hébergement, utilisez les instructions officielles d’inférence 1017, qui décrivent la conversion du checkpoint et l’exécution en parallèle sur plusieurs tenseurs. Le lanceur vLLM générique de la page Hugging Face n’est pas une recette de déploiement propre à ce modèle. Avant de télécharger les poids, vérifiez le matériel, les noyaux pris en charge et la compatibilité du service d’inférence. deepseek-recipe gère la conversion des prompts et des protocoles ; il ne fournit pas l’inférence et n’exécute pas d’outils. Les personnes qui utilisent un portable ordinaire devraient commencer par l’accès hébergé.
Estimez le coût de toute la tâche, pas celui du jeton le moins cher
Au 18 octobre 2026, DeepSeek affiche les tarifs Flash suivants en dollars américains pour un million de jetons. Tarifs officiels
| Catégorie de jetons | Heures de pointe | Heures creuses |
|---|---|---|
| Entrée, défaut de cache | 0,30 $ | 0,15 $ |
| Entrée, succès du cache | 0,006 $ | 0,003 $ |
| Sortie | 1,20 $ | 0,60 $ |
Les heures de pointe sont de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi, hors jours fériés chinois ; toutes les autres périodes sont des heures creuses. Selon ce calendrier, les week-ends sont entièrement en heures creuses. Utilisez l’UTC pour planifier vos requêtes au lieu de supposer que la journée est chère dans votre fuseau horaire.
Pour une tâche illustrative comprenant 100 000 jetons d’entrée sans succès du cache, 200 000 jetons d’entrée avec succès du cache et 20 000 jetons de sortie, le calcul au tarif de pointe est :
(0.1 x $0.30) + (0.2 x $0.006) + (0.02 x $1.20)
= $0.0300 + $0.0012 + $0.0240
= $0.0552
Aux tarifs des heures creuses, ces quantités hypothétiques coûtent 0,0276 $. Il s’agit d’un calcul, pas d’une facture de projet mesurée. Utilisez les volumes réels d’entrées avec ou sans succès du cache ; ne supposez pas que tout contexte répété bénéficie systématiquement du tarif inférieur.
Search et Fetch coûtent chacun 0,75 $ pour 1 000 requêtes réussies produisant un résultat. Ainsi, 40 recherches et 60 récupérations facturables ajoutent 0,075 $, sans compter les jetons du modèle utilisés pour lire les résultats. La période temporaire de gratuité s’applique aux appels côté serveur via les intégrations API DeepSeek nommées ; leur facturation commence le 31 octobre 2026 à 16:00 UTC. Elle ne signifie pas que l’accès direct aux endpoints est gratuit. Règles de facturation des outils
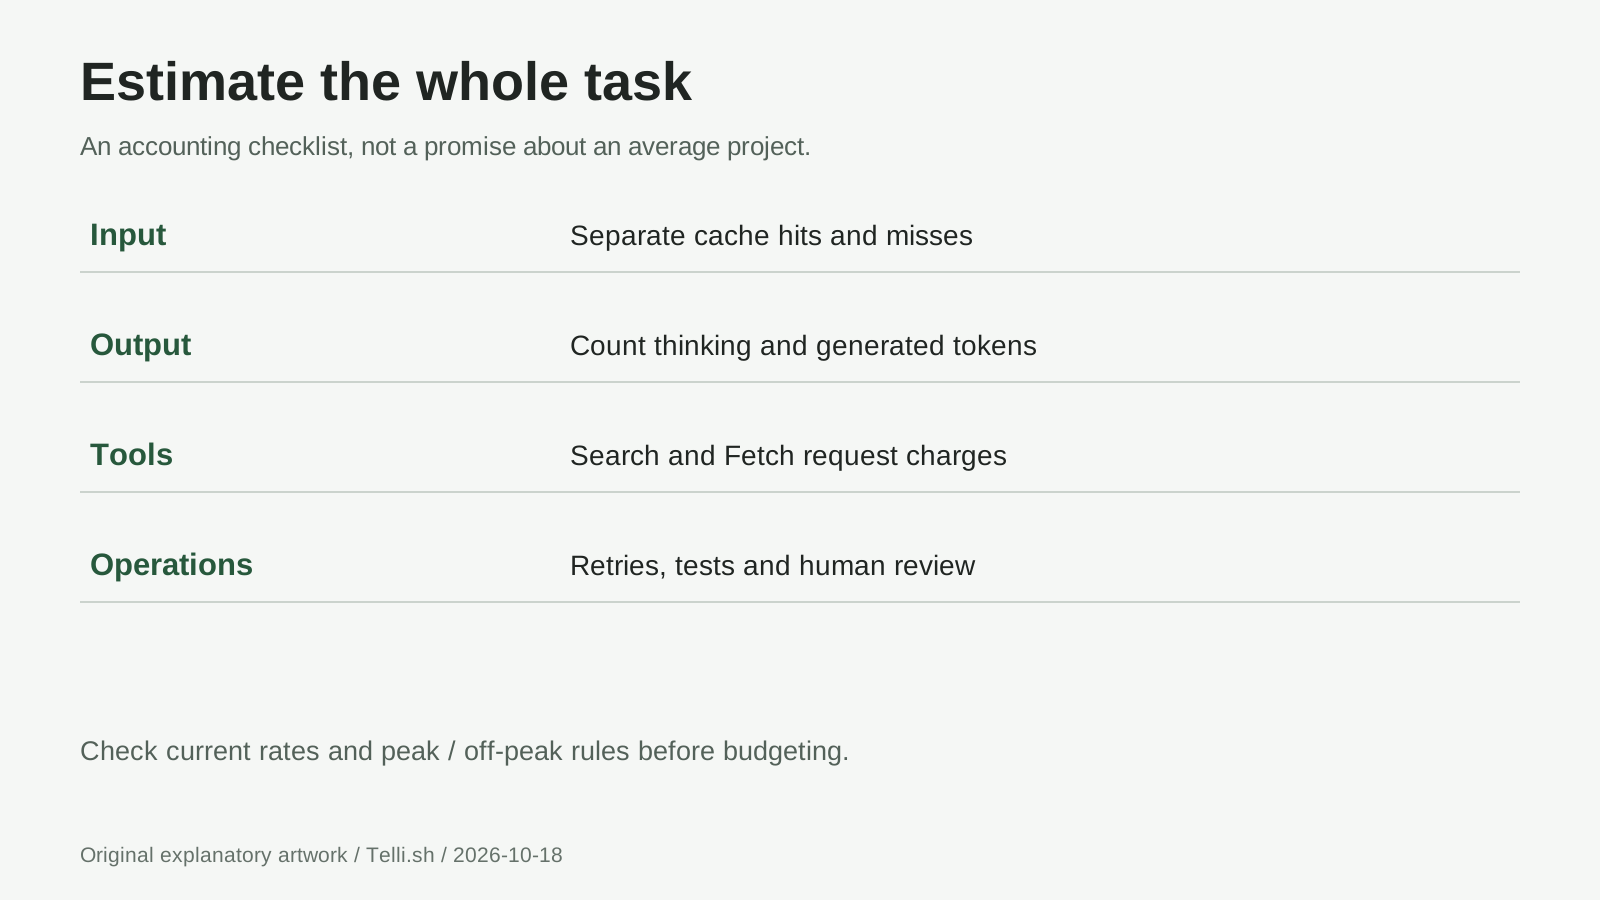
Schéma comptable original : incluez les sorties du mode réflexion, les nouvelles tentatives, les appels d’outils et le travail de révision dans votre budget. Aucun coût moyen de projet n’est avancé.
Interprétez les gains aux benchmarks avec le harness utilisé
DeepSeek rapporte les évolutions suivantes entre V4.1 Flash et 1017. Ce sont des scores rapportés par le fournisseur, pas des résultats indépendants obtenus pour ce guide. Comparaison de la fiche modèle 1017
| Benchmark | V4.1 Flash | 1017 | Évolution |
|---|---|---|---|
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 points |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 points |
| ProgramBench | 20.3 | 29.1 | +8.8 points |
La fiche 1017 précise que Terminal-Bench 4.0 utilise Claude Code et DeepSWE v1.1, Mini-SWE-V2. Un harness fournit les outils, la gestion du contexte et les règles d’exécution ; le modifier revient à modifier l’expérience. N’interprétez pas un écart de score entre deux configurations comme une mesure pure des capacités du modèle.
Pour effectuer votre propre comparaison, gardez le dépôt, les critères d’acceptation, les autorisations et le budget identiques. Notez si le projet fonctionne, le nombre de corrections nécessaires, l’utilisation totale et le temps écoulé. Un meilleur score public peut aider à choisir un candidat ; une tâche reproductible dans votre environnement déterminera s’il mérite le travail.
Questions à trancher avant de lui confier une tâche plus importante
1017 a-t-il un nom de modèle API distinct ?
Non. Utilisez deepseek-flash. Le nom daté du checkpoint désigne la mise à jour, tandis que l’API hébergée de DeepSeek conserve l’identifiant existant. Si la reproductibilité compte, notez la date et les informations de modèle renvoyées. Documentation du premier appel
La licence MIT des poids rend-elle l’API gratuite ?
Non. La fiche modèle 1017 place le dépôt et les poids sous licence MIT. L’utilisation du service hébergé est facturée séparément. Cette licence ne vous accorde pas non plus de droits sur des données privées, des ressources tierces ou les médias d’une démonstration.
Peut-il créer un jeu complet à partir d’un seul prompt ?
Considérez les démonstrations officielles comme des exemples de résultats du fournisseur, et non comme une garantie de livraison. Définissez les déplacements, les collisions, le redémarrage et la condition de fin avant de demander des finitions visuelles. Un jeu que vous pouvez examiner et relancer constitue un meilleur jalon qu’un vaste dépôt de code généré.
Faut-il toujours activer le niveau de réflexion maximal et utiliser tout le contexte ?
Non. Commencez par une demande délimitée et augmentez l’effort de réflexion ou le contexte lorsqu’un problème précis le justifie. Un raisonnement généré plus long et des prompts plus volumineux consomment des ressources ; aucun des deux ne remplace les critères d’acceptation ni une gestion prudente des autorisations d’outils.
Puis-je publier immédiatement le travail généré ?
Vérifiez d’abord le fonctionnement, la sécurité, les licences des dépendances et la provenance des ressources. Supprimez les identifiants d’exemple et examinez les requêtes distantes. Distinguez l’autorisation de déployer de celle de modifier un projet local.
En bref : terminer, c’est faire vérifier le résultat
La promesse intéressante de 1017 est une meilleure capacité à mener les projets à terme, pas une raison d’arrêter de les examiner. Donnez au modèle un objectif modeste, un environnement délimité et des vérifications observables. N’élargissez le projet qu’une fois son comportement actuel validé.
Sources
Documentation produit et tarifs vérifiés le 18 octobre 2026. Les affirmations concernant les benchmarks et l’entraînement sont attribuées à DeepSeek ; les exercices sont des exemples pédagogiques et ne prétendent pas rapporter des essais pratiques. Les trois schémas sont des illustrations explicatives originales. Les médias des démonstrations du fournisseur sont référencés par des liens, et non reproduits.
- Mise à jour du 17 octobre et démonstrations de projets
- Version de base du 10 septembre
- Journal des mises à jour daté
- Fiche modèle 1017, benchmarks et licence MIT
- Architecture V4.1 de base et rapport technique
- Premier appel API, mode réflexion, vision, Search et Fetch et tarifs
- Référence officielle d’inférence et deepseek-recipe
Reprenez plus facilement votre prochain projet
Recommandation Telli.sh : rassemblez les liens vers vos sources, le brief du projet, les prompts et les notes de révision afin que la prochaine session commence avec des décisions établies plutôt qu’avec des suppositions. Telli.sh peut organiser ces connaissances de projet ; ce n’est pas une intégration d’agent de programmation DeepSeek. Créer un compte Telli.sh