DeepSeek V4.1 Flash 1017: crea tu primer proyecto y después conecta la API
Empieza con un proyecto funcional en el navegador, conecta DeepSeek Flash desde Windows, Mac o Linux y entiende la actualización del 17 de octubre, el modo de razonamiento, la visión, los costes y los límites.
Un modelo de programación resulta útil cuando lo que escribe funciona de verdad. Empieza por ahí: crea una aplicación pequeña que puedas abrir, inspeccionar y mejorar, en vez de lanzar una instrucción gigantesca para construir todo un negocio.
DeepSeek publicó V4.1 Flash el 10 de septiembre de 2026; la actualización 1017 llegó el 17 de octubre, no fue el primer lanzamiento de V4.1. La actualización ya está disponible en el sitio web, la aplicación y la API de DeepSeek, y el identificador del modelo en la API sigue siendo deepseek-flash. Registro de actualizaciones fechado de DeepSeek
Esta guía te acompaña desde un primer proyecto en el navegador hasta un flujo de desarrollo repetible, y después muestra cómo configurar la API en Windows, macOS y Linux. Por último, analizaremos la arquitectura, los benchmarks del proveedor, el coste de los tokens y los límites prácticos que conviene tener presentes antes de encomendarle una tarea mayor a un agente.
Imagen principal: ilustración explicativa original con las fases de especificar, construir, inspeccionar y revisar. Representa un flujo de trabajo, no una captura de un producto DeepSeek.
Consigue un primer resultado antes de instalar nada
Abre el chat web de DeepSeek o su aplicación oficial e inicia una conversación nueva. Para este primer ejercicio, usa información inventada. Un servicio público de IA no es el lugar para descubrir que tu archivo de muestra contiene una lista de clientes o un token de acceso.
Nuestro primer proyecto será una cola de lectura: una página pequeña con artículos que quieres leer. No necesita cuenta, base de datos en la nube ni clave de API. Lo siguiente es un ejercicio ilustrativo, no el informe de una ejecución completada del modelo.
-
Pide el artefacto completo más pequeño con esta instrucción:
Texto sin formatoBuild a reading queue as one self-contained index.html file. Use plain HTML, CSS and JavaScript, with no libraries or network calls. Include three fictional example articles, a title filter, and a read/unread toggle. Keep state in memory; reloading should reset it. Use accessible labels and make the layout work at 360px wide. Return the complete file, followed by five manual acceptance checks. Do not add login, analytics, remote fonts or a backend. -
Guarda el archivo generado en una carpeta nueva y vacía, y abre
index.htmlen un navegador. Antes de abrir código desconocido que haya generado el modelo, inspecciónalo por si contiene solicitudes de red o scripts inesperados. Este ejercicio no debería requerir comandos de terminal, dependencias descargadas ni avisos de permisos. -
Comprueba tú mismo el comportamiento: filtra por un fragmento del título, marca un artículo, elimina el filtro, estrecha la ventana y vuelve a cargar la página. La marca debería mantenerse al filtrar y reiniciarse al recargar, porque ese era el alcance solicitado.
-
Comunica un fallo concreto: «El filtro oculta todas las filas si la búsqueda termina con espacios. Elimina esos espacios, conserva el resto del comportamiento y devuelve el archivo revisado». Repite las mismas comprobaciones.
Ese es un primer éxito reconocible. «Tiene buena pinta» es subjetivo; «la marca sigue funcionando después de filtrar» es un criterio de aceptación. Además, mantener pequeño el primer proyecto facilita saber si una revisión resolvió el problema o solo cambió su aspecto.
La actualización de octubre trata de completar proyectos, no solo de escribir fragmentos
DeepSeek afirma que la versión 1017 utiliza aprendizaje por refuerzo con autoevaluación para mejorar el desarrollo de proyectos de principio a fin. En su anuncio presenta cuatro ejemplos: modelado 3D de la Ciudad Prohibida, un juego de carreras web, una recreación en Godot inspirada en Portal 2 y Valley of Ages, una escena 3D que abarca distintas épocas históricas. Sigue las demostraciones oficiales de proyectos para examinar esos ejemplos: son demostraciones del proveedor, no resultados garantizados para cualquier instrucción.
Esta distinción es importante: el autoaprendizaje es una afirmación sobre el desarrollo del modelo; la respuesta de tu proyecto depende de ejecutar el software. Que el modelo haya aprendido mediante retroalimentación durante su entrenamiento no significa que una respuesta del chat ejecute tu navegador, inspeccione el repositorio o compruebe que el juego se compila. Para ello hacen falta un entorno y herramientas.
Piensa en el proceso como un ciclo de proyecto: especificar, implementar, comprobar y revisar. Nuestra conclusión es que ese ciclo importa más que el tamaño de la primera respuesta generada. Un cambio acotado que supera la prueba de aceptación sirve más que un repositorio impresionante que nadie ha puesto en marcha.
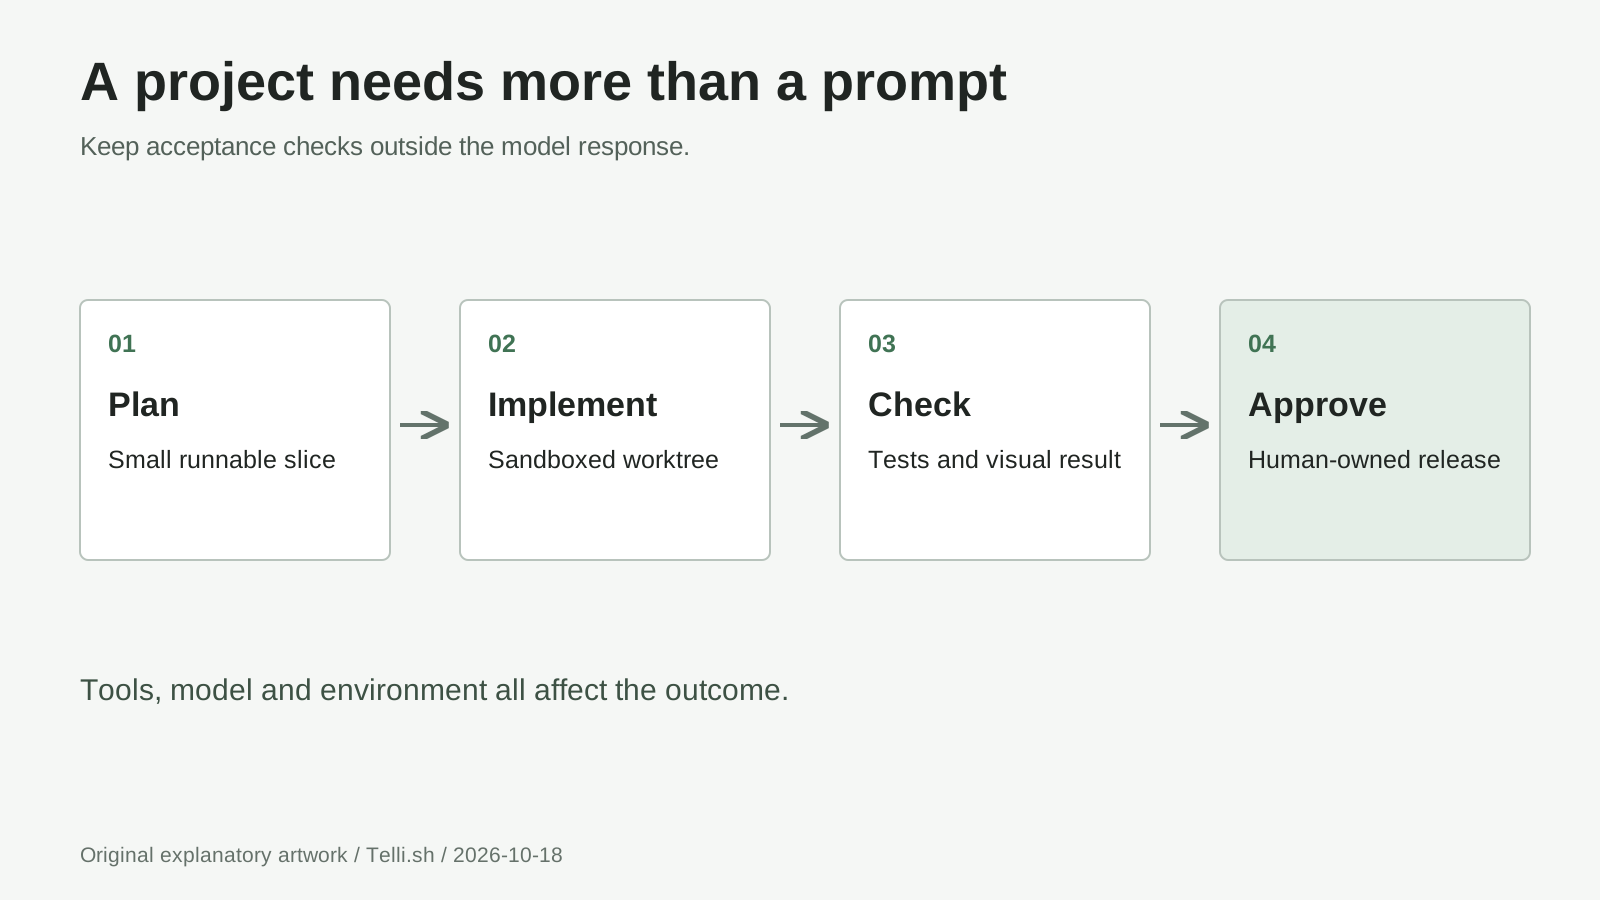
Diagrama original: las pruebas de aceptación y la aprobación de publicación quedan fuera de la respuesta del modelo. Las herramientas y el entorno de ejecución determinan qué se puede verificar realmente.
Convierte la cola de lectura en un proyecto con un objetivo final claro
Para una segunda iteración, imagina una cola de lectura para un pequeño grupo de estudio. Sus miembros necesitan añadir enlaces, marcar artículos como leídos y exportar la cola. Mantén esta versión para una sola persona y solo en el navegador; la colaboración y la sincronización son proyectos distintos.
-
Define el contrato. Exige título, URL y estado de lectura; rechaza los enlaces no válidos, conserva las entradas al recargar y exporta un archivo JSON. Especifica qué debe ocurrir si no hay entradas, si un título es largo o si el archivo importado no tiene un formato válido. Deja fuera la autenticación y el almacenamiento en servidor.
-
Pide un plan antes de modificar archivos. Solicita al modelo que identifique qué archivos necesita, qué método de almacenamiento propone y qué pruebas plantea. Dale una carpeta limpia o un worktree aislado. No empieces entregándole tu directorio personal, credenciales de producción ni permiso para instalar software arbitrario.
-
Implementa una porción vertical cada vez. Añade un artículo, guárdalo y recarga. Luego incorpora el filtro, y después las funciones de exportación e importación. Cada incremento debería seguir siendo ejecutable, de modo que un problema de exportación no termine mezclado con una migración del almacenamiento y un rediseño sin relación.
-
Aporta pruebas concretas. Facilita el error exacto, la entrada y el comportamiento esperado. Si hay un problema de diseño, adjunta una captura recortada sin información privada. Pide una corrección acotada y repite las mismas comprobaciones, en vez de aceptar una reescritura completa cada vez.
-
Aprueba una candidata de publicación. Comprueba la navegación con teclado, la cola vacía, los enlaces duplicados y los títulos largos. Exporta, vacía la cola de prueba, importa y verifica que los campos hayan sobrevivido el recorrido de ida y vuelta. Conserva una copia que sepas que funciona antes de aceptar otra revisión.
El modelo también puede ayudar a redactar un plan de pruebas antes de implementar nada. Por ejemplo, pídele que describa la estructura JSON prevista e identifique qué campos debería validar el importador. Luego compara el código con ese plan. Así se distingue lo que se promete del código y se hacen visibles los desacuerdos.
Un arnés de proyecto proporciona edición de archivos, ejecución de comandos y otras herramientas alrededor del modelo. En su anuncio de lanzamiento, DeepSeek recomienda Harness v0.2.1-rc.1 o posterior para 1017. Sigue la guía oficial de Harness para instalarlo; no des por hecho que una solicitud a la API del chat crea un agente de programación.
Conecta la API sin poner un secreto en tu página web
Usa la API cuando tu propio programa necesite respuestas del modelo. La cola de lectura puede seguir siendo una aplicación local del navegador; el script siguiente es una herramienta de desarrollo independiente que se ejecuta desde la terminal. No incluyas la clave de DeepSeek en index.html, en JavaScript del navegador ni en un repositorio público.
1. Crea una clave de API y elige una tarea pequeña
Crea una clave en la plataforma API de DeepSeek y consulta el saldo de tu cuenta. La guía para la primera solicitud de DeepSeek documenta la URL base compatible con OpenAI https://api.deepseek.com y el modelo deepseek-flash. Una cuenta del chat web no hace ilimitado el uso de pago de la API.
Para la primera solicitud, pide criterios de aceptación, no un repositorio entero. Así la salida será fácil de inspeccionar y se limitará lo que se genere si algo está mal configurado.
2. Prepara Python en tu sistema operativo
Instala Python 3 si aún no está disponible. En una carpeta de proyecto nueva, crea un entorno aislado e instala el SDK. Estos comandos invocan directamente su intérprete, así que no hace falta activar un script ni modificar la política de ejecución de PowerShell. Siguen la documentación de Python sobre entornos virtuales.
Windows, PowerShell:
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install --upgrade openai
Si py no está disponible, pero python --version identifica tu instalación de Python 3, utiliza python -m venv .venv como primer comando.
macOS, Terminal:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Linux, terminal:
python3 -m venv .venv
./.venv/bin/python -m pip install --upgrade openai
Algunas distribuciones de Linux empaquetan venv por separado. Si al crear el entorno se indica que no está disponible, instala el paquete de entorno virtual de Python documentado por tu distribución y vuelve a intentarlo. No resuelvas un problema de aislamiento con sudo pip install en todo el sistema.
3. Crea una herramienta auxiliar para la terminal
Crea first_request.py junto a .venv e incluye este ejemplo. Usa una solicitud de clave oculta mediante el módulo getpass de Python, en vez de colocar el secreto en el código fuente o en un comando guardado en el historial del shell. Ejecútalo en una terminal normal que admita entrada oculta.
from getpass import getpass

from openai import OpenAI

client = OpenAI(
    api_key=getpass("DeepSeek API key: "),
    base_url="https://api.deepseek.com",
    timeout=120.0,
    max_retries=0,
)

reply = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{
        "role": "user",
        "content": (
            "Propose five manual acceptance checks for a browser-only "
            "reading queue with filtering, read status and JSON export. "
            "Return checks only; do not claim to have executed them."
        ),
    }],
    max_tokens=2048,
    stream=False,
    extra_body={"thinking": {"type": "disabled"}},
)

print(reply.choices[0].message.content)
print("Finish reason:", reply.choices[0].finish_reason)
print("Usage:", reply.usage)
4. Ejecútalo e inspecciona la respuesta
En Windows, ejecuta \.venv\Scripts\python.exe first_request.py. En macOS o Linux, ejecuta ./.venv/bin/python first_request.py. Introduce la clave cuando se solicite. El resultado previsto es una lista de comprobaciones, el motivo de finalización y la información de uso, no archivos nuevos del proyecto.
Si la solicitud falla, inspecciona el estado antes de volver a intentarlo. Un 401 está relacionado con la autenticación, un 402 con saldo insuficiente y un 429 con un límite; DeepSeek los documenta en la guía de códigos de error. Un motivo de finalización length indica que la respuesta llegó a un límite, así que no demuestra que esté completa. Mientras aprendes a usar la API, decide deliberadamente cuándo repetir la solicitud.
El razonamiento, la visión y las herramientas web cumplen funciones distintas
El razonamiento está activado por defecto y tiene un nivel de esfuerzo high. Para una pregunta de depuración más difícil, sustituye el extra_body del ejemplo por {"thinking": {"type": "enabled"}} y añade reasoning_effort="high". Las opciones de esfuerzo documentadas son low, high y max; el modo de razonamiento ignora temperature, así que reducirla no es un atajo para razonar con más fiabilidad. Guía del modo de razonamiento, consultada el 18 de octubre
El razonamiento también consume el presupuesto de generación. Aumenta deliberadamente un límite de salida pequeño al pasar de respuestas breves sin razonamiento a tareas complejas. Si implementas llamadas a herramientas en el modo de razonamiento, conserva el reasoning_content del asistente en las solicitudes posteriores que incluyan herramientas, tal como exige la guía. No construyas la conversación con herramientas conservando únicamente la respuesta final visible.
La visión admite imágenes junto con texto; no es un endpoint para generar imágenes. En Chat Completions, añade el contenido de imagen a un mensaje de user con un bloque image_url, una URL de datos base64 o el formato documentado de Files API. Se admiten JPEG, PNG, GIF y WebP. El límite del cuerpo de la solicitud en línea es 48 MiB, y cada imagen en línea o enlazada externamente tiene un límite de 32 MiB. Guía de visión
Para la cola de lectura, envía una captura censurada y pregunta qué etiquetas se solapan cuando la ventana es estrecha. Comprueba el diagnóstico en el navegador en vez de considerarlo una prueba de que el diseño ya está corregido. La comprensión de imágenes tampoco concede a la API permiso para mover el ratón o modificar archivos.
Search encuentra páginas; Fetch recupera una página en formato Markdown. Sus endpoints independientes son POST /v1/tools/search y POST /v1/tools/fetch, y se autentican con la misma clave bearer. Una solicitud Search puede usar {"query":"browser storage documentation","count":3}; Fetch emplea {"url":"https://developer.mozilla.org/en-US/docs/Web/API/Storage"}. Tu aplicación debe llamar a estos endpoints explícitamente o usar una integración que los proporcione. Mencionar una URL en una solicitud básica de chat no equivale a este flujo. Guía de Search y Fetch
Mantén separado el contenido recuperado de las instrucciones. Una página recuperada es una fuente de información, no una autoridad que pueda ordenar la ejecución de comandos, la divulgación de una clave o un cambio en los requisitos del proyecto. Fetch también está sujeto a las políticas de acceso del sitio de destino; no da acceso a material privado o de pago.
Un modelo base grande puede activar menos parámetros sin caber por ello en un portátil
La ficha del modelo V4.1 de septiembre describe una base MoE de 552.000 millones de parámetros, que activa aproximadamente 8.000 millones de parámetros por token de entrada durante el prefill y 16.000 millones por token de salida durante la decodificación. Su arquitectura Causal Encoder-Decoder separa un codificador causal de 20 capas de un decodificador de 20 capas. Estos detalles corresponden al lanzamiento base de V4.1, no a una arquitectura anunciada de nuevo el 17 de octubre. Arquitectura del modelo base y enlace al informe técnico
Dicho de forma sencilla, el prefill procesa la instrucción que ya has escrito y la decodificación produce la respuesta. El enrutamiento Mixture-of-Experts selecciona expertos en vez de activar todos los parámetros de la base para cada token. La atención comprimida y el diseño de caché compartida del modelo reducen el coste de memoria de las instrucciones largas. Sin embargo, el número de parámetros activos describe el cálculo, no todo el almacenamiento y la memoria necesarios para alojar el checkpoint.
El contexto anunciado es de un millón de tokens. Es una capacidad, no una exigencia de pegar un repositorio entero en cada solicitud ni una garantía de recuerdo perfecto. Empieza con la tarea, los archivos pertinentes y los errores concretos; amplía el contexto cuando lo justifique una dependencia o un contrato que falte.
Para alojar el modelo por tu cuenta, utiliza las instrucciones oficiales de inferencia 1017, que explican la conversión del checkpoint y la ejecución en paralelo por tensores. El lanzador genérico de vLLM de la página de Hugging Face no es una receta de despliegue específica para el modelo. Comprueba el hardware, los kernels compatibles y la compatibilidad del servicio antes de descargar los pesos. deepseek-recipe se ocupa de convertir instrucciones y protocolos; no proporciona inferencia ni ejecuta herramientas. Quien use un portátil normal debería empezar por el acceso alojado.
Calcula el coste de toda la tarea, no el token más barato
A fecha de 18 de octubre de 2026, DeepSeek publica los siguientes precios de Flash en dólares estadounidenses por millón de tokens. Precios oficiales
| Categoría de token | Hora punta | Fuera de hora punta |
|---|---|---|
| Entrada, sin acierto de caché | 0,30 USD | 0,15 USD |
| Entrada, con acierto de caché | 0,006 USD | 0,003 USD |
| Salida | 1,20 USD | 0,60 USD |
Las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, excepto los festivos públicos chinos; el resto son horas valle. Según ese calendario, todo el fin de semana es hora valle. Para programar las solicitudes, usa UTC en vez de dar por hecho que las horas diurnas de tu zona son más caras.
Este cálculo ilustrativo supone una tarea con 100.000 tokens de entrada sin acierto de caché, 200.000 tokens de entrada con acierto y 20.000 tokens de salida. El cálculo en hora punta es:
(0.1 x $0.30) + (0.2 x $0.006) + (0.02 x $1.20)
= $0.0300 + $0.0012 + $0.0240
= $0.0552
Con las tarifas valle, esas cantidades supuestas cuestan 0,0276 USD. Es un cálculo aritmético, no la factura medida de un proyecto. Usa el consumo real con y sin aciertos de caché; no presupongas que el contexto repetido siempre obtiene la tarifa reducida.
Search y Fetch cuestan 0,75 USD por cada 1.000 solicitudes satisfactorias que devuelven resultados. Por tanto, 40 búsquedas facturables más 60 recuperaciones facturables suman 0,075 USD, sin incluir los tokens del modelo que se utilicen para leer esos resultados. El periodo temporal gratuito se aplica a las llamadas del lado del servidor a través de las integraciones de API de DeepSeek indicadas; su facturación comienza el 31 de octubre de 2026 a las 16:00 UTC. No es un periodo gratuito general para usar directamente el endpoint. Reglas de facturación de herramientas
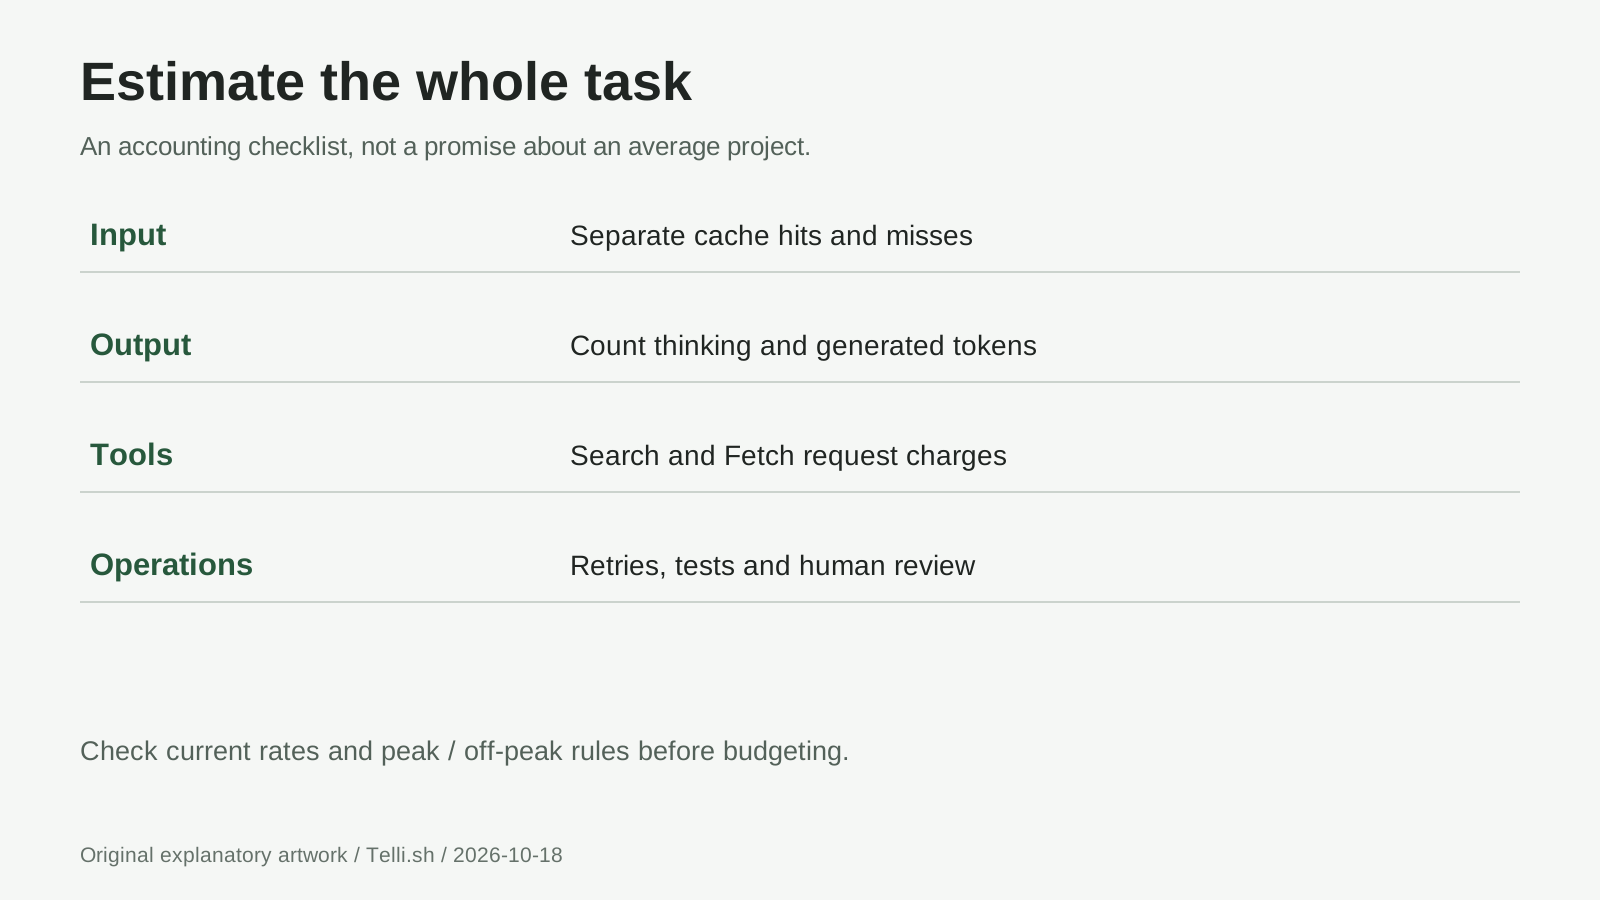
Diagrama original de costes: incluye en el presupuesto el razonamiento generado, los reintentos, las llamadas a herramientas y el tiempo de revisión. No implica un coste medio por proyecto.
Interpreta las mejoras del benchmark teniendo en cuenta el arnés
DeepSeek informa de los siguientes cambios entre V4.1 Flash base y 1017. Son resultados publicados por el proveedor, no mediciones independientes de esta guía. Comparación de la ficha del modelo 1017
| Benchmark | V4.1 Flash | 1017 | Cambio |
|---|---|---|---|
| DeepSWE v1.1 | 74,2 | 77,0 | +2,8 puntos |
| Terminal-Bench 4.0 | 31,2 | 42,3 | +11,1 puntos |
| ProgramBench | 20,3 | 29,1 | +8,8 puntos |
La ficha de 1017 especifica Claude Code para Terminal-Bench 4.0 y Mini-SWE-V2 para DeepSWE v1.1. Un arnés proporciona herramientas, gestión del contexto y políticas de ejecución; cambiarlo cambia el experimento. No interpretes una diferencia de puntuación entre configuraciones distintas como una medida pura de la capacidad del modelo.
Si haces tu propia comparación, mantén fijo el repositorio, los criterios de aceptación, los permisos y el presupuesto. Registra si funciona el proyecto, cuántas correcciones hizo falta introducir, el uso total y el tiempo transcurrido. Una puntuación pública más alta ayuda a elegir una opción; la tarea repetible en tu entorno determina si merece encargarse de ella.
Qué conviene resolver antes de asignarle una tarea mayor
¿1017 es un nombre de modelo distinto en la API?
No. Utiliza deepseek-flash. El nombre fechado del checkpoint identifica la actualización, pero la API alojada de DeepSeek mantiene el identificador existente. Si necesitas reproducibilidad, anota la fecha y la información del modelo devuelta. Documentación de la primera solicitud
¿La licencia MIT de los pesos hace gratuita la API?
No. La ficha del modelo 1017 ofrece el repositorio y los pesos con licencia MIT. El uso alojado tiene cargos independientes. La licencia de los pesos tampoco te concede derechos sobre entradas privadas, recursos de terceros ni contenido multimedia de las demostraciones.
¿Puede crear un juego completo a partir de una sola instrucción?
Toma las demos oficiales como ejemplos de resultados del editor, no como garantía de entrega. Define el movimiento, las colisiones, el reinicio y las condiciones para terminar antes de pedir acabados visuales. Un juego que puedes inspeccionar y volver a jugar es un hito mejor que una base de código enorme generada de una vez.
¿Debería usar siempre el máximo razonamiento y todo el contexto?
No. Empieza con una petición acotada y aumenta el esfuerzo o el contexto cuando un fallo concreto lo justifique. Más razonamiento generado e instrucciones más largas consumen recursos; ninguno sustituye a los criterios de aceptación ni a los permisos cuidadosos para las herramientas.
¿Puedo publicar inmediatamente el trabajo generado?
Primero revisa la funcionalidad, la seguridad, las licencias de dependencias y la procedencia de los recursos. Elimina las credenciales de ejemplo e inspecciona las solicitudes remotas. Mantén la aprobación de despliegue separada del permiso para editar un proyecto local.
En resumen: terminar significa que alguien comprobó el resultado
La promesa útil de 1017 es completar mejor los proyectos, no dejar de revisarlos. Dale al modelo un objetivo pequeño, un entorno acotado y comprobaciones observables. Amplía el proyecto solo después de aprobar el comportamiento que ya tiene.
Fuentes
La documentación del producto y los precios se consultaron el 18 de octubre de 2026. Las afirmaciones sobre benchmarks y entrenamiento se atribuyen a DeepSeek; los ejercicios son ejemplos didácticos, no resultados de pruebas prácticas. Los tres diagramas son ilustraciones explicativas originales. Se enlaza al material multimedia de las demos del proveedor en lugar de reproducirlo.
- Actualización del 17 de octubre y demostraciones de proyectos
- Lanzamiento base del 10 de septiembre
- Registro de actualizaciones fechado
- Ficha del modelo 1017, benchmarks y licencia MIT
- Arquitectura base V4.1 e informe técnico
- Primera solicitud a la API, razonamiento, visión, Search y Fetch y precios
- Referencia oficial de inferencia y deepseek-recipe
Deja el siguiente proyecto listo para retomarlo
Recomendación de Telli.sh: guarda juntos los enlaces de origen, el resumen del proyecto, las instrucciones y las notas de revisión para que la próxima sesión empiece con decisiones y no con conjeturas. Telli.sh puede organizar el conocimiento del proyecto; no es una integración con el agente de programación de DeepSeek. Crea una cuenta de Telli.sh