Czy stara pamięć DDR4 da serwerowi AI więcej swobody?
Netlist i Marvell szykują na SC26 projekty CXL z pamięcią DDR4. Sprawdź, gdzie przyda się dodatkowa pamięć hosta i co zmierzyć przed zakupem.
Wewnętrzna wyszukiwarka działa szybko do porannego szczytu. Musi pobrać fragmenty z tysięcy dokumentów, zanim wyśle do GPU żądanie wygenerowania odpowiedzi. Często używane fragmenty mieszczą się w pamięci, ale kolejne zapytania do reszty zbioru znów sięgają do pamięci masowej. Użytkownicy czekają dłużej, choć akcelerator ma wolne zasoby. Zespołowi utrzymującemu usługę większa pamięć podręczna na serwerze może pomóc bardziej niż kolejny GPU.
Dwie zapowiedzi przed SC26 pokazują dodatkowy sposób zbudowania takiej pamięci podręcznej. 10 listopada konsorcjum CXL przekazało, że Netlist, firma specjalizująca się w pamięci, planuje pokazać prototyp NVvault-D4. Pozwala on użyć posiadanej pamięci DDR4 do rozszerzenia pamięci hosta za pośrednictwem Compute Express Link (CXL). 13 listopada producent układów Marvell zapowiedział ekspozycje partnerów z kontrolerami rozszerzeń pamięci Structera X wykorzystującymi DDR4 i DDR5. Zapowiedzi dotyczą sprzętu przewidzianego do prezentacji. Ceny, terminy dostaw i wyniki zaplanowanych demonstracji pozostają otwarte. SC26 odbywa się w Chicago 15–20 listopada, a regularna wystawa 17–19 listopada czasu lokalnego. Zapowiedź Netlist przedstawiona przez konsorcjum CXL · Ogłoszenie Marvell na SC26 · Oficjalne daty SC26
Kupujący powinien sprawdzić, czy dodatkowa pojemność utrzyma w pamięci dostatecznie dużo danych potrzebnych aplikacji bez nadmiernego wydłużania najwolniejszych zapytań. Jeśli zespół ma zapas DDR4, ponowne użycie modułów może przynieść oszczędności pod warunkiem, że przejdą kwalifikację, a system zdoła umieścić w nich właściwe dane. Wartość takiej rozbudowy zależy od tego, które zadania czekają dzisiaj i gdzie powstaje opóźnienie.
Gdzie trafia dodatkowa pamięć
CPU sięga do bezpośrednio podłączonej lokalnej pamięci DRAM przez swój kontroler pamięci. Przy zgodnym serwerze i urządzeniu rozszerzającym CPU ma także dostęp przez CXL do pamięci udostępnianej przez to urządzenie. Rozszerzenie zapewnia dodatkowe miejsce na dane po stronie hosta. Ścieżka dostępu, przepustowość i opóźnienie są inne niż w lokalnych kanałach DRAM. Oprogramowanie układowe i system operacyjny muszą udostępnić pojemność, a aplikacja lub system potrzebuje reguł umieszczania stron pasujących do rodzaju obciążenia.
To ważne, gdy ktoś chce użyć zapasu DDR4 w nowszym serwerze. Serwer może zachować lokalną DDR5 i sięgać po DDR4 za pośrednictwem obsługiwanego rozszerzenia. Nadal liczą się kontroler urządzenia, kwalifikacja modułów i zgodność z hostem. Prototyp wykorzystujący posiadaną DDR4 daje powód, by zbadać ponowne użycie. Pozostaje ustalić, które moduły będą przyjmowane w obsługiwanej konfiguracji i na jakich serwerach zadziałają niezawodnie.
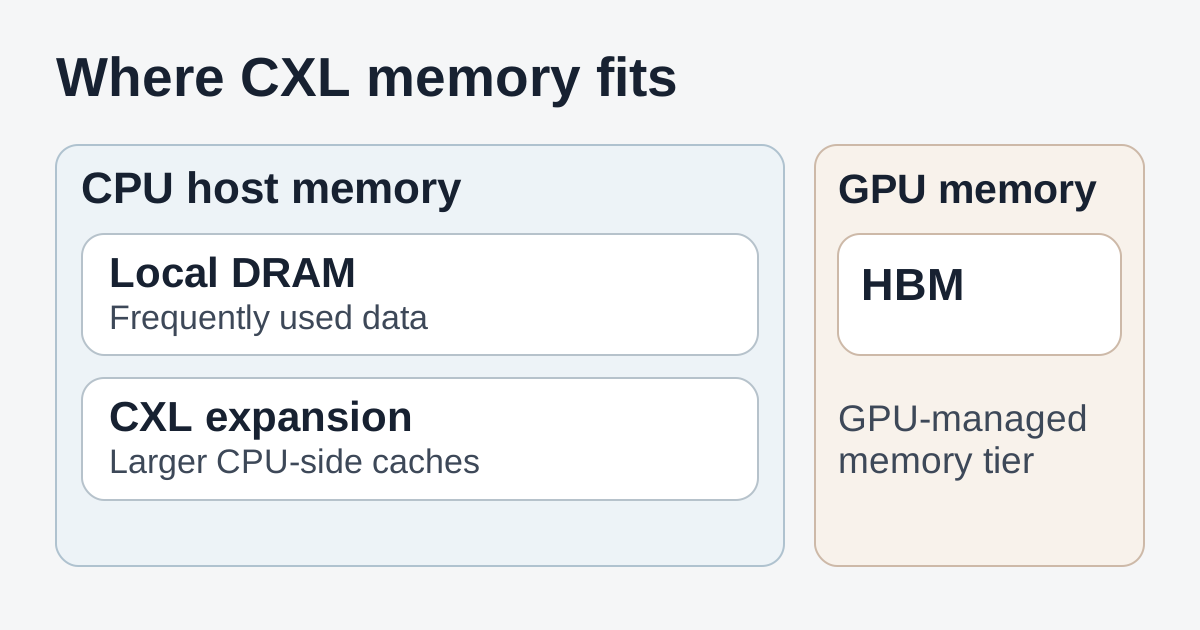
Lokalna DRAM może przechowywać często używane strony, a poziom rozszerzenia większe pamięci podręczne po stronie CPU. Pamięć akceleratora o dużej przepustowości ma własne ograniczenia pojemności i przepustowości.
W przykładzie z wyszukiwaniem często odczytywane dane indeksu można pozostawić w lokalnej DDR5, a większą, rzadziej czytaną pamięć podręczną fragmentów lub wyników przenieść na poziom CXL. Gdy usługa znajdzie właściwe fragmenty, zaplecze inferencji przekazuje je modelowi działającemu na GPU. Wagi modelu i dane potrzebne kodowi akceleratora nadal muszą się zmieścić tam, skąd oczekuje ich silnik inferencji. Rozszerzenie CXL z tych zapowiedzi zwiększa pojemność pamięci hosta. Pamięć GPU o dużej przepustowości, zwykle nazywana HBM, pozostaje odrębnym zasobem.
Zacznij od prześledzenia, na co idzie czas obsługi zapytań. Jeśli CPU regularnie czeka na dane usunięte z pamięci podręcznej, większa pamięć hosta może zapobiec odczytom z nośnika. Jeśli model poświęca większość czasu na odczyt wag z pamięci GPU, a host rzadko czeka, zakup może niewiele zmienić w czasie odpowiedzi. Szybsze pobranie danych może być odczuwalne, nawet gdy sam model działa z tą samą szybkością. Zmierz oba etapy, zanim przypiszesz zmianę działania całej usługi któremuś z nich.
Trzy prototypy Netlist odpowiadają na różne potrzeby
Dla ponownego użycia DDR4 interesujący jest NVvault-D4. Konsorcjum wymienia maszyny wirtualne, bazy danych działające w pamięci, obliczenia wysokiej wydajności i zastosowania korporacyjne. Konkretnym przykładem jest host wirtualizacji. Najbardziej aktywne maszyny wirtualne mogłyby pozostać w pamięci lokalnej, podczas gdy zespół sprawdza, czy rzadziej używane strony systemów gościnnych można przenieść do rozszerzenia. Zespół bazodanowy mógłby spróbować tego z częścią pamięci podręcznej odczytu. Baza wymagałaby takiego przydziału, aby strony zapytań wrażliwych na opóźnienie pozostały blisko CPU. To możliwe pilotaże rozszerzenia pojemności. W zapowiedzi nie podano wyników dla konkretnych obciążeń. Zapowiedź Netlist przedstawiona przez konsorcjum CXL
Pozostałe dwa projekty Netlist pokazują, dlaczego oznaczenia mają znaczenie. NVvault-HM korzysta z DRAM jako pamięci podręcznej przed zasobem opartym na NAND. W zapowiedzi opisano przenoszenie danych i telemetrię, a wśród przykładów podano pamięć podręczną klucz–wartość dla AI i analitykę. NVvault-PM to osobna konstrukcja CXL Type 3 z DRAM, zabezpieczeniem danych w NAND i wbudowanym źródłem energii na wypadek utraty zasilania. Zapowiedź wskazuje PM do zachowania pamięci podręcznej klucz–wartość, obsługi punktów kontrolnych i odzyskiwania. Zespoły rozważające kopie zapasowe lub trwałość danych potrzebują szczegółów o zachowaniu danego projektu w scenariuszach awarii. Zapowiedź D4 nie daje podstaw do przypisania temu rozwiązaniu właściwości zapisu i odzyskiwania pozostałych dwóch projektów. Zapowiedź Netlist przedstawiona przez konsorcjum CXL
Pamięć podręczna klucz–wartość modelu językowego daje osobny przykład testu AI. Przechowuje dane mechanizmu uwagi z poprzednich tokenów, aby model mógł użyć ich ponownie. Silnik inferencji, który przenosi dane do hosta, mógłby zdejmować z GPU strony pamięci podręcznej nieaktywnych sesji i odtwarzać je po wznowieniu tych sesji. Zespół może sprawdzić, czy większa pojemność hosta pozwala zachować więcej sesji i ile transfery dodają do czasu wznowionego żądania. Rozmieszczenie i kopiowanie zależą od silnika i serwera. To przykład eksperymentu dla wielopoziomowej pamięci hosta. W zapowiedzi Netlist zastosowanie pamięci podręcznej KV jest przypisane wprost do HM i PM.
Zapowiedź Marvell daje kupującym drugi wariant realizacji wart obserwowania. Partnerzy planują pokazać systemy z rodziny kontrolerów Structera X oparte na DDR4 i DDR5. Program i materiały prasowe podają kontekst wystawy oraz rodziny produktów. Kupujący wciąż muszą sprawdzić, które konfiguracje serwerów zatwierdzi dostawca, jaką pamięć przyjmują i jak dostawcy wspierają cały system. Zdjęcia układów w zestawie są poglądowymi materiałami rodziny produktów. Program pawilonu konsorcjum CXL na SC26 · Ogłoszenie Marvell na SC26 · Materiały prasowe Marvell Structera
Najpierw zmierz najwolniejsze zapytania
Średnia może ukryć zapytania, przez które aplikacja wydaje się powolna. W wyszukiwarce popularne dokumenty mogą przez cały dzień dawać szybkie trafienia, a mniej popularne wielokrotnie kierować te same procesy robocze do warstwy rozszerzenia. Wzrost czasu najwolniejszych zapytań może być do przyjęcia podczas nocnego indeksowania wsadowego. Klient czekający na wynik wyszukiwania może dostrzec go od razu. Konfiguracja pamięci powinna sprostać rzeczywistym celom usługi w godzinach szczytu.
Niezależni badacze w publikacji MELODY pokazali znaczenie tego problemu w 2025 r. Zbadali 265 obciążeń, korzystając z czterech rzeczywistych urządzeń pamięci CXL, pięciu platform CPU i siedmiu poziomów opóźnienia. Sprawdzali wrażliwość w zakresie poniżej mikrosekundy, od 140 do 410 ns, i ustalili, że na działanie pamięci CXL wpływały charakter obciążenia, opóźnienia najwolniejszych żądań i zachowanie procesora. Autorzy nazywają testowane rozszerzenia CXL-A do CXL-D. Wyniki nie pozwalają oszacować wydajności zapowiedzianych systemów z SC26. Kupującemu pokazują, dlaczego średnie opóźnienie lub jeden udany test nie rozstrzygają, jak zachowa się konkretny serwer. Badanie MELODY z ASPLOS 2025 · Pełna publikacja
Jeśli platforma pozwala, zaplanuj trzy porównania. Najpierw odtwórz działanie obecnej usługi na dotychczasowej lokalnej DRAM. Potem przetestuj większą pojemność w hoście z poziomami pamięci. Wreszcie użyj konfiguracji całkowicie lokalnej o tej samej łącznej pojemności, aby nadać wynikowi miarodajny punkt odniesienia. Przykładowe liczby do porównania to 256 GiB lokalnej DRAM z 256 GiB dostępnego rozszerzenia wobec 512 GiB lokalnej DRAM. Zachowaj porównywalną aplikację, zbiór danych, ustawienia i obciążenie. Zapisz też różnice w platformie lub lokalnych kanałach, których nie da się uniknąć. Jeśli w praktyce alternatywą jest przenoszenie nadmiarowych danych na nośniki albo podział danych na drugi host, zmierz czas i koszt tego wariantu.
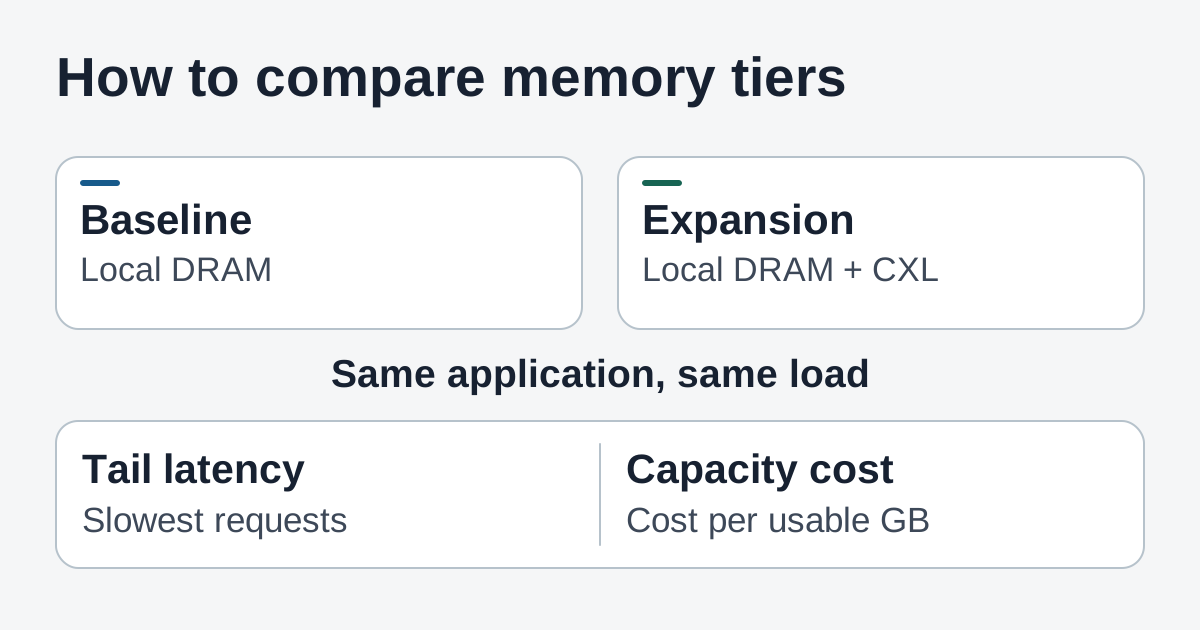
Porównaj takie samo obciążenie i ruch w obu konfiguracjach. Zmierz najwolniejsze zapytania i oblicz koszt jednostki dostępnej pojemności.
- Odtwórz ruch wypełniający pamięć podręczną. Użyj realistycznej mieszanki zapytań o dokumenty używane często i rzadko. Wykonaj próbę od zimnego startu i ponownie po rozgrzaniu pamięci podręcznej. Porównaj medianę i percentyle p95 oraz p99 czasu odpowiedzi, odsetek błędów i przepustowość przy tej samej współbieżności. W wyszukiwaniu wspieranym przez AI mierz pobieranie danych i inferencję osobno, żeby szybszy odczyt nie ukrył spowolnienia modelu ani odwrotnie.
- Sprawdź, które dane rzeczywiście się przemieściły. Przejrzyj przydział pamięci według poziomu i węzła NUMA CPU, przenoszenie i zwalnianie stron, jeśli można to zobaczyć, oraz liczniki łącza lub urządzenia udostępniane przez platformę. Dobry pozornie przebieg mógł obsłużyć niemal wszystkie zapytania w lokalnej DRAM. W słabym przebiegu często odczytywane strony indeksu mogły domyślnie trafić do zdalnej warstwy. Obok każdego zestawu pomiarów zapisz reguły rozmieszczania danych.
- Odtwórz popołudnie pod dużym obciążeniem. Włącz drugie zadanie podczas pracy usługi interaktywnej, rozgrzej pamięć podręczną po restarcie i obserwuj system w pobliżu granicy pojemności. Sprawdź, jak system operacyjny raportuje błędy urządzenia lub pamięci, jak obsługa identyfikuje dany host i jak usługa wraca do wcześniejszej polityki przydziału. Odtwarzanie działania warto uwzględnić dla każdej konfiguracji, którą zespół musiałby utrzymywać.
- Ustal kryteria odbioru przed obejrzeniem wykresów. Zacznij od aktualnych celów dla p99 i odsetka błędów. Zapisz, ile dodatkowej pojemności musi być dostępne przy tych celach i gdzie można zaakceptować wolniejsze odzyskiwanie. Jeżeli system spełnia wymagania tylko przy wysokim odsetku trafień w pamięć podręczną, użyj zapisów z najbardziej obciążonych dni i sprawdź, czy ten odsetek utrzymuje się przy ruchu produkcyjnym.
Policz pełny koszt ponownego użycia
Posiadane moduły DIMM mogą obniżyć pozycję pamięci w ofercie. Nadal trzeba uwzględnić urządzenie rozszerzające, obsługiwany host lub aktualizację, zakwalifikowane moduły oraz czas ludzi na wdrożenie i serwis. Urządzenie potrzebuje też odpowiedniego gniazda lub innego połączenia z platformą. Sprawdź planowany podział linii PCIe między nośniki, sieć i akceleratory. Rozbudowa pamięci traci sens, jeśli zabiera zasoby, które tej samej aplikacji są potrzebne do przenoszenia danych.
Oblicz koszt każdego użytecznego GiB przy wymaganym poziomie usługi. Uwzględnij pamięć rezerwowaną przez platformę lub pozostawianą na zapewnienie dostatecznej liczby lokalnych stron, zużycie energii i chłodzenie, kwalifikację dla całej floty, części zapasowe i wsparcie przez cały planowany okres pracy. Sprawdź, kto dostarcza aktualizacje oprogramowania układowego i jak system pokazuje stan sprzętu i błędy pamięci. Jeśli dodatkowy poziom pozwala obsłużyć na jednym hoście zadania, które inaczej używałyby pamięci masowej lub drugiej maszyny, zmierz oszczędność i uwzględnij narzut obu architektur. Uruchomienie usługi z maksymalną częstotliwością zapytań na obu architekturach pozwoli porównać koszt utrzymania czasu odpowiedzi w celu.
Po SC26 warto śledzić zakwalifikowane konfiguracje, udokumentowaną obsługę modułów, zgodność oprogramowania i ślady działania rzeczywistych obciążeń. Wydany system mógłby dać zespołom z dużym drugorzędnym zbiorem roboczym inną metodę rozbudowy obecnego serwera. Mocnym przykładem byłaby usługa przechowująca więcej danych dokumentów na hoście, unikająca powtarzanych odczytów z nośników i utrzymująca poprzedni limit p99 za mniejsze pieniądze. Zespół z takim wynikiem ma uzasadnienie zakupu, z którego można skorzystać przy następnym serwerze.
Źródła
- Zapowiedź Netlist na SC26 przedstawiona przez konsorcjum CXL, 10 listopada 2026 r.
- Ogłoszenie Marvell o partnerach i łączności na SC26, 13 listopada 2026 r.
- Program pawilonu konsorcjum CXL na SC26 i grafiki wydarzenia
- Materiały prasowe rodziny produktów Marvell Structera
- Oficjalny program SC26 i daty wystawy
- Publikacja MELODY i informacje wydawnicze, ASPLOS 2025 · Pełna publikacja
Aby trzymać w jednym miejscu notatki z pilotażu, pomiary obciążeń i decyzje zakupowe, załóż konto w Telli.sh.