La vecchia DDR4 può dare più margine a un server per l’IA?
Netlist e Marvell portano a SC26 soluzioni CXL basate su DDR4. Ecco a che cosa può servire più memoria host e che cosa misurare prima dell’acquisto.
Un servizio di ricerca interno sembra rapido fino al picco del mattino. Deve recuperare brani da migliaia di documenti prima di inviare alla GPU la richiesta di una risposta. I passaggi più usati entrano in memoria, ma le ricerche che tornano sul resto della raccolta devono rileggere i dati dallo storage. Chi cerca aspetta più a lungo anche se all’acceleratore resta capacità disponibile. Per il team che gestisce il servizio, una cache più grande sul server potrebbe essere più utile di un’altra GPU.
Due anticipazioni per SC26 indicano un modo in più per realizzare quella cache. In un annuncio del 10 novembre, il CXL Consortium ha riferito che Netlist, specialista di memorie, prevedeva di mostrare un prototipo chiamato NVvault-D4, che rende disponibile DDR4 esistente come espansione della memoria host tramite Compute Express Link, o CXL. Il 13 novembre il produttore di chip Marvell ha annunciato che i partner avrebbero esposto sistemi con controller di espansione della memoria Structera X e DDR4 o DDR5. Gli annunci riguardano hardware destinato all’esposizione. Prezzi, date di consegna ed esiti delle dimostrazioni previste restano aperti. SC26 si svolge a Chicago dal 15 al 20 novembre, con esposizione ordinaria dal 17 al 19 novembre, ora locale. Anteprima Netlist del CXL Consortium · Annuncio SC26 di Marvell · Calendario ufficiale di SC26
Per chi deve acquistare, la domanda è se la capacità aggiuntiva permetta di tenere in memoria una parte sufficiente del carico di lavoro senza rallentare troppo le richieste più lente. Per un team con DDR4 di scorta, il riuso potrebbe convenire se i moduli sono qualificati e il sistema riesce a collocarvi i dati giusti. Il valore dipende da che cosa oggi resta in attesa e in quale punto.
Dove si colloca la memoria aggiuntiva
Una CPU può raggiungere la DRAM locale direttamente tramite il proprio controller di memoria. Con un server compatibile e un dispositivo di espansione CXL, può anche accedere alla memoria dietro quel dispositivo tramite un collegamento CXL. L’espansione aggiunge uno spazio per i dati lato host. Percorso, banda e latenza differiscono da quelli dei canali DRAM locali. Il firmware e il sistema operativo devono rendere disponibile la capacità, e l’applicazione o il sistema operativo deve usare una politica di collocazione delle pagine adatta al carico.
La distinzione conta quando si valuta l’uso di DDR4 di scorta in un server più recente. Il server può conservare la DDR5 locale e raggiungere la DDR4 tramite un dispositivo di espansione supportato. Restano importanti il controller del dispositivo, la qualifica dei moduli e la compatibilità dell’host. Un prototipo che usa DDR4 esistente dà un motivo per esplorare il riuso. Rimane da capire quali moduli accetterebbe una configurazione supportata e su quali sistemi potrebbero funzionare in modo affidabile.
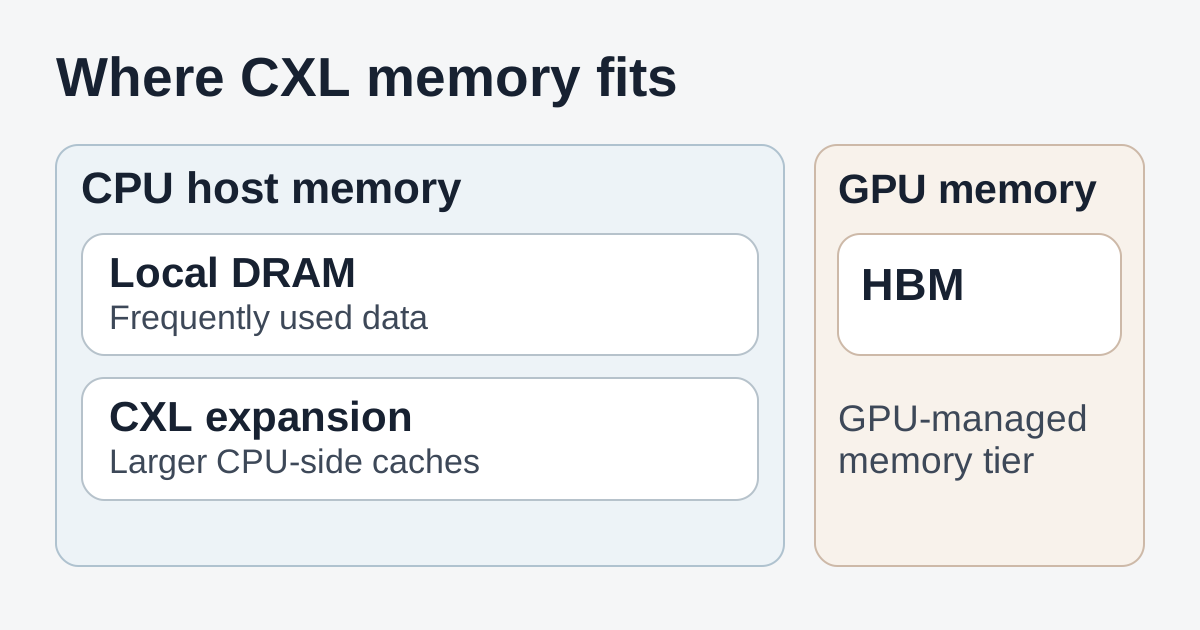
La DRAM locale può contenere le pagine consultate di frequente, mentre il livello di espansione può ospitare cache più grandi lato CPU. La memoria ad alta banda dell’acceleratore ha limiti propri di capacità e banda.
Nell’esempio della ricerca, il team potrebbe tenere nella DDR5 locale i dati dell’indice consultati di frequente e spostare nel livello CXL una cache più grande di brani o risultati a cui accede più di rado. Una volta trovati i passaggi pertinenti, il servizio di inferenza li passa a un modello in esecuzione sulla GPU. I pesi del modello e i dati necessari al kernel dell’acceleratore devono comunque entrare nello spazio in cui il motore di inferenza si aspetta di trovarli. L’espansione CXL di questi annunci riguarda la capacità della memoria host. La memoria ad alta banda della GPU, comunemente chiamata HBM, resta una risorsa separata.
Comincia tracciando dove le richieste passano il tempo. Se la CPU aspetta spesso dati espulsi dalla cache, più memoria host può evitare di doverli andare a cercare nello storage. Se invece il modello passa gran parte del tempo a leggere i pesi dalla memoria GPU e l’host si blocca di rado, lo stesso acquisto potrebbe incidere poco sui tempi di risposta. Recuperare prima i dati può contare anche quando il modello gira alla stessa velocità. Misura entrambe le fasi prima di attribuire all’una o all’altra le variazioni del tempo complessivo.
I tre prototipi Netlist rispondono a esigenze diverse
NVvault-D4 è il prototipo Netlist da seguire per il riuso della DDR4. Il consorzio indica come obiettivi macchine virtuali, database in memoria, calcolo ad alte prestazioni e carichi aziendali. Un host di virtualizzazione offre un esempio. Le macchine virtuali più attive potrebbero restare sulla memoria locale, mentre il team prova a collocare nel livello di espansione le pagine delle macchine meno attive. Chi gestisce un database potrebbe provare lo stesso approccio con parti della cache di lettura. Il database avrebbe bisogno di una politica di allocazione che tenga vicino alla CPU le pagine usate dalle query sensibili alla latenza. Sono progetti pilota possibili per un’espansione di capacità. Il comunicato di anteprima non riporta risultati su carichi di lavoro. Anteprima Netlist del CXL Consortium
Gli altri due progetti Netlist mostrano perché contano i nomi dei modelli. NVvault-HM usa una cache DRAM davanti a una capacità basata su NAND. L’annuncio parla di movimento dei dati e telemetria oltre che di casi d’uso come cache chiave-valore per l’IA e analisi. NVvault-PM è un progetto CXL Type 3 distinto, descritto con DRAM, backup NAND e una fonte di energia integrata per gestire le interruzioni di alimentazione. L’anteprima propone PM per la conservazione delle cache chiave-valore, i checkpoint e il ripristino. Chi valuta il backup o la persistenza dovrebbe verificare come si comporta quel progetto nelle condizioni di guasto previste. L’annuncio di D4 non attribuisce a quel modello le funzioni di archiviazione o ripristino degli altri due. Anteprima Netlist del CXL Consortium
La cache chiave-valore di un modello linguistico offre un esempio di prova per l’IA. La cache conserva i dati dell’attenzione ricavati dai token precedenti, che il modello può riutilizzare. Un motore di inferenza che supporta lo spostamento nella memoria host potrebbe trasferire fuori dalla memoria GPU le pagine di cache delle sessioni inattive e ricaricarle al loro ritorno. Il team può verificare se la capacità host aggiuntiva permette di conservare più sessioni e quanto incidono i trasferimenti sui tempi di una richiesta ripresa. Collocazione e copia dipendono dal motore e dal server. È un esperimento possibile per una memoria host a più livelli. Nell’anteprima, Netlist associa esplicitamente la cache KV a HM e PM.
L’annuncio di Marvell offre un secondo filone da seguire. I partner prevedono di mostrare sistemi basati sulla famiglia di controller Structera X con DDR4 e DDR5. Il programma e il kit stampa danno contesto all’esposizione e alla famiglia. Chi acquista dovrà verificare quali configurazioni dei server qualifica il fornitore, quali memorie accettano e che tipo di assistenza è prevista per l’intero sistema. Le immagini dei chip nel kit sono materiale informativo della famiglia di prodotti. Programma del padiglione SC26 del CXL Consortium · Annuncio SC26 di Marvell · Kit stampa Marvell Structera
Misura prima le richieste più lente
La media può nascondere le richieste che fanno sembrare lenta un’applicazione. In un servizio di ricerca, i documenti popolari possono produrre risposte rapide per tutta la giornata, mentre per quelli meno comuni gli stessi processi interrogano ripetutamente il livello di espansione. Un aumento nei tempi delle richieste più lente può essere accettabile per l’indicizzazione notturna. Chi aspetta il risultato di una ricerca può accorgersene subito. La configurazione di memoria va valutata rispetto all’obiettivo del servizio sotto il carico di picco.
I ricercatori indipendenti dello studio MELODY hanno mostrato concretamente il problema nel 2025. Hanno esaminato 265 carichi con quattro dispositivi CXL reali, cinque piattaforme CPU e sette livelli di latenza. Hanno studiato la sensibilità nell’intervallo inferiore a un microsecondo, tra 140 e 410 nanosecondi, rilevando l’importanza del carico, della latenza ai percentili più alti e del comportamento della CPU nel modo in cui i sistemi gestivano la memoria CXL. L’articolo chiama gli espansori di prova da CXL-A a CXL-D. I risultati non stimano le prestazioni dei sistemi annunciati per SC26. Per chi acquista, mostrano perché una sola latenza media o un benchmark favorevole non basta a sapere come si comporterà un server. Studio MELODY, ASPLOS 2025 · Articolo completo
Prevedi tre confronti se la piattaforma lo consente. Prima riproduci il servizio attuale sulla DRAM locale già disponibile. Poi prova più capacità con un host a più livelli. Infine usa una configurazione tutta locale con la stessa capacità totale, per dare al risultato a più livelli un riferimento utile. Come esempio puramente illustrativo di dimensionamento, confronta 256 GiB di DRAM locale più 256 GiB di espansione utilizzabile con 512 GiB di DRAM locale. Mantieni comparabili applicazione, dati, impostazioni e carico offerto. Registra eventuali differenze di piattaforma o canali locali imposte dalle configurazioni. Se l’alternativa operativa è usare lo storage per i dati che non entrano in memoria o distribuirli su un altro host, misura tempi e costi anche per quell’opzione.
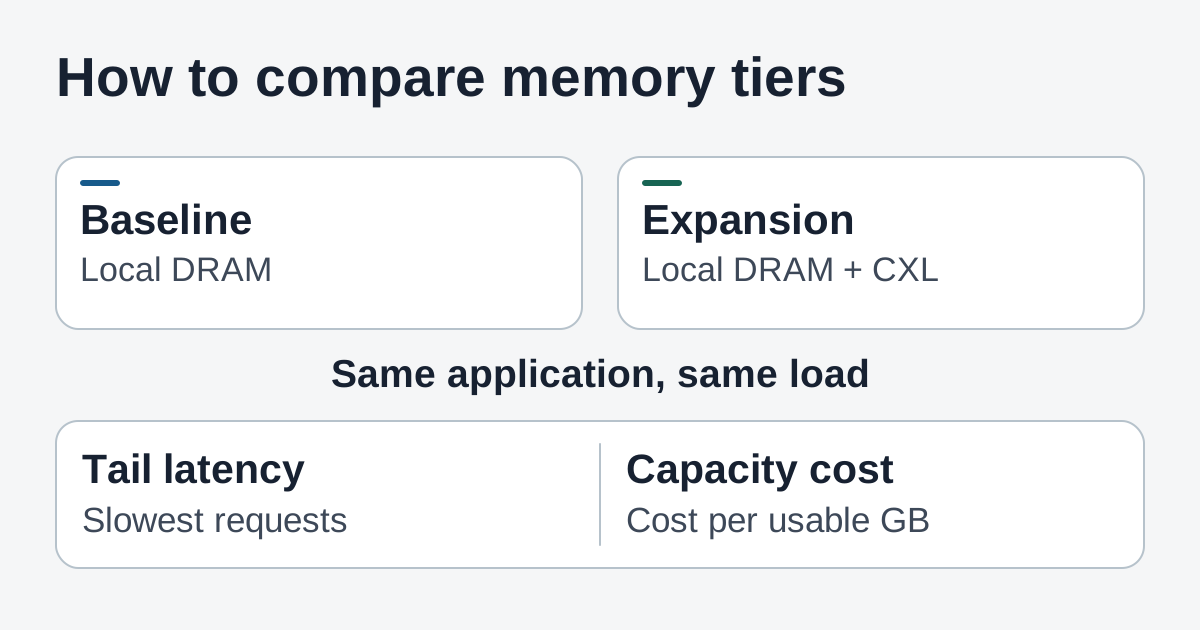
Confronta gli stessi carichi e lo stesso traffico nelle due configurazioni. Verifica le richieste più lente e calcola il costo di ogni unità di capacità utilizzabile.
- Riproduci il traffico che riempie la cache. Usa un insieme realistico di richieste, con documenti consultati spesso e documenti rari. Parti a freddo e ripeti a cache calde. Alla stessa concorrenza, osserva mediana, p95 e p99 della latenza delle richieste, tasso di errore e volume di richieste elaborate. Per un’applicazione di ricerca con IA, misura separatamente recupero e inferenza, così eventuali miglioramenti nella cache non nascondono rallentamenti del modello e viceversa.
- Controlla quali dati si sono spostati. Esamina l’allocazione della memoria per livello e nodo NUMA della CPU, la migrazione e il recupero delle pagine, se disponibili, e i contatori di collegamento o dispositivo offerti dalla piattaforma. Un test apparentemente buono potrebbe aver servito quasi tutto dalla DRAM locale. Uno apparentemente cattivo potrebbe aver collocato per impostazione predefinita nel livello remoto le pagine dell’indice consultate di frequente. Registra la politica di collocazione accanto a ogni serie di misure.
- Prova un pomeriggio di punta. Esegui una seconda attività mentre il carico interattivo è intenso, riscalda la cache dopo un riavvio e osserva che cosa succede vicino ai limiti di memoria del servizio. Controlla come il sistema operativo segnala guasti del dispositivo o errori di memoria, come individuare l’host interessato e come ripristinare la politica di allocazione precedente. Il recupero fa parte del pilota per ogni configurazione che il team dovrà supportare.
- Definisci i criteri prima di guardare i grafici. Usa come punto di partenza gli obiettivi attuali del team per p99 ed errori. Annota quanta capacità aggiuntiva deve essere utilizzabile rispettando quegli obiettivi e quali casi tollerano un recupero più lento. Se il sistema li rispetta solo con un tasso elevato di accessi serviti dalla cache, usa tracce di giorni particolarmente intensi per verificare se quel tasso regge nel traffico di produzione.
Calcola tutto il costo del riuso
I DIMM disponibili possono rendere conveniente la voce memoria in un preventivo. Restano i costi del dispositivo di espansione, di un host o aggiornamento supportato, dei moduli qualificati e del lavoro di distribuzione e assistenza. Il dispositivo richiede anche uno slot o un collegamento alla piattaforma adeguato. Confronta le linee PCIe previste con quelle necessarie a storage, rete e acceleratori. Un aumento di memoria può convenire meno se sottrae risorse che lo stesso carico usa per spostare i dati.
Calcola il costo per GiB utilizzabile al livello di servizio richiesto. Includi la capacità riservata alla piattaforma o sacrificata per mantenere abbastanza pagine in locale, oltre ad alimentazione, raffreddamento, qualificazione della flotta, ricambi e assistenza per la durata prevista. Controlla chi fornisce aggiornamenti del firmware e come il sistema espone stato ed errori della memoria. Se il nuovo livello permette a un host di svolgere lo stesso lavoro che altrimenti finirebbe sullo storage o richiederebbe un’altra macchina, misura il lavoro risparmiato e includi il costo aggiuntivo delle due opzioni. Puoi rendere il confronto concreto eseguendo il servizio alla frequenza di picco delle richieste su entrambe e confrontando quanto costa mantenere i tempi entro l’obiettivo.
Dopo SC26, cerca configurazioni qualificate, supporto documentato per i moduli, compatibilità software e tracce di carichi effettivi. Un sistema in commercio potrebbe dare ai team con molti dati consultati meno spesso un altro modo per espandere un server esistente. Un esempio convincente sarebbe un servizio che tiene più documenti in memoria host, evita letture ripetute dallo storage e rimane entro il limite p99 precedente a un costo inferiore. Un team con quel risultato avrebbe un criterio d’acquisto da applicare al server successivo.
Fonti
- Anteprima SC26 di Netlist del CXL Consortium, 10 novembre 2026
- Annuncio SC26 di Marvell su partner e connettività, 13 novembre 2026
- Programma del padiglione SC26 del CXL Consortium e immagini dell’evento
- Kit stampa della famiglia Marvell Structera
- Programma ufficiale SC26 e date dell’esposizione
- Studio MELODY e dati della pubblicazione, ASPLOS 2025 · Articolo completo
Per conservare insieme appunti del pilota, tracce dei carichi e decisioni d’acquisto, crea un account Telli.sh.