De la DDR4 réemployée peut-elle donner plus de marge à un serveur d’IA ?
Netlist et Marvell préparent pour SC26 des démonstrations CXL faisant appel à la DDR4. Découvrez où cette mémoire hôte supplémentaire pourrait aider et quoi mesurer avant d’acheter.
Un service de recherche interne paraît rapide jusqu’au pic du matin. Avant d’envoyer une demande de réponse au GPU, il faut extraire des passages parmi des milliers de documents. Les plus consultés tiennent en mémoire, mais les recherches répétées dans le reste de la collection retournent au stockage. Les utilisateurs attendent alors que l’accélérateur dispose encore de capacité. Pour l’équipe qui exploite le service, agrandir le cache du serveur peut apporter davantage qu’ajouter un GPU.
Deux annonces avant SC26 esquissent une autre façon de constituer ce cache. Le 10 novembre, le consortium CXL a annoncé que Netlist, spécialiste de la mémoire, comptait présenter une preuve de concept appelée NVvault-D4. Celle-ci rend de la DDR4 existante accessible comme extension de mémoire hôte via Compute Express Link, ou CXL. Le 13 novembre, le fabricant de puces Marvell a annoncé des démonstrations de partenaires utilisant ses contrôleurs d’extension Structera X avec de la DDR4 et de la DDR5. Ces annonces décrivent du matériel destiné à être présenté. Les prix, les dates de livraison et les résultats des démonstrations prévues restent ouverts. SC26 se tient à Chicago du 15 au 20 novembre, avec les expositions régulières du 17 au 19 novembre, heure locale. Présentation de Netlist par le consortium CXL · Annonce SC26 de Marvell · Dates officielles de SC26
Pour l’acheteur, la question est de savoir si cette capacité supplémentaire garde en mémoire une part suffisante des données de travail tout en maintenant les requêtes les plus lentes dans des délais acceptables. Si l’équipe dispose de DDR4 inutilisée, sa réutilisation peut être intéressante si les barrettes sont qualifiées et si le système sait y placer les bonnes données. L’intérêt dépend de ce qui attend aujourd’hui et de l’endroit où l’attente se produit.
Où se place la mémoire supplémentaire ?
Un processeur accède directement à sa DRAM locale via son contrôleur mémoire. Avec un serveur et un dispositif d’extension compatibles, il peut aussi accéder à la mémoire derrière ce dispositif sur une liaison CXL. L’extension offre un espace supplémentaire pour les données côté hôte. Son chemin d’accès, son débit et sa latence diffèrent de ceux des canaux de DRAM locale. Le micrologiciel et le système d’exploitation doivent exposer cette capacité. L’application ou le système doit ensuite appliquer une politique de placement des pages adaptée à la charge.
C’est important quand on envisage d’utiliser un stock de DDR4 dans un serveur récent. Celui-ci peut garder sa DDR5 locale et accéder à la DDR4 par l’intermédiaire d’un dispositif d’extension pris en charge. Le contrôleur, la qualification des barrettes et la compatibilité de l’hôte comptent toujours. Une preuve de concept utilisant de la DDR4 existante donne une raison d’étudier le réemploi. Elle ne précise pas encore quelles barrettes seraient validées ni quels systèmes pourraient les exploiter de façon fiable.
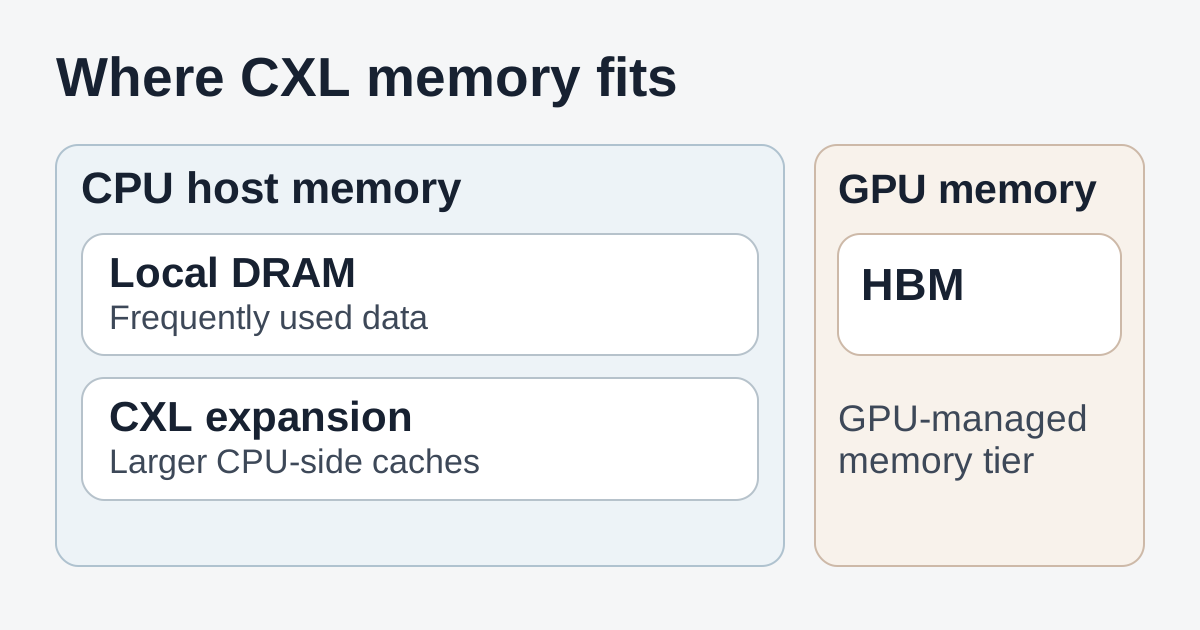
Les pages les plus consultées peuvent rester en DRAM locale, tandis que l’extension accueille des caches plus volumineux côté processeur. La mémoire à haute bande passante de l’accélérateur a ses propres limites de capacité et de débit.
Dans l’exemple du moteur de recherche, l’équipe pourrait garder les données d’index souvent lues en DDR5 locale et déplacer un cache plus grand de passages ou de résultats moins consultés vers le niveau CXL. Une fois les passages trouvés, le service d’inférence les transmet au modèle sur le GPU. Les poids et les données nécessaires au code exécuté par l’accélérateur doivent toujours tenir à l’endroit où le moteur d’inférence s’attend à les lire. L’extension CXL de ces annonces augmente la capacité côté hôte. La mémoire à haute bande passante du GPU, dite HBM, reste une ressource distincte.
Commencez par relever où les requêtes passent leur temps. Si le processeur attend souvent des données évincées du cache, davantage de mémoire hôte peut éviter des accès au stockage. Si le modèle passe surtout son temps à lire des poids dans la mémoire du GPU et que l’hôte attend rarement, le même achat peut avoir peu d’effet sur le délai de réponse. Accélérer la recherche peut compter même si le modèle tourne à la même vitesse. Mesurez les deux avant d’attribuer un changement du service à l’un d’eux.
Trois prototypes Netlist pour trois usages
Le NVvault-D4 est la conception Netlist à suivre pour le réemploi de DDR4. Le consortium cite les machines virtuelles, les bases en mémoire, le calcul haute performance et les charges d’entreprise. Un hôte de virtualisation donne un exemple concret. Les invités les plus actifs pourraient rester en mémoire locale, pendant que l’équipe teste le placement de pages moins actives dans l’extension. Une équipe base de données pourrait essayer la même approche sur une partie du cache de lecture. Il faudrait alors garder près du processeur les pages utilisées par les requêtes sensibles à la latence. Ces usages sont des pistes d’essai pour cette extension. L’annonce ne donne aucun résultat sur une charge réelle. Présentation de Netlist par le consortium CXL
Les deux autres conceptions Netlist montrent l’importance de distinguer les références. Le NVvault-HM utilise de la DRAM comme cache devant une capacité adossée à de la NAND. L’annonce évoque les déplacements de données et la télémétrie, notamment pour les caches clés-valeurs d’IA et l’analyse de données. Le NVvault-PM relève d’une autre conception CXL de type 3. Elle associe DRAM, sauvegarde sur NAND et source d’énergie embarquée pour gérer les pertes d’alimentation. L’annonce l’envisage notamment pour conserver le cache clés-valeurs, créer des points de reprise et restaurer les services. Une équipe qui étudie la sauvegarde ou la persistance doit obtenir des précisions sur cette conception dans ses propres scénarios de panne. L’annonce du D4 ne lui attribue aucun de ces mécanismes de stockage ou de reprise. Présentation de Netlist par le consortium CXL
Le cache clés-valeurs d’un modèle de langage donne un autre exemple d’essai. Il contient les données d’attention des jetons précédents pour permettre leur réutilisation. Un moteur d’inférence qui prend en charge le déport vers l’hôte pourrait déplacer les pages de sessions inactives hors de la mémoire GPU et les recharger à leur retour. L’équipe peut tester si la capacité hôte permet de conserver plus de sessions et quel délai les transferts ajoutent à une requête reprise. Le placement et les copies dépendent du moteur et du serveur. Ce scénario illustre un essai possible avec plusieurs niveaux de mémoire hôte. Dans cette annonce, Netlist associe explicitement les caches clés-valeurs aux modèles HM et PM.
L’annonce de Marvell offre une deuxième voie à suivre. Ses partenaires prévoient de montrer des systèmes qui utilisent des contrôleurs Structera X avec de la DDR4 et de la DDR5. Le programme et le dossier de presse renseignent sur l’exposition et la gamme. Les acheteurs devront vérifier les configurations que le fournisseur qualifie, les mémoires acceptées et l’assistance disponible pour le système complet. Les photos de puces du dossier illustrent la famille de composants. Programme du pavillon SC26 du consortium CXL · Annonce SC26 de Marvell · Dossier de presse Marvell Structera
Mesurez d’abord les requêtes lentes
La moyenne peut masquer les requêtes qui rendent un service lent aux yeux des utilisateurs. Dans un moteur de recherche, les documents populaires donnent des résultats rapides toute la journée, tandis que les documents moins courants obligent les mêmes processus à consulter souvent l’extension. Des requêtes très lentes peuvent être acceptables dans un traitement d’indexation nocturne. Une personne qui attend un résultat les remarquera aussitôt. L’organisation de la mémoire doit satisfaire l’objectif du service à la charge de pointe.
L’étude indépendante MELODY l’a illustré en 2025. L’évaluation couvre 265 charges, quatre dispositifs de mémoire CXL réels, cinq plateformes CPU et sept niveaux de latence. Les auteurs ont étudié la sensibilité dans une plage inférieure à la microseconde, de 140 à 410 nanosecondes. La charge, les temps des opérations les plus lentes et le comportement du processeur influencent les résultats. Le papier nomme les extensions testées CXL-A à CXL-D. Il ne fournit aucune estimation pour les systèmes annoncés à SC26. Il montre pourquoi une latence moyenne ou un benchmark favorable ne suffisent pas à prédire les performances d’un serveur précis. Étude MELODY présentée à ASPLOS 2025 · Article intégral
Prévoyez trois comparaisons si la plateforme s’y prête. Reproduisez d’abord le service sur sa DRAM locale actuelle. Testez ensuite une capacité supérieure avec la mémoire hôte répartie sur plusieurs niveaux. Enfin, prenez une configuration tout en mémoire locale offrant la même capacité totale comme référence. À titre d’exemple de dimensionnement, comparez 256 Gio de DRAM locale et 256 Gio d’extension utilisable à 512 Gio de DRAM locale. Gardez des conditions comparables pour l’application, les données, les réglages et la charge envoyée. Relevez les différences de plateforme ou de canaux locaux imposées par les configurations. Si l’autre option est de déborder sur le stockage ou de répartir les données sur un deuxième hôte, mesurez aussi son coût et son temps de réponse.
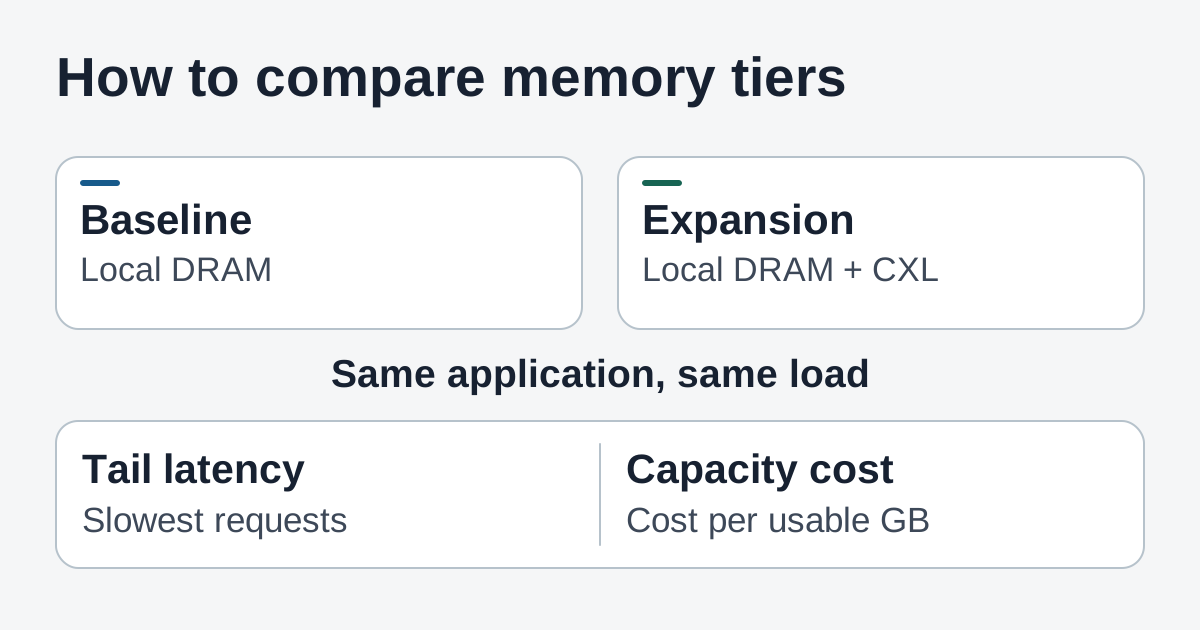
Comparez la même charge et le même trafic. Contrôlez les requêtes les plus lentes et calculez le coût de chaque unité de capacité utilisable.
- Rejouez le trafic qui remplit le cache. Utilisez un mélange réaliste de requêtes, avec des documents recherchés souvent et rarement. Testez après un démarrage à froid, puis quand les caches sont chauds. À concurrence identique, suivez la médiane, les latences p95 et p99, le taux d’erreur et le débit. Pour une recherche par IA, mesurez séparément la recherche documentaire et l’inférence pour éviter qu’un gain masque un ralentissement de l’autre étape.
- Vérifiez quelles données ont bougé. Examinez les allocations par niveau et par nœud NUMA, les migrations, la récupération de pages et les compteurs de lien ou de périphérique que fournit la plateforme. Un essai apparemment bon peut avoir gardé presque toutes les requêtes en DRAM locale. Un essai apparemment mauvais peut avoir placé par défaut les pages d’index sollicitées sur le niveau distant. Associez la politique de placement à chaque série de mesures.
- Simulez un après-midi chargé. Lancez un deuxième traitement pendant que le service interactif est occupé. Réchauffez le cache après un redémarrage et observez le comportement à l’approche des limites mémoire. Vérifiez comment le système signale les erreurs mémoire ou de périphérique, comment les opérateurs identifient l’hôte concerné et comment rétablir la politique d’allocation précédente. Intégrez la récupération à tout essai d’une configuration qu’il faudra exploiter.
- Fixez les critères avant de regarder les résultats. Partez des seuils p99 et d’erreur actuels. Précisez quelle capacité supplémentaire doit rester utilisable à ce niveau de service et quels cas tolèrent une reprise plus lente. Si les objectifs ne sont atteints qu’avec un taux élevé de succès du cache, vérifiez avec les traces de journées chargées que ce taux se maintient en production.
Comptez le coût complet du réemploi
Des barrettes DIMM déjà disponibles peuvent réduire le poste mémoire du devis. Il faut encore un dispositif d’extension, un hôte pris en charge ou une mise à niveau, des barrettes qualifiées et du temps pour le déploiement et l’assistance. Le dispositif nécessite aussi un emplacement ou un raccordement compatible. Vérifiez la distribution prévue des lignes PCIe entre stockage, réseau et accélérateurs. L’ajout de mémoire perd de son intérêt s’il retire les ressources dont la même charge a besoin pour déplacer les données.
Calculez le coût par Gio utilisable au niveau de service requis. Incluez la capacité réservée par la plateforme ou sacrifiée pour garder assez de pages en local, ainsi que l’énergie, le refroidissement, la qualification du parc, les pièces de rechange et l’assistance sur la durée prévue. Identifiez qui fournit les mises à jour du micrologiciel et comment consulter l’état du système et ses erreurs mémoire. Si ce niveau permet de traiter le volume qui aurait autrement débordé sur le stockage ou demandé une machine de plus, quantifiez le travail évité et les dépenses des deux options. Pour une comparaison simple, faites tourner le service au pic de requêtes sur les deux architectures. Comparez le coût pour rester dans l’objectif de temps de réponse.
Après SC26, recherchez les configurations qualifiées, les barrettes documentées, la compatibilité logicielle et les mesures sur de vraies charges. Un système commercialisé donnerait aux équipes ayant un gros volume de données de travail secondaires une façon d’agrandir un serveur en place. Le meilleur exemple serait un service qui garde davantage de documents en mémoire hôte, évite des lectures de stockage répétées et reste sous son seuil p99 à moindre coût. Ce résultat fournirait un argument d’achat réutilisable pour le serveur suivant.
Sources
- Annonce du consortium CXL sur Netlist à SC26, 10 novembre 2026
- Annonce de Marvell sur les partenaires et l’interconnexion à SC26, 13 novembre 2026
- Programme du pavillon du consortium CXL et visuels de SC26
- Dossier de presse de la gamme Marvell Structera
- Dates officielles du programme et des expositions de SC26
- Étude MELODY et publication à ASPLOS 2025 · Article intégral
Pour réunir vos notes d’essai, vos traces de charge et vos décisions d’achat, créez un compte Telli.sh.