¿Puede la DDR4 reutilizada darle más margen a un servidor de IA?
Netlist y Marvell preparan para SC26 demostraciones de CXL con DDR4. Descubre dónde puede ayudar la memoria de host adicional y qué medir antes de comprar.
Un servicio de búsqueda interna parece rápido hasta la hora punta de la mañana. Tiene que recuperar pasajes de miles de documentos antes de enviar una solicitud de respuesta a una GPU. Los pasajes de uso frecuente caben en memoria, pero las búsquedas repetidas en el resto de la colección vuelven al almacenamiento. La gente espera aunque el acelerador tenga capacidad libre. Para el equipo que opera el servicio, ampliar la caché del servidor podría aportar más que sumar otra GPU.
Dos anuncios previos a SC26 apuntan a otra manera de crear esa caché. El 10 de noviembre, el consorcio CXL anunció que el especialista en memoria Netlist planeaba mostrar NVvault-D4, una prueba de concepto que permite usar DDR4 existente como memoria de host ampliada mediante Compute Express Link, o CXL. El 13 de noviembre, el fabricante de chips Marvell anunció demostraciones de socios con sus controladores de expansión Structera X y memorias DDR4 y DDR5. Los anuncios describen hardware destinado a una exposición y dejan abiertos el precio, las fechas de entrega y los resultados de las demostraciones previstas. SC26 se celebra del 15 al 20 de noviembre en Chicago, con exposiciones regulares del 17 al 19, hora local. Avance de Netlist del consorcio CXL · Anuncio de Marvell para SC26 · Fechas oficiales de SC26
Para quien compra, la cuestión es si la capacidad extra permite mantener suficientes datos de una carga útil en memoria sin que las peticiones más lentas tarden demasiado. Si el equipo dispone de DDR4 sin usar, reutilizarla podría mejorar los costes si los módulos están validados y el sistema puede colocar allí los datos adecuados. El valor depende de qué espera hoy y de dónde se produce la espera.
Dónde entra la memoria adicional
Una CPU accede de forma directa a su DRAM local mediante el controlador de memoria. Si el servidor y el dispositivo de ampliación son compatibles, también puede acceder a la memoria del dispositivo por un enlace CXL. La ampliación ofrece espacio para guardar datos del lado del host. Su ruta, su ancho de banda y su latencia difieren de los canales de DRAM local. El firmware y el sistema operativo tienen que exponer la capacidad. La aplicación o el sistema operativo debe aplicar una política de colocación de páginas adecuada a la carga.
Esto importa al plantearse usar DDR4 de existencias en un servidor más nuevo. El servidor puede conservar su DDR5 local y acceder a la DDR4 mediante un dispositivo de ampliación compatible. Siguen importando el controlador, la validación de los módulos y la compatibilidad con el host. Una prueba de concepto con DDR4 existente da un motivo para investigar su reutilización. Queda por ver qué módulos admitiría una configuración con soporte y en qué sistemas funcionarían de manera fiable.
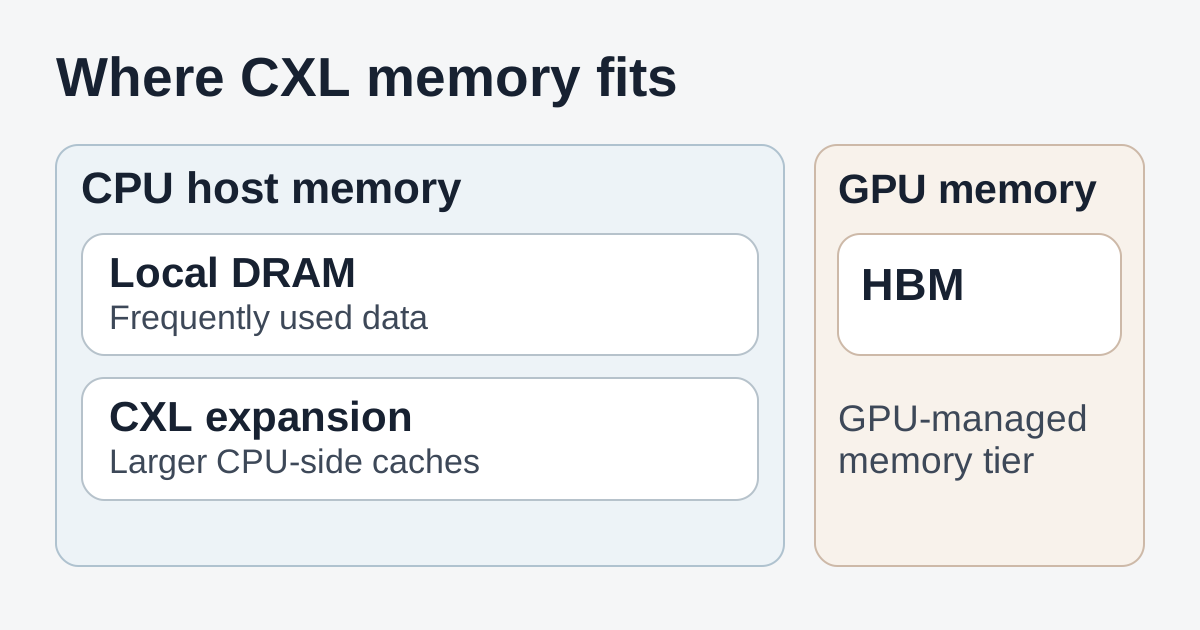
La DRAM local puede alojar páginas de acceso frecuente, y la ampliación puede contener cachés más grandes del lado de la CPU. La memoria de alto ancho de banda del acelerador tiene sus propios límites de capacidad y ancho de banda.
En el ejemplo de búsqueda, el equipo podría mantener los datos del índice que lee con frecuencia en DDR5 local y trasladar una caché más grande de pasajes o resultados menos consultados a la memoria CXL. Cuando el servicio encuentra los pasajes, el motor de inferencia los pasa al modelo que se ejecuta en la GPU. Los pesos y los datos que necesita el código del acelerador deben seguir cabiendo donde el motor de inferencia espera acceder a ellos. La ampliación CXL de estos anuncios aborda la capacidad de memoria del host. La memoria de alto ancho de banda de la GPU, conocida como HBM, sigue siendo un recurso separado.
Empieza con una traza de dónde pasan el tiempo las peticiones. Si la CPU espera a menudo datos expulsados de la caché, más memoria del host puede evitar accesos al almacenamiento. Si el modelo pasa la mayor parte del tiempo leyendo pesos de la memoria de GPU y el host apenas sufre esperas, la misma compra podría aportar poco al tiempo de respuesta. Una recuperación de documentos más rápida puede importar aunque el modelo siga a la misma velocidad. Mide ambas etapas antes de atribuir el cambio del servicio a una de ellas.
Tres prototipos de Netlist para tareas distintas
NVvault-D4 es el que conviene seguir para reutilizar DDR4. El consorcio cita las máquinas virtuales, las bases de datos en memoria, la computación de alto rendimiento y las cargas empresariales. Un host de virtualización ofrece un caso concreto. Las máquinas invitadas más activas podrían quedarse en memoria local mientras el equipo prueba si las páginas menos utilizadas caben en la ampliación. El equipo de bases de datos podría aplicar la misma idea a parte de una caché de lectura. Necesitaría una política de asignación que mantenga cerca de la CPU las páginas de las consultas sensibles a la latencia. Son posibles pruebas para este diseño de ampliación. El anuncio no aporta resultados de cargas reales. Avance de Netlist del consorcio CXL
Los otros dos diseños de Netlist muestran por qué importa distinguir los nombres. NVvault-HM utiliza DRAM como caché delante de capacidad respaldada por NAND. El anuncio habla de migración de datos, telemetría y usos como cachés de claves y valores para IA y análisis de datos. NVvault-PM es un diseño distinto de CXL de tipo 3 que combina DRAM, copia de respaldo en NAND y una fuente de energía integrada para afrontar cortes de alimentación. El anuncio lo plantea para conservar cachés de claves y valores, guardar puntos de control y acelerar la recuperación. Un equipo que valore copias o persistencia necesita datos sobre ese diseño concreto en sus condiciones de fallo. El anuncio de D4 no le atribuye el comportamiento de almacenamiento o recuperación de esos otros diseños. Avance de Netlist del consorcio CXL
La caché de claves y valores de un modelo de lenguaje ofrece otro ejemplo de prueba. Guarda los datos de atención de los tokens anteriores para poder reutilizarlos. Un motor de inferencia que permita descargar datos a la memoria del host podría sacar de la memoria de GPU las páginas de caché de las sesiones inactivas y recargarlas al volver. El equipo puede comprobar si la capacidad del host permite conservar más sesiones y cuánto retraso añaden las transferencias a una solicitud reanudada. La colocación y las copias dependen del motor y del servidor. El ejemplo ilustra un posible ensayo con varios niveles de memoria de host. En este anuncio, Netlist relaciona explícitamente la caché de claves y valores con HM y PM.
El anuncio de Marvell aporta una segunda línea de implementación. Sus socios planean mostrar sistemas que utilizan controladores Structera X con DDR4 y DDR5. El programa y el dossier de prensa explican la exposición y la familia de componentes. Quien compre tendrá que averiguar qué configuraciones del servidor valida el proveedor, qué memoria admiten y cómo se presta soporte al sistema completo. Las fotos de chips del dossier sirven como referencia de la familia de productos. Programa del pabellón del consorcio CXL en SC26 · Anuncio de Marvell para SC26 · Dossier de prensa de Marvell Structera
Mide primero las solicitudes lentas
Una media puede ocultar las peticiones que hacen que el servicio se sienta lento. En una búsqueda, los documentos populares pueden dar aciertos rápidos todo el día mientras los menos consultados llevan los mismos procesos repetidamente a la memoria ampliada. Un aumento de las peticiones lentas puede ser aceptable en un proceso nocturno de indexado. Una persona que espera un resultado de búsqueda podría notarlo de inmediato. El diseño de memoria debe cumplir el objetivo real del servicio en horas punta.
El estudio independiente MELODY mostró esto en 2025. Abarcó 265 cargas, cuatro dispositivos reales de memoria CXL, cinco plataformas de CPU y siete niveles de latencia. Estudió la sensibilidad en un rango inferior a un microsegundo, de 140 a 410 nanosegundos. La carga, la latencia de las peticiones más lentas y el comportamiento de la CPU influyeron en los resultados. El artículo llama CXL-A a CXL-D a los expansores probados. Sus resultados no estiman el rendimiento de los sistemas anunciados para SC26. El estudio permite entender por qué una latencia media o un benchmark favorable no bastan para anticipar el rendimiento de un servidor concreto. Estudio MELODY de ASPLOS 2025 · Artículo completo
Planifica tres comparaciones si la plataforma lo permite. Primero reproduce el servicio en su DRAM local actual. Después prueba más capacidad con varios niveles de memoria de host. Por último, usa una configuración totalmente local con la misma capacidad total como referencia. Como ejemplo de dimensionamiento, compara 256 GiB de DRAM local más 256 GiB de ampliación utilizable con 512 GiB de DRAM local. Mantén comparables la aplicación, los datos, los ajustes y la carga enviada. Anota las diferencias de plataforma o canales locales que impongan las configuraciones. Si la alternativa operativa es usar el almacenamiento al llenarse la memoria o repartir los datos entre varios hosts, mide también su coste y su tiempo de respuesta.
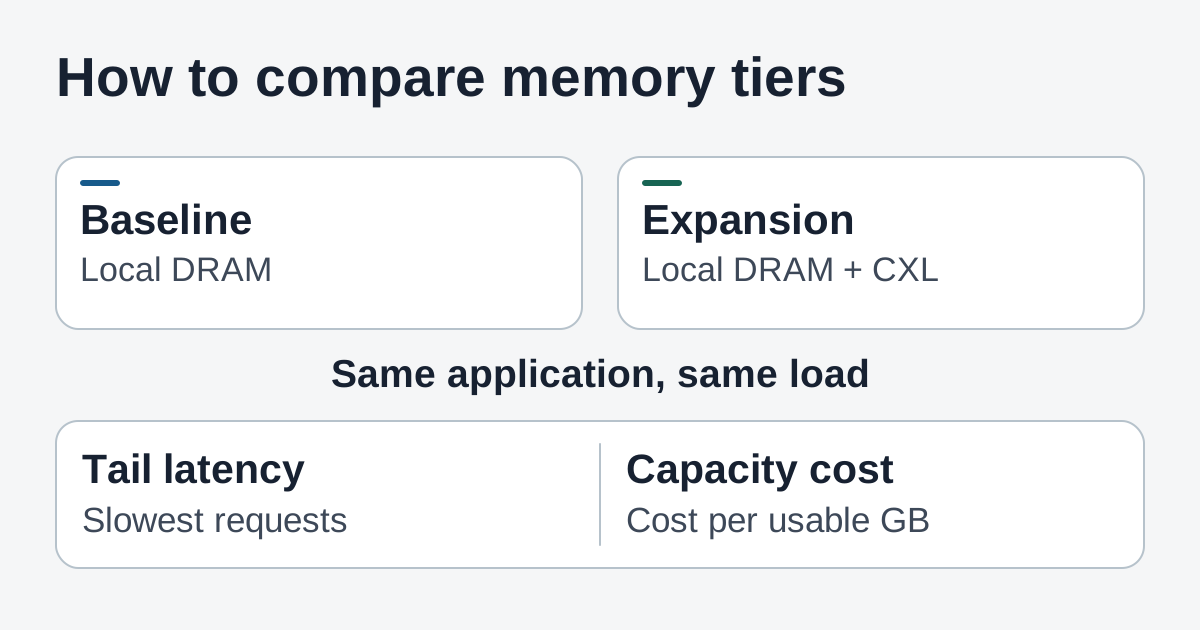
Mantén la misma carga y el mismo tráfico. Comprueba las peticiones más lentas y calcula cuánto cuesta cada unidad de capacidad utilizable.
- Reproduce tráfico que llene la caché. Usa una mezcla realista de peticiones de documentos frecuentes y poco consultados. Prueba desde un arranque en frío y con las cachés calientes. Mide la mediana, p95 y p99, la tasa de errores y el rendimiento con la misma concurrencia. Para una aplicación de búsqueda con IA, mide por separado la recuperación y la inferencia para que una caché más rápida no oculte que el modelo se ha ralentizado, o viceversa.
- Comprueba qué datos cambiaron de sitio. Examina las asignaciones por nivel y nodo NUMA de CPU, la migración y recuperación de páginas donde estén disponibles y los contadores de enlace o dispositivo de la plataforma. Una prueba aparentemente buena pudo resolver casi todas las peticiones con DRAM local. Otra que parezca mala pudo colocar de forma predeterminada las páginas más usadas del índice en la memoria remota. Registra la política de colocación junto a cada grupo de mediciones.
- Simula una tarde de mucho trabajo. Ejecuta un segundo proceso mientras el servicio interactivo está ocupado, calienta la caché tras reiniciar y observa qué ocurre cerca de los límites de memoria. Verifica cómo comunica el sistema los errores de memoria o en el dispositivo, cómo se identifica el host afectado y cómo vuelve el servicio a la política de asignación anterior. Incluye la recuperación en cualquier prueba de una configuración que el equipo vaya a operar.
- Fija los criterios antes de mirar los gráficos. Usa como punto de partida los objetivos actuales de p99 y de errores. Especifica cuánta capacidad adicional debe ser utilizable con ese nivel de servicio y qué casos pueden tolerar una recuperación más lenta. Si el sistema solo cumple con una tasa alta de aciertos de caché, utiliza trazas de días especialmente cargados para comprobar si esa tasa se mantiene en producción.
Cuenta el coste total de reutilizar la memoria
Los DIMM existentes pueden mejorar la partida de memoria del presupuesto. Aun así, hacen falta un dispositivo de expansión, un host compatible o una actualización, módulos validados y tiempo para desplegar y mantener la solución. El dispositivo necesita una ranura o una conexión de plataforma apropiada. Comprueba cómo se repartirán los carriles PCIe entre el almacenamiento, la red y los aceleradores. La ampliación pierde atractivo si resta recursos que esa misma carga necesita para mover datos.
Calcula el coste por GiB utilizable con el nivel de servicio requerido. Incluye la capacidad que reserva la plataforma o la que se sacrifica para conservar suficientes páginas en memoria local, además del consumo, la refrigeración, la validación de la flota, los repuestos y el soporte durante la vida prevista. Comprueba quién proporciona actualizaciones de firmware y cómo se consultan el estado y los errores de memoria. Si este nivel permite resolver en un host lo que antes desbordaba al almacenamiento o exigía otra máquina, mide el trabajo evitado y contabiliza los costes de ambas opciones. Una comparación sencilla consiste en ejecutar el servicio con su máximo ritmo de solicitudes en las dos arquitecturas y comparar el coste de cumplir el tiempo de respuesta objetivo.
Tras SC26, busca configuraciones validadas, soporte de módulos documentado, compatibilidad de software y trazas de cargas reales. Un sistema comercializado podría dar a los equipos con muchos datos secundarios otra manera de ampliar un servidor existente. El mejor ejemplo sería un servicio que conserve más documentos en el host, evite lecturas repetidas del almacenamiento y mantenga su antiguo límite p99 con un coste menor. Demostrar ese resultado daría un argumento de compra reutilizable en el siguiente servidor.
Fuentes
- Avance de Netlist en SC26 del consorcio CXL, 10 de noviembre de 2026
- Anuncio de Marvell sobre socios y conectividad en SC26, 13 de noviembre de 2026
- Programa y material visual del pabellón del consorcio CXL en SC26
- Dossier de prensa de la familia Marvell Structera
- Fechas oficiales del programa y las exposiciones de SC26
- Estudio MELODY y datos de publicación en ASPLOS 2025 · Artículo completo
Para reunir las notas del piloto, las trazas de carga y las decisiones de compra, crea una cuenta de Telli.sh.