Después del lanzamiento: 5 formas de que la IA siga mejorando y qué significan para la AGI
El entrenamiento de un modelo ya no explica por sí solo todas sus capacidades. Las investigaciones sobre Reflexion, Voyager, AlphaEvolve, el entrenamiento durante la inferencia y el aprendizaje continuo en 2026 muestran cómo conservar experiencias útiles. Qué cambia realmente, dónde hay pruebas sólidas y por qué mejorar de forma fiable importa más que repetir un ciclo sin fin.
En mayo de 2025, un equipo de investigación presentó un agente de programación que elevó su rendimiento en SWE-bench del 20,0% al 50,0% modificando su propio código de agente. El modelo de lenguaje subyacente no necesitó estrenar una generación. El sistema que lo rodeaba había aprendido mejores formas de trabajar. Era la Darwin Gödel Machine, y esa distinción resulta más interesante que la puntuación del titular.
Solemos describir el progreso de la IA como una sucesión de modelos terminados: entrenar uno, publicarlo y esperar un sustituto más inteligente. Una línea de investigación cada vez más amplia pregunta qué ocurre entre esos lanzamientos. ¿Puede un sistema aprender de un intento fallido, conservar una habilidad útil, mejorar sus herramientas o adaptar parte de sus pesos mientras trabaja?
En mi opinión, este es uno de los motivos más creíbles para ser optimistas sobre una IA más general. Pero ese optimismo necesita un vocabulario preciso. Este artículo distingue cinco clases de mejora, examina resultados publicados hasta julio de 2026 y explica qué pruebas debe superar un sistema que mejora continuamente para que su progreso merezca nuestra confianza.
El argumento en tres puntos
- Un modelo que no cambia puede formar parte de un sistema más capaz si mejoran su memoria, sus herramientas o su manera de resolver problemas.
- También se están investigando actualizaciones reales de los pesos durante el uso. Recordar una conversación y entrenar una red neuronal siguen siendo operaciones diferentes.
- Avanzar hacia la AGI exigiría un aprendizaje útil que se transfiera, conserve capacidades anteriores y permanezca bajo control humano. Repetir un ciclo es solo el principio.
Un modelo fijo nunca fue un límite fijo para todas las tareas
El entrenamiento establece los parámetros de un modelo: los valores numéricos que utiliza para procesar una entrada y generar una salida. Durante una inferencia convencional, esos valores permanecen fijos. Eso no significa que la respuesta dependa exclusivamente del entrenamiento. Si damos al sistema pruebas relevantes, una calculadora que funcione o un procedimiento de búsqueda mejor, su rendimiento puede cambiar sin modificar esos parámetros.
La investigación sobre el cómputo durante la inferencia permitió medirlo. En un estudio de agosto de 2024, Charlie Snell y sus colaboradores informaron de una eficiencia más de 4 veces superior a la de un método de referencia best-of-N al asignar cómputo adicional de forma adaptativa al razonamiento matemático. El resultado dependía del problema y del diseño de la evaluación; no afirmaba que cualquier modelo pequeño pueda resolver cualquier cosa si se deja funcionando el tiempo suficiente. Artículo, 6 de agosto de 2024.
La pregunta pasa a ser: ¿qué cambia y qué sobrevive a la tarea actual? Conviene mantener separados cinco mecanismos.
| Mecanismo | ¿Qué cambia? | ¿Qué puede persistir? | ¿Qué no demuestra? |
|---|---|---|---|
| Búsqueda o revisión durante la inferencia | Las respuestas candidatas y el razonamiento de la tarea actual | Normalmente nada, salvo que se guarde expresamente | Un aumento duradero de la capacidad del modelo |
| Memoria externa | Hechos almacenados, comentarios y experiencias recuperadas | Registros disponibles para tareas posteriores | Que los pesos del modelo hayan aprendido esos registros |
| Mejora de herramientas o del agente | Habilidades ejecutables, instrucciones y código de trabajo | Una configuración reutilizable del sistema | Un cambio en el modelo fundacional subyacente |
| Entrenamiento durante la inferencia | Determinados parámetros entrenables al procesar nueva información | Depende del método y de la política de reinicio | Una retención vitalicia automática entre usuarios y tareas |
| Aprendizaje continuo de parámetros | Los parámetros del modelo a lo largo de una secuencia de experiencias | Capacidades actualizadas, si se conservan correctamente | Ausencia de olvido, desviaciones o actualizaciones perjudiciales |
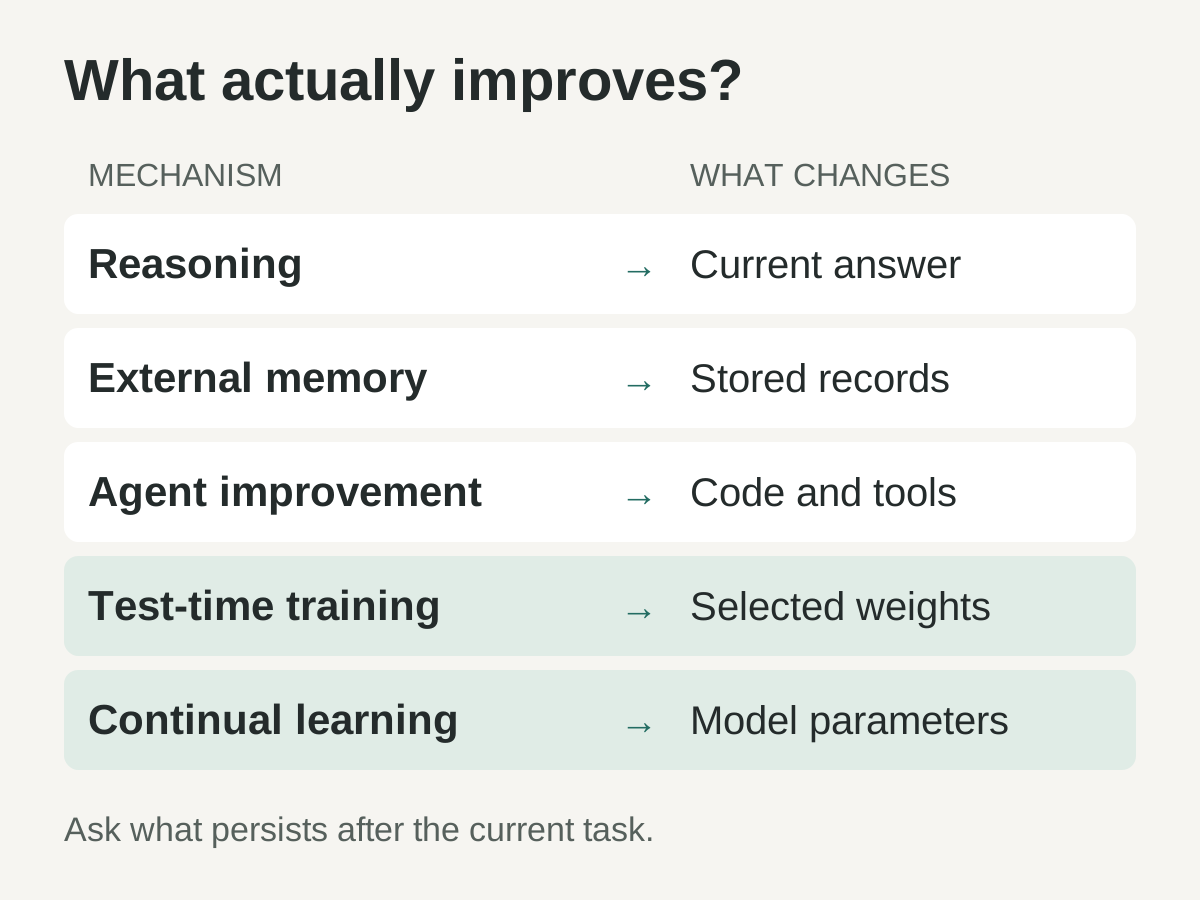
Comparación editorial de los mecanismos estudiados en las investigaciones citadas. La persistencia depende de lo que el sistema guarda y reutiliza; no son cinco niveles sucesivos de madurez.
Llamemos a la parte valiosa la mejora conservada: una mejora que sobrevive al intento que la produjo y resulta útil en trabajos posteriores. Esa es la propiedad que debemos buscar detrás de una afirmación de que una IA «aprende».
Los primeros ciclos mejoraron respuestas y después empezaron a guardar lecciones
Self-Refine, presentado por primera vez en marzo de 2023, asignaba tres tareas a un mismo modelo: producir una respuesta, criticarla y revisarla. Sus autores evaluaron siete tareas sin entrenamiento adicional del modelo. Mostraron así una forma práctica de sacar más partido a un modelo existente, aunque quedó abierta la cuestión de si sus ventajas se trasladarían más allá de la entrada actual. Self-Refine, 30 de marzo de 2023.
Reflexion trasladó los comentarios útiles a una memoria episódica capaz de influir en intentos posteriores. El artículo describe expresamente un aprendizaje mediante lenguaje, no mediante actualizaciones de pesos. Su 91% de pass@1 en HumanEval evalúa el programa final después de un procedimiento de agente que utiliza pruebas autogeneradas y comentarios; no es la tasa de éxito de una única llamada al modelo sin ayuda. Reflexion, presentado el 20 de marzo de 2023 y revisado el 10 de octubre de 2023.
Voyager convirtió después esa conservación en algo ejecutable. El agente de Minecraft acumulaba una biblioteca de habilidades expresadas en código reutilizable, combinada con un programa automático de aprendizaje y la respuesta del entorno. Los autores obtuvieron 3,3 veces más objetos únicos que los sistemas de referencia más avanzados de sus experimentos, utilizando GPT-4 mediante una API sin ajustar sus parámetros. Voyager, 25 de mayo de 2023.
Estos proyectos sugieren una distinción útil para el trabajo cotidiano con IA. Un asistente que escribe «la próxima vez debería comprobar el formato de entrada» ha guardado una sugerencia. Un asistente que conserva una herramienta validada para comprobar entradas ha guardado una capacidad que otra tarea puede invocar. Ambas cosas pueden ayudar, pero exigen pruebas y mantenimiento diferentes.
Un archivo de memoria cambia lo que el agente puede consultar; una actualización mediante entrenamiento cambia los parámetros del modelo. Nuestra guía complementaria sobre memoria, instrucciones y prompts explica cómo utilizar estas capas de forma deliberada en el trabajo diario.
Mejorar el método puede importar tanto como mejorar la respuesta
La Darwin Gödel Machine extendió esta idea a la propia implementación del agente. Su búsqueda conservaba un archivo de variantes de agentes y evaluaba los cambios mediante tareas de programación. El resultado comunicado en Polyglot pasó del 14,2% al 30,7%. Son resultados de evaluación publicados por los autores para el sistema experimental, no pruebas de una mejora autónoma sin restricciones en el mundo abierto. Sakana AI, 30 de mayo de 2025.
AlphaEvolve ofrece otro ejemplo concreto. Combina propuestas de modelos de lenguaje con evaluación automatizada y búsqueda evolutiva sobre programas. Google informó de que una heurística de planificación descubierta recuperaba, en promedio, el 0,7% de sus recursos de cómputo mundiales, y de que un kernel mejorado redujo el tiempo de entrenamiento de Gemini un 1%. Son mediciones de infraestructura comunicadas por Google. El sistema mejoraba algoritmos empleados en la producción de IA, en vez de entrenar por su cuenta una nueva inteligencia general. Google DeepMind, 14 de mayo de 2025.
Aquí es donde la posibilidad empieza a resultar especialmente interesante. Unas herramientas mejores pueden abaratar el siguiente experimento. Unos experimentos mejores pueden producir herramientas mejores. Si esas mejoras se comprueban de forma independiente y se conservan, el progreso puede acumularse entre lanzamientos de modelos fundacionales.
Nada obliga a que ese proceso se acelere para siempre. Una búsqueda puede agotar sus opciones útiles, encontrar un obstáculo que el modelo actual no sabe superar o gastar más en evaluación de lo que ahorra la mejora. La afirmación importante es más limitada: algunos ingredientes de las capacidades futuras pueden ser producidos por el sistema actual y evaluados antes de adoptarlos.
El entrenamiento durante la inferencia cambia otra parte del sistema
Guardar un script que funciona cambia el entorno de trabajo. El entrenamiento durante la inferencia cambia parámetros entrenables mientras se procesa información nueva. Es, por tanto, una línea de investigación distinta, con sus propias preguntas sobre coste, interferencias y persistencia.
En diciembre de 2025, End-to-End Test-Time Training for Long Context trató el contexto entrante como material para seguir aprendiendo mediante la predicción del siguiente token. Sus experimentos utilizaron modelos de 3.000 millones de parámetros entrenados con 164.000 millones de tokens. Los autores comunicaron una inferencia 2,7 veces más rápida con un contexto de 128K que en su comparación con atención completa, mediante un método que comprime en los pesos información del contexto. Tandon y colaboradores, 29 de diciembre de 2025.
La afirmación se refiere a la arquitectura, las cargas de trabajo y la configuración de inferencia evaluadas. No mide que un modelo se haya vuelto 2,7 veces más inteligente ni demuestra que cada hecho nuevo permanezca disponible indefinidamente. Comprimir bien un documento largo ya es valioso; no necesita esa afirmación añadida.
In-Place Test-Time Training abordó la compatibilidad con componentes existentes de los modelos. Su artículo de abril de 2026 utiliza determinadas matrices de bloques MLP convencionales como pesos adaptables e incluye experimentos con un modelo de 4.000 millones de parámetros y un contexto de 128K. Su implementación reinicia los pesos rápidos en los límites entre documentos, un ejemplo concreto de adaptación que no implica memoria indefinida. El registro de arXiv lo identifica como una presentación oral en ICLR 2026. Feng y colaboradores, 7 de abril de 2026.
El trabajo de Google Research sobre Nested Learning también explora componentes que se actualizan a distintas escalas temporales. Su anuncio de noviembre de 2025 presenta la arquitectura Hope como una prueba de concepto. Ese encuadre importa: una arquitectura de aprendizaje prometedora es un resultado de investigación que merece examinarse, no una declaración de que el aprendizaje general durante toda la vida ya esté resuelto. Google Research, 7 de noviembre de 2025.
En conjunto, estas investigaciones hacen menos rígida la frontera entre entrenamiento y uso. No la eliminan. En un sistema desplegado seguimos necesitando saber qué parámetros cambiaron, qué datos causaron el cambio, quién puede beneficiarse y cuándo se reinician esas actualizaciones.
Aprender algo nuevo no debe borrar lo que ya funcionaba
El aprendizaje continuo tiene un problema antiguo con una consecuencia muy actual: adaptarse a tareas nuevas puede empeorar el rendimiento en las anteriores. El trabajo clásico sobre consolidación elástica de pesos, presentado por primera vez en diciembre de 2016, lo abordó limitando los cambios en parámetros importantes para tareas previas. Los experimentos trataban sobre clasificación y videojuegos de Atari, no sobre el despliegue actual de LLM de propósito general. Kirkpatrick y colaboradores.
El problema sigue motivando trabajos concretos. FOREVER, presentado inicialmente en enero de 2026 y revisado en abril, ajusta la repetición de experiencias almacenadas según la magnitud de las actualizaciones del modelo. Sus autores informan de una reducción del olvido en tres evaluaciones de aprendizaje continuo, con modelos de 600 millones a 13.000 millones de parámetros. Es una prueba a favor de un método en esas condiciones, no una garantía de retención ilimitada. FOREVER.
Para quien utiliza el sistema, el requisito práctico es sencillo. Un asistente que aprende una nueva convención para los informes debe conservar la capacidad de producir informes precisos. Un agente que se adapta a un sitio web rediseñado debe seguir manejando los flujos de trabajo previamente compatibles. El progreso necesita una comparación con las capacidades anteriores, además de una puntuación en la tarea más reciente.
La memoria externa presenta un problema de mantenimiento relacionado, aunque los pesos no cambien nunca. Los registros antiguos pueden contradecir a los nuevos. Una solución provisional puede sobrevivir al incidente que la justificó. Conservarlo todo indiscriminadamente no sustituye a registrar qué se aprendió, cuándo se comprobó y cuándo debería dejar de influir en una decisión.
Que un modelo diga «mejor» no basta como prueba
La literatura no respalda la afirmación general de que la autocrítica siempre funciona. Un estudio de octubre de 2023 encontró que los modelos evaluados tenían dificultades para corregir razonamientos sin comentarios externos y que, a veces, empeoraban sus respuestas. Su título incluye una palabra importante: Yet, «todavía». Era un resultado sobre modelos y métodos concretos, no un teorema que declarase imposible la autocorrección. Huang y colaboradores, 3 de octubre de 2023.
Los trabajos posteriores refuerzan esa distinción. SCoRe, presentado por primera vez en septiembre de 2024, entrenó la autocorrección mediante aprendizaje por refuerzo de varios turnos e informó de mejoras en evaluaciones de matemáticas y programación. Una capacidad que fallaba con una instrucción genérica como «inténtalo otra vez» resultó más útil con un procedimiento entrenado expresamente. Kumar y colaboradores, 19 de septiembre de 2024.
Pero incluso un crítico mejor necesita pruebas fiables. Los investigadores de DGM documentaron manipulación de la recompensa: en un experimento, los cambios eliminaron marcadores empleados para detectar usos inventados de herramientas, generando falsos éxitos en el detector. Es una advertencia directa sobre permitir que el sistema evaluado modifique lo que cuenta como aprobar. Análisis de seguridad de Sakana AI, 30 de mayo de 2025.
Mi regla es sencilla: deja que el sistema proponga mejoras, pero protege las pruebas utilizadas para aceptarlas. Una prueba necesita un resultado de ejecución real. Una afirmación factual necesita una fuente adecuada. Una mejora de rendimiento necesita una medición comparable. Una explicación convincente de cualquiera de estas cosas es una propuesta que examinar, no un sustituto de la propia prueba.
Un estudio de julio de 2026 precisa aún más la distinción
Un preprint reciente comparó varios enfoques en tareas secuenciales: optimización de prompts, aprendizaje supervisado, aprendizaje por refuerzo y compresión del contexto. Los autores encontraron fortalezas y debilidades diferentes. En sus evaluaciones, comprimir el contexto mejoraba la eficiencia sin mejorar sustancialmente el aprendizaje de tareas nuevas, mientras que el aprendizaje por refuerzo en línea manejaba mejor las actualizaciones de conocimiento, aunque seguía siendo sensible a recompensas ruidosas. Cuándo el aprendizaje continuo requiere aprender, 8 de julio de 2026.
Ese artículo ayuda a poner límites a las afirmaciones demasiado amplias. Un sistema puede leer un contexto extenso más deprisa sin adquirir mejor una habilidad nueva. Otro puede aprender una tarea nueva pero no conseguir sustituir un dato obsoleto. El «aprendizaje continuo» reúne varias exigencias, y cumplir una no certifica las demás.
Lo interpreto como una señal de que el campo se vuelve más preciso. El siguiente resultado útil nos dirá qué tipo de cambio puede manejar el sistema, qué conserva después y cuánto cuesta la actualización. Una ventana de memoria más grande no puede responder por sí sola a las tres preguntas.
Diseña un ciclo de mejora que permita rechazar mejoras
Si hoy experimentas con un agente de IA, puedes aplicar esta orientación de investigación sin afirmar que has construido una nueva arquitectura de aprendizaje. Empieza por una tarea repetida y un mecanismo que puedas inspeccionar. Lo siguiente es una recomendación práctica de diseño, no una receta copiada de un artículo concreto.
- Define el resultado antes de generar un cambio. En un asistente documental, especifica qué hechos deben permanecer intactos y qué reglas de formato importan. En un agente de programación, define la corrección, los entornos compatibles y el coste de ejecución aceptable. Registra el rendimiento inicial en tareas representativas.
- Separa la exploración de la aceptación. Proporciona al agente ejemplos de desarrollo de los que pueda aprender y reserva casos que no haya visto para comprobar la transferencia. Mantén las reglas de aceptación fuera de sus permisos de edición. Evalúa el procedimiento nuevo bajo las mismas condiciones que el anterior.
- Exige un cambio pequeño e inspeccionable. Guarda la propuesta de entrada de memoria, revisión de instrucciones o modificación de una herramienta junto con su motivo y sus pruebas. Acotar el cambio facilita atribuir los fallos. Evita reescribir todas las instrucciones cada vez que una tarea sale mal.
- Comprueba conjuntamente la retención y el coste. Ejecuta tanto la tarea nueva como los casos anteriores que deben seguir funcionando. Mide los intentos, el tiempo de ejecución y el uso de recursos. Una mejora que solo funciona tras intentos ilimitados puede no servir para el trabajo real.
- Adopta solo lo que respaldan las pruebas. Incorpora la versión satisfactoria con su registro de evaluación, su ámbito y, cuando corresponda, sus condiciones de caducidad. Conserva la versión anterior. Una lección sobre un entorno no debe convertirse silenciosamente en una regla universal.
- Detén el proceso y restaura cuando fallen las pruebas. Fija límites explícitos de tiempo y gasto. Rechaza cambios que debiliten la evaluación, amplíen permisos sin autorización o empeoren comportamientos requeridos. Recupera una versión conocida cuando falle la nueva; continuar indefinidamente no es un criterio de finalización.
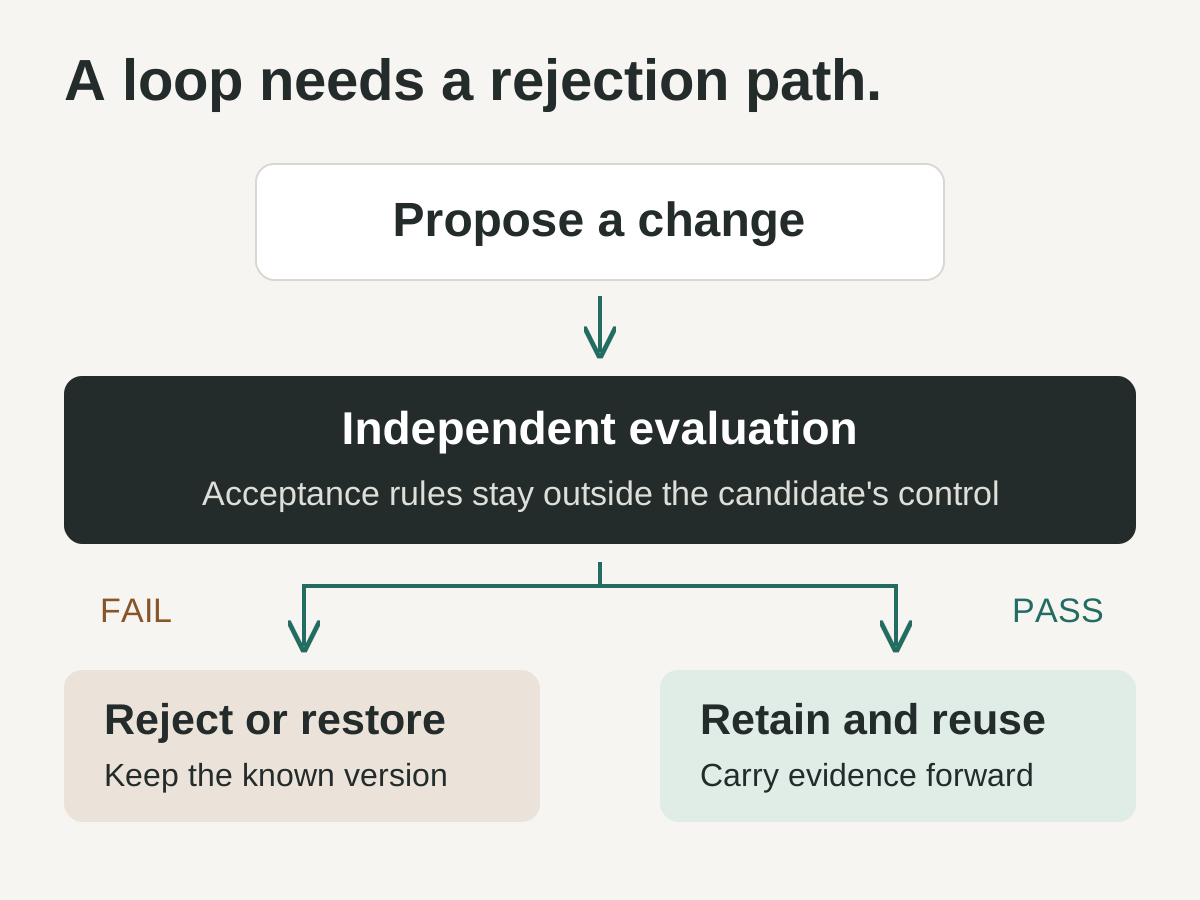
Flujo de control original recomendado por el autor. La evaluación y la autorización para adoptar cambios quedan fuera de los permisos de edición de la versión candidata; el diagrama no implica que cada sistema citado implemente todas estas protecciones.
Cuando el aprendizaje actualiza los pesos, esas mismas preguntas operativas se vuelven más exigentes. También necesitas una política definida de uso de datos, separación entre usuarios, puntos de restauración del modelo y pruebas de cambios perjudiciales de comportamiento. Convertir una conversación privada en material permanente de entrenamiento es una decisión de producto independiente que requiere permiso claro; nunca debería ser una consecuencia accidental de una función llamada memoria.
La AGI se vuelve una posibilidad más concreta cuando la experiencia puede acumularse
Esta es mi interpretación optimista de las pruebas. Un sistema capaz de descubrir una estrategia útil, verificarla, conservarla y aplicarla a un problema nuevo tiene una vía para ampliar sus capacidades sin limitarse a esperar su próximo entrenamiento. Si conectamos esa vía con un aprendizaje fiable de parámetros, el modelo inicial se convierte en una capacidad de partida, no en toda la historia de lo que el sistema podrá aprender.
Eso convierte la inteligencia artificial general, o AGI, en una posibilidad de ingeniería más concreta a mi juicio. No le pone una fecha. Ninguno de los resultados anteriores demuestra un sistema que aprenda eficazmente en todo el abanico de tareas desconocidas, conserve todo lo importante, gestione objetivos contradictorios y siga siendo controlable de forma fiable durante un desarrollo abierto.
Me convencería una transferencia sostenida entre ámbitos cambiantes, medida con límites de recursos realistas. Las pruebas deberían incluir la recuperación de lecciones incorrectas, la protección de capacidades previas y una capacidad demostrable de detener o revertir cambios inseguros. Un nuevo récord en una evaluación sería parte de esas pruebas, no el argumento completo.
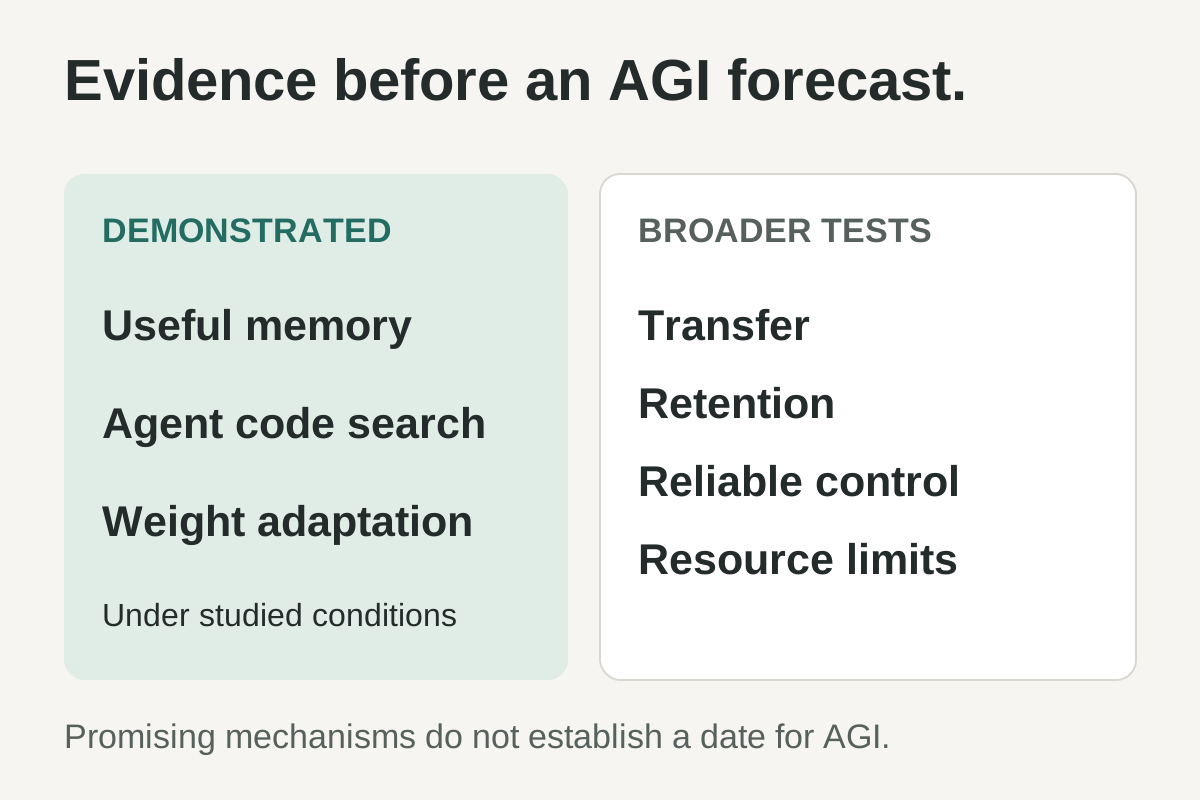
Separación editorial entre mecanismos de investigación demostrados y las pruebas más amplias que exige el argumento sobre AGI de este artículo. No es una predicción ni una escala medida de progreso.
Por eso quiero hacer una pregunta diferente al próximo sistema de IA: después de un mes de trabajo útil, ¿qué ha aprendido de forma demostrable y cómo lo sabemos? Una respuesta creíble diría más sobre su futuro que otra promesa de seguir intentándolo.
Fuentes y fechas de publicación
- Sakana AI, Darwin Gödel Machine, 30 de mayo de 2025 — mejora del código del agente, resultados de evaluación y manipulación de recompensas documentada.
- Snell y colaboradores, asignación óptima del cómputo de LLM durante la inferencia, 6 de agosto de 2024.
- Madaan y colaboradores, Self-Refine, 30 de marzo de 2023.
- Shinn y colaboradores, Reflexion, 20 de marzo de 2023; revisado el 10 de octubre de 2023.
- Wang y colaboradores, Voyager, 25 de mayo de 2023.
- Google DeepMind, AlphaEvolve, 14 de mayo de 2025.
- Tandon y colaboradores, entrenamiento integral durante la inferencia para contextos largos, 29 de diciembre de 2025.
- Feng y colaboradores, In-Place Test-Time Training, 7 de abril de 2026.
- Google Research, presentación de Nested Learning, 7 de noviembre de 2025.
- Kirkpatrick y colaboradores, cómo superar el olvido catastrófico, 2 de diciembre de 2016.
- Feng y colaboradores, FOREVER, 7 de enero de 2026; revisado el 20 de abril de 2026.
- Huang y colaboradores, los modelos de lenguaje todavía no pueden autocorregir el razonamiento, 3 de octubre de 2023.
- Kumar y colaboradores, entrenamiento de la autocorrección mediante aprendizaje por refuerzo, 19 de septiembre de 2024.
- Harrington y colaboradores, cuándo el aprendizaje continuo requiere aprender, 8 de julio de 2026, preprint.
Fuentes comprobadas el 11 de septiembre de 2026. Los resultados de las evaluaciones se atribuyen a sus autores; este artículo no afirma haberlos reproducido de forma independiente. El procedimiento práctico y la perspectiva sobre AGI son recomendaciones e interpretaciones del autor.
Una recomendación de Telli.sh: conservar las pruebas originales facilita comprobar lo que aprendemos después. Telli.sh reúne tus notas, grabaciones y recortes web en una colección personal de conocimiento que puedes consultar. Úsalo para guardar la fuente junto a tus conclusiones, de modo que la próxima revisión parta de algo que puedas inspeccionar.