Transkrypcja wyglądała dobrze: Confident AI włącza brzmienie rozmowy do oceny
Aktualizacja z 23 października dodaje bezpośrednią klasyfikację audio, ocenę człowieka i znaczniki czasu. Jak badać przerywanie, ciszę i sposób mówienia, zachowując dowody.
Autorski diagram redakcyjny Ken Jo, oparty na źródłach wymienionych poniżej.
Klient zadaje pytanie, agent odpowiada poprawnie, a transkrypcja wygląda idealnie. Nagranie ujawnia jednak inną interakcję: agent zaczyna zbyt wcześnie, zagłusza poprawkę i pozostawia długą ciszę, zanim znów zareaguje.
Aktualizacja Confident AI z 23 października 2026 roku włącza więcej tego słyszalnego doświadczenia do oceny. Firma ogłosiła bezpośrednie klasyfikatory audio, etap weryfikacji przez człowieka, znaczniki problemów w odtwarzaczu Observatory i śledzenie audio Pipecat. Łączą one podejrzewany problem z chwilą, której można posłuchać. Oficjalny rejestr zmian.
Confident AI dostarcza narzędzia oceny i obserwowalności aplikacji AI. To wydanie warto rozpatrzyć przez praktyczne pytanie: jak zamienić nieprzyjemną rozmowę w odtwarzalny problem? Rozdzielimy dowody tekstowe i dźwiękowe, a następnie zbudujemy mały proces dla trzech typowych scenariuszy.
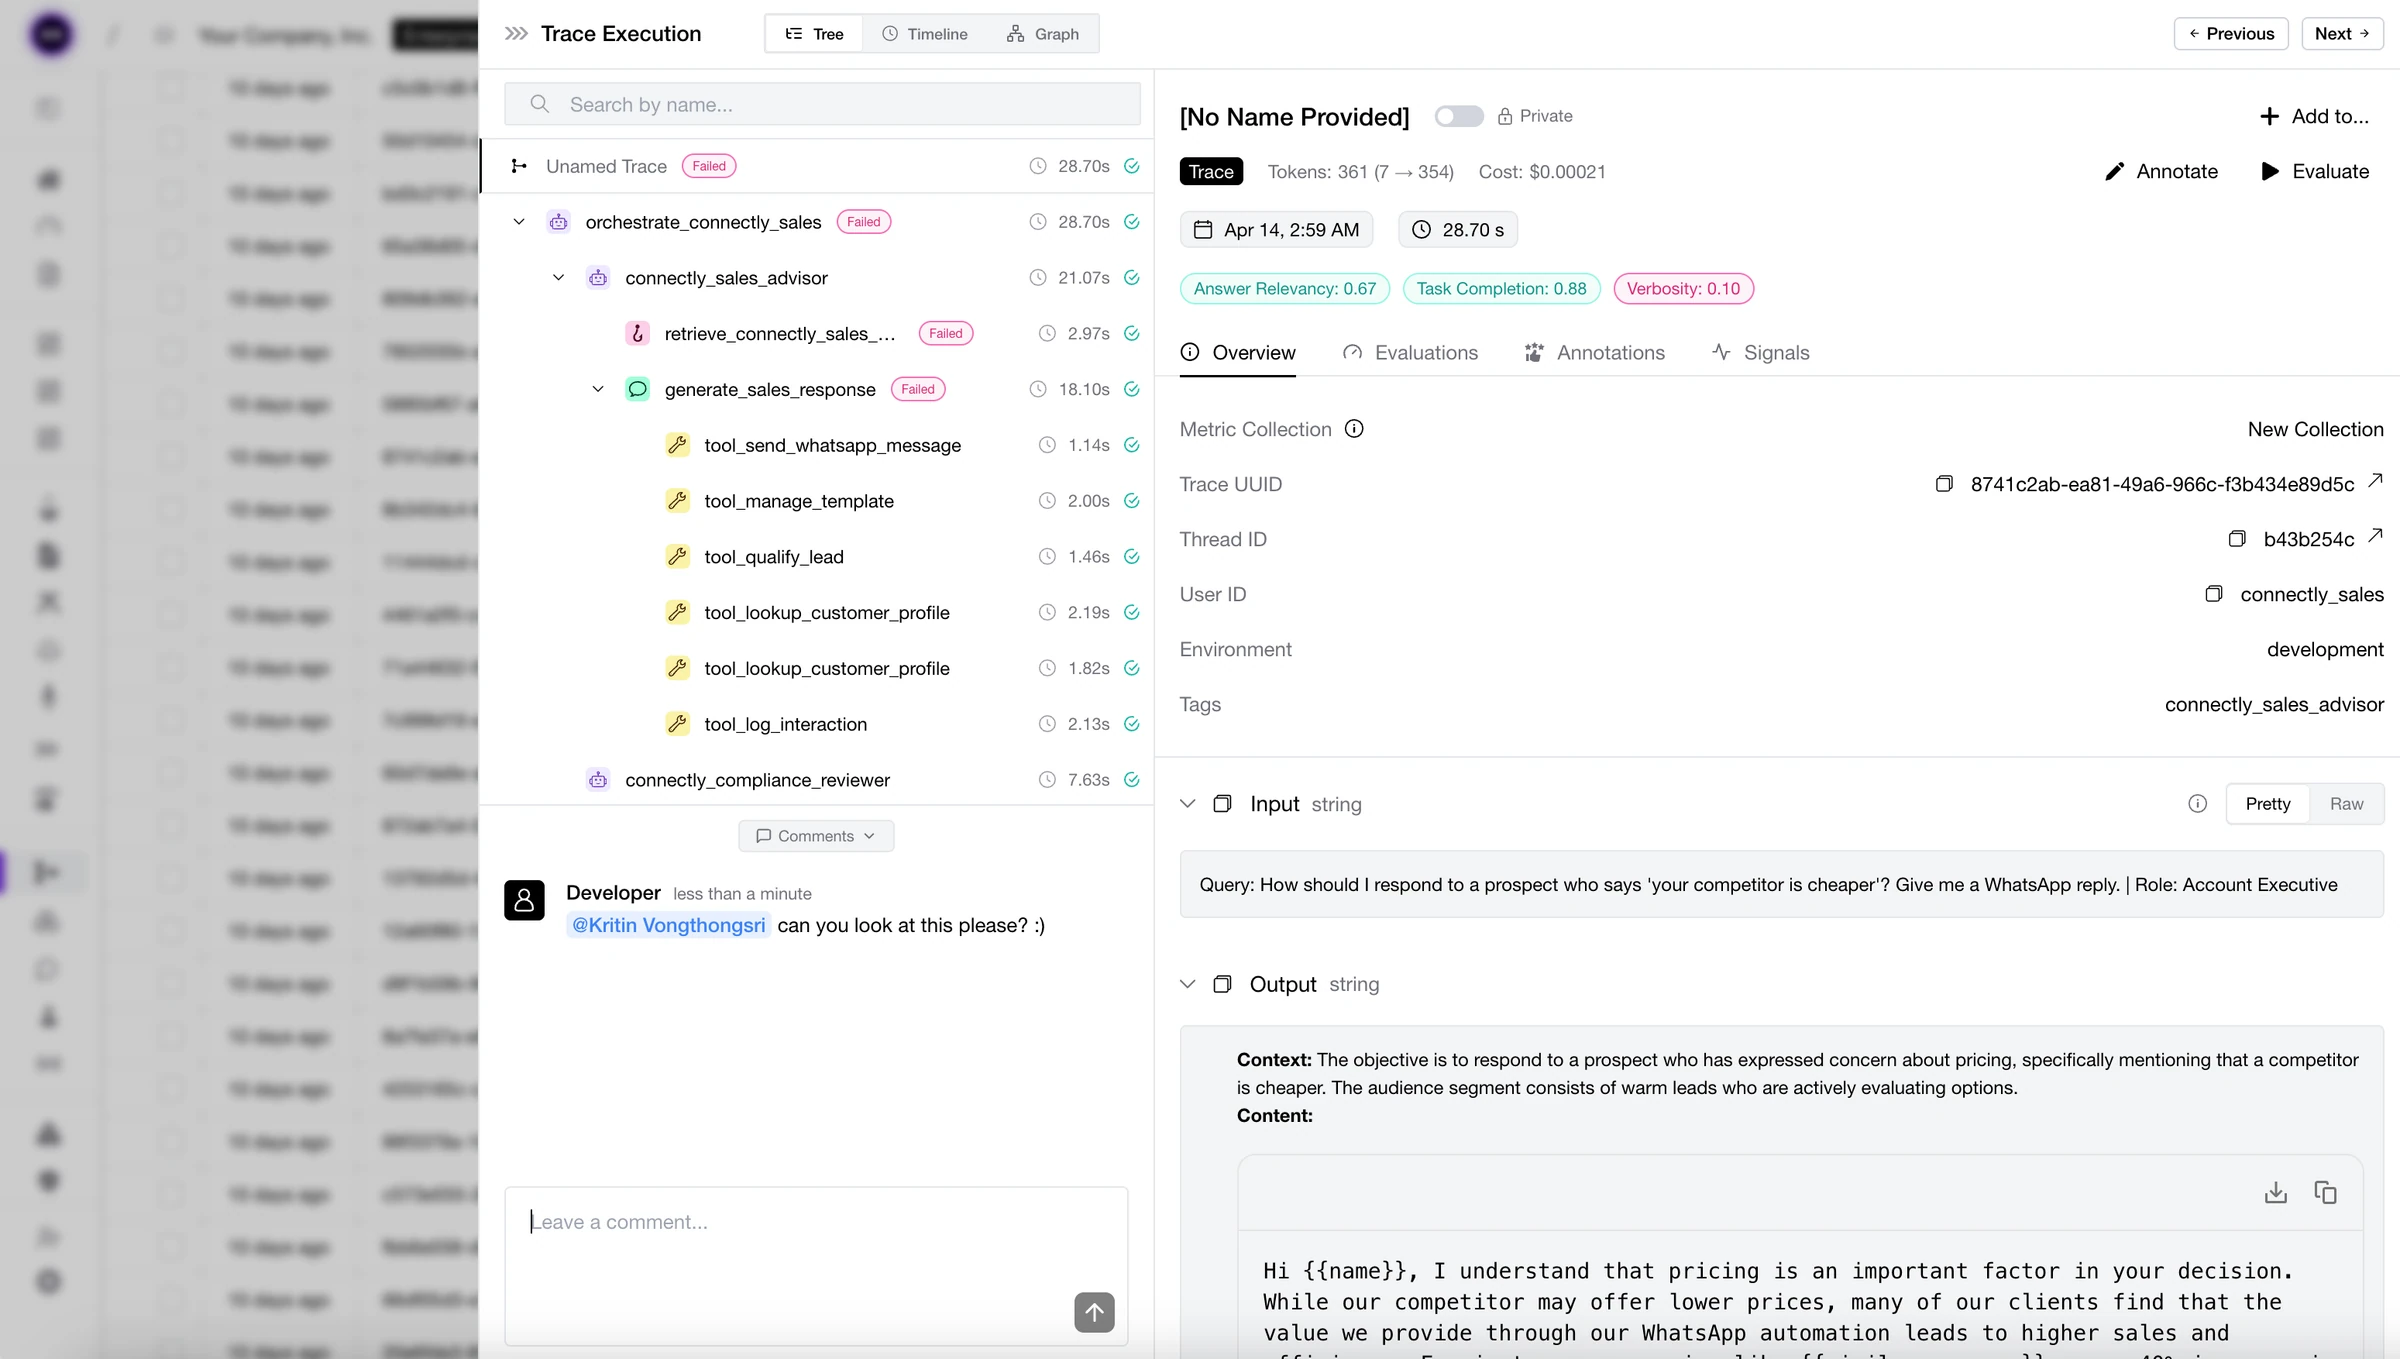
Oficjalny obraz dokumentacji Confident AI, © 2024 Confident AI Inc., Apache 2.0. Ogólny interfejs pokazuje organizację dowodów wykonania, nie nowy klasyfikator audio ani pomiary z tego artykułu.

Transkrypcja zachowuje słowa, audio zachowuje interakcję
Transkrypcja pozwala szybko sprawdzić, czy odpowiedź zawierała oczekiwane informacje. Ujawnia błędną datę, pominiętą instrukcję lub sprzeczność. Łatwo ją również przeszukiwać i porównywać między rozmowami.
Audio odpowiada na inne pytania. Czy osoba skończyła mówić? Czy pozorna przerwa była namysłem? Czy sposób wypowiedzenia utrudnił zrozumienie poprawnego zdania? Czytając tylko oczyszczony tekst, można przeoczyć właśnie to, co uczyniło rozmowę frustrującą.
Rozróżnienie jest szczególnie użyteczne, gdy dowody się różnią. Transkrypcja może zawierać pełne pytanie, choć agent zaczął odpowiadać w połowie. Z kolei dziwny fragment tekstu może brzmieć naturalnie jako krótkie potwierdzenie. Zachowaj obie formy, aby umożliwić ocenę w kontekście.
Przewodnik audio opisuje dołączanie nagrania do wiadomości z rolą i tekstem oraz odtwarzanie w śladzie wykonania. Recenzent może przechodzić między zapisem słownym a tym, co rzeczywiście usłyszano. Dokumentacja audio, sprawdzono 27 października 2026.
Uważamy, że ocena głosu potrzebuje tej drugiej ścieżki. Rozmowa jest częścią produktu, więc końcowy tekst nie reprezentuje całej jakości. Powiązanie nagrania ze zdarzeniem aplikacji pozwala mówić o jakości precyzyjniej.
Przydatne ustalenie zawiera moment i powód
Wydanie z 23 października dodaje klasyfikatory przerywania, niezręcznej ciszy i problemów sposobu wypowiedzi. Dodaje także odsłuch przez człowieka przed potwierdzeniem etykiety. Odtwarzacz zaznacza momenty problemów, aby można było do nich wrócić. Nowy proces audio.
To bardziej praktyczne niż ogólna skarga, że agent brzmiał źle. Programista potrzebuje lokalizacji, opisu zachowania i kontekstu pozwalającego zrozumieć oczekiwany przebieg. Klasyfikacja ustala priorytet uwagi, a fragment dostarcza sprawdzalnego dowodu.
Zachowaj różnicę między podejrzeniem a potwierdzeniem. Pauza może być właściwa, gdy rozmówca sprawdza dokument. Nakładająca się wypowiedź może być pomocnym potwierdzeniem zamiast przerwaniem. Etykieta ma sens, gdy odzwierciedla rzeczywiste oczekiwania zespołu.
Zapisz je zwykłym językiem. Na przykład przerwanie może oznaczać rozpoczęcie istotnej odpowiedzi, gdy rozmówca nadal podaje dane, przez co informacja ginie lub musi być powtórzona. To przykładowe kryterium przeglądu, nie definicja narzucona przez produkt.
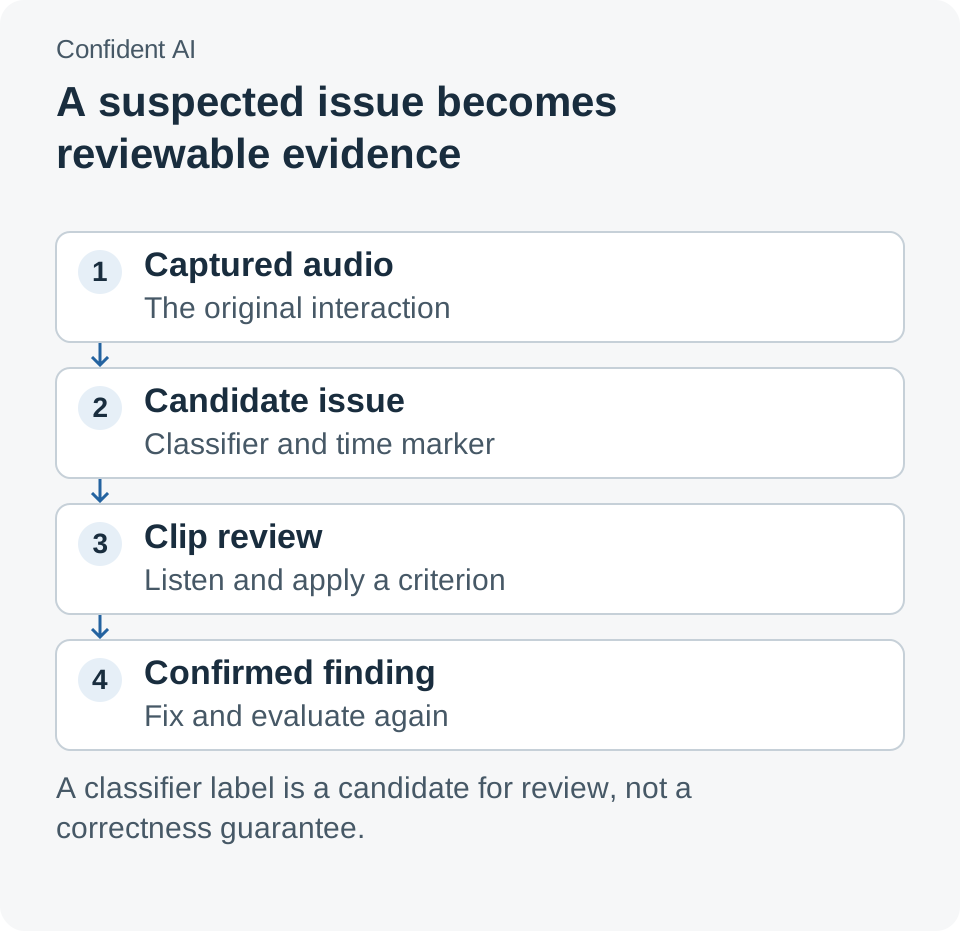
Klasyfikacja lokalizuje możliwy problem. Odsłuch i jasne kryterium zmieniają go w ustalenie, na które można zareagować.
Trzy rozmowy pokazują, dlaczego czas wymaga kontekstu
Najpierw rozważmy asystenta terminów. Osoba prosi o zmianę rezerwacji, przerywa na sprawdzenie kalendarza, a potem podaje dzień. Jeśli agent w tej pauzie proponuje godziny, odpowiedź może być merytorycznie trafna, a mimo to przeszkadzać.
W tym przykładzie należy posłuchać przed przerwaniem i po nim. Czy agent jedynie potwierdził odbiór, czy przedwcześnie przyjął interpretację? Czy rozmówca kontynuował naturalnie, czy musiał zacząć od nowa? Obserwacje rozróżniają dopuszczalny nawyk i usterkę wartą naprawy.
Drugi scenariusz to pomoc przy nieznanym produkcie. Agent odpowiada dobrze, ale osoba nie wie, czy została usłyszana. Długi brak reakcji może wywołać powtórzenie pytania, odczytane potem jako nowe żądanie. Nagranie wraz ze śladem wykonania pomaga znaleźć początek odczuwalnego opóźnienia.
Nie ustalaj uniwersalnego progu ciszy z jednego przykładu. Wyszukanie konta i potwierdzenie prostej instrukcji budują różne oczekiwania. Najpierw określ właściwą interakcję, a potem porównuj pauzy. Ważne jest to, co osoba mogła rozsądnie rozumieć o trwającym procesie.
Trzeci scenariusz to wielojęzyczny asystent obsługujący adres lub kod produktu. Transkrypcja może zawierać wiarygodne zdanie, podczas gdy oryginalna wymowa wskazuje inny termin. Ponowny odsłuch obu stron pomaga rozróżnić problem rozpoznawania, interpretacji i wypowiedzi.
Nie każdy błąd staje się przez to zadaniem klasyfikatora audio. Aplikacja może potrzebować potwierdzenia, lepszego słownictwa albo wyraźniejszej prośby o powtórzenie istotnego szczegółu. Ocena jest wartościowa, gdy prowadzi do właściwej zmiany interakcji, zamiast ogólnego dążenia do milszego brzmienia.
| Dowód do sprawdzenia | Co pomaga ustalić | Nadal potrzebny kontekst |
|---|---|---|
| Transkrypcja | Zapisane słowa i treść odpowiedzi | Zrozumiałość kolejności wypowiedzi i wymowy |
| Fragment audio | Czas, nakładanie, ciszę i sposób mówienia | Czy zachowanie szkodziło zadaniu |
| Ślad aplikacji | Wykonane kroki i operacje narzędzi | Czy końcowa interakcja zaspokoiła potrzebę |
| Notatka człowieka | Potwierdzoną interpretację z uzasadnieniem | Czy późniejsza zmiana naprawia ten sam przypadek |
Zapisanie śladu nie gwarantuje odtwarzalnego nagrania
Przed oceną audio potwierdź istnienie dowodu. Dokumentacja multimodalna odróżnia media osadzone, odsyłacze i pominięte pliki. Ogólne przechwytywanie wywołań zachowuje obsługiwane obrazy i PDF, ale audio wymaga właściwego załącznika lub wspieranej integracji głosowej. Śledzenie multimodalne, aktualizacja 9 października 2026.
To rozróżnienie wpływa na codzienną diagnostykę. URL w śladzie jest odwołaniem do pliku, niekoniecznie zachowaną kopią. Jeśli lokalizacja wygaśnie lub recenzent nie ma dostępu, ślad pozostanie widoczny, ale dowód dźwiękowy zniknie. Uwzględnij odtwarzanie w pierwszej kontroli integracji.
Dokumentacja podaje domyślnie 5 MiB na element multimedialny oraz łącznie 16 MiB na span w SDK TypeScript. Zbyt duże media są pomijane, nie obcinane. Dlatego duże nagrania trzeba obsłużyć świadomie; otrzymanie tekstowego śladu nie dowodzi obecności audio. Limity mediów.
Przewodnik audio umieszcza nagranie przy wiadomości z rolą i treścią. Zachowaj informację o mówcy i odpowiednim tekście. Fragment przypisany do złej wiadomości może prowadzić do błędnego wniosku, nawet gdy odtwarza się poprawnie.
Zacznij od dwunastu fragmentów wyjaśniających zadanie
Praktyczny pilotaż może objąć 12 celowo wybranych fragmentów: cztery zwykłe sukcesy, cztery oczywiste błędy i cztery niejednoznaczne przypadki do dyskusji. To propozycja kalibracji przeglądu, nie statystycznie reprezentatywna próba ani benchmark dostawcy.
Niejednoznaczne przypadki są szczególnie cenne. Pokazują, czy oceniający wspólnie rozumieją przerywanie, akceptowalne czekanie i klarowną wypowiedź. W razie różnic zapisz przyczyny, zanim zażądasz od automatycznego klasyfikatora odtworzenia rzekomo uzgodnionej etykiety.
Użyj powtarzalnego procesu, aby pierwsza ocena dała więcej niż zbiór wrażeń:
- Utwórz projekt dla jednego zastosowania głosowego. Zawęź zakres, aby do wszystkich fragmentów odnosiły się te same oczekiwania.
- Powiąż nagranie i transkrypcję z jedną interakcją. Użyj opisanego załącznika lub odpowiedniej integracji. Sprawdź odtwarzanie obu stron reprezentatywnej rozmowy.
- Sprawdź dowody przy domyślnych limitach. Szukaj oznaczeń pominięcia, niedostępnych linków i złych przypisań. Napraw przechwytywanie, zanim uznasz brak audio za bezproblemową rozmowę.
- Zdefiniuj niewielki zestaw etykiet. Opisz każde zachowanie konkretnie i dodaj podobny, ale akceptowalny przykład.
- Uruchom klasyfikację i posłuchaj wskazanych momentów. Zachowaj etykietę kandydującą, decyzję i wyjaśnienie. Posłuchaj również nieoznaczonych fragmentów, by znaleźć przeoczenia.
- Zmień jeden istotny element i powtórz. Porównaj te same przypadki po zmianie, a przed rozszerzeniem dodaj świeże przykłady.
Przewodnik klasyfikatorów wyjaśnia, że opisy etykiet wpływają na klasyfikację, a wyniki stają się filtrowalnymi sygnałami. Starszy przewodnik ogólny i aktualizacja z 23 października opisują różne etapy produktu; w nowym procesie audio korzystaj z aktualnych opcji przestrzeni roboczej. Trwałą zasadą jest opisanie zachowania na tyle konkretnie, by inny recenzent zastosował to samo kryterium. Przewodnik klasyfikatorów.
Mierz proces oceny razem z agentem
Więcej wykrytych problemów może oznaczać gorszego agenta, czulszy klasyfikator albo trudniejsze rozmowy. Zachowaj widoczność konfiguracji i zbioru sprawdzonych połączeń, aby odróżniać te możliwości.
W pilotażu zanotuj, ile oznaczonych fragmentów potwierdzono i ile błędów znaleziono w nieoznaczonych. Zapisz też czas odnalezienia właściwego momentu. Są to obserwacje procesu zespołu, bez twierdzenia o uniwersalnej dokładności klasyfikatora.
Gdy zmiana poprawia fragment, wyjaśnij co konkretnie. Rozmówca skończył pytanie przed odpowiedzią. Usłyszał potwierdzenie podczas wyszukiwania. Asystent sprawdził niepewny kod przed działaniem. Takie wyniki pomagają bardziej niż ogólne stwierdzenie, że model brzmi naturalnie.
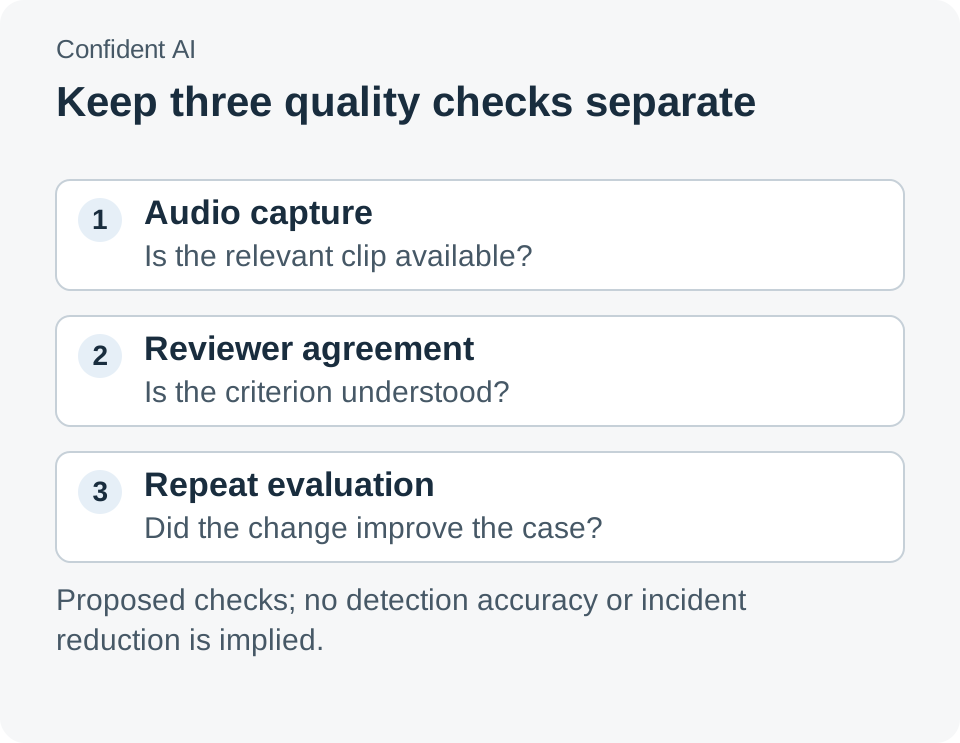
Wiarygodny przegląd osobno bada dowód, interpretację i skutek zmiany.
Dostęp i przechowywanie nagrań należą do projektu
Nagrania mogą zawierać informacje zbędne w danej ocenie. Ustal, które rozmowy zachowywać, kto może słuchać i jak długo dowód jest użyteczny. W pilotażu wybierz najmniejszy sensowny zbiór zamiast szerokiego gromadzenia bez celu.
Przewodnik danych opisuje projekty jako oddzielne przestrzenie z własnymi danymi i uprawnieniami. To praktyczna granica organizacyjna: ocena jednego zastosowania nie oznacza automatycznie potrzeby dostępu do nagrań innego. Przetwarzanie danych, aktualizacja 14 października 2026.
Rejestr z 23 października wprowadza również rozliczanie kredytów i przechowywanie śladów w GB-miesiącach. Przed poszerzeniem zbierania sprawdź aktualny plan i rzeczywiste użycie. Udane technicznie przyjęcie danych jest tylko częścią opłacalnego i utrzymywalnego procesu. Zmiany wykorzystania.
Jakość rozmowy staje się użyteczna, gdy można jej posłuchać ponownie
Ciekawy kierunek wydania łączy ocenę jakości z rzeczywistym doświadczeniem. Znacznik czasu, odtwarzalny fragment i decyzja dają programiście konkretny obiekt poprawy. Pozostawiają też zapis, do którego można wrócić po zmianie modelu lub reguł interakcji.
Naturalny agent zyskuje zaufanie w całej rozmowie: słucha, odpowiada we właściwym momencie i jasno kończy zadanie. Oceniaj te elementy razem, a nagranie stanie się dowodem służącym lepszej rozmowie, zamiast kolejnym plikiem monitoringu.
Źródła
- Rejestr zmian Confident AI, 23 października 2026.
- Audio w śladach, sprawdzono 27 października 2026.
- Śledzenie multimodalne i limity, aktualizacja 9 października, sprawdzono 27 października 2026.
- Zadania klasyfikatorów, aktualizacja 6 października 2026. Nowe funkcje audio i span potwierdza rejestr z 23 października.
- Przetwarzanie danych, aktualizacja 14 października 2026.
- Oficjalny obraz i repozytorium, licencja Apache 2.0. Scenariusze i pilotaż dwunastu fragmentów są ilustracyjne; nie wykonano benchmarku dokładności detektora.
Rekomendacja Telli.sh
Zachowaj łatwy dostęp do notatek oceny, przykładowych transkrypcji i decyzji stojących za zmianą rozmowy. Utwórz konto Telli.sh, aby uporządkować nagrania i notatki referencyjne.