La transcription semblait parfaite : Confident AI intègre le son de la conversation à l’évaluation
La mise à jour du 23 octobre ajoute classification audio directe, revue humaine et repères temporels. Comment évaluer interruptions, silences et diction en conservant les preuves de chaque constat.
Schéma éditorial original de Ken Jo, fondé sur les sources présentées ci-dessous.
Un client pose une question, l’agent donne la bonne réponse et la transcription paraît parfaite. Pourtant, l’enregistrement révèle une autre interaction : l’agent commence trop tôt, couvre une correction et laisse un long silence avant de répondre à nouveau.
La mise à jour de Confident AI du 23 octobre 2026 intègre davantage cette expérience audible au travail d’évaluation. L’entreprise annonce des classificateurs audio directs, une étape de revue humaine, des repères temporels dans le lecteur Observatory et le traçage audio de Pipecat. Ces fonctions relient un problème présumé à un moment que quelqu’un peut réellement écouter. Journal officiel.
Confident AI fournit des outils d’évaluation et d’observabilité pour les applications d’IA. Cette version pose une question pratique : comment transformer une conversation inconfortable en problème reproductible ? Nous distinguerons les preuves de la transcription de celles de l’audio, puis construirons une petite procédure pour trois situations courantes.
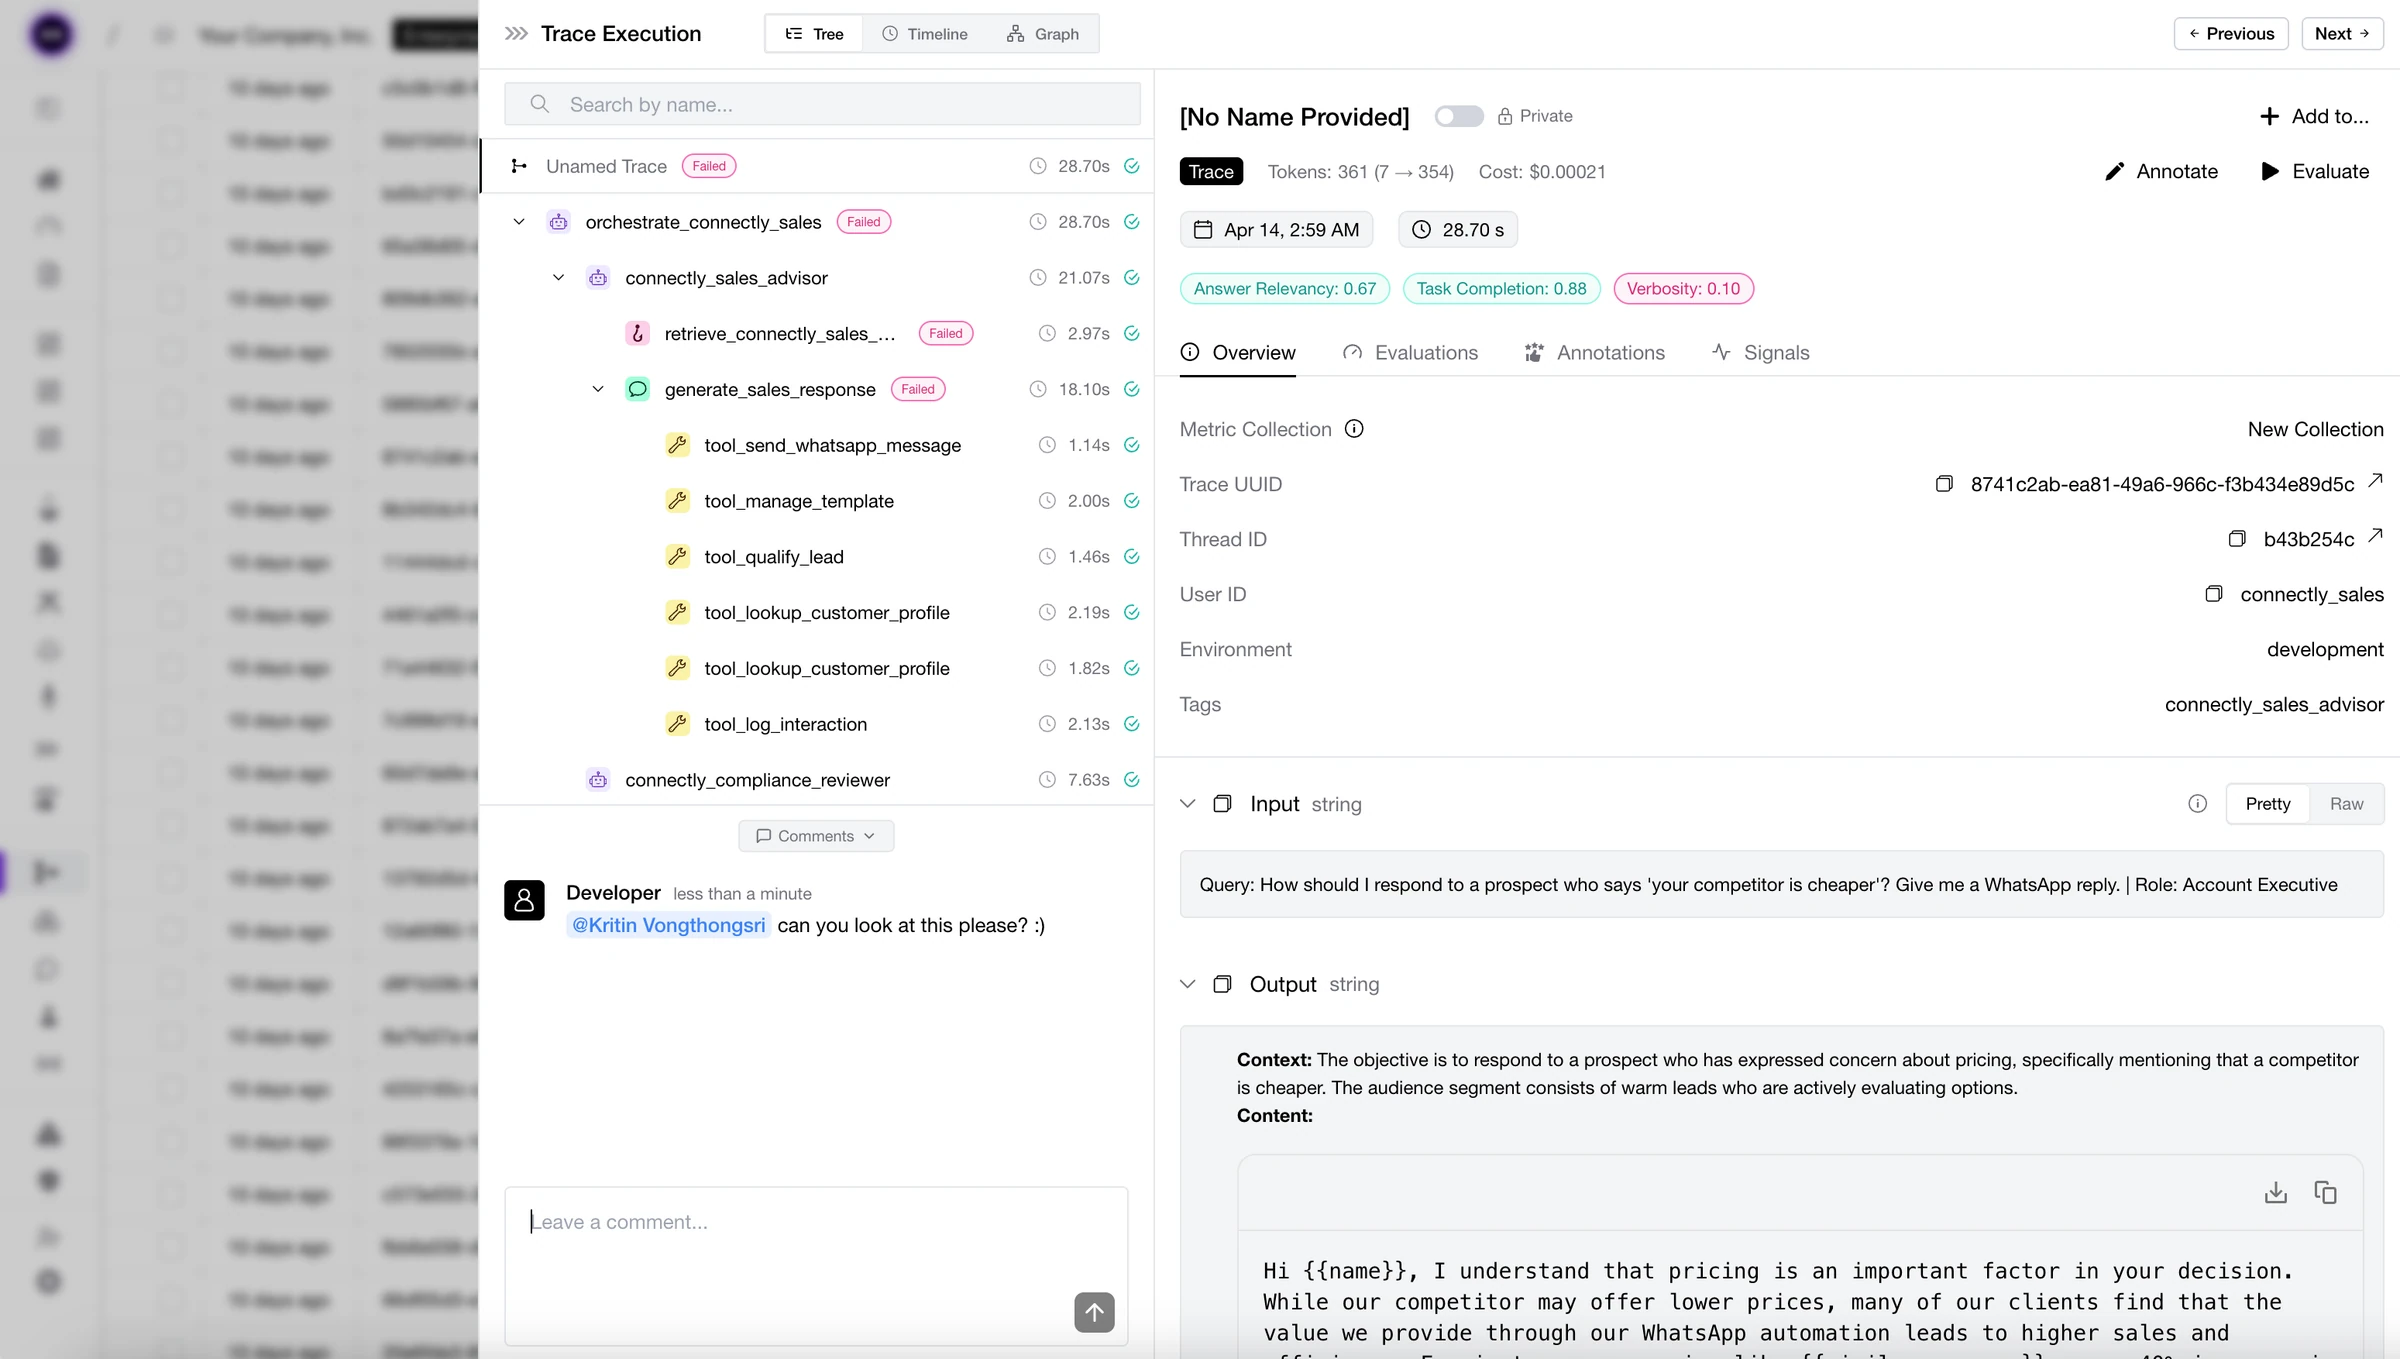
Image officielle de la documentation Confident AI, © 2024 Confident AI Inc., Apache 2.0. Cette interface générale montre l’organisation des preuves d’exécution ; elle ne représente ni le nouveau classificateur audio ni des mesures réalisées pour cet article.

La transcription conserve les mots, l’audio conserve l’interaction
La transcription permet de vérifier rapidement si la réponse contenait les informations attendues. Elle peut révéler une date erronée, une consigne absente ou une contradiction. Elle se prête aussi à la recherche et à la comparaison entre de nombreuses conversations.
L’audio répond à d’autres questions. La personne avait-elle fini de parler ? Une pause apparente était-elle un moment de réflexion ? La manière de parler rendait-elle une phrase correcte difficile à comprendre ? En ne lisant qu’un texte nettoyé, on peut manquer l’événement même qui a rendu l’appel frustrant.
La distinction devient particulièrement utile lorsque les deux preuves divergent. La transcription peut contenir la question entière alors que l’agent répondait déjà au milieu. À l’inverse, un fragment étrange à l’écrit peut être une confirmation naturelle dans une conversation fluide. Gardez les deux pour permettre une appréciation contextuelle.
Le guide audio décrit l’ajout d’un enregistrement à un message, avec son rôle et son texte, et sa lecture dans la trace. Le réviseur peut ainsi passer de ce qui est représenté à l’écrit à ce qui a été entendu. Documentation audio, consultée le 27 octobre 2026.
Nous pensons que l’évaluation vocale a besoin de cette deuxième piste. L’échange parlé fait partie du produit ; le texte final ne représente donc pas toute sa qualité. Relier l’enregistrement à l’événement applicatif rend la discussion plus précise.
Un constat utile comprend un moment et une raison
La version du 23 octobre ajoute des classificateurs destinés à repérer interruptions, silences gênants et problèmes de diction ou de restitution. Elle prévoit également qu’une personne écoute avant de confirmer l’étiquette. Le lecteur indique les moments concernés pour y revenir facilement. Nouveau processus audio.
Ce constat est plus exploitable qu’une plainte générale selon laquelle l’agent sonnait mal. Le développeur a besoin d’un emplacement, d’une description du comportement observé et d’assez de contexte pour comprendre ce qui aurait dû se passer. La classification indique où regarder ; l’extrait apporte une preuve vérifiable.
Il faut maintenir la différence entre soupçon et problème confirmé. Une pause peut être adaptée lorsque l’appelant consulte un document. Un chevauchement peut être une confirmation utile plutôt qu’une interruption. L’étiquette sert lorsqu’elle reflète les attentes conversationnelles réelles de l’équipe.
Décrivez ces attentes simplement. Par exemple, une interruption peut correspondre au début d’une réponse substantielle alors que l’appelant fournit encore des informations, entraînant perte ou répétition. C’est un critère illustratif pour une procédure d’équipe, pas une définition imposée par le produit.
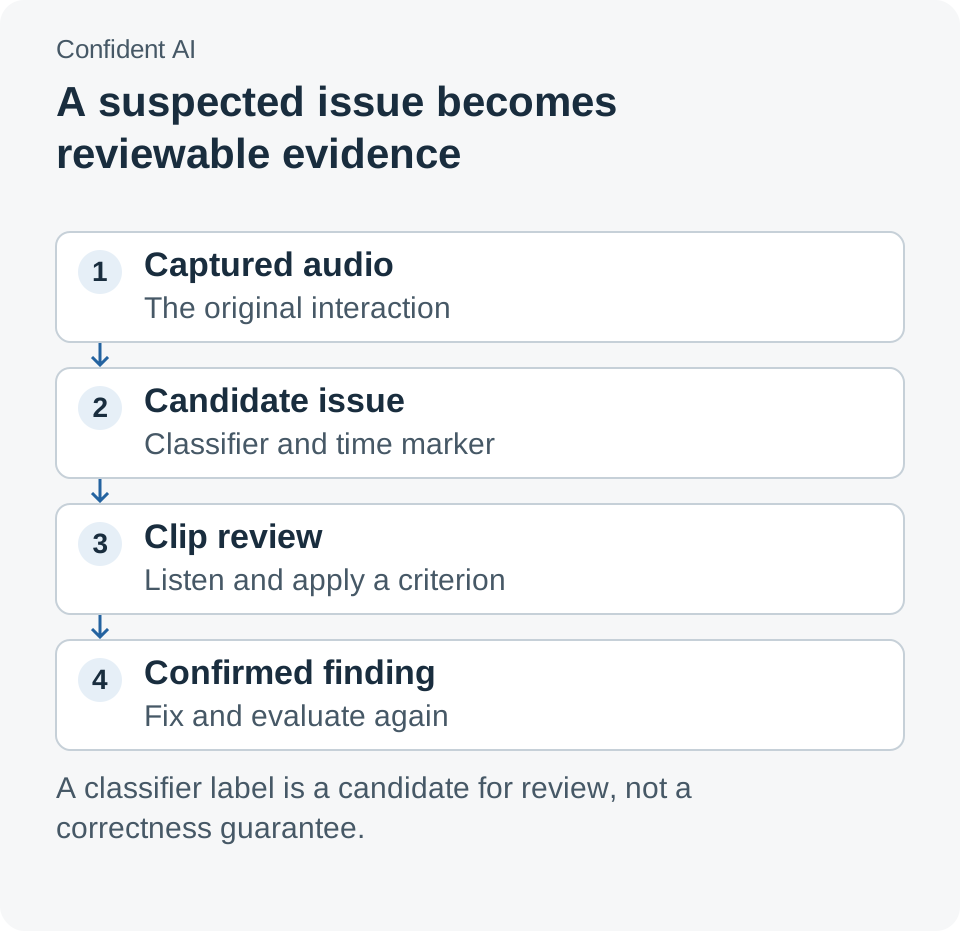
La classification localise un problème possible. L’écoute et un critère clair le transforment en constat sur lequel l’équipe peut agir.
Trois conversations montrent pourquoi le timing dépend du contexte
Prenons un assistant de rendez-vous. L’appelant demande un déplacement, s’arrête pour consulter son agenda, puis donne le jour. Si l’agent propose déjà des horaires pendant cette pause, la réponse peut être pertinente sur le fond tout en perturbant la tâche.
Dans cet exemple, le réviseur doit écouter avant et après l’interruption. L’agent a-t-il simplement accusé réception, ou fixé une interprétation avant la fin ? L’appelant a-t-il repris naturellement ou dû recommencer ? Ces observations distinguent une habitude acceptable d’un défaut à corriger.
Deuxième scénario : le support d’un produit peu familier. L’agent répond correctement, mais l’appelant ne sait pas s’il a été entendu. Une longue attente sans confirmation peut provoquer une répétition, ensuite interprétée comme une nouvelle demande. L’enregistrement associé à la trace aide à identifier le début du délai perceptible.
Ne fixez pas un seuil universel de silence à partir d’un seul exemple. Une recherche de compte et la confirmation d’une instruction simple créent des attentes différentes. Définissez l’interaction souhaitée pour la tâche, puis comparez les pauses observées. Ce qui importe est ce que la personne pouvait raisonnablement comprendre de la situation.
Troisième scénario : un assistant multilingue traite une adresse ou un code produit. La transcription peut contenir une expression plausible alors que la prononciation initiale indique autre chose. Réécouter les deux côtés aide à repérer si le problème vient de la reconnaissance, de l’interprétation ou de la restitution.
Cela ne transforme pas chaque erreur en problème de classificateur audio. L’application peut nécessiter une confirmation, un meilleur vocabulaire ou une demande plus explicite de répéter un détail critique. L’évaluation vaut lorsqu’elle conduit à modifier correctement l’interaction, plutôt qu’à rendre vaguement l’agent plus sympathique.
| Preuve à examiner | Ce qu’elle aide à établir | Contexte encore nécessaire |
|---|---|---|
| Transcription | Mots enregistrés et contenu de la réponse | Intelligibilité des tours de parole et de la prononciation |
| Extrait audio | Timing, chevauchement, silence et restitution | Effet du comportement sur la tâche visée |
| Trace applicative | Étapes et opérations d’outils exécutées | Satisfaction du besoin de l’utilisateur à la fin |
| Note de revue humaine | Interprétation confirmée et justifiée | Correction réelle du même cas après une modification |
Capturer une trace ne garantit pas un enregistrement lisible
Avant d’évaluer l’audio, vérifiez l’existence de la preuve. La documentation multimodale distingue médias intégrés, liens et fichiers omis. La capture générale des appels de modèle conserve les images et PDF intégrés pris en charge ; l’audio nécessite une pièce jointe adaptée ou une intégration vocale compatible. Traçage multimodal, mis à jour le 9 octobre 2026.
Cette distinction compte au quotidien. Une URL dans une trace référence un fichier, sans garantir une copie conservée. Si l’adresse expire ou si le réviseur n’y a pas accès, la trace reste visible mais la preuve sonore disparaît. Incluez la lecture dans la première vérification d’intégration.
La documentation fixe par défaut 5 MiB par élément multimédia et 16 MiB au total par span dans le SDK TypeScript. Les médias trop volumineux sont omis, pas tronqués. Il faut donc traiter les gros enregistrements délibérément, sans présumer qu’ils sont présents parce que la trace textuelle est arrivée. Limites des médias.
Le guide audio place le son sur un message associé à un rôle et à un contenu. Cette association aide l’évaluation : préservez l’identité du locuteur et le texte correspondant. Un extrait lié au mauvais message peut induire une conclusion erronée même s’il se lit correctement.
Commencer par douze extraits qui expliquent la tâche
Un pilote pratique peut débuter avec 12 extraits choisis délibérément : quatre interactions ordinaires réussies, quatre échecs évidents et quatre cas ambigus nécessitant une discussion. C’est une proposition de calibration, pas un échantillon statistiquement représentatif ni un benchmark fournisseur.
Les cas ambigus sont particulièrement utiles. Ils montrent si les réviseurs partagent les définitions d’interruption, d’attente acceptable et de restitution claire. En cas de désaccord, consignez les raisons avant de demander à un classificateur de reproduire une étiquette supposée acquise.
Adoptez une procédure répétable pour que la première évaluation dépasse la collection d’impressions :
- Créez un projet pour un seul usage d’agent vocal. Limitez le périmètre afin que les mêmes attentes conversationnelles s’appliquent aux extraits.
- Reliez l’enregistrement et la transcription à la même interaction. Utilisez la méthode documentée de pièce jointe audio ou l’intégration vocale adaptée. Vérifiez que les deux côtés d’un échange représentatif sont lisibles.
- Vérifiez les preuves aux limites par défaut. Cherchez indicateurs d’omission, liens indisponibles et mauvaises associations. Corrigez la capture avant d’assimiler une absence d’audio à un appel sans incident.
- Définissez quelques étiquettes de revue. Décrivez chaque comportement précisément, avec un cas similaire qui doit rester acceptable.
- Lancez la classification et écoutez les moments signalés. Conservez l’étiquette candidate, la décision confirmée et l’explication du réviseur. Écoutez aussi des extraits non signalés pour trouver les omissions.
- Modifiez un élément pertinent et recommencez. Comparez les mêmes cas après modification, puis ajoutez des exemples nouveaux avant d’élargir le processus.
Le guide des classificateurs explique que les descriptions influencent la classification et que les résultats deviennent des signaux filtrables. L’ancien guide général et la version du 23 octobre décrivent des étapes différentes du produit ; utilisez les commandes actuelles de l’espace de travail pour le nouveau processus audio. Le principe durable est de décrire le comportement assez précisément pour qu’un autre réviseur puisse appliquer le critère. Guide des classificateurs.
Mesurer la revue autant que l’agent
Une hausse des problèmes détectés peut avoir plusieurs causes : agent dégradé, classificateur plus sensible ou conversations plus difficiles. Rendez visibles la configuration et l’ensemble des appels examinés pour distinguer ces possibilités.
Pendant le pilote, notez combien d’extraits signalés sont confirmés et combien de problèmes apparaissent parmi les extraits non signalés. Mesurez aussi le temps nécessaire pour retrouver le passage pertinent. Ce sont de simples observations sur le processus, sans prétendre à un score universel de précision.
Lorsqu’une modification améliore un extrait, dites ce qui a changé. L’appelant a fini sa question avant la réponse. Il a entendu une confirmation pendant la recherche. L’assistant a vérifié un code incertain avant d’agir. Ces résultats concrets servent mieux la discussion qu’une affirmation générale de naturel.
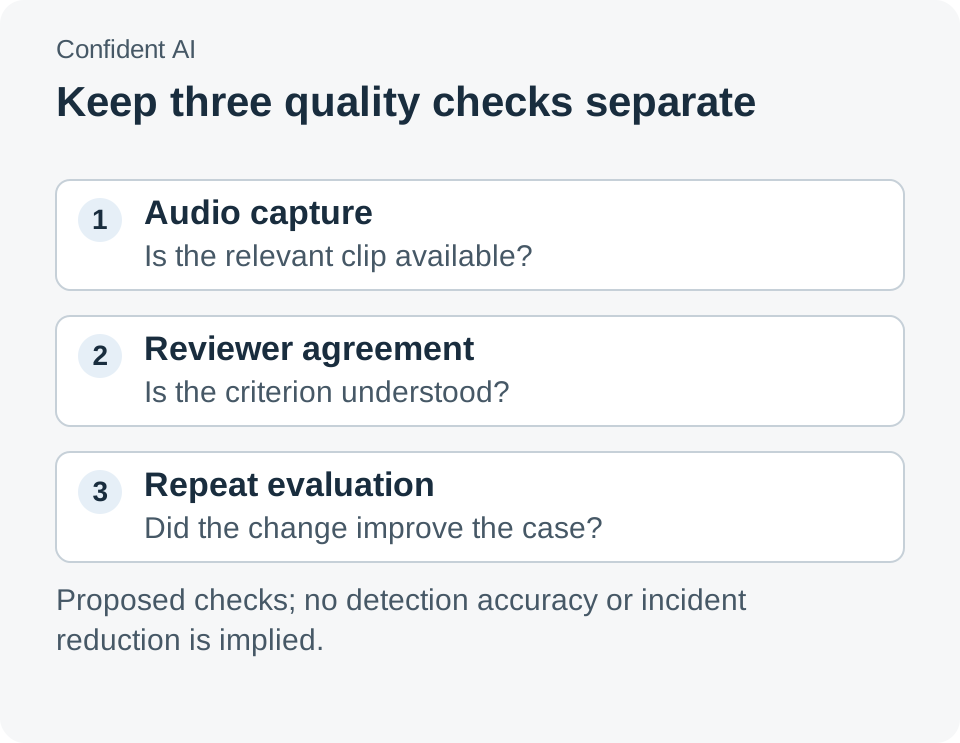
Une revue fiable vérifie séparément les preuves, leur interprétation et l’effet du changement.
Accès et stockage des enregistrements font partie de la conception
Les enregistrements peuvent contenir des informations inutiles à certaines revues. Décidez quelles conversations conserver, qui peut les écouter et combien de temps les preuves restent utiles. Pour le pilote, retenez le plus petit ensemble pertinent plutôt qu’une collecte large sans objectif d’évaluation.
Le guide de traitement des données décrit des projets séparés avec leurs propres données et droits d’accès. C’est une frontière organisationnelle pratique : examiner un usage ne donne pas automatiquement besoin des enregistrements d’un autre. Traitement des données, mis à jour le 14 octobre 2026.
Le journal du 23 octobre introduit aussi une comptabilité en crédits et un stockage de traces mesuré en Go-mois. Avant d’élargir la collecte audio, vérifiez le forfait actuel et l’usage réel. Une ingestion réussie n’est qu’une partie d’une revue abordable et maintenable. Évolutions de l’usage.
La qualité conversationnelle devient exploitable lorsqu’on peut la réécouter
La direction intéressante de cette version relie le jugement de qualité à l’expérience réelle. Un repère temporel, un extrait lisible et une décision donnent aux développeurs un objet concret à améliorer. Ils constituent aussi une trace à revisiter après un changement de modèle ou de règle d’interaction.
Un agent naturel gagne la confiance dans l’ensemble de l’échange : écouter, répondre au bon moment et terminer clairement la tâche. Évaluez ces aspects ensemble et l’enregistrement devient une preuve au service d’une meilleure conversation, plutôt qu’un fichier de plus dans un système de surveillance.
Sources
- Journal produit de Confident AI, 23 octobre 2026.
- Audio dans les traces, consulté le 27 octobre 2026.
- Traçage multimodal et limites, mis à jour le 9 octobre 2026 ; consulté le 27 octobre.
- Tâches de classification, mises à jour le 6 octobre 2026. Le journal du 23 octobre fait foi pour les nouvelles fonctions audio et par span.
- Traitement des données, mis à jour le 14 octobre 2026.
- Image officielle et dépôt documentaire, licence Apache 2.0. Les scénarios et le pilote de douze extraits sont illustratifs ; aucun benchmark de précision de détection n’a été réalisé.
Une recommandation de Telli.sh
Gardez facilement accessibles les notes de revue, transcriptions d’exemple et décisions qui ont motivé un changement de conversation. Créez un compte Telli.sh pour organiser vos enregistrements et notes de référence.