La transcripción parecía correcta: Confident AI incorpora el sonido de la conversación a la evaluación
La actualización del 23 de octubre añade clasificación directa de audio, revisión humana y marcas temporales. Cómo evaluar interrupciones, silencios y expresión conservando la evidencia.
Diagrama editorial original de Ken Jo, basado en las fuentes indicadas al final.
Un cliente hace una pregunta, el agente responde correctamente y la transcripción parece perfecta. Sin embargo, la grabación revela otra interacción: el agente empieza demasiado pronto, tapa una corrección y deja un largo silencio antes de volver a responder.
La actualización de Confident AI del 23 de octubre de 2026 incorpora más de esa experiencia audible a su evaluación. La empresa anunció clasificadores directos de audio, una revisión humana, marcas temporales de problemas en el reproductor Observatory y trazado de audio de Pipecat. Estas funciones vinculan un problema sospechado con un momento que alguien puede escuchar. Registro oficial.
Confident AI ofrece herramientas de evaluación y observabilidad para aplicaciones de IA. Podemos entender esta versión con una pregunta práctica: ¿cómo convertir una conversación incómoda en un problema reproducible? Separaremos la evidencia de la transcripción y del audio, y construiremos un proceso pequeño para tres situaciones habituales de agentes de voz.
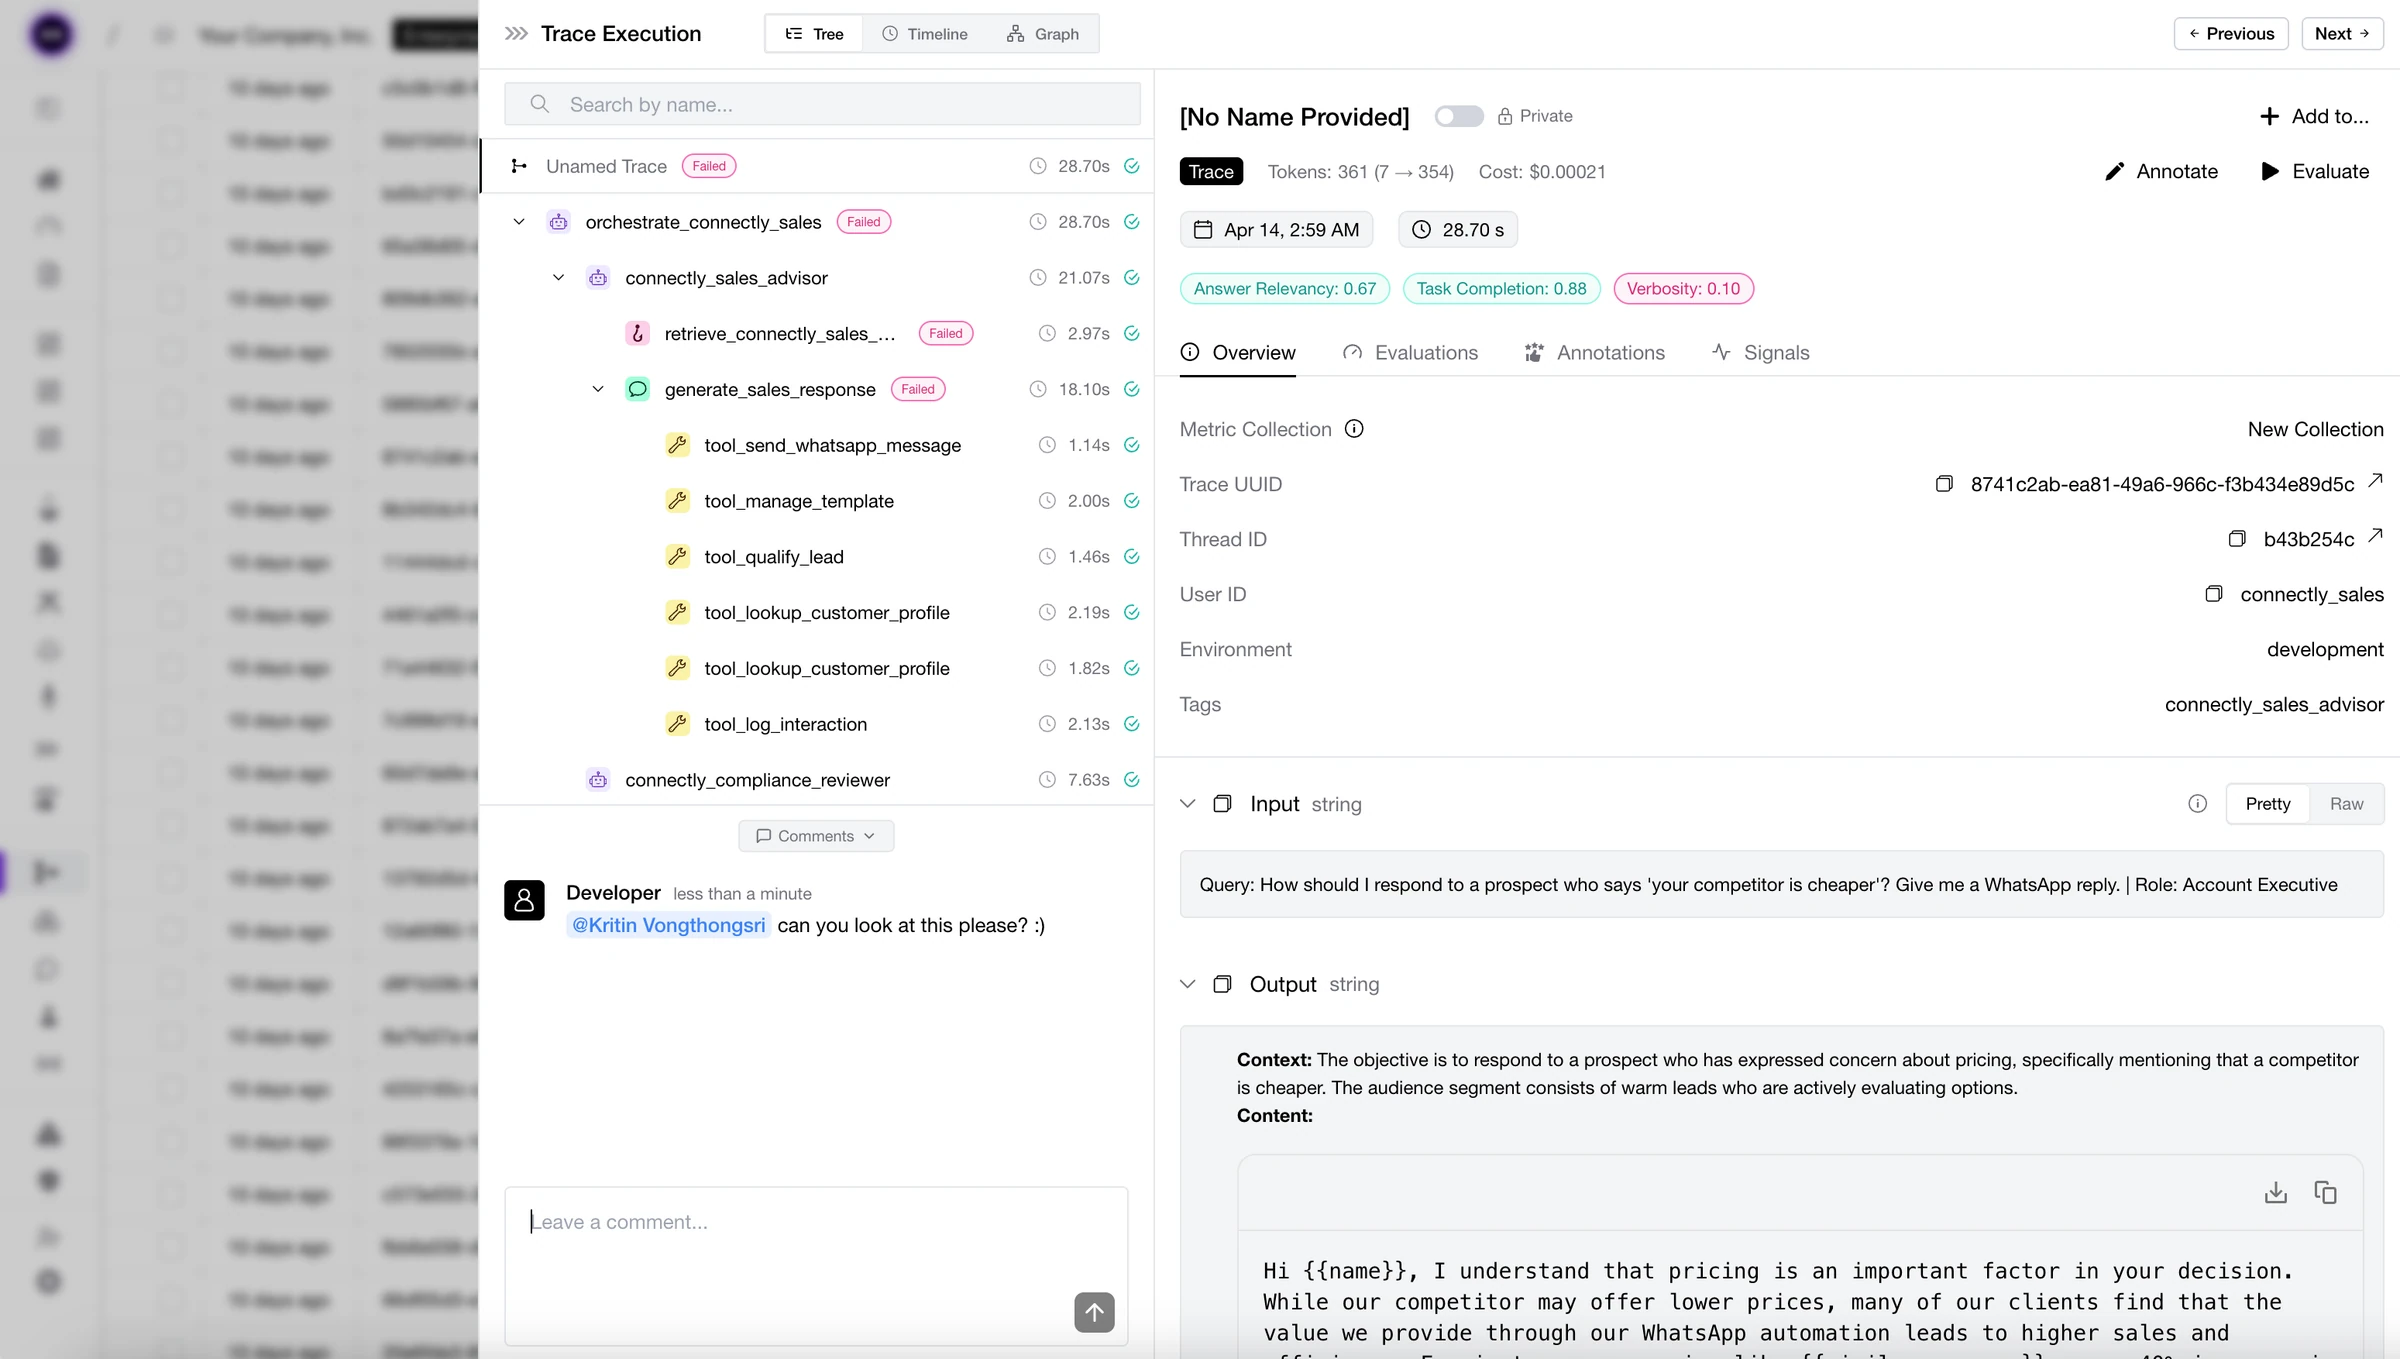
Imagen oficial de la documentación de Confident AI, © 2024 Confident AI Inc., Apache 2.0. Esta interfaz general muestra cómo se organiza la evidencia de ejecución; no representa el nuevo clasificador de audio ni mediciones de este artículo.

La transcripción conserva palabras; el audio conserva la interacción
Una transcripción permite inspeccionar de forma compacta si la respuesta contenía la información esperada. Puede revelar una fecha errónea, una instrucción ausente o una contradicción. También es fácil de buscar y comparar entre muchas conversaciones.
El audio responde a otras preguntas. ¿Había terminado de hablar la persona? ¿La aparente pausa era un momento de reflexión? ¿La expresión del agente hacía difícil entender una frase correcta? Leer solo texto depurado puede ocultar el hecho que volvió frustrante la llamada.
La distinción resulta especialmente útil cuando ambas evidencias discrepan. La transcripción puede incluir la pregunta completa aunque el agente empezara a responder a mitad. A la inversa, un fragmento extraño por escrito puede sonar natural como breve confirmación. Conserve ambas formas para que los revisores juzguen el contexto.
La guía de audio describe cómo adjuntar una grabación a un mensaje junto a su rol y texto, con reproducción dentro de la traza. Así se puede alternar entre lo representado por escrito y lo escuchado. Documentación de audio, consultada el 27 de octubre de 2026.
Creemos que la evaluación de voz necesita esta segunda pista. El intercambio hablado forma parte del producto, por lo que el texto final no representa toda su calidad. Vincular la grabación con el evento de la aplicación permite discutirla con más precisión.
Un hallazgo útil incluye un momento y una razón
La versión del 23 de octubre añade clasificadores destinados a detectar interrupciones, silencios incómodos y problemas de expresión. También incorpora un paso en el que una persona escucha antes de confirmar la etiqueta. El reproductor marca los momentos problemáticos para regresar a ellos. Nuevo proceso de audio.
Es un hallazgo más accionable que la queja general de que el agente sonaba mal. Un desarrollador necesita una ubicación, la descripción del comportamiento y suficiente contexto para entender lo esperado. La clasificación ayuda a priorizar dónde mirar; el fragmento proporciona evidencia comprobable.
Mantenga la diferencia entre sospecha y problema confirmado. Una pausa puede ser apropiada mientras el interlocutor consulta una referencia. Una superposición puede ser una confirmación útil en vez de una interrupción. La etiqueta aporta valor cuando refleja las expectativas conversacionales reales del equipo.
Escriba esas expectativas con palabras normales. Por ejemplo, una interrupción podría exigir que el agente comenzara una respuesta sustancial mientras la persona todavía aporta información, causando pérdidas o repeticiones. Es un criterio ilustrativo de revisión, no una definición impuesta por el producto.
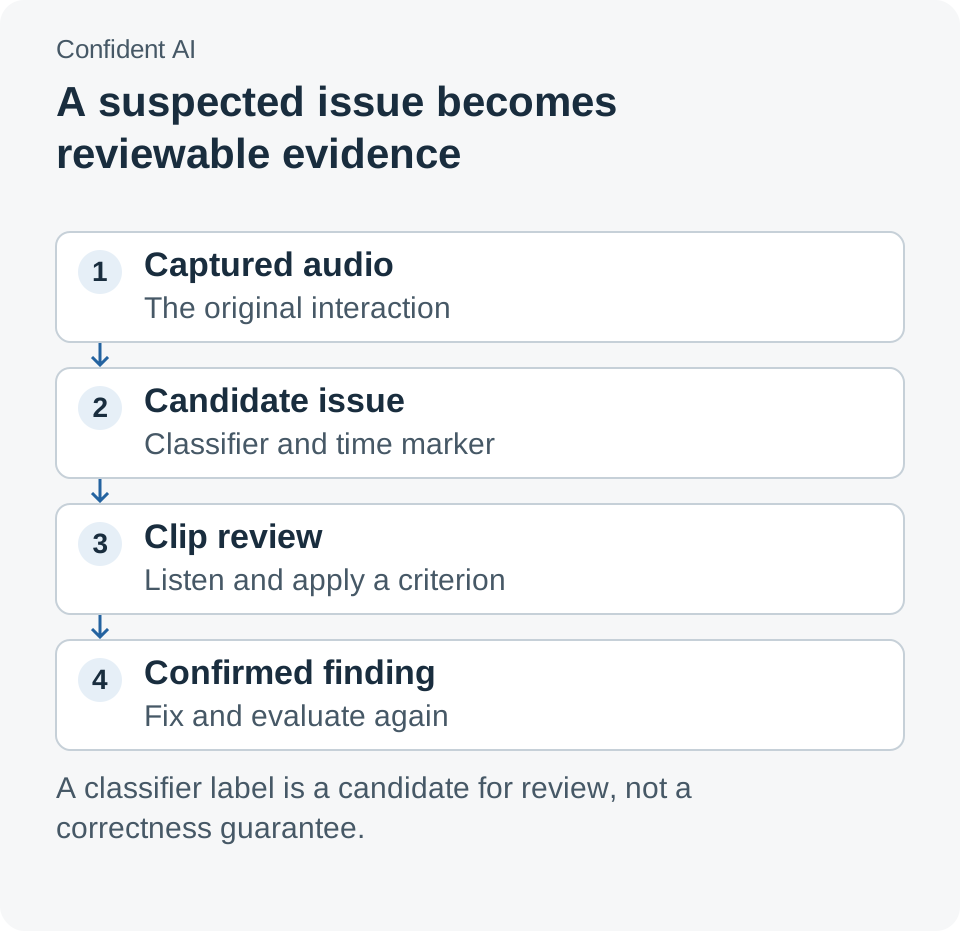
La clasificación localiza un posible problema. Escucharlo y aplicar un criterio claro lo convierte en un hallazgo sobre el que actuar.
Tres conversaciones muestran por qué el tiempo necesita contexto
Considere primero un asistente de citas. La persona pide cambiar una reserva, se detiene a consultar el calendario y después indica el día. Si el agente ofrece horarios durante esa pausa, su respuesta puede ser pertinente y aun así interrumpir la tarea.
En este ejemplo, el revisor debe escuchar antes y después de la interrupción. ¿El agente solo confirmó que había recibido la petición o fijó una interpretación prematura? ¿La persona pudo continuar con naturalidad o tuvo que empezar de nuevo? Esas observaciones distinguen un hábito aceptable de un defecto que conviene corregir.
El segundo escenario es soporte para un producto desconocido. El agente responde bien, pero la persona no sabe si la ha oído. Un intervalo largo sin confirmación puede provocar que repita la pregunta, que luego se interpreta como una nueva solicitud. Escuchar junto a la traza de ejecución ayuda a identificar dónde empezó la demora percibida.
No elija un umbral universal de silencio a partir de un solo caso. Consultar una cuenta y confirmar una instrucción simple generan expectativas distintas. Defina la interacción prevista para la tarea y compare las pausas con ella. La pregunta útil es qué entendió razonablemente la persona que estaba ocurriendo.
El tercer escenario es un asistente multilingüe que gestiona una dirección o un código de producto. La transcripción puede contener una frase plausible mientras la pronunciación original apunta a otra palabra. Reproducir ambas partes ayuda a separar problemas de reconocimiento, interpretación o expresión.
Eso no convierte todos los errores en problemas del clasificador de audio. La aplicación quizá necesita una confirmación, mejor vocabulario o una forma más explícita de pedir que se repita un dato crítico. La evaluación vale cuando conduce a un cambio apropiado, no a un intento genérico de sonar más amable.
| Evidencia que inspeccionar | Qué ayuda a establecer | Qué contexto sigue haciendo falta |
|---|---|---|
| Transcripción | Palabras registradas y contenido de la respuesta | Si los turnos y la pronunciación eran comprensibles |
| Fragmento de audio | Tiempo, superposición, silencio y expresión | Si el comportamiento perjudicó la tarea prevista |
| Traza de la aplicación | Pasos y operaciones de herramientas ejecutados | Si la interacción final resolvió la necesidad |
| Nota de revisión humana | Interpretación confirmada y justificada | Si un cambio posterior corrige realmente el mismo caso |
Capturar una traza no garantiza una grabación reproducible
Antes de evaluar audio, confirme que existe evidencia. La documentación multimodal distingue medios integrados, enlaces y archivos omitidos. La captura general de llamadas al modelo conserva imágenes y PDF integrados compatibles; el audio requiere un adjunto adecuado o una integración de voz admitida. Trazado multimodal, actualizado el 9 de octubre de 2026.
La diferencia afecta al trabajo diario. Una URL en la traza referencia un archivo, pero no garantiza una copia conservada. Si la ubicación caduca o el revisor carece de acceso, la traza sigue visible mientras la evidencia sonora desaparece. Incluya la reproducción en la primera comprobación de integración.
La misma documentación indica 5 MiB por elemento multimedia de forma predeterminada y 16 MiB en total por span en el SDK de TypeScript. Los medios demasiado grandes se omiten, no se recortan. Trate deliberadamente las grabaciones grandes; que llegue la traza textual no demuestra que el audio también quepa. Límites multimedia.
La guía específica coloca audio en un mensaje con rol y contenido. Conserve quién produjo la grabación y qué texto le corresponde. Un fragmento asociado al mensaje incorrecto puede llevar a una conclusión errónea aunque se reproduzca bien.
Empiece con doce fragmentos que expliquen la tarea
Un piloto práctico puede comenzar con 12 fragmentos seleccionados deliberadamente: cuatro interacciones normales exitosas, cuatro fallos evidentes y cuatro casos ambiguos que requieren discusión. Es una propuesta para calibrar la revisión, no una muestra estadísticamente representativa ni un benchmark del proveedor.
Los casos ambiguos son especialmente valiosos. Revelan si los revisores comparten definiciones de interrupción, espera aceptable y expresión clara. Si discrepan, registre el motivo antes de pedir al clasificador automático que reproduzca una etiqueta supuestamente acordada.
Use un procedimiento repetible para que la primera evaluación produzca más que impresiones:
- Cree un proyecto para un uso concreto del agente de voz. Limite el alcance para aplicar las mismas expectativas conversacionales a los fragmentos.
- Vincule grabación y transcripción con la misma interacción. Use el adjunto de audio documentado o la integración de voz adecuada. Compruebe que se pueden reproducir ambas partes de un intercambio representativo.
- Revise la evidencia con los límites predeterminados. Busque marcas de omisión, enlaces inaccesibles y asociaciones incorrectas. Corrija la captura antes de interpretar audio ausente como una llamada sin incidentes.
- Defina pocas etiquetas de revisión. Describa concretamente cada comportamiento e incluya un caso parecido que sí deba aceptarse.
- Clasifique y escuche los momentos señalados. Conserve la etiqueta candidata, la decisión confirmada y la explicación. Escuche también fragmentos no señalados para descubrir problemas omitidos.
- Cambie una parte relevante y repita. Compare los mismos casos después del cambio y añada ejemplos nuevos antes de ampliar el proceso.
La guía de clasificadores explica que la descripción de las etiquetas afecta a la clasificación y que los resultados se vuelven señales filtrables. La guía general anterior y el lanzamiento del 23 de octubre describen etapas distintas; use los controles actuales del espacio de trabajo para el nuevo proceso de audio. El principio duradero es concretar el comportamiento deseado para que otro revisor pueda aplicar el criterio. Guía de clasificación.
Mida el proceso de revisión además del agente
Más problemas detectados puede significar varias cosas: el agente empeoró, el clasificador se volvió más sensible o las conversaciones son más difíciles. Mantenga visibles la configuración y el conjunto de llamadas revisadas para distinguir esas posibilidades.
En el piloto, registre cuántos fragmentos señalados se confirman y cuántos problemas aparecen entre los no señalados. Anote también el tiempo necesario para localizar el momento relevante. Son observaciones del proceso del equipo, sin afirmar una precisión universal del clasificador.
Cuando un cambio mejore un fragmento, explique qué mejoró. La persona terminó la pregunta antes de la respuesta. Oyó una confirmación durante una consulta. El asistente verificó un código incierto antes de actuar. Estos resultados son más útiles que afirmar ampliamente que el modelo suena natural.
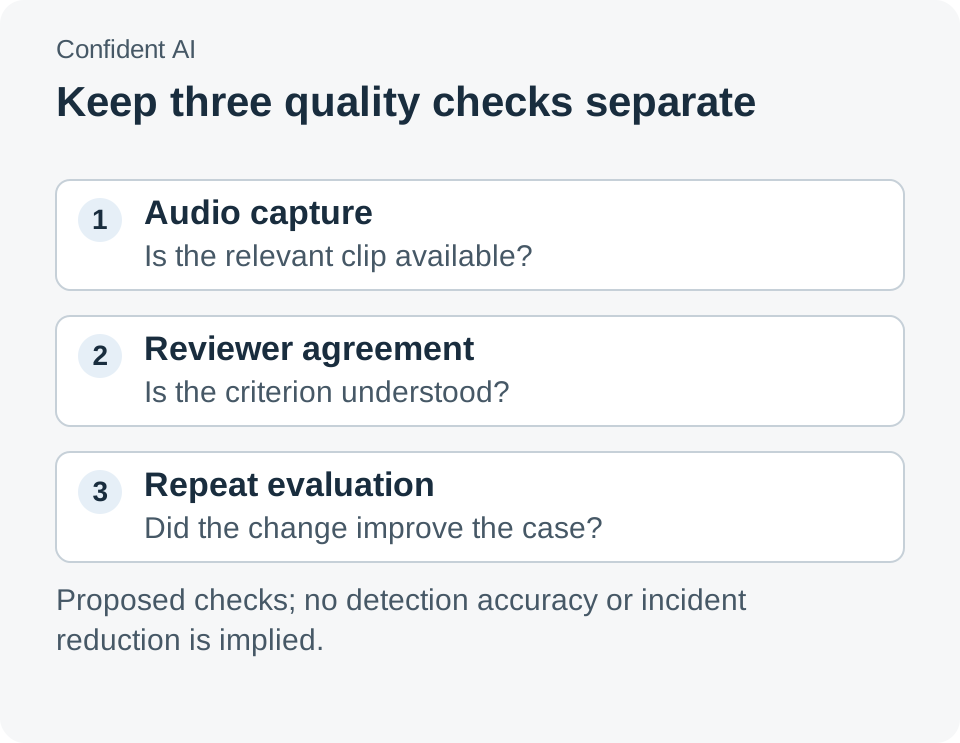
Una revisión fiable comprueba por separado la evidencia, su interpretación y el efecto del cambio.
Acceso y almacenamiento también forman parte del diseño
Las grabaciones pueden contener información que no hace falta en cada revisión. Decida qué conversaciones conservar, quién puede escucharlas y durante cuánto tiempo son útiles. Use el conjunto mínimo significativo para el piloto, en lugar de recopilar ampliamente sin un objetivo de evaluación.
La guía de tratamiento de datos describe proyectos separados, con sus propios datos y permisos. Es un límite organizativo práctico: revisar un caso de uso no implica necesitar automáticamente las grabaciones de otro. Tratamiento de datos, actualizado el 14 de octubre de 2026.
El registro del 23 de octubre también introduce contabilidad por créditos y almacenamiento de trazas medido en GB-mes. Antes de ampliar la recopilación, compruebe el plan vigente y el uso real. Ingerir los datos correctamente solo es una parte de un proceso asequible y mantenible. Cambios de uso.
La calidad de la conversación resulta útil cuando puede escucharse de nuevo
La dirección interesante del lanzamiento conecta el juicio de calidad con la experiencia real. Una marca temporal, un fragmento reproducible y una decisión de revisión dan al desarrollador algo concreto que mejorar. También ofrecen un registro al que volver después de cambiar un modelo o una regla de interacción.
Un agente natural gana confianza durante todo el intercambio: escucha, responde en el momento adecuado y completa la tarea claramente. Evalúe estas partes juntas y la grabación será evidencia para una mejor conversación, no otro archivo en un sistema de supervisión.
Fuentes
- Registro de cambios de Confident AI, 23 de octubre de 2026.
- Audio en trazas, consultado el 27 de octubre de 2026.
- Trazado multimodal y límites, actualizado el 9 de octubre de 2026; consultado el 27 de octubre.
- Tareas de clasificación, actualizadas el 6 de octubre de 2026. El registro del 23 de octubre documenta las nuevas funciones de audio y spans.
- Tratamiento de datos, actualizado el 14 de octubre de 2026.
- Imagen oficial y repositorio de documentación, licencia Apache 2.0. Los escenarios y el piloto de doce fragmentos son ilustrativos; no se midió la precisión del detector mediante benchmark.
Una recomendación de Telli.sh
Conserve accesibles las notas de revisión, transcripciones de ejemplo y decisiones que motivaron un cambio en la conversación. Cree una cuenta de Telli.sh para organizar grabaciones y notas de referencia.