[Notatnik pomysłów AI 03] ColGrep-Agent: lokalny zwiadowca znajduje kod, zanim przeczyta go duży model
Poznaj lokalnego agenta wyszukiwania kodu LightOn: jego wyniki, współpracę z asystentami programistycznymi i sposób oceny oszczędności tokenów bez mylenia wyszukiwania z gotową poprawką.
Notatnik pomysłów AI przybliża idee i praktyczne możliwości nowych modeli i narzędzi AI.
Zgłoszenie błędu mówi, że wysyłanie kończy się zbyt wcześnie. Repozytorium ma setki plików, kilka procedur postępu i podobnie nazwane pola stanu. Zanim asystent AI zaproponuje naprawę, może znaczną część pracy poświęcić na znalezienie kodu odpowiedzialnego za ukończenie.
ColGrep-Agent, zapowiedziany przez LightOn 12 października 2026 r., wykonuje ten etap lokalnie. Przegląda repozytorium i zwraca głównemu asystentowi ścieżki, zakresy linii oraz kod. Idea przypomina lokalnego zwiadowcę: mniejszy specjalista odnajduje szlak, zanim większy model zacznie rozumować nad naprawą. Zapowiedź LightOn
Ten artykuł wyjaśnia składniki, praktyczną drogę startu i pomiary pierwszego porównania. Atutem jest mniejszy narzut wyszukiwania. Pytanie brzmi, czy korzyść utrzyma się w rzeczywistym repozytorium, przy twoich pytaniach i sprzęcie.
 Publiczna strona modelu, zrzut z 20 października 2026 r. To opublikowana karta, nie dowód uruchomienia modelu na naszym komputerze.
Trzy nazwy opisują trzy elementy przepływu pracy
ColGrep jest narzędziem wyszukiwania semantycznego. ColGrep-Agent-2B to nazwa wydanego modelu. Polecenie colgrep --agent uruchamia model w ograniczonym środowisku wyszukiwania; oznacza działające połączenie, nie kolejną rodzinę modeli. Oficjalne wyjaśnienie
Ten podział pomaga zdecydować, ile infrastruktury dodawać. Programista może chcieć wyszukiwania semantycznego w terminalu bez pętli agenta. Inny zespół woli, by asystent zadawał lokalnemu agentowi pytanie i otrzymywał mniejszy, trafniej dobrany pakiet kontekstu.
System łączy zapytania o znaczenie z dokładnymi ograniczeniami, takimi jak ścieżki i wzorce. Rozwiązują one odmienne problemy. Pytanie w języku naturalnym lokalizuje zachowanie o nieznanych identyfikatorach, a wyszukiwanie dokładne nadal przydaje się dla nazwy funkcji ze śladu stosu.
Dla początkującego wynik jest prosty: krótka lista miejsc do obejrzenia. Nadal trzeba zrozumieć kod, sprawdzić sąsiednie kontrakty i uruchomić testy po zmianie. Użyteczna lokalizacja to dane do naprawy, nie sama naprawa.
Dlaczego pętla wyszukiwania bywa kosztowna
Asystent często wyszukuje termin, otwiera plik, zauważa inny identyfikator, podąża za odwołaniem i szuka ponownie. Każdy krok może powiększać kontekst kolejnych wywołań modelu. Repozytorium łatwe dla opiekuna bywa kosztowne dla asystenta, który widzi je pierwszy raz.
ColGrep-Agent przenosi te kroki do lokalnej pętli. Główny asystent pyta, zwiadowca przeszukuje i czyta kandydatów, a zwrócony kontekst wskazuje uznane za istotne miejsca. Podział dotyczy odpowiedzialności za eksplorację, nie przekazania lokalnemu modelowi wszystkich zadań programistycznych.
Wyobraź sobie badanie, dlaczego sesja nagrywania nie odzyskuje działania po ponownym połączeniu. Szerokie wyszukanie „reconnect” znajdzie pomocniczy transport, powiadomienia interfejsu i stare testy. Przydatny wynik musi zawęzić listę do aktualnego właściciela sesji i funkcji odtwarzających połączenia.
Dlatego krótsza odpowiedź nie musi oznaczać lepszego wyszukiwania. Jeśli zwiadowca pominie plik wyjaśniający końcowy zapis, główny asystent może stworzyć przekonującą, niepełną poprawkę. Celem jest mniej nieistotnego kontekstu przy zachowaniu dowodów potrzebnych do zadania.
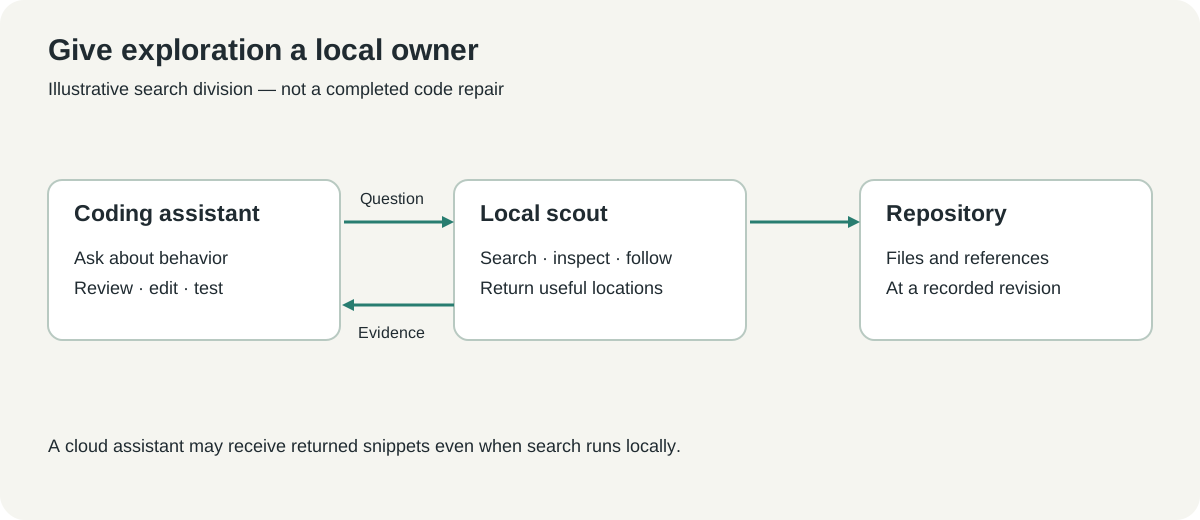 Autorski schemat udokumentowanego podziału pracy. Pytanie i zwrócone lokalizacje są ilustracyjne.
Główny wynik dotyczy konkretnie wyszukiwania kodu
LightOn podaje 34% mniej tokenów API i 40% niższy koszt API z uwzględnieniem pamięci podręcznej względem grep w badaniu 52 pytań o kod w 13 repozytoriach. To pomiary wydawcy dla tego porównania. Nie dowodzą spadku kosztu tworzenia lub utrzymania aplikacji o 40%. Opis badania
Zakres jest ważny, bo praca programistyczna ma wiele kosztów. Wyszukiwanie może się skurczyć, a rozumowanie implementacyjne pozostać bez zmian. Czas mogą zdominować testy. Model oszczędzający tokeny chmurowe może jednocześnie korzystać z lokalnego CPU, GPU, pamięci i indeksowania.
Rozdziel trzy pytania: czy znaleziono właściwy kod, czy zadanie ukończono poprawnie i jakie zasoby pochłonęła całość? Pomiar tylko najłatwiejszego pozostawia dwa pozostałe bez odpowiedzi. Zespół powinien wybrać kompromis zgodny z pracą, zamiast traktować procent jako uniwersalną prognozę.
Powtarzane prompty komplikują także ceny. Dostawca może osobno wyceniać wejście z pamięci podręcznej, wejście bez niej i wygenerowane wyjście. Rejestruj je oddzielnie, jeśli narzędzie ujawnia dane, a aktualny na konkretny dzień cennik stosuj po zebraniu zużycia.
Zacznij od repozytorium, które potrafisz ocenić
Oficjalny start opisuje instalację na macOS, Windows i budowanie ze źródeł. Użyj czystej kopii albo repozytorium o znanym stanie, przeczytaj instrukcję wydania przed uruchomieniem instalatora. Nie zaczynaj od udostępnienia nieznanemu narzędziu nieprzejrzanego środowiska produkcyjnego. Dokumentacja ColGrep
Dla czytelnika macOS używającego Homebrew zapowiedź LightOn pokazuje:
brew install lightonai/tap/colgrep
colgrep --install-agent
Drugie polecenie przygotowuje model lokalny, zamiast wykupywać hostowane wnioskowanie. Opis wydania podaje domyślne pobranie modelu skwantyzowanego o wielkości około 2.5 GB. To wielkość pobierania z dokumentacji, nie kompletny budżet pamięci lub dysku każdej konfiguracji. Przygotowanie modelu
Na Windows korzystaj z aktualnej ścieżki PowerShell w oficjalnym repozytorium i przejrzyj instalator. Dostępne środowisko wykonawcze oraz akceleracja zależą od maszyny. Powodzenie na Macu nie dowodzi identycznej konfiguracji, szybkości ani zużycia zasobów na Windows.
Taka kolejność pierwszego uruchomienia ułatwi zrozumienie eksperymentu:
- Zapisz commit i stan drzewa roboczego. Wybierz pytanie ze znanym odpowiednim kodem.
- Zainstaluj udokumentowaną metodą, a potem przeczytaj
colgrep --helpi instrukcję indeksowania dla tej wersji. - Najpierw uruchom zwykłe wyszukiwanie semantyczne. Sprawdź, czy pomijane pliki i katalogi odpowiadają oczekiwaniom.
- Wypróbuj
colgrep --agentwedług pomocy zainstalowanej wersji. Obejrzyj każdą zwróconą lokalizację. - Połącz wspieranego asystenta dopiero, gdy samodzielne wyszukiwanie jest użyteczne. Zachowaj dotychczasową konfigurację do porównań.
To kroki konfiguracji i oceny, nie relacja z instalacji wykonanej do tego artykułu. Wprowadzenie ma pomóc wybrać ćwiczenie bez wymyślania jego wyniku.
Pytaj o zachowanie, zamiast narzucać plik
Dobre pytanie opisuje zdarzenie i szukane zachowanie. „Gdzie zaakceptowane wysyłanie staje się ukończone po przetworzeniu w tle?” mówi więcej niż „znajdź kod wysyłania”. Daje zwiadowcy kontrakt do odnalezienia, nie zamykając drogi do rzeczywistego właściciela.
Nie umieszczaj proponowanej poprawki w pytaniu. Szukanie tylko funkcji mającej ustawiać flagę może podążyć za twoim założeniem i pominąć komponent, który powinien zarządzać stanem. Zacznij od obserwacji użytkownika, potem sprawdź implementację, która ją wyjaśnia.
Trzy ćwiczenia obejmują różne wzorce nawigacji: gdzie uwierzytelnia się żądanie, gdzie zadanie w tle zapisuje wynik końcowy i gdzie frontend subskrybuje aktualizację statusu. Zachęcają do śledzenia odpowiedzialności między plikami zamiast dopasowania jednego identyfikatora.
Dokładne ciągi nadal mają zastosowanie. Ślad stosu, ścieżka trasy lub kod błędu uściśla pytanie. Połącz taki dowód z opisem zachowania, żeby wyszukiwanie nie odrywało się od wadliwego przepływu.
Oceniaj lokalizacje przed oceną prozy
Otwórz sugerowane linie i przeczytaj dość otoczenia, by zrozumieć odpowiedzialność funkcji. Numer linii może być poprawny, a fragment mylący, gdy pomija warunek ochronny, wywołującego lub końcowy zapis. Kontekst ma umożliwiać sprawdzenie twierdzenia, nie tylko sprawiać wiarygodne wrażenie.
Liczy się commit repozytorium. Przydatna ścieżka i zakres linii mogą się zdezaktualizować po refaktoryzacji. Powiąż wynik z rewizją oceny i odświeżaj indeks zgodnie z dokumentacją narzędzia po zmianach źródeł.
| Wynik wyszukiwania | Co sprawdzić | Dlaczego to ważne |
|---|---|---|
| Właściwy właściciel i przydatne otoczenie | Czy kod realizuje zachowanie z pytania? | Potwierdza możliwość działania na podstawie wyniku |
| Tylko powiązana funkcja pomocnicza | Czy brakuje wywołującego lub właściciela stanu? | Zapobiega lokalnej edycji pozostawiającej uszkodzony kontrakt |
| Test bez implementacji | Czy opisuje stan obecny, czy dawne oczekiwanie? | Łączy dowód z implementacją |
| Wiele przekonujących plików | Czy da się wskazać mniejszy zestaw bez utraty istotnego kontekstu? | Pokazuje zmniejszenie pracy przeglądu |
W pilotażu poproś opiekuna o wskazanie oczekiwanych plików przed zobaczeniem odpowiedzi. Inaczej łatwo zaakceptować wiarygodne miejsce i po cichu zmienić definicję sukcesu. Pytania niejednoznaczne traktuj osobno, zamiast udawać, że każdy problem ma dokładnie jeden właściwy plik.
Uwzględnij lokalny rachunek w porównaniu
Uruchom te same pytania starą i nową metodą na tej samej rewizji. Mały zestaw może zawierać kilkanaście zwykłych pytań i kilka trudniejszych o odpowiedzialność. To propozycja pilotażu, nie oficjalny benchmark ani gwarancja pewności statystycznej.
Zapisz obecność znanego istotnego pliku, ilość niepotrzebnego kodu, tokeny chmurowe i czas. Oddziel budowanie indeksu od kolejnych wyszukiwań. Koszt startu bywa rozsądny dla często używanego repozytorium, lecz nieatrakcyjny przy jednorazowej nawigacji.
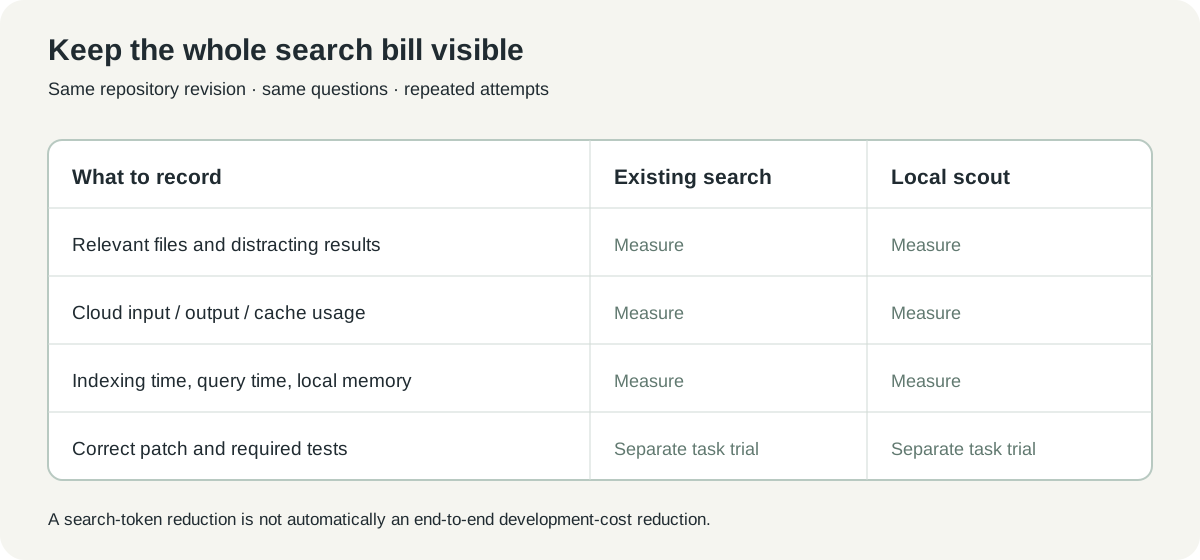 Autorski rejestr oceny. Puste pola są celowe: zbierz własne wartości, zanim ocenisz opłacalność kompromisu.
Jeżeli porównujesz też kompletne naprawy, potraktuj to jako osobny eksperyment. Zachowaj zgłoszenie, migawkę repozytorium, kryteria testów i konfigurację modelu, a potem oceń poprawkę. Zwycięstwo w wyszukiwaniu może nie powtórzyć się przy eksploracji, edycji, interpretacji testów i kolejnych korektach.
Powtarzaj kilka pytań, zamiast ufać szczęśliwemu uruchomieniu. Agent może wybierać różne ścieżki. Wynikiem bywa niższe typowe zużycie tokenów, ale wolniejsze trudne pytania — rzeczywisty kompromis niewidoczny w jednej liczbie zbiorczej.
Lokalne wyszukiwanie nie przenosi chmurowego asystenta offline
LightOn opisuje lokalne indeksowanie i wnioskowanie agenta. Etap wyszukiwania może pozostać na komputerze, lecz zintegrowany asystent chmurowy nadal otrzymywać wybrany kod. Oceń całą trasę od pytania do końcowego wywołania, zamiast utożsamiać „lokalne wyszukiwanie” z „żaden kod nie opuszcza komputera”. Opis architektury
Świadomie przejrzyj wykluczenia repozytorium. Katalogi generowane wprowadzają szum, a dane logowania i prywatne eksporty nie powinny stawać się materiałem wyszukiwania tylko dlatego, że leżą w katalogu projektu. Użyj udokumentowanego ignorowania i zwykłych praktyk organizacji.
Wyszukiwanie tylko do odczytu jest dobrym ograniczeniem zwiadowcy, lecz nie zatwierdza późniejszej zmiany. Główny asystent nadal respektuje instrukcje repozytorium, zachowuje bieżącą pracę i weryfikuje naprawę. Nawigacja i upoważnienie są odrębnymi obowiązkami.
W zespole opisz te granice w dokumentacji integracji. Użytkownicy powinni wiedzieć, gdzie jest indeks, jaki model działa lokalnie, które fragmenty trafiają do innej usługi i jak wyłączyć połączenie. Jasna odpowiedzialność utrzymuje zrozumiałość eksperymentu po odejściu autora.
Najlepsza oszczędność to mniej nieistotnej eksploracji
Naszym zdaniem ColGrep-Agent pokazuje praktyczny sens specjalizacji. Asystent nie musi zużywać najdroższych kroków rozumowania na każde przeszukanie katalogu, jeśli lokalny zwiadowca niezawodnie zwraca dowody. Właśnie niezawodność ma ustalić pilotaż.
Zacznij od jednego repozytorium i pytania ocenialnego przez opiekuna. Jeśli lokalizacje zmniejszają lekturę bez ukrywania właściciela zachowania, rozszerz próbę. Celem jest krótsza droga do poprawnej zmiany, z mierzonym kosztem wyszukiwania.
Źródła i materiały graficzne
Sprawdzono 20 października 2026 r. Liczby wydajności są wynikami wyszukiwania kodu podanymi przez LightOn. Nie deklarujemy lokalnej instalacji, pomiarów opóźnienia ani pełnego benchmarku programistycznego. Autor wykonał publiczny zrzut; schematy są autorskie. Atrybucja i licencje znajdują się w rejestrze materiałów.
- Zapowiedź i badanie LightOn z 12 października 2026 r.
- Dokumentacja i źródła ColGrep
- Karta ColGrep-Agent
- Licencja Apache 2.0 repozytorium
Łącz zgłoszenie z dowodami
Przechowuj razem oryginalne zgłoszenie, pytanie wyszukiwania, odnośniki do kodu i notatki z przeglądu. Telli.sh pomaga uporządkować taki zapis analizy. Utwórz konto Telli.sh