[Taccuino di idee sull'IA 03] ColGrep-Agent: lascia che un esploratore locale trovi il codice prima che lo legga il modello grande
Scopri l'agente di LightOn per la ricerca locale nel codice: cosa restituisce, come lavora con gli assistenti di programmazione e come verificare il risparmio di token dichiarato senza confondere una ricerca con una correzione conclusa.
Taccuino di idee sull'IA esplora le idee e le possibilità pratiche dei nuovi modelli e strumenti di IA.
Una segnalazione dice che un caricamento termina troppo presto. Il repository contiene centinaia di file, diversi gestori dell'avanzamento e alcuni campi di stato dai nomi simili. Prima di proporre una riparazione, un assistente IA può spendere gran parte del turno soltanto per trovare il codice responsabile del completamento.
ColGrep-Agent, annunciato da LightOn il 12 ottobre 2026, gestisce localmente questa fase di ricerca. Esplora un repository e restituisce percorsi di file, intervalli di righe e codice pertinenti all'assistente principale di programmazione. L'idea è un esploratore locale: lasciare che uno specialista più piccolo trovi la pista prima di chiedere a un modello più grande di ragionare sulla correzione. Annuncio di LightOn
Questa introduzione spiega i componenti, il percorso pratico per iniziare e cosa misurare nel primo confronto. Il vantaggio atteso è ridurre il lavoro accessorio della ricerca. La domanda è se la riduzione regge con il repository, le domande e l'hardware che usi davvero.
 La pagina pubblica del modello, acquisita il 20 ottobre 2026. È la schermata della scheda pubblicata, non la prova che il modello sia stato eseguito sulla nostra macchina.
Tre nomi descrivono tre parti del flusso di lavoro
ColGrep è lo strumento di ricerca semantica. ColGrep-Agent-2B è il nome del modello rilasciato. Il comando colgrep --agent esegue il modello in un ambiente di ricerca vincolato: è la combinazione operativa, non un'altra famiglia di modelli. Spiegazione ufficiale
Questa distinzione è utile per scegliere quanta infrastruttura aggiungere. Uno sviluppatore può volere ricerca semantica nel terminale senza un ciclo agente. Un altro gruppo può volere che un assistente di programmazione interroghi l'agente locale e riceva un pacchetto di contesto più piccolo e mirato.
Il sistema combina query basate sul significato con vincoli esatti, come percorsi o schemi. Sono approcci che risolvono problemi diversi. Una domanda in linguaggio naturale può localizzare un comportamento dagli identificatori sconosciuti, mentre la ricerca esatta resta preziosa per il nome di una funzione copiato da una traccia d'errore.
Per chi inizia, l'output importante è semplice: una breve lista di punti da esaminare. Occorre ancora capire il codice, controllare i contratti circostanti ed eseguire i test pertinenti dopo averne modificato il comportamento. Una posizione utile è un ingresso per una correzione, non la correzione stessa.
Perché il ciclo di ricerca può diventare costoso
Un assistente di programmazione segue spesso una sequenza: cerca un termine, apre un file, nota un altro identificatore, segue un riferimento e cerca di nuovo. Ogni passo può aggiungere contesto alle chiamate successive del modello. Un repository facile da navigare per chi lo mantiene può comunque costare molto a un assistente che lo incontra per la prima volta.
ColGrep-Agent sposta questi passaggi esplorativi in un ciclo locale. L'assistente principale pone una domanda, l'esploratore cerca e legge i file candidati e il contesto restituito identifica le posizioni giudicate pertinenti. La divisione riguarda chi si occupa dell'esplorazione, anziché chiedere al modello locale di risolvere ogni attività di programmazione.
Immagina di indagare perché una sessione di registrazione non riprende dopo una riconnessione. Una ricerca ampia di «reconnect» può restituire utilità di trasporto, notifiche dell'interfaccia e vecchi test. Un risultato utile deve restringere l'elenco al responsabile attuale della sessione e alle funzioni che ne ricreano le connessioni.
È anche il motivo per cui una risposta più breve non è automaticamente una ricerca migliore. Se l'esploratore esclude l'unico file che spiega la persistenza finale, l'assistente principale può produrre una correzione convinta ma incompleta. Lo scopo è ridurre il contesto irrilevante mantenendo le prove necessarie per il compito.
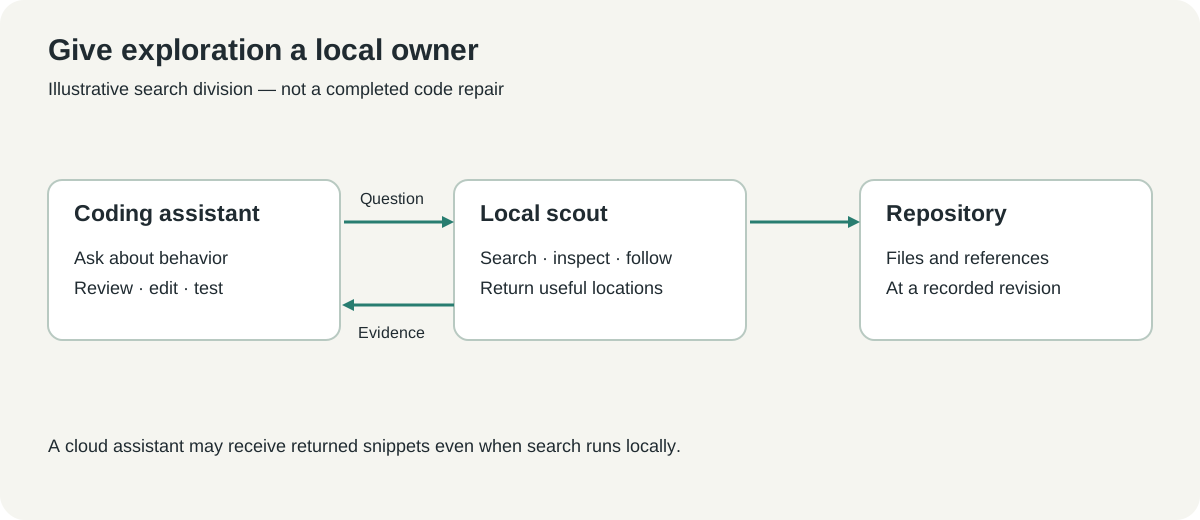 Diagramma esplicativo originale della divisione del lavoro documentata. La domanda di esempio e le posizioni restituite sono illustrative.
Il risultato in evidenza riguarda specificamente la ricerca nel codice
LightOn riporta il 34% di token API in meno e un costo API inferiore del 40% tenendo conto della cache rispetto a grep, in uno studio su 52 domande di ricerca nel codice distribuite su 13 repository. Sono misure dell'editore per quel confronto. Non dimostrano una riduzione del 40% dei costi di sviluppo o manutenzione di un'applicazione. Descrizione dello studio
Il perimetro conta perché il lavoro software ha diversi costi. La ricerca può ridursi mentre il ragionamento sull'implementazione resta invariato. L'esecuzione dei test può dominare il tempo trascorso. Un modello che risparmia token cloud può anche consumare CPU, GPU, memoria e tempo di indicizzazione locali.
Pensa a tre domande separate: la ricerca ha trovato il codice giusto, il compito di programmazione è terminato correttamente e quali risorse ha consumato l'intera attività? Misurare soltanto la più facile lascia le altre due senza risposta. Un gruppo dovrebbe scegliere il compromesso adatto al proprio lavoro, invece di adottare una percentuale come previsione universale.
Anche i prompt ripetuti complicano i confronti di prezzo. Un fornitore può applicare tariffe diverse a input in cache, input non in cache e output generato. Registrali separatamente quando lo strumento fornisce queste informazioni, e applica un listino datato soltanto dopo aver ottenuto i conteggi d'uso.
Parti da un repository che puoi esaminare con sicurezza
Le istruzioni ufficiali offrono percorsi di installazione per macOS, Windows e compilazione dai sorgenti. Parti da una copia pulita o da un repository di cui comprendi lo stato e leggi le istruzioni del rilascio prima di eseguire un programma d'installazione. Non iniziare consegnando a uno strumento sconosciuto un'area di produzione non esaminata. Documentazione ColGrep
Per chi usa Homebrew su macOS, l'annuncio LightOn mostra:
brew install lightonai/tap/colgrep
colgrep --install-agent
Il secondo comando prepara il modello locale anziché attivare un abbonamento a un endpoint di inferenza ospitato. Il rilascio descrive un download predefinito del modello quantizzato di circa 2.5 GB. È una dimensione di download riportata dalla documentazione, non un budget completo di memoria o disco per ogni configurazione. Preparazione del modello
Chi usa Windows dovrebbe seguire il percorso PowerShell attuale del repository ufficiale ed esaminare l'installer prima dell'esecuzione. Runtime e accelerazione disponibili dipendono dalla macchina. Non presumere che un comando riuscito su Mac dimostri configurazione, velocità o consumo equivalenti su Windows.
Usa questa sequenza iniziale per mantenere comprensibile l'esperimento:
- Registra il commit del repository e lo stato dell'albero di lavoro. Scegli una domanda di cui conosci il codice pertinente.
- Installa attraverso un percorso documentato, poi leggi
colgrep --helpe le istruzioni di indicizzazione della versione installata. - Esegui una semplice ricerca semantica prima di abilitare l'integrazione dell'agente. Verifica che file ignorati e directory escluse corrispondano alle attese.
- Prova
colgrep --agentcon l'invocazione indicata dalla guida di quella versione. Esamina ogni posizione restituita nel repository. - Collegalo a un assistente di programmazione supportato soltanto quando la ricerca autonoma è utile. Conserva la configurazione precedente per il confronto.
Sono passaggi di configurazione e valutazione, non il resoconto di un'installazione eseguita per questo articolo. Un'introduzione dovrebbe aiutarti a scegliere un primo esercizio senza inventare il risultato che vedrai.
Chiedi del comportamento invece di imporre un file
Una buona domanda descrive l'evento e il comportamento da localizzare. «Dove un caricamento accettato diventa completo dopo la conclusione dell'elaborazione in background?» è più informativo di «trova il codice degli upload». Fornisce all'esploratore un contratto da cercare, lasciandogli spazio per scoprire il responsabile effettivo.
Evita di inserire nella domanda la correzione che proponi. Se chiedi soltanto la funzione che dovrebbe impostare un determinato flag, la ricerca può seguire la tua ipotesi e perdere il componente che dovrebbe possedere lo stato. Parti da ciò che osserva l'utente, poi esamina l'implementazione che lo spiega.
Tre domande di esercizio utili coprono schemi di navigazione diversi. Chiedi dove si autentica una richiesta, dove un lavoro in background persiste il risultato finale e dove il frontend si iscrive a un aggiornamento di stato. Sono attività illustrative che incoraggiano a seguire le responsabilità tra file invece di trovare un unico identificatore.
Le stringhe esatte hanno ancora un ruolo. Una traccia d'errore, un percorso di rotta o un codice di errore possono rendere una domanda molto più precisa. Combina queste prove con una descrizione del comportamento osservato, per non separare la ricerca dal flusso che non funziona.
Valuta le posizioni restituite prima della prosa
Apri le righe suggerite e leggi abbastanza codice circostante da capire la responsabilità della funzione. Un numero di riga può essere corretto mentre il frammento inganna perché omette una condizione di protezione, un chiamante o un passaggio finale di persistenza. Il contesto dovrebbe permettere di verificare l'affermazione, non soltanto renderla plausibile.
Qui conta il commit del repository. Un percorso e un intervallo utili possono diventare obsoleti dopo una rifattorizzazione. Associa il risultato alla stessa revisione usata durante la valutazione e aggiorna l'indice secondo il flusso documentato dello strumento quando cambiano i sorgenti.
| Esito della ricerca | Cosa dovrebbe controllare chi revisiona | Perché conta |
|---|---|---|
| Responsabile corretto e codice circostante utile | Il codice implementa il comportamento della domanda? | Stabilisce che il risultato consente un'azione concreta |
| Soltanto un'utilità collegata | Mancano il chiamante o il responsabile dello stato? | Evita una modifica locale che lasci rotto il contratto reale |
| File di test senza implementazione | Il test descrive il comportamento attuale o una vecchia aspettativa? | Mantiene collegate prove e implementazione |
| Molti file plausibili | Il risultato può dare priorità a un insieme minore senza perdere contesto essenziale? | Mostra se la ricerca riduce il lavoro di revisione |
Per una prova pilota di ricerca nel codice, fai identificare a un manutentore i file attesi prima che veda la risposta dello strumento. Altrimenti è facile accettare una posizione plausibile e ridefinire silenziosamente il successo. Tieni separate le domande ambigue, invece di fingere che ogni problema abbia esattamente un file corretto.
Costruisci un confronto che includa il conto locale
Esegui le stesse domande con il metodo esistente e quello nuovo sulla stessa revisione del repository. Un piccolo insieme iniziale potrebbe includere una dozzina di domande ordinarie e alcune più difficili sulle responsabilità. È una proposta di prova pilota, non un benchmark ufficiale né una garanzia di significatività statistica.
Registra se ogni risultato include il file pertinente noto, la quantità di codice irrilevante restituito, l'uso di token cloud e il tempo trascorso. Registra anche la costruzione dell'indice separatamente dalle ricerche ripetute. Un costo iniziale può essere ragionevole per un repository usato spesso, ma poco interessante per una consultazione occasionale.
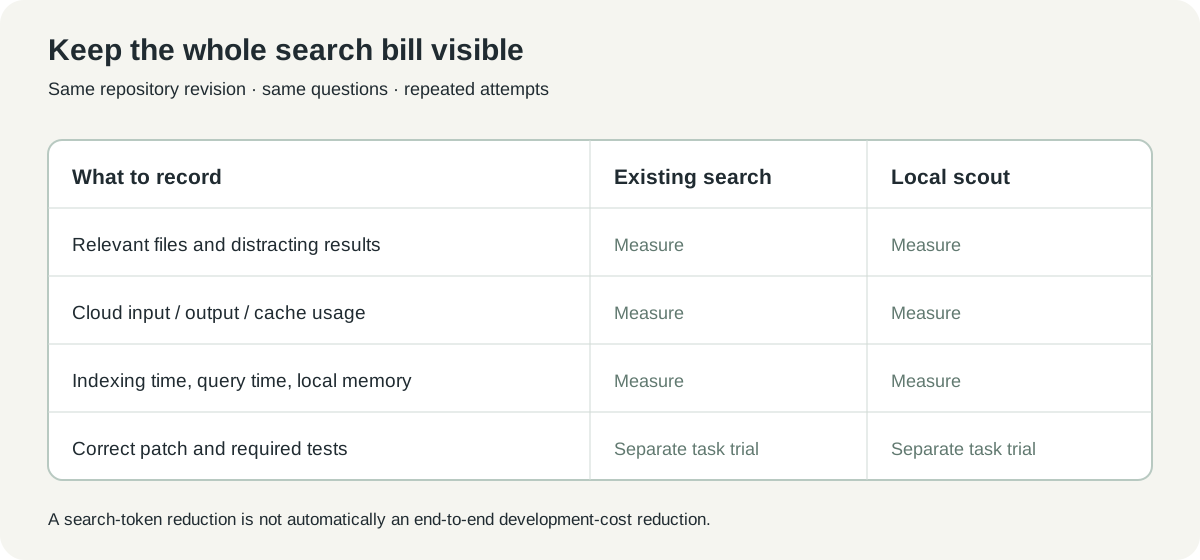 Registro di valutazione originale. Gli spazi vuoti sono intenzionali: raccogli i tuoi valori prima di decidere se il compromesso conviene.
Se confronti anche correzioni complete di bug, trattale come un esperimento separato. Usa lo stesso problema, istantanea del repository, criteri di test e configurazione del modello, poi controlla la patch risultante. Uno strumento vincente nelle domande di ricerca può comportarsi diversamente quando servono esplorazione, modifica, interpretazione dei test e più cicli di correzione.
Ripeti alcune domande invece di fidarti di una singola esecuzione fortunata. La navigazione dell'agente può scegliere percorsi differenti tra tentativi. Una conclusione utile può essere che l'uso tipico di token scende mentre le domande difficili diventano più lente: un compromesso reale che una sola cifra aggregata non descrive.
Il recupero locale non rende offline un assistente cloud
LightOn descrive indicizzazione locale e inferenza locale dell'agente. Questo può mantenere la fase di ricerca sulla tua macchina, ma un assistente cloud integrato può comunque ricevere il codice selezionato restituito dall'esploratore. Valuta l'intero percorso dalla domanda alla chiamata finale del modello, senza equiparare «ricerca locale» a «nessun codice lascia il computer». Descrizione dell'architettura
Le esclusioni del repository meritano una verifica deliberata. Le cartelle generate possono creare rumore, mentre credenziali ed esportazioni private non dovrebbero diventare materiale di ricerca soltanto perché sono nella directory del progetto. Usa il comportamento di esclusione documentato dello strumento e le normali pratiche della tua organizzazione.
La ricerca in sola lettura è un limite utile per un esploratore, ma non autorizza una modifica successiva. L'assistente principale deve ancora rispettare le istruzioni del repository, conservare il lavoro attuale e convalidare l'eventuale correzione. Navigazione e autorizzazione restano responsabilità differenti.
Nei gruppi, rendi visibili questi confini nella documentazione d'integrazione. Le persone dovrebbero sapere dove si trova l'indice, quale modello gira localmente, quali frammenti selezionati raggiungono un altro servizio e come disabilitare l'integrazione. Responsabilità chiare aiutano un esperimento utile a rimanere comprensibile dopo il passaggio di consegne del suo autore.
Il risparmio migliore è esplorare meno materiale irrilevante
La nostra opinione è che ColGrep-Agent offra un caso pratico a favore della specializzazione. Un assistente di programmazione non deve spendere i passaggi di ragionamento più costosi per ogni ricerca tra directory, se un esploratore locale può restituire in modo affidabile le prove pertinenti. La parola affidabile è ciò che la tua prova pilota deve dimostrare.
Parti da un repository e una domanda che un manutentore possa valutare. Se le posizioni restituite riducono la lettura senza nascondere il responsabile del comportamento, amplia la prova. L'obiettivo è un percorso più breve verso una modifica corretta, misurando nel frattempo il conto della ricerca.
Fonti e materiali visivi
Consultato il 20 ottobre 2026. Le prestazioni pubblicate sono i risultati di ricerca nel codice riportati da LightOn. Non si dichiarano installazioni locali, misure di latenza o benchmark di programmazione completi. Schermata pubblica acquisita dall'autore; diagrammi originali. Attribuzioni e avvisi di licenza sono nel registro dei media.
- Annuncio e studio LightOn, 12 ottobre 2026
- Documentazione e sorgenti ColGrep
- Scheda del modello ColGrep-Agent
- Licenza Apache 2.0 del repository
Mantieni collegati il problema e le sue prove
Salva insieme la segnalazione originale, la domanda di ricerca, i collegamenti al codice pertinente e le note di revisione. Telli.sh può aiutarti a organizzare questo registro d'indagine. Crea un account Telli.sh