[Carnet d’idées IA 03] ColGrep-Agent : un éclaireur local trouve le code avant que le grand modèle le lise
Découvrez l'agent local de recherche de code de LightOn : ses résultats, son intégration aux assistants de développement et un test des économies de tokens qui distingue recherche et correction achevée.
Le Carnet d’idées IA explore les idées et les possibilités concrètes des nouveaux modèles et outils d’IA.
Un rapport de bug indique qu'un envoi de fichier se termine trop tôt. Le dépôt contient des centaines de fichiers, plusieurs gestionnaires de progression et quelques états aux noms voisins. Avant de proposer une correction, un assistant IA peut passer l'essentiel de son tour à chercher le code responsable de la fin de l'opération.
ColGrep-Agent, annoncé par LightOn le 12 octobre 2026, prend cette recherche en charge localement. Il explore le dépôt et renvoie à l'assistant principal les chemins, plages de lignes et extraits pertinents. L'idée est celle d'un éclaireur local : laisser un petit spécialiste trouver la piste avant de demander à un grand modèle de réfléchir à la correction. Annonce de LightOn
Cette introduction présente les composants, le parcours de démarrage et les mesures d'un premier comparatif. L'intérêt est de réduire le coût de recherche. Reste à savoir si ce gain se maintient avec votre dépôt, vos questions et votre matériel.
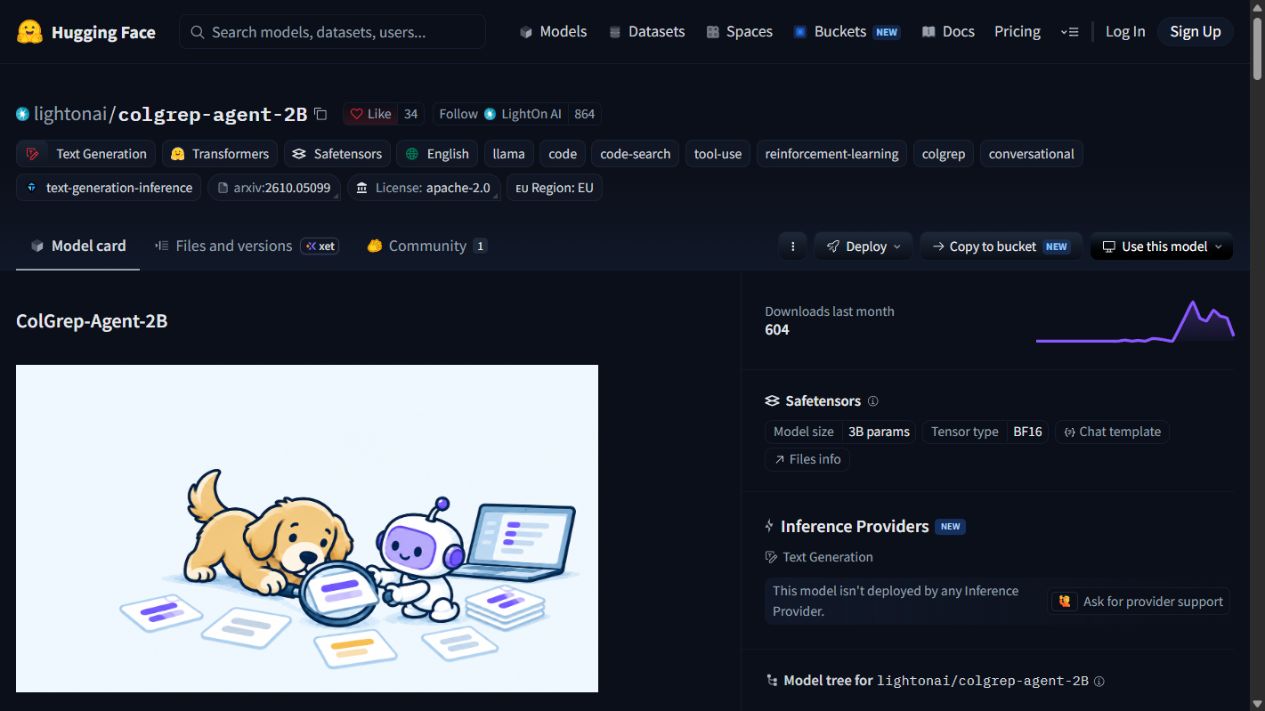 La page publique du modèle, capturée le 20 octobre 2026. Il s'agit de la fiche publiée, pas d'une preuve d'exécution sur notre machine.
Trois noms désignent trois éléments du processus
ColGrep est l'outil de recherche sémantique. ColGrep-Agent-2B est le nom du modèle publié. La commande colgrep --agent exécute le modèle dans un dispositif de recherche contraint ; elle désigne la combinaison opérationnelle plutôt qu'une nouvelle famille de modèles. Explication officielle
Cette séparation aide à choisir la quantité d'infrastructure à ajouter. Un développeur peut vouloir une recherche sémantique en terminal sans boucle d'agent. Une autre équipe peut préférer que son assistant interroge l'agent local et reçoive un contexte plus petit et mieux ciblé.
Le système combine des requêtes fondées sur le sens et des contraintes exactes comme les chemins ou les motifs. Ces approches résolvent des problèmes différents. Une question naturelle peut retrouver un comportement dont les identifiants sont inconnus, tandis qu'une recherche exacte reste précieuse pour un nom de fonction copié depuis une trace d'erreur.
Pour débuter, la sortie importante est simple : une courte liste d'endroits à examiner. Il reste à comprendre le code, vérifier les contrats environnants et exécuter les tests pertinents après un changement. Un emplacement utile est une entrée de la correction, pas la correction elle-même.
Pourquoi la boucle de recherche peut coûter cher
Un assistant suit souvent une séquence : chercher un terme, ouvrir un fichier, remarquer un autre identifiant, suivre une référence, puis relancer une recherche. Chaque étape peut ajouter du contexte aux appels suivants. Un dépôt facile à parcourir pour son mainteneur peut rester coûteux pour un assistant qui le découvre.
ColGrep-Agent déplace ces explorations dans une boucle locale. L'assistant principal pose une question, l'éclaireur cherche et lit les fichiers candidats, puis le contexte retourné indique les endroits jugés pertinents. La répartition concerne la responsabilité de l'exploration, pas la délégation de toutes les tâches de programmation au modèle local.
Imaginez l'analyse d'une session d'enregistrement qui ne se rétablit pas après reconnexion. Une recherche large de « reconnect » peut renvoyer des utilitaires de transport, des notifications d'interface et d'anciens tests. Un résultat utile doit réduire cette liste au composant actuellement responsable de la session et aux fonctions qui recréent ses connexions.
C'est aussi pourquoi une réponse plus courte n'est pas automatiquement une meilleure recherche. Si l'éclaireur élimine le fichier expliquant la persistance finale, l'assistant principal peut proposer une correction assurée mais incomplète. Le but est de réduire le contexte inutile tout en conservant les preuves nécessaires.
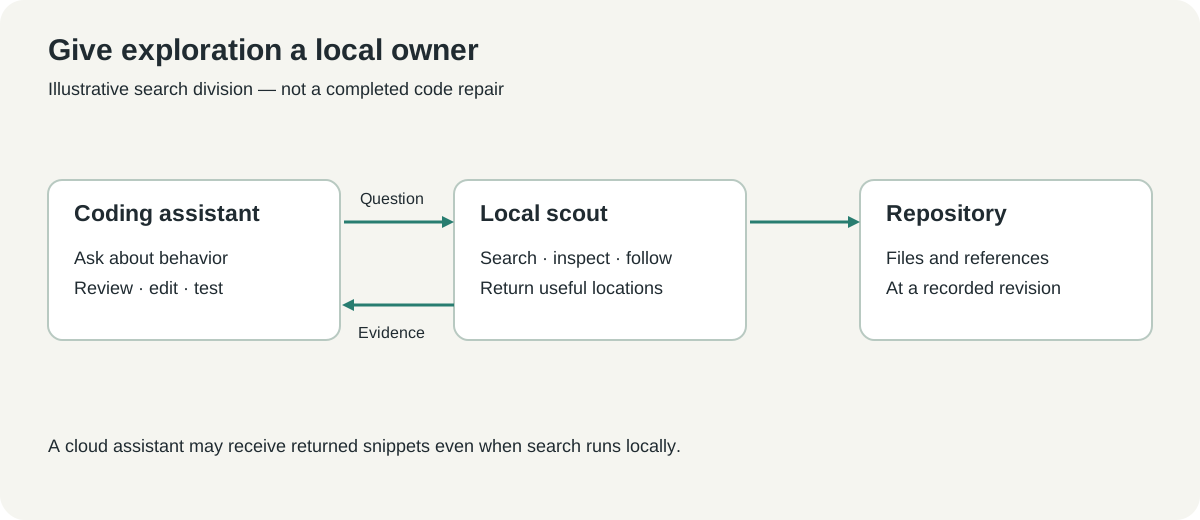 Schéma explicatif original de la répartition documentée. La question et les emplacements présentés sont illustratifs.
Le résultat mis en avant porte précisément sur la recherche de code
LightOn annonce 34% de tokens d'API en moins et 40% de coût d'API en moins en tenant compte du cache, par rapport à grep, sur 52 questions de recherche réparties sur 13 dépôts. Ce sont les mesures de l'éditeur pour cette comparaison. Elles ne prouvent pas une réduction de 40% du coût de construction ou de maintenance d'une application. Description de l'étude
Ce périmètre compte, car le travail logiciel comporte plusieurs coûts. La recherche peut diminuer sans changer le raisonnement d'implémentation. Les tests peuvent dominer le temps total. Un modèle qui économise des tokens cloud peut aussi consommer CPU, GPU, mémoire et temps d'indexation locaux.
Posez trois questions distinctes : la recherche a-t-elle trouvé le bon code, la tâche s'est-elle terminée correctement et quelles ressources l'ensemble a-t-il consommées ? Mesurer seulement la plus facile laisse les deux autres sans réponse. L'équipe doit choisir le compromis adapté à son travail plutôt qu'adopter un pourcentage comme prévision universelle.
La répétition des prompts complique aussi les comparaisons de prix. Un fournisseur peut facturer différemment les entrées mises en cache, les autres entrées et les sorties générées. Consignez-les séparément si l'outil fournit ces informations et appliquez une grille tarifaire datée seulement après avoir obtenu les volumes d'usage.
Commencez par un dépôt que vous savez examiner
Les instructions officielles proposent des installations pour macOS, Windows et une compilation depuis les sources. Partez d'une copie propre ou d'un dépôt dont vous comprenez l'état et lisez les instructions de publication avant de lancer l'installateur. Ne commencez pas par confier un environnement de production non examiné à un outil inconnu. Documentation de ColGrep
Pour macOS avec Homebrew, l'annonce de LightOn montre :
brew install lightonai/tap/colgrep
colgrep --install-agent
La seconde commande prépare le modèle local, sans vous abonner à un endpoint d'inférence hébergé. La publication indique un téléchargement par défaut du modèle quantifié d'environ 2.5 GB. C'est une taille de téléchargement documentée, pas un budget complet de mémoire ou de disque pour toutes les configurations. Configuration du modèle
Sous Windows, suivez la procédure PowerShell actuelle du dépôt officiel et examinez l'installateur avant exécution. Le runtime et l'accélération disponibles dépendent de la machine. Une commande réussie sur Mac ne prouve pas une installation, une vitesse ou une consommation équivalentes sous Windows.
Cette séquence rend le premier essai compréhensible :
- Notez le commit du dépôt et l'état de l'arbre de travail. Choisissez une question dont le code pertinent est connu.
- Installez selon une méthode documentée, puis examinez
colgrep --helpet les recommandations d'indexation de la version installée. - Lancez une recherche sémantique simple avant l'intégration de l'agent. Vérifiez que fichiers ignorés et dossiers exclus correspondent à vos attentes.
- Essayez
colgrep --agentavec l'invocation indiquée par l'aide de cette version. Examinez chaque emplacement retourné. - Connectez-le à un assistant compatible seulement lorsque la recherche autonome est utile. Gardez la configuration précédente pour comparer.
Ce sont des étapes de configuration et d'évaluation, pas le compte rendu d'une installation réalisée pour cet article. Une introduction doit aider à choisir un premier exercice sans inventer ce que l'on y verra.
Interrogez le comportement plutôt que d'imposer un fichier
Une bonne question décrit l'événement et le comportement à retrouver. « Où un envoi accepté devient-il terminé une fois son traitement en arrière-plan achevé ? » informe mieux que « trouve le code d'upload ». Elle fournit un contrat à rechercher tout en laissant découvrir le véritable responsable.
Évitez d'intégrer votre correction supposée à la question. En demandant uniquement la fonction qui devrait définir un indicateur donné, vous pouvez orienter la recherche vers votre hypothèse et manquer le composant qui devrait posséder cet état. Partez de ce qu'observe l'utilisateur, puis examinez l'implémentation qui l'explique.
Trois exercices utiles couvrent différentes navigations : où une requête est-elle authentifiée, où une tâche de fond persiste-t-elle son résultat final et où le frontend s'abonne-t-il à une mise à jour d'état ? Ces tâches illustratives encouragent à suivre les responsabilités entre fichiers plutôt qu'à retrouver un seul identifiant.
Les chaînes exactes ont toujours leur place. Une trace d'erreur, un chemin de route ou un code d'erreur peuvent préciser fortement la question. Associez ces éléments à la description du comportement pour que la recherche reste liée au parcours défaillant.
Jugez les emplacements avant de juger la rédaction
Ouvrez les lignes proposées et lisez assez de code autour pour comprendre la responsabilité de la fonction. Le numéro de ligne peut être exact alors que l'extrait induit en erreur parce qu'il omet une garde, un appelant ou une persistance finale. Le contexte doit permettre de vérifier l'affirmation, pas seulement de la rendre plausible.
Le commit est important ici. Un chemin et une plage de lignes utiles peuvent devenir obsolètes après refactorisation. Associez le résultat à la même révision que celle de l'évaluation et actualisez l'index selon la procédure documentée lorsque les sources changent.
| Résultat de recherche | Ce que le relecteur doit vérifier | Pourquoi cela compte |
|---|---|---|
| Bon responsable, contexte utile | Le code implémente-t-il le comportement demandé ? | Établit que le résultat est exploitable |
| Simple utilitaire lié | Manque-t-il l'appelant ou le propriétaire de l'état ? | Évite une modification locale qui laisse le vrai contrat cassé |
| Fichier de test sans implémentation | Le test décrit-il le comportement actuel ou une ancienne attente ? | Garde le lien entre preuve et implémentation |
| Nombreux fichiers plausibles | Peut-on prioriser une sélection sans perdre le contexte essentiel ? | Montre si la recherche réduit le travail de revue |
Pour un pilote, faites identifier les fichiers attendus par un mainteneur avant qu'il voie la réponse. Sinon, il est facile d'accepter un emplacement plausible et de redéfinir silencieusement le succès. Classez séparément les questions ambiguës plutôt que supposer que chaque problème possède exactement un fichier correct.
Construisez une comparaison qui inclut la facture locale
Soumettez les mêmes questions à l'ancienne et à la nouvelle méthode sur la même révision. Un petit ensemble initial peut comprendre une douzaine de questions courantes et quelques questions plus difficiles sur les responsabilités. C'est un plan de pilote proposé, pas un benchmark officiel ni une garantie de confiance statistique.
Consignez la présence du fichier pertinent connu, la quantité de code inutile, les tokens cloud et le temps écoulé. Mesurez séparément la construction de l'index et les recherches répétées. Le coût initial peut convenir à un dépôt fréquenté souvent, mais pas à une exploration ponctuelle.
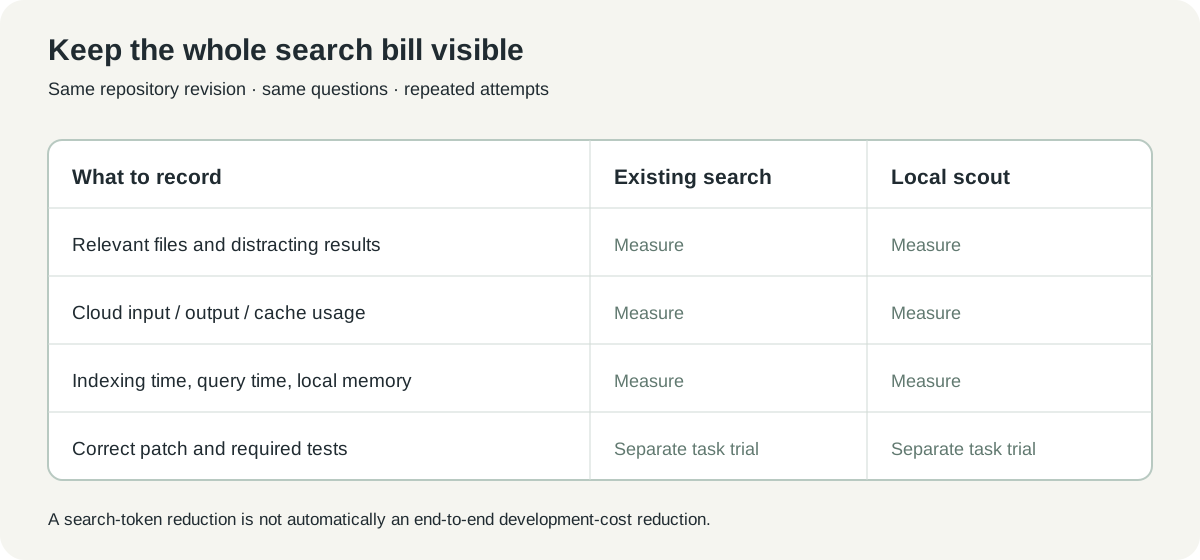 Registre d'évaluation original. Les cases de mesure sont volontairement vides : recueillez vos valeurs avant de juger le compromis.
Si vous comparez aussi des corrections complètes, faites-en une autre expérience. Gardez le même problème, le même instantané du dépôt, les mêmes critères de test et la même configuration de modèle, puis examinez le patch. Un outil gagnant sur des recherches peut se comporter autrement quand il faut explorer, modifier, interpréter des tests et corriger plusieurs fois.
Répétez quelques questions au lieu de croire un seul essai chanceux. La navigation agentique peut emprunter des chemins différents. La conclusion utile peut être une baisse habituelle des tokens accompagnée d'un ralentissement des questions difficiles : c'est un vrai compromis qu'une moyenne seule ne décrit pas.
Une recherche locale ne met pas un assistant cloud hors ligne
LightOn décrit une indexation et une inférence d'agent locales. Cela peut garder la recherche sur votre machine, mais l'assistant cloud intégré peut recevoir le code sélectionné par l'éclaireur. Évaluez toute la route, de la question au dernier appel, plutôt que d'assimiler « recherche locale » à « aucun code ne quitte l'ordinateur ». Description de l'architecture
Les exclusions du dépôt méritent une revue délibérée. Les dossiers générés peuvent ajouter du bruit ; les identifiants et exports privés ne doivent pas devenir des données de recherche simplement parce qu'ils sont sous le répertoire du projet. Utilisez les règles d'exclusion documentées et les pratiques habituelles de votre organisation.
La recherche en lecture seule est une frontière utile pour l'éclaireur, mais n'autorise pas une mutation ultérieure. L'assistant principal doit toujours respecter les instructions du dépôt, préserver le travail en cours et valider la correction obtenue. Navigation et autorisation restent des responsabilités distinctes.
Pour une équipe, rendez ces frontières visibles dans la documentation d'intégration. Il faut savoir où vit l'index, quel modèle tourne localement, quels extraits partent vers un autre service et comment désactiver l'intégration. Des responsabilités claires gardent l'expérience compréhensible après le départ de son auteur initial.
Le meilleur gain est une exploration moins encombrée
À notre avis, ColGrep-Agent défend concrètement la spécialisation. Un assistant n'a pas besoin de consacrer ses raisonnements les plus coûteux à chaque recherche de dossier si un éclaireur local lui fournit les preuves pertinentes de façon fiable. Le mot fiable est ce que votre pilote doit établir.
Commencez avec un dépôt et une question qu'un mainteneur sait juger. Si les emplacements réduisent la lecture sans cacher le responsable du comportement, élargissez l'essai. Le but est un trajet plus court vers une modification correcte, avec le coût de recherche mesuré en chemin.
Sources et médias
Vérifié le 20 octobre 2026. Les chiffres sont ceux publiés par LightOn pour la recherche de code. Aucune installation locale, mesure de latence ou évaluation complète du développement n'est revendiquée. Capture publique réalisée par l'auteur ; schémas originaux. Les crédits et licences figurent dans le registre des médias.
- Annonce et étude de LightOn du 12 octobre 2026
- Documentation et sources de ColGrep
- Fiche du modèle ColGrep-Agent
- Licence Apache 2.0 du dépôt
Gardez le problème relié à ses preuves
Conservez ensemble le rapport initial, la question de recherche, les liens de code pertinents et les notes de revue. Telli.sh peut vous aider à organiser ce dossier d'investigation. Créer un compte Telli.sh