[Cuaderno de ideas de IA 03] ColGrep-Agent: deja que un explorador local encuentre el código antes de que lo lea el modelo grande
Conoce el agente de búsqueda local de código de LightOn: qué devuelve, cómo trabaja con asistentes de programación y cómo comprobar el ahorro de tokens anunciado sin confundir la búsqueda con una corrección terminada.
Cuaderno de ideas de IA explora las ideas y las posibilidades prácticas que hay detrás de los nuevos modelos y herramientas de IA.
Un informe de error dice que una carga termina demasiado pronto. El repositorio contiene cientos de archivos, varios controladores de progreso y unos cuantos campos de estado con nombres parecidos. Antes de proponer una reparación, un asistente de IA puede gastar buena parte de su turno simplemente en encontrar el código responsable de la finalización.
ColGrep-Agent, anunciado por LightOn el 12 de octubre de 2026, se ocupa localmente de esa fase de búsqueda. Explora un repositorio y devuelve rutas de archivos, intervalos de líneas y código relevantes al asistente principal de programación. La idea es un explorador local: dejar que un especialista más pequeño encuentre el rastro antes de pedirle a un modelo mayor que razone sobre la reparación. Anuncio de LightOn
Esta introducción explica las piezas, una vía práctica para comenzar y qué medir en una primera comparación. El atractivo es reducir el sobrecoste de búsqueda. La pregunta es si esa reducción se mantiene con el repositorio, las preguntas y el hardware que utilizas realmente.
 La página pública del modelo, capturada el 20 de octubre de 2026. Es una pantalla de la ficha publicada, no una prueba de que el modelo se haya ejecutado en nuestro equipo.
Tres nombres describen tres piezas del flujo de trabajo
ColGrep es la herramienta de búsqueda semántica. ColGrep-Agent-2B es el nombre del modelo publicado. El comando colgrep --agent ejecuta el modelo en un entorno de búsqueda con límites; es la combinación operativa, no otra familia de modelos. Explicación oficial
Esta separación resulta útil al decidir cuánta infraestructura añadir. Un desarrollador puede querer búsqueda semántica en una terminal sin un ciclo de agente. Otro equipo puede querer que un asistente de programación consulte al agente local y reciba un paquete de contexto más pequeño y enfocado.
El sistema combina consultas basadas en el significado con restricciones exactas, como rutas o patrones. Estos enfoques resuelven problemas diferentes. Una pregunta en lenguaje natural puede localizar un comportamiento cuyos identificadores desconoces, mientras que la búsqueda exacta sigue siendo valiosa para un nombre de función copiado de una traza de error.
Para quien empieza, el resultado importante es sencillo: una lista corta de lugares que inspeccionar. Todavía hay que entender el código, comprobar los contratos que lo rodean y ejecutar las pruebas pertinentes después de modificar el comportamiento. Una ubicación útil es una entrada para reparar, no la reparación en sí.
Por qué el ciclo de búsqueda puede salir caro
Un asistente de programación suele seguir una secuencia: buscar un término, abrir un archivo, descubrir otro identificador, seguir una referencia y volver a buscar. Cada paso puede añadir más contexto a las llamadas posteriores al modelo. Un repositorio fácil de recorrer para su mantenedor puede seguir siendo costoso para un asistente que lo encuentra por primera vez.
ColGrep-Agent traslada esos pasos exploratorios a un ciclo local. El asistente principal formula una pregunta, el explorador busca y lee archivos candidatos y el contexto devuelto identifica las ubicaciones consideradas relevantes. La división trata de quién se ocupa de explorar, en lugar de pedir al modelo local que resuelva todas las tareas de programación.
Imagina investigar por qué una sesión de grabación no se recupera tras una reconexión. Una búsqueda amplia de «reconnect» puede devolver utilidades de transporte, notificaciones de interfaz y pruebas antiguas. Un resultado útil debe reducir esa lista al responsable actual de la sesión y las funciones que recrean sus conexiones.
Por eso una respuesta más corta no equivale automáticamente a una búsqueda mejor. Si el explorador elimina el único archivo que explica la persistencia final, el asistente principal puede producir una corrección segura de sí misma pero incompleta. El objetivo es reducir el contexto irrelevante conservando las pruebas necesarias para la tarea.
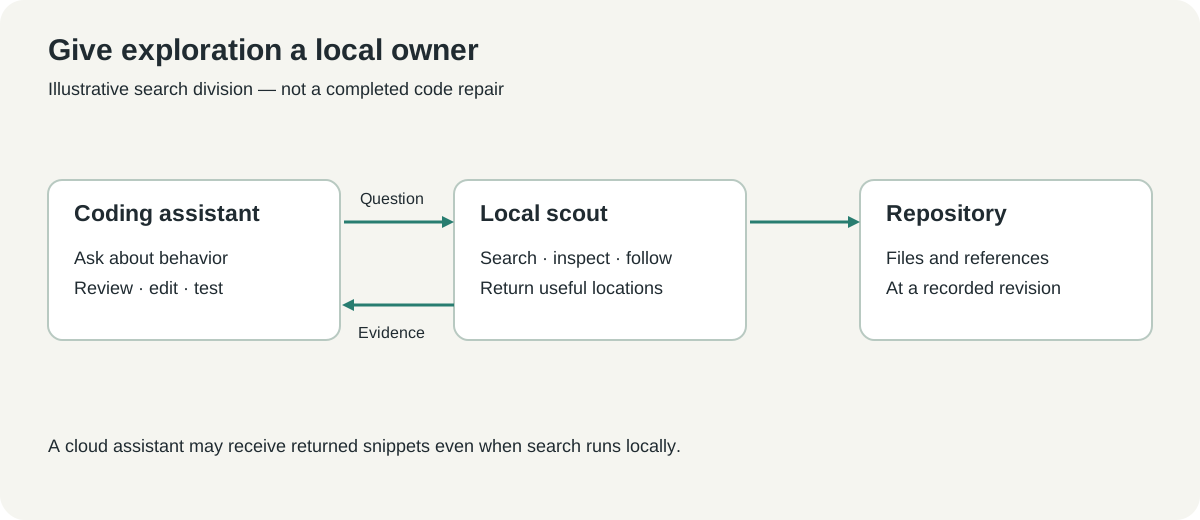 Diagrama explicativo original del reparto documentado del trabajo. La pregunta de ejemplo y las ubicaciones devueltas son ilustrativas.
El resultado destacado se refiere específicamente a la búsqueda de código
LightOn publica un 34% menos de tokens de API y un coste de API un 40% inferior teniendo en cuenta la caché frente a grep, en un estudio de 52 preguntas de búsqueda de código en 13 repositorios. Son las mediciones del editor para esa comparación. No establecen una reducción del 40% en el coste de construir o mantener una aplicación. Descripción del estudio
El alcance importa porque el trabajo de software tiene varios costes. La búsqueda puede reducirse mientras el razonamiento de implementación permanece igual. La ejecución de pruebas puede dominar el tiempo total. Un modelo que ahorra tokens en la nube también puede consumir CPU, GPU, memoria y tiempo de indexación locales.
Piensa en tres preguntas separadas: ¿la búsqueda encontró el código correcto?, ¿la tarea de programación terminó correctamente? y ¿qué recursos consumió toda la tarea? Medir solo la más fácil deja sin responder las otras dos. Un equipo debe elegir la concesión que encaje con su trabajo, en vez de adoptar un porcentaje como previsión universal.
Las consultas repetidas también complican las comparaciones de precio. Un proveedor puede cobrar de forma distinta por entrada en caché, entrada sin caché y salida generada. Regístralas por separado si la herramienta ofrece esa información y aplica una tarifa fechada solo después de tener los recuentos de uso.
Empieza por un repositorio que puedas inspeccionar con confianza
Las instrucciones oficiales ofrecen vías de instalación para macOS, Windows y compilación desde el código fuente. Empieza por una copia limpia o un repositorio cuyo estado comprendas y lee las instrucciones de la versión antes de ejecutar un instalador. No empieces dando a una herramienta desconocida un espacio de producción sin revisar. Documentación de ColGrep
Para lectores de macOS que usen Homebrew, el anuncio de LightOn muestra:
brew install lightonai/tap/colgrep
colgrep --install-agent
El segundo comando prepara el modelo local en lugar de suscribirte a un endpoint de inferencia alojada. El lanzamiento describe una descarga predeterminada del modelo cuantizado de unos 2.5 GB. Es un dato documental sobre el tamaño de descarga, no un presupuesto completo de memoria o disco para todas las configuraciones. Preparación del modelo
Los lectores de Windows deben seguir la vía PowerShell actual del repositorio oficial e inspeccionar el instalador antes de ejecutarlo. El entorno de ejecución y la aceleración disponibles dependen del equipo. No supongas que un comando correcto en un Mac demuestra una configuración, velocidad o consumo equivalentes en Windows.
Utiliza esta secuencia inicial para que el experimento resulte comprensible:
- Registra el commit del repositorio y el estado del árbol de trabajo. Elige una pregunta cuyo código relevante conozcas.
- Instala por una vía documentada y revisa
colgrep --helpy las indicaciones de indexación de la versión instalada. - Ejecuta una búsqueda semántica sencilla antes de habilitar la integración del agente. Comprueba que los archivos ignorados y directorios excluidos sean los esperados.
- Prueba
colgrep --agentcon la invocación que muestre la ayuda de esa versión. Inspecciona cada ubicación devuelta en el repositorio. - Conéctalo a un asistente compatible solo cuando la búsqueda independiente resulte útil. Conserva la configuración de búsqueda anterior para compararla.
Son pasos de configuración y evaluación, no un informe de una instalación realizada para este artículo. Una introducción debería ayudarte a elegir un primer ejercicio sin inventar el resultado que encontrarás.
Pregunta por el comportamiento en vez de imponer un archivo
Una buena pregunta de búsqueda describe el evento y el comportamiento que quieres localizar. «¿Dónde se marca como completa una carga aceptada después de terminar su procesamiento en segundo plano?» informa más que «busca código de cargas». Da al explorador un contrato que buscar y deja espacio para descubrir al responsable real.
Evita incluir la solución propuesta en la pregunta. Si solo pides la función que debería activar un indicador concreto, la búsqueda puede seguir tu suposición y omitir el componente que debería ser dueño del estado. Empieza por lo que observa el usuario y después inspecciona la implementación que lo explica.
Tres preguntas de práctica útiles cubren patrones de navegación distintos. Pregunta dónde se autentica una solicitud, dónde persiste su resultado final un trabajo en segundo plano y dónde se suscribe el frontend a una actualización de estado. Son tareas ilustrativas que animan a seguir la responsabilidad entre archivos, en lugar de buscar un solo identificador.
Las cadenas exactas siguen teniendo su lugar. Una traza de error, una ruta o un código de error pueden hacer una pregunta mucho más precisa. Combina esas pruebas con la descripción del comportamiento observado para que la búsqueda no se desconecte del flujo que falla.
Evalúa las ubicaciones devueltas antes de evaluar la prosa
Abre las líneas sugeridas y lee suficiente código alrededor para entender la responsabilidad de la función. Un número de línea puede ser correcto y el fragmento resultar engañoso porque omite una condición de protección, un llamador o un paso final de persistencia. El contexto debe bastar para comprobar la afirmación, no solo para que parezca creíble.
Aquí importa el commit del repositorio. Una ruta útil y un intervalo de líneas pueden quedar obsoletos tras una refactorización. Asocia el resultado de búsqueda a la misma revisión usada para evaluar y actualiza el índice según el flujo documentado de la herramienta cuando cambien los archivos fuente.
| Resultado de búsqueda | Qué debería comprobar quien revisa | Por qué importa |
|---|---|---|
| Responsable correcto y código circundante útil | ¿El código implementa el comportamiento de la pregunta? | Establece que se puede actuar sobre el resultado |
| Solo una utilidad relacionada | ¿Falta el llamador o el responsable del estado? | Evita un cambio local que deje roto el contrato real |
| Archivo de pruebas sin implementación | ¿La prueba describe el comportamiento actual o una expectativa antigua? | Mantiene conectadas las pruebas y la implementación |
| Muchos archivos plausibles | ¿Puede priorizarse un grupo menor sin perder contexto esencial? | Muestra si la búsqueda reduce el trabajo de revisión |
En una prueba piloto de búsqueda de código, pide a un mantenedor que identifique los archivos esperados antes de ver la respuesta de la herramienta. De lo contrario es fácil aceptar una ubicación plausible y redefinir silenciosamente el éxito. Separa las preguntas ambiguas en lugar de fingir que cada problema tiene exactamente un archivo correcto.
Construye una comparación que incluya la factura local
Ejecuta las mismas preguntas con el método existente y el nuevo sobre la misma revisión del repositorio. Un conjunto inicial pequeño podría incluir una docena de preguntas habituales y unas pocas más difíciles sobre responsabilidades. Es una propuesta de prueba piloto, no un benchmark oficial ni una garantía de confianza estadística.
Registra si cada resultado incluye el archivo relevante conocido, la cantidad de código irrelevante devuelto, el uso de tokens en la nube y el tiempo transcurrido. Registra también la construcción del índice por separado de las búsquedas repetidas. Un coste inicial puede ser razonable para un repositorio frecuente pero poco atractivo para una navegación puntual.
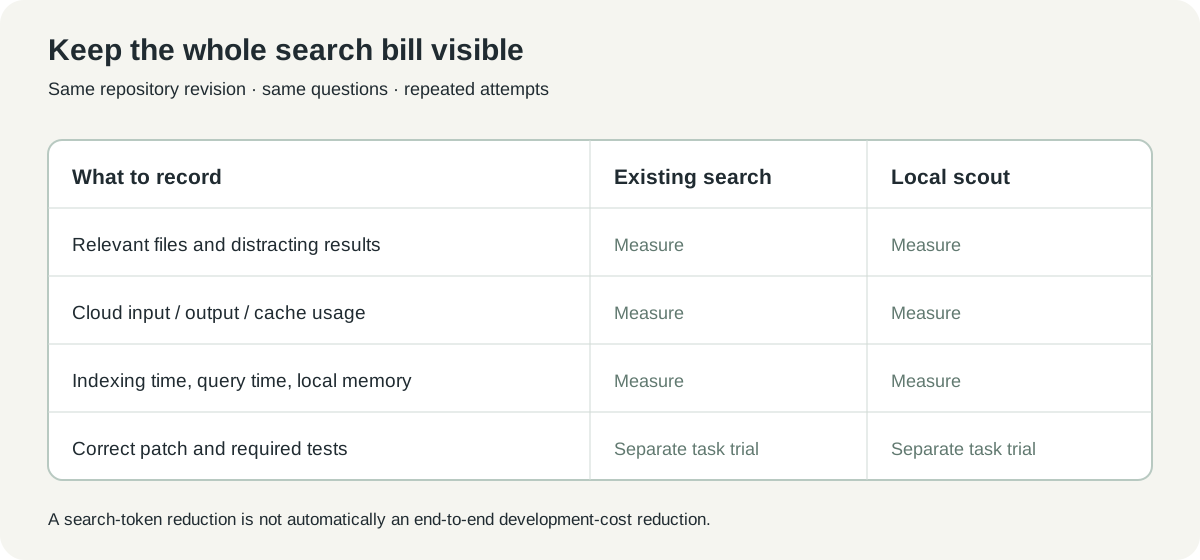 Registro de evaluación original. Las casillas vacías son deliberadas: recoge tus propios valores antes de decidir si la concesión compensa.
Si también comparas reparaciones completas, hazlo como experimento separado. Usa el mismo problema, instantánea del repositorio, criterios de prueba y configuración del modelo, y después revisa el parche resultante. Una herramienta que gana en preguntas de búsqueda puede comportarse de otra manera cuando una tarea requiere explorar, editar, interpretar pruebas y corregir varias veces.
Repite algunas preguntas en vez de confiar en una ejecución afortunada. La navegación del agente puede escoger rutas distintas entre intentos. Una conclusión útil podría ser que el uso habitual de tokens baja mientras las preguntas difíciles se ralentizan; es una concesión real que una sola cifra agregada no puede describir.
La recuperación local no vuelve desconectado a un asistente en la nube
LightOn describe indexación local e inferencia local del agente. Eso puede mantener la fase de búsqueda en tu equipo, pero un asistente de programación en la nube integrado todavía puede recibir el código seleccionado que devuelve el explorador. Evalúa toda la ruta desde la pregunta hasta la llamada final al modelo, en lugar de equiparar «búsqueda local» con «ningún código sale del ordenador». Descripción de la arquitectura
Las exclusiones del repositorio merecen una revisión deliberada. Las carpetas generadas pueden introducir ruido, mientras que credenciales y exportaciones privadas no deberían convertirse en material de búsqueda simplemente por estar dentro del directorio del proyecto. Usa el comportamiento documentado de exclusión y las prácticas habituales de repositorios de tu organización.
La búsqueda de solo lectura es un límite útil para un explorador, pero no autoriza una modificación posterior. El asistente principal debe respetar las instrucciones del repositorio, conservar el trabajo actual y validar la corrección que resulte. La navegación y la autorización siguen siendo responsabilidades diferentes.
En los equipos, haz visibles esos límites en la documentación de integración. Las personas deben saber dónde reside el índice, qué modelo se ejecuta localmente, qué fragmentos seleccionados llegan a otro servicio y cómo desactivar la integración. La responsabilidad clara ayuda a que un experimento útil siga siendo comprensible cuando su autor original ya no esté.
El mejor ahorro consiste en explorar menos contenido irrelevante
En nuestra opinión, ColGrep-Agent presenta un caso práctico a favor de la especialización. Un asistente de programación no necesita gastar sus pasos de razonamiento más caros en cada búsqueda por directorios si un explorador local puede devolver de forma fiable las pruebas relevantes. La palabra fiable es lo que debe demostrar tu prueba piloto.
Empieza por un repositorio y una pregunta que un mantenedor pueda evaluar. Si las ubicaciones reducen la lectura sin ocultar al responsable del comportamiento, amplía la prueba. El objetivo es un camino más corto hacia un cambio correcto, midiendo por el camino la factura de búsqueda.
Fuentes y recursos visuales
Consultado el 20 de octubre de 2026. Las cifras publicadas de rendimiento son los resultados de búsqueda de código comunicados por LightOn. No se afirma haber realizado una instalación local, una medición de latencia ni un benchmark completo de programación. El autor capturó la pantalla pública; los diagramas son originales. Las atribuciones y los avisos de licencia están en el registro de medios.
- Anuncio y estudio de LightOn, 12 de octubre de 2026
- Documentación y código fuente de ColGrep
- Ficha del modelo ColGrep-Agent
- Licencia Apache 2.0 del repositorio
Mantén conectados el problema y sus pruebas
Guarda juntos el informe original, la pregunta de búsqueda, los enlaces al código relevante y las notas de revisión. Telli.sh puede ayudarte a organizar ese registro de investigación. Crea una cuenta en Telli.sh