Baseten joey-1 pyta, czy każda decyzja AI potrzebuje dużego modelu
Model decyzyjny 2B, API za 0,01 USD na milion tokenów wejściowych i praktyczny sposób kierowania niepewnej pracy do większych modeli lub ludzi.
„Który zespół powinien obsłużyć zgłoszenie?” rzadko wymaga pięciu akapitów odpowiedzi. Potrzebuje jednego z kilku poprawnych miejsc, wystarczającej pewności odpowiedzialnego wyboru i sposobu poproszenia o pomoc, gdy prośba nie pasuje.
Baseten przedstawiło joey-1 29 października 2026 r. właśnie do takiej pracy. Opracowany przez grupę badawczą Base Labs model zajmuje mały koniec rodziny decyzyjnej obok elephant-1 i mammoth-1. Jego zaletą jest węższy kontrakt wyjścia: decyzje i prawdopodobieństwa zamiast generowanego wyjaśnienia do interpretacji przez aplikację. Premierę przedstawia ogłoszenie Baseten.
Praktyczną szansą jest inny podział pracy. Mały model obsługuje dobrze określone, powtarzalne decyzje, a więcej zasobów trafia do niepewnej reszty. Ten przewodnik wyjaśnia obliczenia ceny, trzy przykładowe zastosowania i kontrole potrzebne do użytecznego routingu.
 Oficjalny baner karty modelu joey-1 Baseten. Obraz: Base Labs / Baseten, z repozytorium modelu deklarującego MIT; zmniejszony z dodanymi marginesami. Źródło obrazu · Licencja i informacje o obrazie.
Model decyzyjny zaczyna od wyborów akceptowanych przez aplikację
Ogólny model językowy może sklasyfikować prośbę, pisząc „rozliczenia”, zwracając JSON lub wyjaśniając zasadność zwrotu. Każdy interfejs ma zastosowanie. Wyspecjalizowany model skupia się na wyborze spośród dostarczonych odpowiedzi i strukturalnym raportowaniu prawdopodobieństw.
To zmienia przygotowania przed wnioskowaniem. Potrzebujesz precyzyjnego pytania i opcji opisujących sensowne działania. „Co zrobić?” to słaby kontrakt. „Który z działów: rozliczenia, wsparcie techniczne czy przeciwdziałanie oszustwom ma otrzymać sprawę?” jest węższy, choć nadal wymaga polityki dla próśb pasujących do kilku zespołów lub żadnego.
Strona joey-1 w bibliotece Baseten, sprawdzona 2 listopada, dokumentuje wejścia tekstowe i obrazowe, pytania wyboru, decyzje tak/nie i uporządkowane oceny przez /v1/systemone. Wynik służy użyciu programowemu. Nie zastępuje osobnego generatora wyjaśnienia lub odpowiedzi, gdy potrzebuje ich użytkownik.
Pomyśl o małym modelu jak o stanowisku sortowania. Wartość polega na kierowaniu zwykłej pracy we właściwe miejsce i oddawaniu nietypowych spraw komuś z większymi uprawnieniami lub kontekstem. Pewne siebie błędne kierowanie trudnych przypadków tworzy ukrytą pracę dalej, choć pojedyncze wnioskowanie jest tanie.
Dlatego aplikacja powinna zachowywać niepewność. System kierowania może zapisać wstępną etykietę, zadać pytanie doprecyzowujące lub przekazać sprawę człowiekowi. Nie musi zmieniać każdego rozkładu w natychmiastowe działanie biznesowe.
Jeden cent kupuje tokeny wejściowe, nie stałą liczbę decyzji
Według stanu z 2 listopada 2026 r. oficjalny cennik podaje 0,01 USD za milion tokenów wejściowych, z wejściem z pamięci podręcznej i wyjściem po 0,00 USD. „Cent” dotyczy tej jednostki tokenów. Żądanie z długą historią zużywa więcej przetwarzania wejścia niż krótkie, starannie ograniczone.
Poniżej przykładowa arytmetyka według tej stawki, przed podatkami, innymi usługami i warunkami handlowymi. Zakłada wejście bez pamięci podręcznej i stałą cenę; służy planowaniu, nie szacowaniu faktury.
| Przykładowe obciążenie | Łączne tokeny wejściowe | Opłata wejściowa przy 0,01 USD za milion |
|---|---|---|
| 100 000 żądań × 500 tokenów | 50 milionów | 0,50 USD |
| Milion żądań × 500 tokenów | 500 milionów | 5,00 USD |
| 10 milionów żądań × 500 tokenów | 5 miliardów | 50,00 USD |
| Milion żądań × 2000 tokenów | 2 miliardy | 20,00 USD |
Wzór jest prosty: suma tokenów wejściowych podzielona przez milion, pomnożona przez 0,01 USD. Rachunek operacyjny jest szerszy. Uwzględnij eskalacje, przygotowanie danych, ponowienia, monitorowanie i poprawki człowieka.
Załóżmy, że dwie konfiguracje różnią się kosztem modelu o kilka dolarów. Jedna kieruje mniej spraw do kontroli, ale czasem wysyła pilne prośby do wolnej kolejki. Druga eskaluje więcej i unika tego błędu. Wybór zależy od kosztu pomyłek i dostępnej obsady kontroli, nie tylko najtańszego rachunku za tokeny.
Argument rośnie w siłę wraz ze spadkiem ceny wnioskowania. Gdy model jest małą częścią kosztu procesu, niewielka poprawa kalibracji lub etykiet może znaczyć więcej niż kolejna obniżka tokenów. Tanie wnioskowanie poszerza opłacalną automatyzację, ale nie usuwa potrzeby wyceniania wyników.
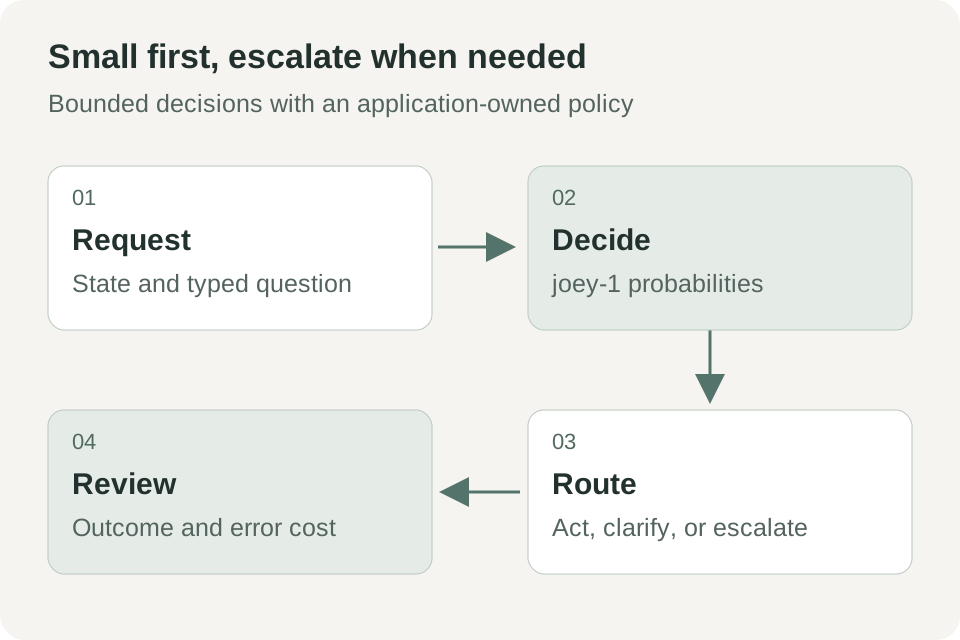 Autorski schemat kierowania inspirowany eskalacją w ogłoszeniu Baseten z 29 października. Progi należą do wdrażającej aplikacji.
Kierowanie zgłoszeń to dobre pierwsze zadanie, gdy etykiety mają właścicieli
W przykładowej obsłudze joey-1 przypisuje wiadomości do rozliczeń, wsparcia technicznego lub bezpieczeństwa konta. Osobne pytanie tak/nie sprawdza prośbę o zwrot. Uporządkowana ocena określa pilność.
Pytania są powiązane, ale nie należy scalać ich w jedną etykietę. Prośba rozliczeniowa może być pilna, a sprawa bezpieczeństwa zawierać żądanie zwrotu. Oddzielne decyzje ułatwiają określenie odbiorców i kombinacji wymagających specjalnej obsługi.
Zacznij od zapisania etykiet z właścicielami kolejek. Dodaj przypadki dawnych sporów. Ustal obsługę wiadomości o nieudanej płatności spowodowanej błędem programu. Model nie rozwiąże organizacyjnej niejednoznaczności pozostawionej bez definicji.
Przed automatycznym przenoszeniem porównaj zalecenia z istniejącymi decyzjami. Grupuj rozbieżności: niejasna polityka, brak kontekstu, oczywisty błąd modelu lub błędna etykieta historyczna. Jedna łączna trafność ukrywa te różne problemy.
Ogłoszenie Baseten z 29 października pozycjonuje joey-1 na pierwszej linii z większymi modelami do niepewności. Podaje 20 milisekund opóźnienia P50 od początku do końca przy przeciętnym żądaniu 2000 tokenów w produkcyjnych warunkach usługi. To pomiar dostawcy dla konkretnego obciążenia, nie gwarancja dla aplikacji lub sprzętu użytkownika. Źródło: Baseten.
Router dokumentów powinien rozpoznawać brak właściwego miejsca
Drugim przykładem jest przyjmowanie dokumentów. Aplikacja otrzymuje plik i decyduje między procesem faktur, oceną wydatków i ogólnym archiwum. Tekst i opcjonalny obraz mogą pomagać przy mieszanych dokumentach, o ile dostarczona reprezentacja zawiera informacje potrzebne zadaniu.
Ogranicz rzeczywistą decyzję. Sprawdzenie, czy strona wygląda jak faktura, różni się od potwierdzenia autentyczności, wystarczalności prawnej lub należności zapłaty. Klasyfikator może wybierać proces bez uprawnienia do zatwierdzania płatności.
Najcenniejsze testy mogą leżeć poza taksonomią: paragon dołączony do umowy, nieczytelnie rozmazany obraz lub nieobsługiwany język. Przy trzech ważnych miejscach docelowych aplikacja potrzebuje innego mechanizmu dla niepełnych dowodów i obcej treści. Jawna kontrola jest łatwiejsza w obsłudze niż wymuszony strzał.
Śledź też zmiany populacji wejścia. Model oceniany głównie na krótkich krajowych fakturach może później otrzymywać wielostronicowe zestawienia i skany korespondencji. Sama końcowa etykieta może nie ujawnić zmiany. Rejestruj długość, typ, niepewność i wynik kontroli przy odpowiednim poziomie prywatności.
Opublikowana karta modelu, sprawdzona 2 listopada, opisuje joey-1 jako model 2B parametrów, dodatkowo trenowany z Qwen3.5-2B, i wymienia licencję MIT. To wspiera opcję otwartych wag, ale nie ustala uniwersalnej pamięci, wydajności CPU ani prawa do ponownego użycia każdej ilustracji ogłoszenia.
Kontrola obrazu pomaga, gdy warunek jest obserwowalny
W trzecim scenariuszu wyobraźmy sobie sprawdzanie zdjęć produktów przed ręcznym przeglądem katalogu. Warto pytać o widoczność etykiety, obecność zamówionego obiektu lub zasłonięcie uniemożliwiające ocenę. Każde pytanie powinno nazywać coś obserwowalnego na obrazie.
Słabe kryteria mieszają obserwację z ukrytymi faktami. „Czy sprzedawca jest godny zaufania?” nie ma odpowiedzi na podstawie samego zdjęcia produktu. „Czy widać wymagany obszar numeru seryjnego?” jest węższe i daje konkretny powód poproszenia o kolejne zdjęcie.
Uporządkowane oceny pomagają, gdy recenzenci już dzielą kryteria, np. nieużyteczne, do kontroli i użyteczne. Zapisz je tak, by dało się je konsekwentnie stosować. Jeśli nawet ludzie nie odróżniają sąsiednich poziomów, rozkład prawdopodobieństwa nie naprawi taksonomii.
Użyj modelu do priorytetyzacji kontroli przed automatycznym odrzucaniem. Odrzucone materiały bezpośrednio wpływają na klientów, a koszt fałszywego odrzucenia może przekroczyć oszczędność. Etap kontroli daje też przykłady do poprawy kryteriów i oceny różnic między warunkami wejścia.
To przykładowe projekty, nie opisane wdrożenia joey-1. Łączy je ograniczone pytanie i odwracalny kolejny krok. To rozsądny początek poznawania zachowania modelu na własnych danych.
Prawdopodobieństwa potrzebują polityki, zanim staną się działaniami
Pewność nie jest flagą uprawnienia. Jeśli aplikacja działa powyżej 0,90, próg jest wyborem projektowym wymagającym pomiaru skutków. Wysoki wynik nadal może być błędny, zwłaszcza przy prośbie innej niż dane użyte do ustalenia progu.
Różne błędy zasługują na różne polityki. Skierowanie zwykłego pytania do złego wsparcia jest niedogodnością. Rutynowe potraktowanie przejęcia konta może kosztować znacznie więcej. Ten sam próg nie powinien automatycznie rządzić oboma zadaniami.
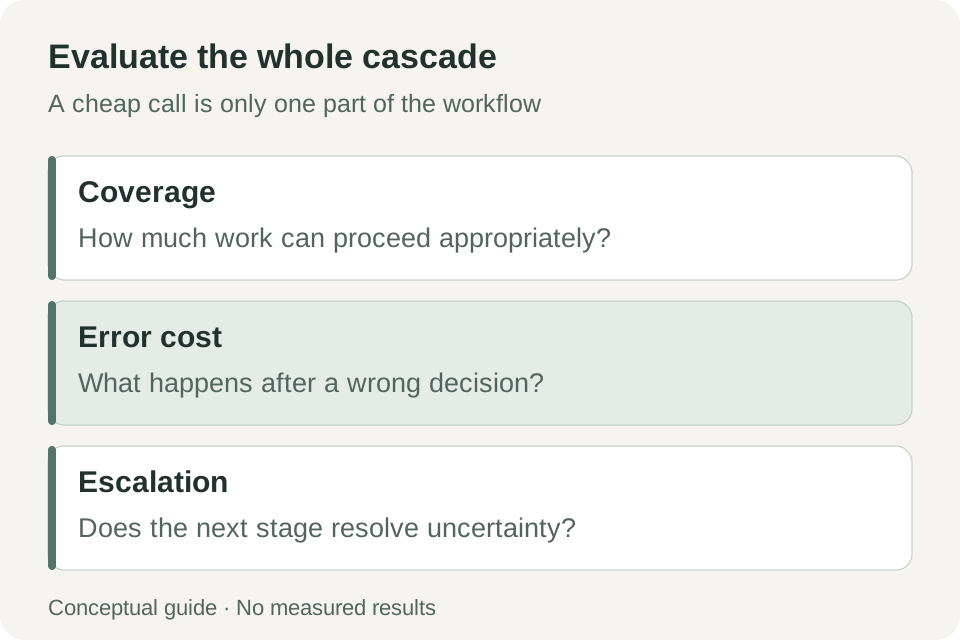 Autorska rama oceny. Pokrycie, koszt złego działania i jakość eskalacji to miary aplikacji; schemat nie podaje zmierzonych wyników joey-1.
Zbuduj oddzielony zestaw kontrolny ze zwykłymi, trudnymi i pozazakresowymi przypadkami. Dla każdego progu sprawdź część automatyczną i jej błędy. Potem zbadaj resztę: model unikający błędów przez eskalowanie niemal wszystkiego może nie zmienić procesu.
Porównaj całą kaskadę z samym większym modelem. Układ „najpierw mały” dodaje etap kierowania z własnymi błędami i opóźnieniem. Wygrywa, gdy dość próśb obsługuje właściwie na pierwszym etapie, a eskalacja poprawia trudną resztę.
Zacznij od hostowanego API albo jawnie zaplanuj własny hosting
Baseten oferuje hostowane Model APIs, wdrożenia dedykowane i wagi do pobrania. Ich kontekst i warunki trzeba sprawdzać osobno. Wpis premierowy opisuje 16k kontekstu Model APIs i opcję 262k dla wdrożenia dedykowanego, podczas gdy karta modelu określa 16 384 tokeny długości sekwencji treningowej i odrzuca żądania ponad wytrenowany limit. Nie ma jednego maksimum do bezkrytycznego przenoszenia między ścieżkami. Wpis premierowy, karta modelu.
- Wybierz jeden kontrakt decyzji. Nazwij ważne opcje, ich znaczenie i reakcję na niewystarczające dowody.
- Wybierz ścieżkę wdrożenia. W hostowanym pilotażu otwórz API modelu i utwórz poświadczenia w koncie dostawcy. Dla lokalnej usługi przestrzegaj przypiętych wymagań środowiska z karty.
- Wyślij minimalne żądanie. Oficjalny przykład używa
https://inference.baseten.co/v1/systemonezestate, typowanymiquestionsi identyfikatoremdecision-models/baseten-joey-2b-latest. - Zweryfikuj odpowiedź strukturalną. Odrzucaj błędne lub niedostępne wyniki, zachowuj potrzebne prawdopodobieństwa i utrzymuj politykę kierowania w aplikacji.
- Przeprowadź ocenę obserwacyjną. Porównaj zalecenia z ocenionymi wynikami przed włączeniem automatycznych działań.
- Dodaj i zmierz eskalację. Kieruj niepewne lub istotne przypadki do większego modelu albo człowieka i oceniaj całą drogę.
Karta modelu dokumentuje własny hosting wymagający GPU CUDA i przypiętego środowiska usługi. „2B” opisuje skalę, nie obiecuje wystarczającej pamięci dowolnego laptopa. W doborze uwzględnij narzut wykonania, obrazy, współbieżność i kontekst.
Pilotaż API może odpowiedzieć o dopasowaniu produktu przed inwestycją w infrastrukturę. Własny hosting staje się osobną decyzją o kontroli, wykorzystaniu zasobów, nakładzie operacyjnym i pełnym koszcie. Otwarte wagi udostępniają wybór, nie czynią go automatycznie opłacalnym.
Zestaw do odtwarzania chroni proces przy zmianie modeli i poleceń
Po udanym pilotażu zachowaj wersjonowaną kolekcję ocenionych żądań. Dodaj zwykłe sprawy, kosztowne błędy i przykłady, w których poprawna jest prośba o pomoc. Zapisz pytania i opisy opcji obok oczekiwanego wyniku, korzystając z danych, które wolno zachować.
Po zmianie polecenia, progu lub konfiguracji odtwórz kolekcję przed zwiększeniem ruchu. Zysk jednej kategorii może ukryć regresję innej. Bardziej zdecydowane kierowanie może ograniczyć kontrolę, ale zwiększyć błędy krótkich, niejednoznacznych wiadomości. Sama średnia nie wyjaśni kompromisu.
Zapisuj rzeczywisty identyfikator modelu i ścieżkę usługi każdej oceny. Jeśli wdrożenie śledzi zmienny identyfikator latest, ustal wykrywanie zmian zachowania i ponowny odbiór. Stały schemat aplikacji nie gwarantuje identycznych decyzji na zawsze.
Przećwicz też awarię usługi. Timeout, niedostępny model lub nieprawidłowa odpowiedź powinny prowadzić do zdefiniowanego odzyskania, nie cichego wyboru domyślnego zespołu. Wartość domyślna sama jest decyzją biznesową i może nie pasować do wrażliwych próśb. Niezawodny mały system tak samo świadomie obsługuje brak odpowiedzi jak pewne wyniki. Ta dyscyplina ma znaczenie, choć zwykła prośba kosztuje ułamek centa.
Małe modele uwidaczniają jakość granicy decyzyjnej
Naszym zdaniem joey-1 jest najciekawszy tam, gdzie aplikacja jasno określiła wybory. Tanie, szybkie decyzje przeniosą dużo pracy, ale słaba taksonomia tylko przyspieszy błędy.
Warto pytać, ile pracy system obsługuje poprawnie w znanym zakresie i jak radzi sobie z resztą. Mały model zasługuje na miejsce, gdy eskalacja jest częścią produktu, nie przypisem po cenie.
Źródła
- Baseten: decyzje za centa, przedstawiamy joey-1, 29 października 2026 r.
- Biblioteka joey-1 Baseten i przykład API, sprawdzono 2 listopada 2026 r.
- Karta joey-1 Base Labs, sprawdzono 2 listopada 2026 r. Benchmarki podaje wydawca; pozycję Artificial Analysis oznaczono jako wewnętrzną replikę.
Zachowaj powiązanie oceny ze źródłem
Telli.sh to jedna z możliwości przechowywania materiałów źródłowych, do których masz uprawnienia, i notatek stojących za decyzją techniczną. Utwórz przestrzeń na notatki.