Baseten joey-1 pregunta si cada decisión de IA necesita un modelo grande
Un modelo de decisión de 2B, una API a $0.01 por millón de tokens de entrada y una forma práctica de derivar trabajo incierto a modelos mayores o personas.
«¿Qué equipo debería tratar esta incidencia?» rara vez necesita cinco párrafos. Necesita uno de unos pocos destinos válidos, confianza suficiente para elegir responsablemente y una forma de pedir ayuda cuando la solicitud no encaja.
Baseten presentó joey-1 el 29 de octubre de 2026 para ese trabajo. Creado por su grupo de investigación Base Labs, ocupa el extremo pequeño de una familia de modelos de decisión junto a elephant-1 y mammoth-1. Su atractivo es un contrato de salida más estrecho: decisiones y probabilidades en lugar de una explicación generada que deba interpretar la aplicación. El anuncio de Baseten presenta el lanzamiento.
La oportunidad práctica es repartir el trabajo de otro modo. Un modelo pequeño trata decisiones repetidas y bien definidas; se invierte más en el resto incierto. Esta guía explica precios, tres aplicaciones ilustrativas y las comprobaciones que hacen útil esa estrategia.
 Banner oficial de la ficha de joey-1 de Baseten. Imagen: Base Labs / Baseten, de su repositorio de modelo declarado MIT; redimensionada con márgenes. Fuente de la imagen · Licencia y notas de la imagen.
Un modelo de decisión empieza por las opciones que acepta tu aplicación
Un modelo general de lenguaje puede clasificar escribiendo «facturación», devolviendo JSON o explicando por qué un cliente merece un reembolso. Cada interfaz tiene su lugar. Un modelo dedicado se centra en elegir entre respuestas aportadas e informar de probabilidades estructuradas.
Eso cambia el trabajo previo a la inferencia. Necesitas una pregunta precisa y opciones que describan acciones significativas. «¿Qué hacemos?» es un contrato débil. «¿Debe recibirlo facturación, soporte técnico o fraude?» es más estrecho, aunque necesita una política para peticiones que encajan en varios equipos o ninguno.
La página de joey-1 en la biblioteca de Baseten, consultada el 2 de noviembre, documenta entradas textuales y visuales, elecciones, decisiones sí/no y puntuación ordenada mediante /v1/systemone. El resultado está pensado para uso programático. No sustituye a un generador separado de explicaciones o respuestas cuando el usuario lo necesita.
Piensa en el modelo pequeño como una mesa de clasificación. Aporta valor enviando lo ordinario al destino correcto y lo inusual a alguien con más autoridad o contexto. Una mesa que asigna con seguridad casos difíciles al lugar equivocado crea trabajo oculto, aunque la inferencia sea barata.
Por eso la aplicación debería conservar la incertidumbre. Puede registrar una etiqueta tentativa, aclarar o transferir a una persona. No tiene por qué convertir toda distribución de probabilidad en acción empresarial inmediata.
Un céntimo compra tokens de entrada, no un número fijo de decisiones
Consultada el 2 de noviembre de 2026, la tarifa oficial indica $0.01 por 1 millón de tokens de entrada, con entrada en caché y salida a $0.00. «Un céntimo» se refiere a esa unidad. Una petición con historial largo procesa más entrada que otra breve y cuidadosamente acotada.
La siguiente aritmética ilustra esa tarifa antes de impuestos, otros servicios o condiciones comerciales. Supone entrada sin caché y precio estable; es un ejemplo de planificación, no una estimación de factura.
| Carga ilustrativa | Tokens de entrada totales | Cargo a $0.01 por millón |
|---|---|---|
| 100,000 peticiones × 500 tokens | 50 millones | $0.50 |
| 1 millón de peticiones × 500 tokens | 500 millones | $5.00 |
| 10 millones de peticiones × 500 tokens | 5 mil millones | $50.00 |
| 1 millón de peticiones × 2,000 tokens | 2 mil millones | $20.00 |
La fórmula es sencilla: tokens totales divididos entre 1 millón y multiplicados por $0.01. La cuenta operativa es mayor. Incluye escalados, preparación de datos, reintentos, supervisión y corrección manual.
Supón dos configuraciones separadas por unos pocos dólares de uso. Una envía menos casos a revisión pero a veces manda urgencias a una cola lenta. Otra escala más y evita ese error. La elección depende del coste de equivocarse y de la capacidad de revisión, no solo de la factura de tokens.
El argumento gana fuerza al abaratarse la inferencia. Si el modelo es una parte pequeña del coste, mejorar modestamente calibración o etiquetas puede importar más que otra rebaja. La inferencia barata amplía automatizaciones viables; no elimina valorar resultados.
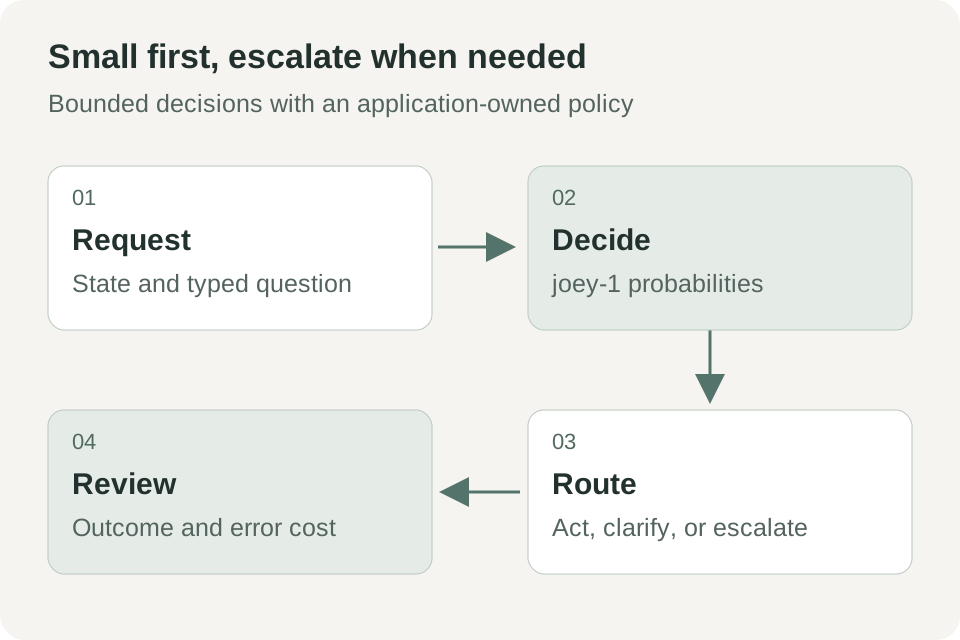 Diagrama original inspirado en el escalado del anuncio de Baseten del 29 de octubre. Los umbrales corresponden a la aplicación que lo despliega.
Asignar incidencias es un buen comienzo cuando las etiquetas tienen responsables
En un proceso ilustrativo de soporte, joey-1 asigna mensajes a facturación, soporte o seguridad de cuentas. Otra pregunta sí/no comprueba si se pide reembolso. Una puntuación ordenada identifica la urgencia.
Son preguntas relacionadas, pero no deben fundirse en una etiqueta. Facturación también puede ser urgente. Un problema de seguridad puede pedir reembolso. Separarlas facilita definir qué recibe cada equipo y qué combinaciones requieren tratamiento especial.
Redacta las etiquetas con quienes responden de las colas. Incluye ejemplos que provocaron desacuerdos. Decide cómo tratar un pago fallido por un error de software. El modelo no resuelve una ambigüedad organizativa que la organización no ha definido.
Antes de mover trabajo automáticamente, compara recomendaciones y decisiones existentes. Clasifica discrepancias: política ambigua, contexto ausente, error claro del modelo o etiqueta histórica incorrecta. Un porcentaje agregado oculta esos problemas diferentes.
El anuncio del 29 de octubre sitúa joey-1 en primera línea, con modelos hermanos mayores para incertidumbre. Publica 20 milisegundos de latencia P50 de extremo a extremo con una petición media de 2,000 tokens en sus condiciones de servicio de producción. Es una medición del proveedor para una carga concreta, no garantía para tu aplicación o hardware. Fuente: Baseten.
Un distribuidor de documentos debe reconocer que falta un destino
Otro uso ilustrativo es recibir documentos y decidir si van a facturas, revisión de gastos o archivo general. Texto e imagen opcional pueden servir para material mixto si la representación enviada contiene lo necesario.
Define estrechamente la decisión. Comprobar si una página parece factura difiere de verificar autenticidad, suficiencia jurídica o autorización de pago. Un clasificador puede elegir un proceso sin recibir permiso para pagar.
Los casos más valiosos pueden quedar fuera de la taxonomía: un recibo adjunto a un contrato, una imagen ilegible o un idioma no admitido. Si solo hay tres destinos válidos, hace falta otro mecanismo para evidencia incompleta y contenido desconocido. Una revisión explícita se opera mejor que una conjetura obligada.
Sigue también los cambios de población. Una evaluación con facturas nacionales breves puede dar paso a extractos de varias páginas y correspondencia escaneada. Vigilar solo la etiqueta final puede ocultarlo. Registra longitud, tipo de entrada, incertidumbre y revisión con privacidad adecuada.
La ficha publicada, consultada el 2 de noviembre, describe 2B parámetros, postentrenamiento de Qwen3.5-2B y licencia MIT. Eso permite considerar pesos abiertos. No establece memoria universal, rendimiento CPU ni permiso para reutilizar todas las ilustraciones del anuncio.
Las comprobaciones de imagen sirven cuando la condición es observable
Como tercer escenario, imagina revisar fotografías de producto antes de una revisión manual del catálogo. Puede preguntarse si se ve una etiqueta, si aparece el objeto solicitado o si hay demasiada obstrucción. Cada pregunta debe nombrar algo observable en la imagen.
Una mala rúbrica mezcla observación con hechos ocultos. «¿Es fiable este vendedor?» no se responde solo con una fotografía. «¿Se ve el área del número de serie solicitado?» es más concreto y justifica pedir otra imagen.
Puntuar por orden sirve si ya existe una rúbrica común, como inutilizable, requiere revisión y utilizable. Redacta criterios aplicables consistentemente. Si ni las personas distinguen dos niveles contiguos, una distribución no arreglará la taxonomía.
Utiliza el modelo para priorizar revisión antes de permitir rechazos automáticos. Rechazar afecta directamente al cliente y un falso rechazo puede costar más que el ahorro. La revisión también aporta ejemplos para afinar criterios y comprobar diferencias entre condiciones de entrada.
Son diseños ilustrativos, no despliegues comunicados de joey-1. Comparten una pregunta acotada seguida de un paso reversible. Es un lugar sensato para aprender su comportamiento con tus datos.
Las probabilidades necesitan política antes de convertirse en acciones
Una confianza no es un permiso. Actuar por encima de 0.90 es una decisión de diseño cuyas consecuencias hay que medir. Una puntuación alta puede ser incorrecta, especialmente si la petición difiere de los datos usados para fijar el umbral.
Errores distintos merecen políticas distintas. Asignar una pregunta común al equipo incorrecto incomoda. Tratar una toma de cuenta como algo rutinario puede costar mucho más. El mismo umbral no debería regir ambos automáticamente.
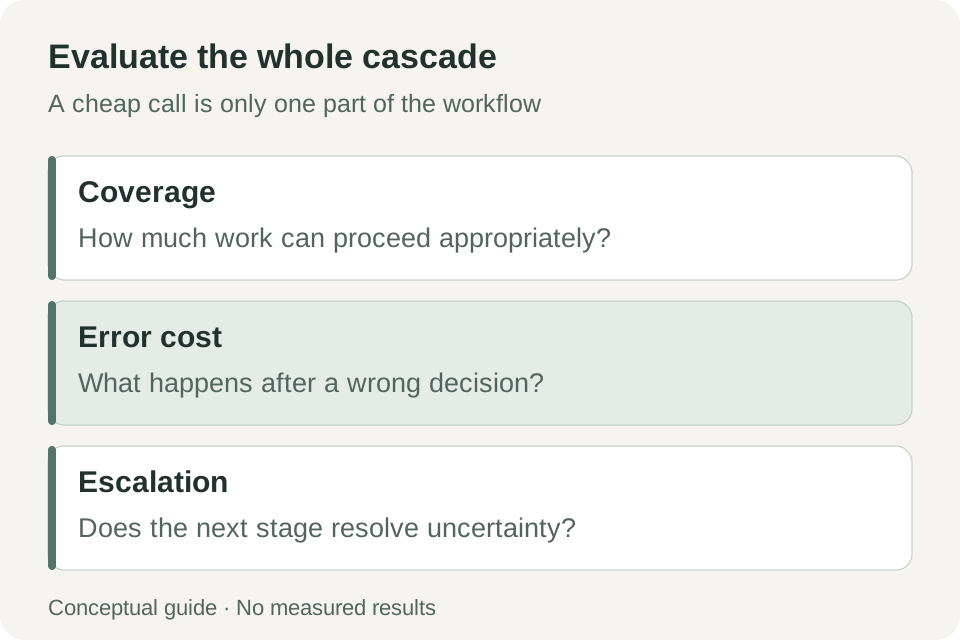 Marco original de evaluación. Cobertura, coste de acciones equivocadas y calidad del escalado son métricas de aplicación; el diagrama no comunica resultados medidos de joey-1.
Prepara un conjunto reservado con casos normales, difíciles y fuera de alcance. Para cada umbral, inspecciona la fracción automática y sus errores. Después examina el resto: evitar errores escalando casi todo puede dejar igual el proceso.
Compara toda la cadena con un modelo grande usado solo. Empezar pequeño añade una etapa con fallos y latencia propios. Gana cuando la primera resuelve adecuadamente suficientes peticiones y el escalado mejora las difíciles restantes.
Empieza por la API alojada o presupuesta explícitamente el autoalojamiento
Baseten ofrece Model APIs, despliegues dedicados y pesos descargables. Comprueba por separado contexto y condiciones. El anuncio describe 16k para Model APIs y una opción dedicada de 262k; la ficha especifica 16,384 tokens de secuencia entrenada y rechaza peticiones que excedan sus límites de entrenamiento. No hay un máximo único aplicable indiscriminadamente. Anuncio, ficha.
- Elige un contrato de decisión. Nombra opciones válidas, significados y respuesta ante evidencia insuficiente.
- Elige despliegue. Para un piloto alojado, abre la entrada API y crea credenciales en la cuenta del proveedor. Para servirlo localmente, sigue las versiones fijadas en la ficha.
- Envía una petición mínima. El ejemplo oficial usa
https://inference.baseten.co/v1/systemone, constate,questionstipadas e identificadordecision-models/baseten-joey-2b-latest. - Valida la respuesta estructurada. Rechaza resultados malformados o no disponibles, conserva probabilidades de evaluación y mantén la política en la aplicación.
- Evalúa en sombra. Compara recomendaciones con resultados revisados antes de activar acciones automáticas.
- Añade y mide el escalado. Deriva casos inciertos o importantes a un modelo mayor o una persona e inspecciona todo el recorrido.
La ficha documenta autoalojamiento con GPU CUDA y entorno de servicio de versiones fijadas. «2B» describe escala, no promete que cualquier portátil tenga memoria suficiente. Incluye sobrecarga, imágenes, concurrencia y longitud de contexto al dimensionar.
Un piloto API puede responder si encaja el producto antes de invertir en infraestructura. Autoalojar es otra decisión sobre control, utilización, operación y coste total. Los pesos abiertos permiten elegir; no garantizan rentabilidad.
Un conjunto reproducible protege el proceso cuando cambia el modelo o la instrucción
Cuando funcione el piloto, conserva una colección versionada de peticiones revisadas. Incluye casos ordinarios, errores costosos y ejemplos donde corresponde pedir ayuda. Guarda pregunta y opciones junto al resultado esperado con datos autorizados.
Al cambiar instrucción, umbral o configuración, reproduce la colección antes de ampliar tráfico. Mejorar una categoría puede ocultar regresiones en otra. Por ejemplo, decidir con más firmeza puede reducir revisión y aumentar errores en mensajes ambiguos breves. La media no explica ese compromiso.
Registra identificador real y vía de servicio de cada evaluación. Si el despliegue sigue un latest móvil, establece cómo detectar cambios y revisar aceptación. Un esquema estable no garantiza decisiones idénticas para siempre.
Prueba también el fallo del servicio. Tiempo agotado, modelo ausente o respuesta inválida deben seguir una recuperación definida, no elegir silenciosamente un equipo predeterminado. Ese valor también es una decisión empresarial y puede ser inadecuado para peticiones sensibles. Un sistema fiable trata respuestas ausentes tan deliberadamente como respuestas seguras, aunque cada petición cueste una fracción de céntimo.
Los modelos pequeños hacen visible la calidad del límite de decisión
Nuestra opinión: joey-1 interesa más donde ya están claras las opciones. Decisiones rápidas y baratas mueven mucho trabajo, pero una mala taxonomía solo mueve errores más deprisa.
La pregunta valiosa es cuánto trabajo resuelve correctamente dentro de un alcance conocido y cómo trata el resto. Un modelo pequeño se gana su lugar cuando el escalado pertenece al producto y no es una nota después del precio.
Fuentes
- Baseten: decisiones por un céntimo, presentación de joey-1, 29 de octubre de 2026.
- Biblioteca de joey-1 y ejemplo API de Baseten, consultados el 2 de noviembre de 2026.
- Ficha de joey-1 de Base Labs, consultada el 2 de noviembre de 2026. Las comparaciones las comunica el editor; la entrada de Artificial Analysis se identifica como réplica interna.
Mantén tu revisión vinculada a su fuente
Telli.sh es una opción para conservar material autorizado y las notas que sustentan una decisión técnica. Crea un espacio de notas.