Czy kolejny serwer AI zmieści się w twojej szafie chłodzonej powietrzem?
Axelera projektuje Titanię do inferencji dużych modeli w serwerze 4U z chłodzeniem powietrzem. Wyniki symulacji pomagają ustalić, o co pytać w sprawie zasilania, pamięci i kosztów wdrożenia.
Zanim nowy serwer AI odpowie na pierwsze pytanie, może potrzebować nowego obwodu elektrycznego, innego chłodzenia i przeniesienia oprogramowania. Dla zespołu uruchamiającego inferencję we własnym obiekcie te wymagania bywają równie istotne jak cena akceleratora. Szybszy układ daje użyteczną moc obliczeniową wtedy, gdy reszta systemu potrafi utrzymać go w pracy.
12 listopada 2026 r. holenderska firma Axelera AI zaprezentowała architekturę Titania, trzecią generację własnej technologii akceleracji AI. Proponowany serwer referencyjny AX8 łączy osiem modułów akceleratora i 1 TB pamięci akceleratorów w obudowie 4U z chłodzeniem powietrzem. Według Axelery typowy pobór mocy systemu ma wynosić 5–6 kW. Projekt ma korzystać z zasilania i chłodzenia dostępnych w istniejących centrach danych. To ogłoszone parametry przyszłej platformy. Na pomiary serwera dostępnego dla klientów trzeba jeszcze poczekać. Ogłoszenie Axelery z 12 listopada
Pytanie brzmi, czy taki projekt pozwoli praktycznie uruchamiać duże modele w obiektach, które już działają. Odpowiedź zależy od pojemności pamięci, czasu odpowiedzi odczuwanego przez użytkownika, prac instalacyjnych i oprogramowania, które zespół będzie utrzymywać. Titania nadaje się do tego przykładu, ponieważ strona produktu podaje też warunki stojące za porównaniami wydajności.
Titania rozszerza ofertę Axelery na większe systemy inferencji
Axelera produkuje już akceleratory Metis i Europa dla aplikacji brzegowych i biznesowych. Titania przenosi ten kierunek na większe wdrożenia inferencji i łączy dwa chiplety w jednej obudowie SiP, czyli system-in-package. Projekt korzysta z architektury Digital In-Memory Computing firmy Axelera, programowalnych jednostek obliczeniowych RISC-V i pamięci LPDDR6. Zapowiedź obejmuje karty PCIe i moduły OAM. Partnerzy systemowi mają oferować konfiguracje chłodzone powietrzem i cieczą.
Dla kupującego układ akceleratora i kompletny serwer to dwie różne decyzje. Sam format PCIe nie określa, czy istniejąca obudowa ma właściwe gniazda, zasilanie, przepływ powietrza i obsługę programową. Projekt referencyjny z chłodzeniem powietrzem również wymaga sprawdzenia warunków w konkretnym pomieszczeniu. Porównuj obsługiwane konfiguracje, które dostawca będzie mógł rzeczywiście dostarczyć i serwisować.
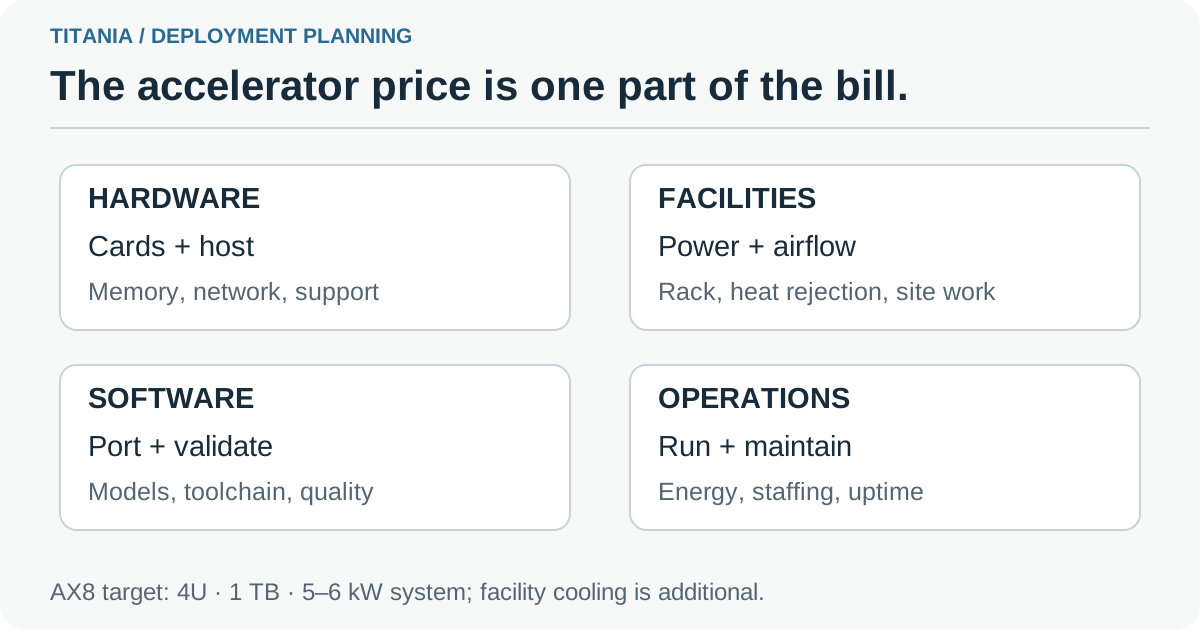
Autorska ilustracja. Budżet wdrożenia obejmuje infrastrukturę i oprogramowanie potrzebne do utrzymania usługi inferencji. Wymiary i moc AX8 pochodzą z ogłoszenia Axelery z 12 listopada.
W materiałach Axelery znajduje się ilustracja producenta przedstawiająca architekturę chipletów Titania. To rysunek projektu układu i jego hierarchii pamięci. Na tej samej stronie podano konfiguracje, które pomagają czytać wykresy wydajności i ocenić, co dokładnie przedstawiają.
Jeden terabajt mówi najpierw o pojemności
Axelera podaje 128 GB pamięci LPDDR6 na jeden moduł Titania. Osiem takich modułów w projekcie AX8 daje deklarowany 1 TB pamięci akceleratorów. Firma podaje także łączną przepustowość pamięci 19,6 TB/s oraz 20 PFLOPS w FP8. Lista obsługiwanych formatów obejmuje FP4, MXFP4, FP8, MXFP8 i BF16. Przy interpretacji tych wartości liczy się precyzja i sposób rozłożenia modelu na moduły. Zapowiedziane parametry architektury i serwera referencyjnego
W dużym modelu typu mieszanina ekspertów całkowita liczba parametrów określa objętość przechowywanych wag, choć przy generowaniu konkretnego tokena może być aktywna tylko część modelu. Pamięć nadal może być ograniczeniem nawet przy stosunkowo małej liczbie wykonywanych obliczeń. Axelera wykorzystuje tę obserwację jako uzasadnienie dla pojemnej pamięci LPDDR6 i wydajnego przenoszenia danych. Szuka innego połączenia pamięci, mocy obliczeniowej i konstrukcji modułu niż akcelerator oparty na HBM.
Według ogłoszenia jeden AX8 ma pomieścić model o 1,6 biliona parametrów w FP4 z miejscem na pamięć podręczną kluczy i wartości. To deklaracja producenta o pojemności przy określonej precyzji. Zespół nadal musi ustalić, czy dokładna reprezentacja modelu, wymagane długości kontekstu i jednoczesne żądania zmieszczą się w obsługiwanej konfiguracji. Gdy rosną liczba i długość rozmów, pamięć robocza usługi wykracza poza rozmiar samych wag.
Utrzymanie modelu w pamięci usuwa jedną przeszkodę. Użytkownik odczuwa przede wszystkim czas oczekiwania i jakość odpowiedzi. Mieszczący się model może wymagać dalszej optymalizacji, aby odpowiadać w wymaganym czasie. Jeśli mniejszy model już daje wystarczająco dokładne wyniki, dodatkowa pojemność może być zbędna. Wybierz model i dopuszczalną precyzję dla zadania, a potem porównaj sprzęt, który może je obsłużyć.
Szybka odpowiedź i wysoka łączna przepustowość premiują inne rozwiązania
Wyobraź sobie wewnętrznego asystenta, który pomaga pracownikom wyszukiwać informacje w dokumentach w czasie spotkań. Odpowiedź, która pojawia się, zanim rozmowa pójdzie dalej, ma inną wartość niż setki wyników gotowych rano. Dla tego asystenta obok łącznej liczby obsłużonych tokenów znaczenie mają czas do pierwszego użytecznego fragmentu i tempo dalszej odpowiedzi. Ten scenariusz służy za przykład i nie pochodzi z testu Titania.
Inny zespół może mieć kolejkę dokumentów, a użytkownicy nie czekają na poszczególne wyniki. Dłuższy czas oczekiwania bywa akceptowalny, gdy większe pakiety zwiększają liczbę zadań wykonanych w ciągu godziny. Duża współdzielona usługa może używać obu trybów o różnych porach. Porównanie przy ustalonym tempie dla jednego użytkownika może więc dać inną kolejność wyników niż maksymalizacja łącznej przepustowości.
Axelera pozycjonuje Titanię pod kątem szybkiej inferencji interaktywnej. Na stronie produktu przyznaje, że systemy GPU w skali całej szafy mogą mieć przewagę przy bardzo dużych pakietach. Wykresy pokazują różne modele i konfiguracje szaf. Przed zakupem warto zapytać, która konfiguracja spełni wymagania dotyczące opóźnień przy przewidywanej liczbie jednoczesnych żądań i akceptowalnych kosztach. Warunki porównań wydajności Titania
| Pytanie o obciążenie | O jakie dane poprosić | Czego nie wyjaśnia pojedynczy wynik szczytowy |
|---|---|---|
| Czy pracownicy mogą korzystać z asystenta na żywo? | Czas do pierwszej odpowiedzi i tempo generowania przy oczekiwanej współbieżności | Kolejki i najwolniejsze odpowiedzi w godzinach największego ruchu |
| Czy usługa wsadowa opróżni kolejkę przed ranem? | Liczba wykonanych zadań na godzinę dla reprezentatywnych dokumentów | Wpływ długości wejścia i grupowania zadań na czas ukończenia |
| Czy jeden serwer obsłuży jednocześnie wideo i zadania językowe? | Wyniki całego procesu z aktywnym dekodowaniem, inferencją i logiką aplikacji | Obciążenie hosta, konkurujące zadania i opóźniona lub pominięta praca |
Przed porównaniem wskaźników przeczytaj warunki symulacji
Na stronie Titania wyniki oznaczono jako wewnętrzne symulacje przeprowadzone z użyciem produkcyjnego kompilatora Axelery. Jedno z porównań zestawia symulację serwera na ośmiu kartach Titania z sierpnia 2026 r. z danymi konkurencji udostępnionymi przez InferenceX we wrześniu 2026 r. Podane warunki obejmują FP4, wejście o długości 8 000 tokenów i wyjście o długości 1 000 tokenów. Inne wykresy bazują na październikowych symulacjach całych szaf i odrębnych konfiguracjach.
Warunki pokazują, co porównują wykresy, i określają, jakie wnioski może z nich wyciągnąć kupujący. Symulacja uwzględniająca kompilator dostarcza danych inżynierskich. Niezależne badanie na produkcyjnym sprzęcie Titania będzie odrębnym źródłem informacji. Istniejące wdrożenia Metis i Europa dają kontekst dla technologii firmy. Prognozy dla Titania nadal wymagają pomiarów na dostarczanych systemach.
Deklarowane wyniki obejmują nawet siedmiokrotną przewagę przepustowości na wat i przewagę w całkowitym koszcie posiadania sięgającą według producenta dwudziestokrotności. Obie liczby pochodzą z porównania Axelery. Nie określają ceny zakupu ani przyszłego rachunku konkretnego obiektu. Strona produktu opisuje porównanie mocy na podstawie TDP, a koszty na podstawie modelu TCO Axelery. TDP to parametr projektowy. Rzeczywiste zużycie energii zależy od całego systemu i zadania.
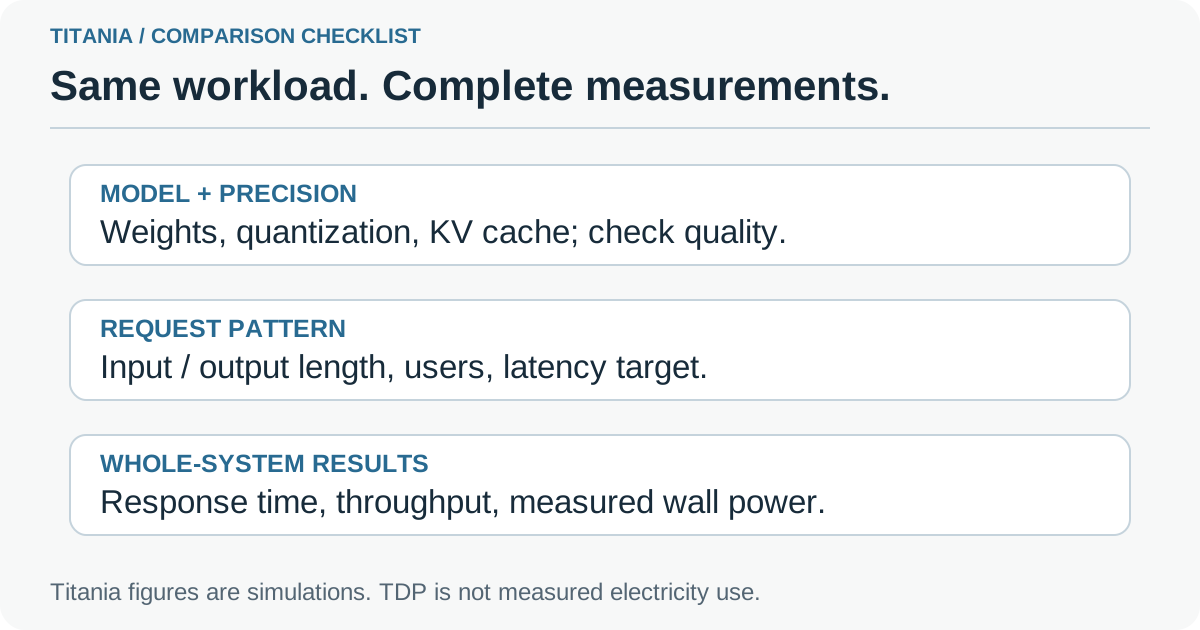
Autorska ilustracja. Przy porównywaniu wyników uwzględnij jednocześnie model, precyzję, długość żądań i współbieżność. Warunki pochodzą ze strony Titania firmy Axelera.
Przed wpisaniem współczynnika do arkusza zakupowego poproś o konfigurację, której dotyczy. Zapisz wersję modelu, precyzję, sposób weryfikowania jakości i rozkład żądań. Potem zapytaj, czy zmierzono moc akceleratora, kompletnego serwera czy całego obiektu. Zestawienie różnych granic pomiaru może dać lepszy wynik na papierze bez proporcjonalnej poprawy usługi.
Chłodzenie powietrzem nadal wymaga zapasu zasilania i odbioru ciepła
W serwerze chłodzonym powietrzem ciepło przechodzi do otoczenia. System chłodzenia obiektu musi je potem usunąć z pomieszczenia. Podawane przez Axelerę typowe 5–6 kW dla AX8 to znaczne obciążenie jak na jedną obudowę 4U. Zanim administratorzy obiektu potwierdzą możliwość instalacji, potrzebują konfiguracji z oferty, wymagań montażowych i przewidywanego obciążenia.
Przykładowe obliczenie pokazuje skalę. Gdyby serwer pobierał średnio 5–6 kW przez pełne 24 godziny, zużyłby w ciągu doby 120–144 kWh na poziomie samego urządzenia. To rachunek oparty na założeniu stałej średniej mocy. Rzeczywisty pomiar będzie zależał od zadania i poboru energii w spoczynku. Chłodzenie, straty konwersji zasilania i pozostała infrastruktura zwiększą całkowite zużycie.
Atutem propozycji Axelery jest możliwość użycia istniejącego centrum danych bez przebudowy pod gęsto upakowaną szafę chłodzoną cieczą. Oszczędność zależy od możliwości konkretnego obiektu. Posiadanie wolnej mocy i wydajności chłodzenia oznacza inne przedsięwzięcie niż praca na granicy dostępnych obwodów i chłodzenia. W ocenie trzeba uwzględnić kompletny serwer w szafie.
Ciągłość oprogramowania może być równie ważna jak pamięć
Według Axelery wspólną podstawą Metis, Europa i Titania są Voyager SDK i AxeleraScript. W zapowiedzi wymieniono planowaną obsługę równoległości tensorowej, eksperckiej i potokowej, dekodowania spekulatywnego oraz przenoszenia lub rozdzielania pamięci podręcznej KV. Kartę PCIe Titania przedstawiono także jako przyszłą ścieżkę modernizacji serwera Axelera Server 250p opartego na Europa. To istotne dla zespołów, które już oceniają oprogramowanie tej firmy.
Użytkownik Europa w pierwszej kolejności powinien sprawdzić, które części aplikacji da się przenieść. Dotyczy to obsługiwanych operacji, konwersji modelu, kodu integracji, monitoringu i pakietów wdrożeniowych. Zespół przechodzący z innego rozwiązania musi zaplanować prace potrzebne do migracji na Voyager. Wspólny SDK może skrócić przenoszenie między produktami jednego producenta. Po przeniesieniu aplikacja nadal wymaga sprawdzenia na każdej platformie docelowej. Oceń możliwość migracji na rzeczywistym modelu i całym procesie, w którym pracuje.
Wyobraź sobie usługę wideo tworzącą opisy nagranych zdarzeń. Zapowiedziane sprzętowe dekodowanie 8K i kodowanie 4K dla H.265 i AV1 może inaczej rozłożyć pracę między akceleratorem a hostem. Próba powinna objąć obsługiwane ustawienia kodeków, przygotowanie klatek, model językowy, zapis danych i odpowiedź aplikacji. Sama szybkość modelu językowego nie wystarczy do oceny całej usługi wideo.
W prywatnym asystencie dokumentów dochodzą wyszukiwanie i kontrola dostępu. Inferencja we własnym obiekcie zmienia miejsce działania modelu. Dostęp do dokumentów, rejestry, kopie zapasowe i dane uwierzytelniające usług nadal wymagają zaprojektowania. Do oferty sprzętowej dołącz plan opieki nad oprogramowaniem. Wskaż, kto aktualizuje środowisko, sprawdza zmiany modelu i przywraca usługę po usterce.
Ocena przydatności zaczyna się od sześciu decyzji
Na obecnym etapie Titanię warto oceniać stopniowo. Zacznij od aplikacji i dostępnego dziś punktu odniesienia, a kolejne dane zbieraj, gdy pojawią się obsługiwane systemy. Demonstracja dostawcy może pomóc zaplanować kolejny etap, jeśli zanotujesz jej konfigurację i ograniczenia. Próba odbiorcza na docelowej instalacji pozostaje odrębnym zadaniem.
- Określ zadanie i wymagania usługi. Wybierz typowe żądania dotyczące dokumentów, agentów lub wideo. Ustal dopuszczalną jakość odpowiedzi, opóźnienie i liczbę jednoczesnych żądań w szczycie, zanim wybierzesz największy model.
- Zapisz stan wyjściowy. Na dotychczasowym sprzęcie lub w usłudze hostowanej zmierz wielkość obciążenia, opóźnienia i koszty operacyjne. Zapisz wersje modeli i żądań, żeby późniejsze porównanie miało sens.
- Poproś o obsługiwaną konfigurację. Ustal, które modele mają działać, jak zorganizowano pamięć, jakiego hosta i wersji oprogramowania potrzeba oraz za co odpowiada partner systemowy. Oddziel zapowiedziane funkcje od tych pokazanych w danej konfiguracji.
- Zleć sprawdzenie obiektu. Przekaż właściwemu zespołowi wymagania dostawcy dotyczące zasilania, przepływu powietrza i montażu. Ocena powinna uwzględnić sąsiednie urządzenia i dostępny zapas chłodzenia.
- Sprawdź całą usługę po udostępnieniu sprzętu. Uwzględnij rozkład żądań, wyszukiwanie, kodeki i monitoring. Zmierz pobór mocy kompletnego serwera w tym samym przedziale co wykonaną pracę i czasy odpowiedzi.
- Policz koszty późniejszej pracy. Uwzględnij czas integracji, wsparcie, konserwację i realny plan awaryjny. Porównaj koszty posiadania dla spodziewanego obciążenia, uwzględniając także okresy mniejszego ruchu.
Te kroki przydają się również wtedy, gdy lepiej zostać przy obecnym sprzęcie. Jeśli mniejszy model spełnia cel przy niewielkich nakładach na utrzymanie, rezygnacja ze zbędnej migracji oszczędza pieniądze i czas zespołu. Jeżeli główną przeszkodą są pamięć lub prace instalacyjne, projekt Titania nadaje następnej rozmowie z dostawcą konkretny kierunek.
Termin produkcji jest częścią oceny sprzętu
W listopadowej zapowiedzi Axelera stawia sobie za cel rozpoczęcie produkcji w trzecim kwartale 2027 r. i opisuje zobowiązania dotyczące wdrożeń u klientów sięgające początku 2028 r. Na stronie produktu wskazuje szerzej drugą połowę 2027 r. jako okres rozpoczęcia produkcji i pokazuje ścieżkę modernizacji w 2028 r. To harmonogram producenta. Początek wytwarzania, dostawa obsługiwanego serwera i instalacja w danym kraju to kolejne etapy.
Przy planowaniu w listopadzie 2026 r. lokalne ceny, datę dostawy i dostępność serwisu musi potwierdzić partner systemowy. Zobowiązanie do zakupu przyszłego sprzętu i działająca instalacja klienta mają odrębne znaczenie. Organizacja potrzebująca inferencji już teraz nadal wymaga dostępnego rozwiązania i planu utrzymania. Titanię można ująć w przyszłej ocenie, zachowując niezależność bieżącego wdrożenia.
Najwięcej wart byłby system inferencji, który zespół może uruchomić i utrzymać w ramach budżetu własnego obiektu. Titania łączy tę propozycję z pojemną pamięcią, szybkością odpowiedzi i wykorzystaniem istniejącej infrastruktury. Następnym sprawdzianem będzie przełożenie założeń konstrukcyjnych i symulacji na obsługiwane systemy sprawdzone w zadaniach klientów.
Źródła
- Axelera AI. Ogłoszenie architektury Titania, 12 listopada 2026 r.
- Axelera AI. Parametry Titania, harmonogram i warunki symulacji, sprawdzono 18 listopada 2026 r.
- Projekt DARE. Partner Axelera przedstawia Titanię, 12 listopada 2026 r.
Zapisz warunki obciążenia, pytania do dostawcy i wyniki prób razem, aby kolejne porównanie opierało się na tych samych założeniach. Utwórz pierwszą notatkę w Telli.sh.