Il prossimo server AI entrerà nel rack raffreddato ad aria che hai già?
Con Titania, Axelera punta a eseguire l’inferenza di grandi modelli su un server 4U raffreddato ad aria. Le simulazioni sollevano domande su potenza, memoria e costi di installazione.
Il prossimo server AI potrebbe aver bisogno di un nuovo circuito elettrico, di una diversa configurazione di raffreddamento e di una migrazione software prima di rispondere alla prima domanda. Per chi porta l’inferenza nella propria sede, questi requisiti possono contare quanto il prezzo dell’acceleratore. Un chip più veloce diventa capacità utile solo se il resto del sistema permette di tenerlo in funzione.
Il 12 novembre 2026, l’azienda olandese Axelera AI ha presentato l’architettura di Titania, la sua terza generazione di tecnologia per l’accelerazione AI. Il server di riferimento proposto, AX8, riunisce otto package di acceleratori e 1 TB di memoria degli acceleratori in un sistema 4U raffreddato ad aria. Axelera indica una potenza tipica di sistema di 5–6 kW e punta alle condizioni di alimentazione e raffreddamento dei data center esistenti. Si tratta di valori di progetto annunciati per una piattaforma futura. Non provengono da un server oggi acquistabile. Annuncio di Axelera del 12 novembre
Questo progetto può rendere praticabile l’inferenza di grandi modelli nelle strutture già disponibili? Bisogna considerare la capacità di memoria, la risposta che riceve ogni utente, i lavori di installazione e il software da gestire nel tempo. Titania è un caso concreto perché la pagina di prodotto indica anche le condizioni dei confronti prestazionali.
Titania porta Axelera dall’edge verso sistemi d’inferenza più grandi
Axelera produce già gli acceleratori Metis ed Europa per l’edge e le applicazioni aziendali. Titania estende la gamma a installazioni d’inferenza più grandi, integrando due chiplet in ciascun system-in-package, o SiP. Il progetto usa l’architettura di calcolo digitale in memoria dell’azienda, unità di calcolo RISC-V programmabili e memoria LPDDR6. L’annuncio presenta schede PCIe e moduli di accelerazione OAM, con configurazioni raffreddate ad aria o a liquido previste tramite i partner di sistema.
Per chi acquista, il package dell’acceleratore e il server completo sono due decisioni distinte. Il formato PCIe non assicura che un telaio esistente abbia slot, alimentazione, flusso d’aria e supporto software adeguati. Un progetto di riferimento raffreddato ad aria non certifica l’idoneità di ogni sala. Vanno confrontate le configurazioni supportate che un fornitore è effettivamente in grado di consegnare e mantenere.
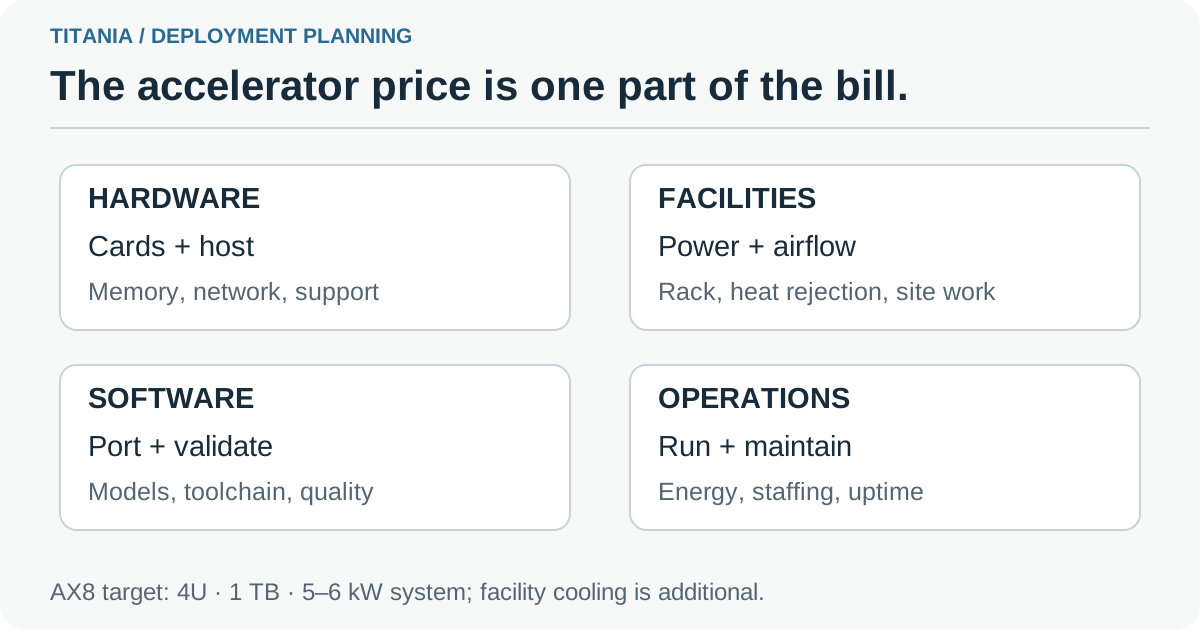
Grafica esplicativa originale. Il bilancio di installazione comprende l’infrastruttura e il software necessari per trasformare il server in un servizio d’inferenza con manutenzione. Le dimensioni e la potenza dell’AX8 vengono dall’annuncio di Axelera del 12 novembre.
Il materiale di Axelera include un’illustrazione del produttore dell’architettura a chiplet di Titania. Mostra il progetto e la gerarchia della memoria previsti. La stessa pagina riporta le condizioni di configurazione necessarie a leggere i grafici prestazionali.
Un terabyte risponde prima a una domanda di capacità
Axelera indica 128 GB di LPDDR6 per package Titania. Gli otto package dell’AX8 raggiungono così 1 TB di memoria degli acceleratori dichiarata. L’azienda indica anche una larghezza di banda complessiva di 19,6 TB/s e una capacità di calcolo di 20 PFLOPS in FP8. Le precisioni dichiarate includono FP4, MXFP4, FP8, MXFP8 e BF16. Per leggere questi numeri servono la precisione e il modo in cui il modello viene distribuito tra i package. Architettura e specifiche annunciate per il server di riferimento
Per un grande modello a miscela di esperti, il numero totale dei parametri determina quanti dati dei pesi vanno conservati, anche se per un singolo token può attivarsi soltanto parte del modello. La memoria può quindi restare un vincolo anche quando il calcolo appare gestibile. Axelera usa questo punto per motivare l’LPDDR6 ad alta capacità e il trasferimento efficiente dei dati. Il compromesso fra memoria, calcolo e integrazione è diverso da quello di un acceleratore progettato attorno a HBM.
Secondo l’annuncio, un AX8 è progettato per ospitare un modello da 1.600 miliardi di parametri in FP4 e lasciare spazio alla cache chiave-valore. È un’indicazione di capacità del fornitore per una determinata precisione. Per ciascuna applicazione va verificato se la rappresentazione del modello, le lunghezze del contesto e le richieste simultanee rientrano nella configurazione supportata. Aumentando il numero o la durata delle conversazioni, cresce la memoria di lavoro oltre a quella occupata dai pesi.
Un modello residente in memoria supera un ostacolo. Gli utenti, però, fanno esperienza dell’attesa e della qualità delle risposte. Anche un modello che entra in memoria può richiedere modifiche per raggiungere il tempo di risposta desiderato. Se uno più piccolo svolge già il compito con sufficiente precisione, capacità aggiuntiva può essere superflua. Scegli il modello e la precisione accettabile in funzione del compito, poi valuta l’hardware.
Velocità interattiva e capacità di elaborazione complessiva premiano progetti diversi
Immagina un assistente documentale aziendale usato durante le riunioni. Una risposta abbastanza rapida da far proseguire una discussione ha un valore diverso da centinaia di risposte concluse durante la notte. Per l’assistente contano il tempo prima del primo testo utile e il ritmo con cui il resto viene generato, oltre al totale dei token elaborati. È un esempio di carico, senza un test su Titania.
Un altro gruppo potrebbe smaltire documenti arretrati senza che nessuno attenda la singola risposta. Può tollerare più attesa se organizzare il lavoro in lotti aumenta le attività completate ogni ora. Un grande servizio condiviso può richiedere entrambi i comportamenti a seconda dell’orario. Fissare la velocità per utente e massimizzare il throughput complessivo può quindi dare classifiche diverse.
Axelera presenta Titania come orientata all’inferenza reattiva. Nella pagina di prodotto l’azienda riconosce che i sistemi GPU su scala rack possono essere in vantaggio con gruppi di richieste molto grandi. I grafici riportano diverse configurazioni di modelli e rack. In fase di acquisto, importa capire quale configurazione rispetta l’obiettivo di latenza alla concorrenza e ai costi attesi. Condizioni prestazionali di Titania
| Domanda sul carico di lavoro | Evidenza da richiedere | Cosa lascia irrisolto un solo valore di picco |
|---|---|---|
| Le persone possono usare un assistente documentale in tempo reale? | Tempo della prima risposta e velocità di generazione con la concorrenza prevista | Accodamento e risposte più lente nelle ore di punta |
| Il servizio a lotti smaltisce gli arretrati nella notte? | Attività completate all’ora con documenti rappresentativi | Effetto della lunghezza dell’input e dei lotti sul tempo di completamento |
| Un server può elaborare insieme video e linguaggio? | Risultati completi con decodifica, inferenza e logica applicativa attive | Carico dell’host, attività in competizione, lavoro perso o in ritardo |
Prima dei rapporti prestazionali, leggi le condizioni delle simulazioni
La pagina di Titania identifica i dati prestazionali come simulazioni interne fatte con il compilatore di produzione di Axelera. Un confronto tra server contrappone un sistema Titania a otto schede, simulato nell’agosto 2026, a dati della concorrenza di InferenceX del settembre 2026. Le condizioni dichiarate comprendono FP4, un input di 8.000 token e un output di 1.000. Altri grafici usano simulazioni su scala rack di ottobre e le rispettive configurazioni.
Queste condizioni spiegano che cosa confrontano i grafici e fissano i limiti delle conclusioni. Una simulazione che usa il compilatore fornisce informazioni di progetto. Una prova indipendente sull’hardware di serie è un passaggio distinto. L’impiego di Metis o Europa aiuta a inquadrare la tecnologia di Axelera, senza trasformare le proiezioni Titania in misure su sistemi consegnati.
I vantaggi annunciati, fino a sette volte il throughput per watt e fino a venti volte nel confronto del costo totale di proprietà, rientrano nel quadro comparativo scelto dal produttore. Non sono preventivi né previsioni di spesa per una singola sede. La pagina dice che la potenza è confrontata da TDP a TDP e che i costi derivano dal modello TCO di Axelera. Il TDP è un valore di progetto. Il consumo di un servizio in funzione dipende da tutto il sistema e dal carico.
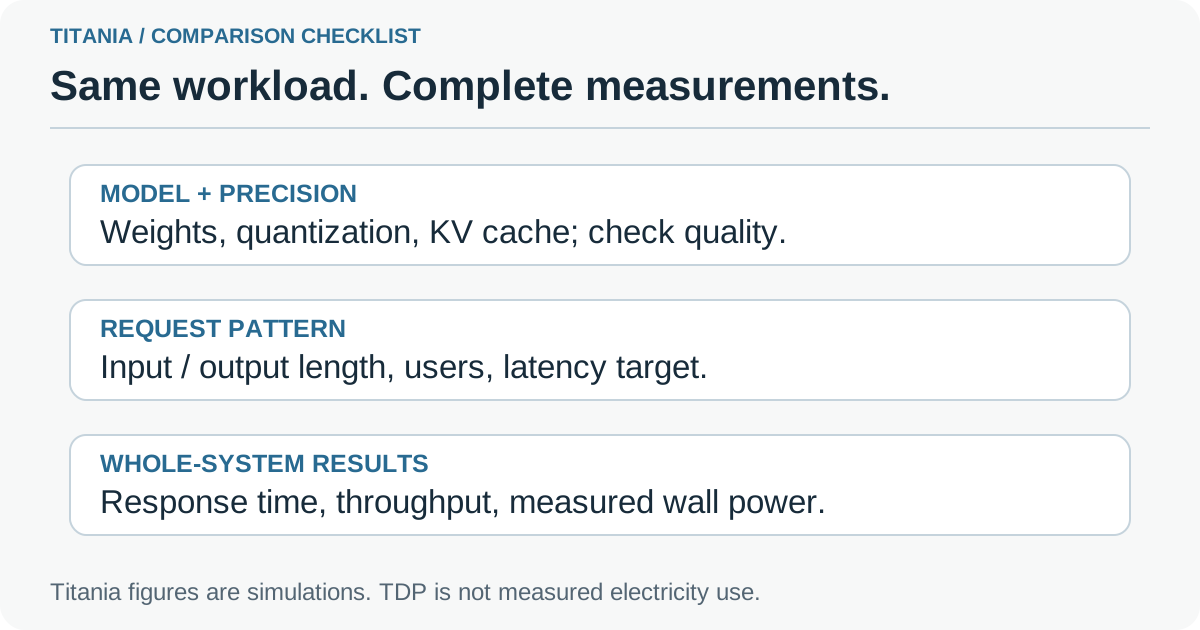
Grafica esplicativa originale. Per capire un confronto, considera insieme modello, precisione, lunghezze delle richieste e concorrenza. Le condizioni sono riportate nella pagina di Titania di Axelera.
Prima di inserire un rapporto nel foglio di acquisto, chiedi da quale configurazione proviene. Allega ai risultati versione del modello, precisione, controlli di qualità e distribuzione delle richieste. Chiedi se la potenza è stata misurata all’acceleratore, al server completo o alle infrastrutture. Altrimenti un perimetro di misura più piccolo può bastare a far apparire migliore un risultato.
Anche il raffreddamento ad aria richiede margine elettrico e termico
“Raffreddato ad aria” descrive come il server cede calore all’ambiente. Una climatizzazione adeguata deve poi espellere quel calore dalla sala. I 5–6 kW tipici indicati per l’AX8 sono un carico rilevante per un solo apparecchio 4U. Il personale responsabile della sede ha bisogno della configurazione offerta, dei requisiti di installazione e del carico atteso per verificare se il rack la può accogliere.
Una stima semplice rende concreta la scala. Una macchina a una media costante di 5–6 kW per 24 ore consumerebbe 120–144 kWh in un giorno come solo server. Il calcolo è basato su un’ipotesi di potenza media continua. Il risultato reale dipenderebbe dal carico e dal comportamento a riposo. Raffreddamento, perdite di conversione e altri sistemi della sede consumano a loro volta energia.
Il progetto di Axelera offre la prospettiva di sfruttare un data center esistente senza adattarlo a un rack ad alta densità e raffreddamento a liquido. L’eventuale risparmio dipende da ciò che la struttura può già sostenere. Una sede con capacità elettrica e termica disponibile affronta un lavoro diverso da una con circuiti e climatizzazione vicini al limite. Il telaio 4U o il formato PCIe non rendono l’installazione equivalente a un aggiornamento di un PC.
La continuità del software può contare quanto la capacità dell’hardware
Axelera sostiene che il Voyager SDK e la base AxeleraScript coprano Metis, Europa e Titania. L’annuncio prevede parallelismo di tensori, esperti e pipeline, decodifica speculativa, trasferimento o disaggregazione della cache KV. Presenta inoltre la scheda Titania PCIe come futuro percorso di sostituzione per l’Axelera Server 250p basato su Europa. È rilevante per chi sta già valutando l’ecosistema del produttore.
Per un utente Europa, la prima domanda riguarda quanto si può conservare: operazioni supportate, conversioni di modelli, codice d’integrazione, monitoraggio e pacchetti di distribuzione. Per chi viene da un’altra piattaforma, migrare a Voyager è già lavoro di ingegneria. Un SDK comune può risparmiare lavoro tra prodotti di uno stesso fornitore. Ogni sistema di destinazione richiede comunque una prova dell’applicazione. Verifica la portabilità con il modello e la filiera di elaborazione reali.
Prendi un servizio video che descrive eventi registrati. La decodifica 8K e la codifica 4K sul chip annunciate per H.265 e AV1 potrebbero ridistribuire i compiti tra acceleratore e host. Una prova deve comprendere le impostazioni di codec supportate, la preparazione dei fotogrammi, il modello linguistico, l’archiviazione e la risposta dell’applicazione. Un modello più veloce da solo non dimostra che l’intero servizio gestisca il carico video richiesto.
Per un assistente documentale riservato, il lavoro comprende ricerca e controllo degli accessi. Portare l’inferenza nei propri locali cambia dove si esegue il modello. Autorizzazioni documentali, registri, backup e credenziali di servizio richiedono un progetto proprio. Al preventivo hardware va quindi affiancato un piano che attribuisca gli aggiornamenti del runtime, la verifica dei nuovi modelli e il ripristino del servizio in caso di guasto.
Una valutazione utile comincia da sei decisioni
Lo stato di Titania rende sensata una valutazione per fasi. Si parte dall’applicazione e dal riferimento disponibile oggi, chiedendo riscontri quando i sistemi supportati diventano disponibili. Una dimostrazione del fornitore può orientare il passo seguente se si documentano configurazione e limiti. Il collaudo finale nella sede di destinazione resta una fase a sé.
- Stabilisci il lavoro e l’obiettivo di servizio. Scegli richieste rappresentative di documenti, agenti o video. Definisci qualità accettabile, tempi di risposta e concorrenza nelle ore di punta prima di optare per il modello maggiore.
- Registra il riferimento attuale. Misura volume di lavoro, latenza e costi operativi del sistema in uso o del servizio ospitato. Conserva le versioni dei modelli e delle richieste per rendere validi i confronti futuri.
- Chiedi la configurazione supportata. Verifica modelli previsti, disposizione della memoria, specifiche dell’host, versioni del software e responsabilità dei partner. Distingui le funzioni annunciate da quelle dimostrate in quella configurazione.
- Fai controllare la sede. Fornisci al personale competente i requisiti di alimentazione, ventilazione e installazione. Fai includere nella valutazione le apparecchiature adiacenti e la capacità di raffreddamento disponibile.
- Prova il servizio completo quando l’hardware è disponibile. Includi i ritmi di arrivo delle richieste, la ricerca, i codec e il monitoraggio. Nello stesso intervallo misura potenza del server completo, lavoro terminato e tempi di risposta.
- Calcola l’impegno operativo. Includi il tempo d’integrazione, il supporto, la manutenzione e un’alternativa praticabile. Confronta i costi di proprietà con il carico previsto, inclusi i periodi tranquilli.
Questi passi aiutano anche a decidere se tenere ciò che già funziona. Se un modello più piccolo soddisfa l’obiettivo con poco lavoro operativo, evitare una migrazione superflua libera denaro e tempo. Se la memoria o la difficoltà di installazione sono il limite, il progetto di Titania rende più concreta la prossima conversazione con un fornitore.
I tempi di produzione fanno parte delle specifiche dell’hardware
Nell’annuncio di novembre Axelera punta alla produzione nel terzo trimestre del 2027 e cita impegni di installazione presso clienti fino all’inizio del 2028. La pagina di prodotto indica un orizzonte più ampio, la seconda metà del 2027, e un percorso di aggiornamento nel 2028. Sono tappe previste. Avvio della produzione, consegna di un server coperto da supporto e installazione in un paese sono traguardi distinti.
Per pianificare nel novembre 2026, prezzi regionali, date di consegna e copertura del servizio vanno confermati con un partner di sistema. Un impegno ad acquistare hardware futuro ha un valore probatorio diverso da una macchina in funzione presso un cliente. Un’organizzazione che ha bisogno di inferenza immediata deve comunque avere una soluzione disponibile e un piano di gestione sostenibile. Titania può entrare nelle valutazioni future senza diventare un vincolo per un lancio imminente.
Il risultato più utile sarebbe capacità d’inferenza che un gruppo può installare, mantenere e finanziare nella propria sede. Titania lega questa possibilità alla memoria, alla reattività e all’infrastruttura esistente. Il prossimo passo è tradurre scelte progettuali e simulazioni in sistemi supportati, misurati sulle attività di cui i clienti hanno bisogno.
Fonti
- Axelera AI, annuncio dell’architettura Titania, 12 novembre 2026
- Axelera AI, specifiche, piano di rilascio e condizioni delle simulazioni di Titania, consultato il 18 novembre 2026.
- Progetto DARE, il partner Axelera presenta Titania, 12 novembre 2026
Conserva insieme la definizione del carico, le domande per il fornitore e i risultati del collaudo. Il confronto successivo partirà dalle stesse ipotesi. Crea la tua prima nota con Telli.sh.