Votre prochain serveur d’IA pourra-t-il prendre place dans une baie refroidie à l’air ?
Avec Titania, Axelera vise l’inférence de grands modèles sur un serveur 4U refroidi à l’air. Les simulations invitent à examiner la puissance électrique, la mémoire et le coût du déploiement.
Avant même de répondre à sa première question, le prochain serveur d’IA pourrait exiger un nouveau circuit électrique, une autre configuration de refroidissement et une migration logicielle. Ces conditions peuvent peser autant que le prix de l’accélérateur pour une équipe qui rapatrie l’inférence dans ses locaux. Une puce plus rapide ne fournit de capacité utile que si le reste du système permet de la faire tourner durablement.
Le 12 novembre 2026, le fabricant néerlandais Axelera AI a dévoilé l’architecture de Titania, sa troisième génération de technologie d’accélération pour l’IA. Le serveur de référence AX8 proposé réunit huit boîtiers d’accélérateur et 1 To de mémoire d’accélération dans un système 4U refroidi à l’air. Axelera annonce une puissance typique de 5–6 kW et vise les infrastructures électriques et de refroidissement des centres de données existants. Ces chiffres décrivent la conception d’une future plateforme. Les clients ne disposent pas encore de mesures réalisées sur un serveur qu’ils peuvent acheter aujourd’hui. Annonce d’Axelera du 12 novembre
Ce système pourrait-il rendre praticable l’inférence de grands modèles sur des sites existants ? La réponse dépend de la capacité mémoire, des délais de réponse perçus, des travaux d’installation et des logiciels à maintenir. Titania fournit un cas d’étude concret, car sa page produit précise aussi les conditions des comparaisons de performances.
Titania élargit le champ d’Axelera de la périphérie vers l’inférence à plus grande échelle
Axelera commercialise déjà les accélérateurs Metis et Europa pour des usages en périphérie et en entreprise. Titania prolonge cette gamme vers des déploiements d’inférence plus importants, avec deux chiplets dans chaque système en boîtier, ou SiP. Le projet combine l’architecture de calcul numérique en mémoire d’Axelera, du calcul programmable RISC-V et de la mémoire LPDDR6. L’annonce évoque des cartes PCIe et des modules d’accélération OAM, avec des configurations refroidies à l’air ou par liquide prévues chez les partenaires intégrateurs.
Pour les acheteurs, choisir un boîtier d’accélérateur et choisir un serveur complet sont deux décisions distinctes. Une carte PCIe n’indique pas si le châssis actuel possède les emplacements nécessaires, une alimentation suffisante, une circulation d’air adaptée et les bons logiciels. Une conception de référence refroidie à l’air ne certifie pas non plus la compatibilité d’une salle particulière. Comparez les configurations prises en charge qu’un fournisseur peut effectivement livrer et maintenir.
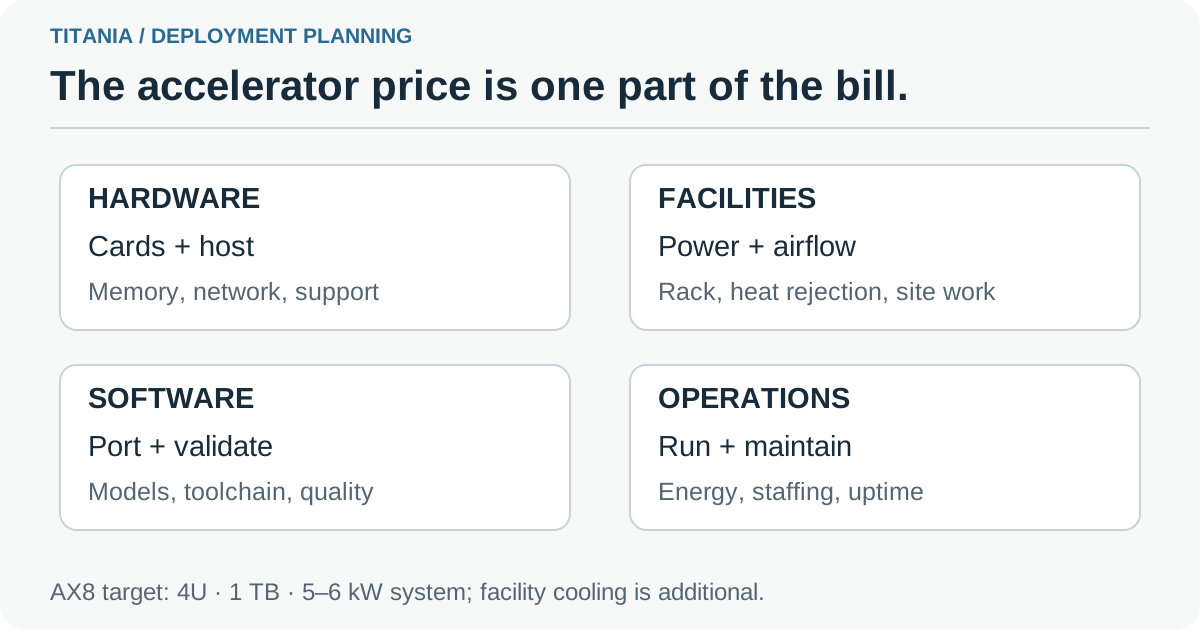
Schéma explicatif original. Le budget de déploiement comprend l’infrastructure et le logiciel nécessaires pour faire du serveur un service d’inférence que l’équipe sait maintenir. Les dimensions et la puissance de l’AX8 viennent de l’annonce d’Axelera du 12 novembre.
La documentation produit contient une illustration d’Axelera de l’architecture à chiplets de Titania. Elle montre l’architecture prévue et la hiérarchie mémoire. On y trouve aussi les configurations qui permettent d’interpréter les graphiques de performances.
Un téraoctet répond d’abord à une question de capacité
Axelera indique 128 Go de LPDDR6 par boîtier Titania. Les huit boîtiers du projet AX8 atteignent ainsi le téraoctet de mémoire d’accélération annoncé. Le fabricant indique aussi une bande passante mémoire cumulée de 19,6 To/s et une puissance de calcul de 20 PFLOPS en FP8. Il mentionne la prise en charge de FP4, MXFP4, FP8, MXFP8 et BF16. L’interprétation de ces chiffres dépend de la précision et de la répartition du modèle entre les boîtiers. Architecture et caractéristiques annoncées pour le serveur de référence
Dans un grand modèle à mélange d’experts, le nombre total de paramètres détermine le volume de poids à stocker, même si une partie seulement du modèle s’active pour un jeton donné. La capacité mémoire peut donc rester limitante alors que la charge de calcul semble maîtrisable. Axelera s’appuie sur ce constat pour privilégier la LPDDR6 de grande capacité et l’efficacité des transferts de données. L’équilibre entre technologie mémoire, calcul et intégration diffère de celui d’un accélérateur construit autour de la HBM.
Selon l’annonce, un seul serveur AX8 est conçu pour héberger un modèle de 1 600 milliards de paramètres en FP4 tout en laissant de la place pour le cache clé-valeur. C’est une affirmation de capacité du fournisseur, pour une précision donnée. Pour une application, il faut encore vérifier comment la représentation exacte du modèle, les longueurs de contexte et les demandes simultanées tiennent dans la configuration prise en charge. Plus les conversations se multiplient ou s’allongent, plus le service consomme de mémoire de travail en sus des poids stockés.
Maintenir le modèle en mémoire lève un obstacle. L’utilisateur, lui, constate surtout le temps d’attente et la qualité des réponses. Même un modèle qui tient en mémoire peut nécessiter des réglages pour respecter les objectifs de latence. Si un modèle plus petit répond déjà avec suffisamment de justesse, une capacité supplémentaire peut être superflue. Choisissez le modèle et sa précision selon la tâche, puis évaluez le matériel qui pourra le servir.
La vitesse interactive et le débit total favorisent des configurations différentes
Imaginons un assistant documentaire interne utilisé en réunion. Une réponse qui arrive à temps pour nourrir la discussion a une autre valeur que des centaines de réponses terminées pendant la nuit. Pour cet assistant, le délai avant le premier texte utile et le rythme de la génération comptent autant que le total de jetons servis. Cette charge de travail est un exemple, sans essai sur Titania.
Une autre équipe pourrait traiter des documents en attente sans que personne ne guette chaque réponse. Elle peut accepter davantage de latence si le traitement par lots augmente le travail accompli par heure. Certains grands services partagés ont besoin des deux comportements selon le moment de la journée. Fixer la vitesse par utilisateur et maximiser le débit agrégé peuvent donc produire deux classements différents.
Axelera met en avant la réactivité de Titania et reconnaît sur sa page produit que des GPU à l’échelle de la baie peuvent prendre l’avantage avec de très grands lots. Les graphiques présentent différents modèles et configurations de baie. Pour l’achat, cherchez quelle configuration respecte l’objectif de latence avec la concurrence et le coût attendus. Conditions des comparaisons de performances de Titania
| Question sur la charge | Éléments à demander | Ce qu’un seul chiffre de pointe laisse en suspens |
|---|---|---|
| Les employés peuvent-ils utiliser l’assistant documentaire en direct ? | Délai de première réponse et vitesse de génération avec la concurrence prévue | Mise en file et réponses les plus lentes en période chargée |
| Un service par lots peut-il résorber son arriéré dans la nuit ? | Tâches terminées par heure sur des documents représentatifs | Effet de la longueur des entrées et du traitement par lots sur le délai de fin |
| Un même serveur peut-il combiner vidéo et langage ? | Résultats de bout en bout avec décodage, inférence et logique applicative actifs | Charge de l’hôte, concurrence des tâches et travaux perdus ou retardés |
Vérifiez les conditions des simulations avant les multiplicateurs de performance
La page de Titania décrit ses résultats comme des simulations internes réalisées avec le compilateur de production d’Axelera. Une comparaison de serveurs oppose un système Titania à huit cartes, simulé en août 2026, à des données concurrentes publiées par InferenceX en septembre 2026. Les conditions indiquées comprennent le FP4, une entrée de 8 000 jetons et une sortie de 1 000 jetons. D’autres graphiques exploitent des simulations d’octobre à l’échelle de la baie, avec leurs propres configurations.
Ces conditions décodent l’objet des graphiques et bornent les conclusions possibles. Une simulation qui tient compte du compilateur renseigne sur la conception. Un essai indépendant sur le matériel Titania de série reste à mener. Les déploiements de Metis et Europa éclairent la technologie d’Axelera, sans pour autant faire des projections de Titania des mesures de systèmes livrés.
Les gains annoncés, jusqu’à sept fois le débit par watt et un avantage pouvant atteindre un facteur vingt sur le coût total de possession, relèvent du cadre de comparaison d’Axelera. On ne peut en tirer ni devis ni prévision de facture pour un site précis. La page produit précise que la puissance est comparée à partir du TDP de chaque système, et que les coûts viennent du modèle TCO d’Axelera. Le TDP est une valeur de conception. En exploitation, la consommation dépend du système complet et de sa charge.
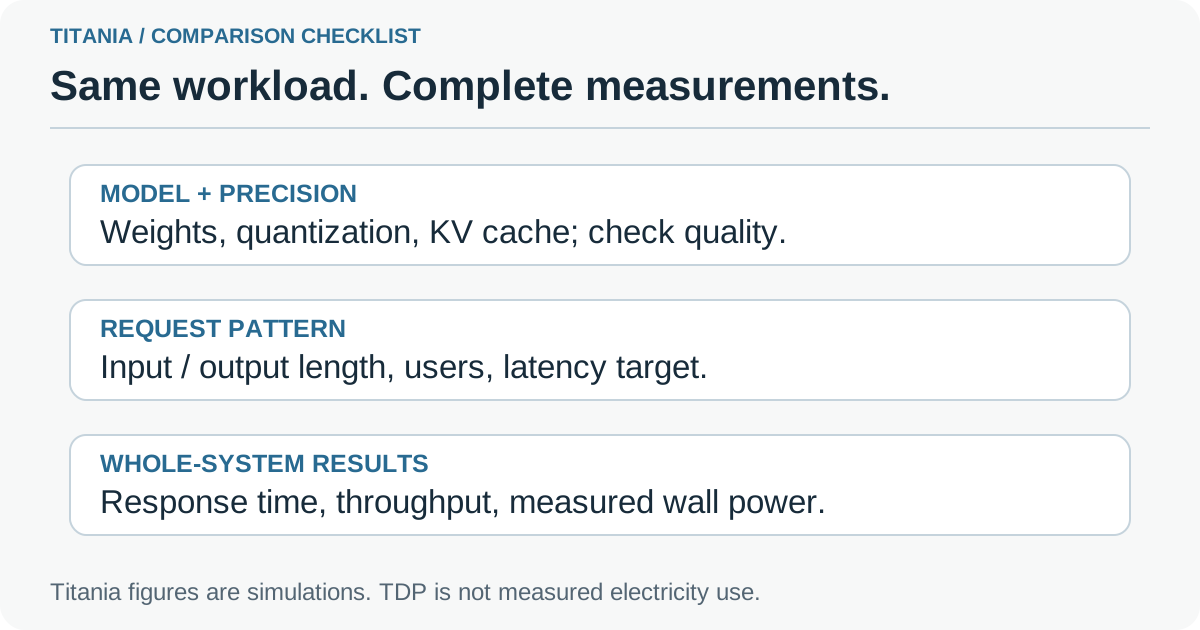
Schéma explicatif original. Pour interpréter une comparaison, lisez ensemble le modèle, la précision, les longueurs de requête et le nombre d’exécutions simultanées. Les conditions proviennent de la page produit de Titania.
Avant de reporter un ratio dans un tableau d’achat, demandez quelle configuration l’a produit. Gardez avec le résultat la version du modèle, la précision, les vérifications de qualité et la distribution des demandes. Demandez aussi où s’arrête la mesure de puissance, à l’accélérateur, au serveur entier ou au site. Un périmètre plus étroit peut suffire à rendre un résultat flatteur.
Le refroidissement à l’air a lui aussi un budget électrique et thermique
Un serveur refroidi à l’air rejette sa chaleur dans l’air ambiant. Une installation de refroidissement adaptée doit ensuite l’évacuer de la salle. Les 5–6 kW typiques annoncés pour l’AX8 représentent une charge importante pour une seule machine 4U. L’équipe chargée du site doit connaître la configuration proposée, ses exigences d’installation et la charge attendue avant de décider si une baie peut l’accueillir.
Un calcul simple donne un ordre de grandeur. Une machine tirant en continu une moyenne de 5–6 kW pendant 24 heures consommerait, à elle seule, 120–144 kWh dans la journée. C’est un calcul sous hypothèse de puissance moyenne constante. Le résultat réel dépendrait de la charge et du comportement au repos. À ce total s’ajoutent le refroidissement, les pertes de conversion électrique et les autres équipements du site.
Le projet d’Axelera présente la possibilité de réutiliser un centre de données sans l’aménager autour d’une baie dense refroidie par liquide. L’économie dépend des équipements que le site peut déjà accueillir. Un site avec des réserves électriques et thermiques n’a pas le même chantier qu’un site dont les circuits et la climatisation approchent de leur limite. Un châssis 4U ou une carte PCIe ne rend pas l’installation aussi simple qu’une mise à niveau de PC.
La continuité logicielle peut compter autant que la capacité matérielle
Axelera présente le SDK Voyager et AxeleraScript comme un socle commun à Metis, Europa et Titania. L’annonce prévoit le parallélisme de tenseurs, d’experts et de pipeline, le décodage spéculatif, ainsi que le déport ou la désagrégation du cache KV. Elle donne aussi la carte PCIe Titania comme voie de remplacement à terme pour l’Axelera Server 250p équipé d’Europa. Ces promesses concernent les équipes qui examinent déjà l’écosystème logiciel du fabricant.
Pour une équipe équipée d’Europa, la question immédiate est de savoir quels opérateurs pris en charge, conversions de modèles, éléments d’intégration, dispositifs de supervision et paquets de déploiement pourront suivre. Pour une équipe qui vient d’un autre environnement, adopter Voyager est un travail d’ingénierie à part entière. Un SDK commun peut réduire le travail entre les produits d’un fournisseur. Il reste à valider l’application sur chaque système cible. La portabilité se vérifie avec le modèle concret et la chaîne de traitement.
Prenons un service vidéo qui produit des descriptions à partir d’événements filmés. Le décodage 8K et l’encodage 4K annoncés sur la puce pour H.265 et AV1 pourraient redistribuer le travail entre accélérateur et hôte. Un essai doit englober les réglages de codecs pris en charge, la préparation des images, le modèle de langage, le stockage et la réponse de l’application. Accélérer le seul modèle ne suffit pas à prouver que le service complet traite la charge vidéo voulue.
Pour un assistant documentaire privé, la recherche et les contrôles d’accès font partie du travail. Installer l’inférence sur site change le lieu d’exécution du modèle. Il reste à concevoir les permissions documentaires, les journaux, les sauvegardes et les identifiants de service. Associez au devis matériel un plan de responsabilité logicielle qui précise qui met à jour l’environnement d’exécution, vérifie les changements de modèle et rétablit le service après une panne.
Six décisions pour préparer une évaluation
À ce stade, Titania se prête davantage à une évaluation progressive qu’à un achat anticipé. Commencez par l’application et les résultats de référence disponibles, puis demandez des éléments probants à mesure que les configurations prises en charge deviennent accessibles. Une démonstration du fournisseur peut éclairer l’étape suivante si ses conditions et ses limites sont consignées. La recette sur le site prévu reste une étape à part entière.
- Fixer la tâche et les objectifs de service. Sélectionnez des demandes représentatives en matière de documents, d’agents ou de vidéo. Fixez les niveaux acceptables de qualité, de réactivité et de concurrence en période chargée avant de choisir le plus gros modèle.
- Consigner la référence actuelle. Mesurez le volume, la latence et les coûts du système existant ou du service hébergé. Conservez les versions du modèle et des requêtes pour permettre une comparaison ultérieure.
- Demander les configurations prises en charge. Renseignez-vous sur les modèles prévus, l’organisation de la mémoire, les caractéristiques de l’hôte, les versions logicielles et les responsabilités de l’intégrateur. Distinguez les fonctions annoncées de celles montrées sur cette configuration.
- Faire contrôler le site. Remettez à l’équipe responsable les exigences électriques, de ventilation et d’installation du fournisseur. Incluez les équipements voisins et la capacité de refroidissement disponible dans l’évaluation.
- Tester le service complet lorsque le matériel est disponible. Incluez les rythmes d’arrivée des demandes, la recherche, les codecs et la supervision. Sur la même période, mesurez la puissance du serveur complet, le travail achevé et les temps de réponse.
- Chiffrer l’engagement d’exploitation. Comptez le temps d’intégration, l’assistance, la maintenance et un plan de repli réalisable. Comparez les coûts de possession avec la charge réellement attendue, périodes creuses comprises.
Cette démarche aide aussi à décider de conserver le matériel actuel. Si un petit modèle atteint déjà l’objectif avec peu d’efforts d’exploitation, éviter une migration inutile préserve le budget et le temps de l’équipe. Si la capacité mémoire ou les travaux d’installation constituent le principal obstacle, la conception de Titania rend le prochain échange avec un fournisseur plus concret.
Les délais de production font partie des caractéristiques du matériel
L’annonce de novembre fixe un objectif de production au troisième trimestre 2027 et évoque des engagements de déploiement chez des clients jusqu’au début de 2028. La page produit donne une fenêtre plus large, le second semestre 2027, et présente une trajectoire de mise à niveau pour 2028. Ces indications décrivent une feuille de route. Le début de la fabrication, la livraison d’un serveur pris en charge et son installation dans un pays donné correspondent à trois jalons distincts.
Pour décider en novembre 2026, il faut obtenir d’un partenaire intégrateur la confirmation des prix régionaux, des dates de livraison et de la couverture de service. Un engagement d’achat pour du matériel futur et une installation cliente qui fonctionne n’ont pas la même valeur de preuve. Une organisation qui a besoin d’inférence immédiatement doit disposer d’une solution accessible et d’un plan d’exploitation viable. Elle peut intégrer Titania à ses évaluations futures sans faire reposer son prochain lancement dessus.
Le meilleur résultat serait une capacité d’inférence que l’équipe peut installer, maintenir et financer dans ses propres locaux. Titania formule cette proposition en reliant mémoire, performances interactives et infrastructure existante. Il reste à concrétiser ces choix et ces simulations dans des systèmes pris en charge, puis à les mesurer sur les tâches dont les clients ont besoin.
Sources
- Axelera AI, annonce de l’architecture Titania, 12 novembre 2026
- Axelera AI, caractéristiques, feuille de route et conditions des simulations de Titania, page consultée le 18 novembre 2026.
- Projet DARE, son partenaire Axelera dévoile Titania, 12 novembre 2026
Rassemblez la définition de la charge de travail, les questions au fournisseur et les futurs résultats d’essais pour repartir des mêmes hypothèses lors de la prochaine comparaison. Créer votre première note avec Telli.sh.