¿Cabría tu próximo servidor de IA en el rack refrigerado por aire que ya tienes?
Titania, de Axelera, apunta a ejecutar inferencia de grandes modelos en un servidor 4U refrigerado por aire. Sus simulaciones plantean preguntas sobre consumo, memoria y costes de despliegue.
El próximo servidor de IA podría necesitar un circuito eléctrico nuevo, otra disposición de la refrigeración y una migración de software antes de responder a la primera pregunta. Para un equipo que quiere llevar la inferencia a sus propias instalaciones, estos requisitos pueden pesar tanto como el precio del acelerador. Un chip más rápido solo aporta capacidad útil cuando el resto del sistema permite mantenerlo en funcionamiento.
El 12 de noviembre de 2026, la empresa neerlandesa de aceleradores Axelera AI presentó la arquitectura de Titania, su tercera generación de tecnología de aceleración de IA. El servidor de referencia AX8 propuesto reúne ocho encapsulados de acelerador y 1 TB de memoria de aceleración en un sistema 4U refrigerado por aire. Axelera indica una potencia típica de 5–6 kW y apunta a las condiciones de suministro eléctrico y refrigeración de los centros de datos existentes. Son cifras de diseño anunciadas para una plataforma futura. Todavía no son mediciones de un servidor que los clientes puedan comprar hoy. Anuncio de Axelera del 12 de noviembre
¿Haría este diseño viable la inferencia de grandes modelos en instalaciones existentes? Para responder hay que mirar la capacidad de memoria, la respuesta que recibe cada usuario, el trabajo de instalación y el software que habrá que mantener. Titania sirve de caso de estudio porque su página de producto también publica las condiciones de las comparaciones de rendimiento.
Titania lleva a Axelera del procesamiento en el borde a sistemas de inferencia mayores
Axelera ya fabrica los aceleradores Metis y Europa para el borde de red y aplicaciones empresariales. Titania amplía esa línea a despliegues de inferencia de mayor tamaño con dos chiplets por sistema en encapsulado o SiP. El diseño combina la arquitectura de computación digital en memoria de Axelera, unidades de cálculo RISC-V programables y memoria LPDDR6. El anuncio contempla tarjetas PCIe y módulos aceleradores OAM, con configuraciones refrigeradas por aire y por líquido previstas a través de integradores.
Para un comprador, el encapsulado del acelerador y el servidor completo son decisiones distintas. Una tarjeta PCIe no garantiza que el chasis existente cuente con ranuras, alimentación, flujo de aire y soporte de software adecuados. Un diseño de referencia refrigerado por aire tampoco certifica la idoneidad de cualquier sala. Conviene comparar configuraciones compatibles que cada proveedor pueda entregar y mantener.
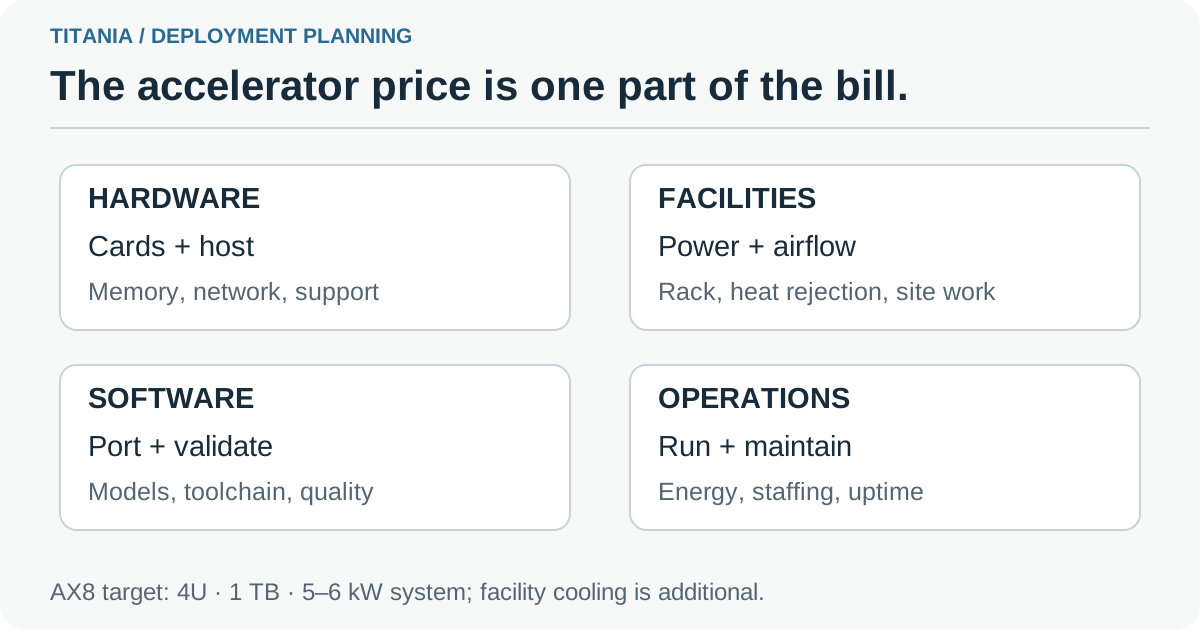
Gráfico explicativo propio. El presupuesto de despliegue incluye la infraestructura y el software necesarios para convertir un servidor en un servicio de inferencia con mantenimiento. Los datos de tamaño y potencia del AX8 proceden del anuncio de Axelera del 12 de noviembre.
Los materiales del producto incluyen una ilustración del fabricante sobre la arquitectura de chiplets de Titania. Enseña el diseño previsto y la jerarquía de memoria. La misma página detalla las configuraciones necesarias para interpretar los gráficos de rendimiento.
Un terabyte responde primero a una pregunta de capacidad
Axelera especifica 128 GB de LPDDR6 por encapsulado Titania. Su diseño AX8 con ocho encapsulados alcanza así el 1 TB de memoria de aceleración anunciado. La empresa indica un ancho de banda de memoria agregado de 19,6 TB/s y una potencia de cálculo de 20 PFLOPS en FP8. También anuncia compatibilidad con FP4, MXFP4, FP8, MXFP8 y BF16. Estas cifras se interpretan junto a la precisión y la distribución del modelo entre encapsulados. Arquitectura anunciada y especificaciones del servidor de referencia
En un gran modelo de mezcla de expertos, el número total de parámetros determina el volumen de pesos que hay que guardar, aunque para un token solo se active parte del modelo. La capacidad puede limitar el sistema incluso si la carga de cálculo parece manejable. Axelera usa esta observación para defender una LPDDR6 de gran capacidad y el movimiento eficiente de datos. Es un equilibrio diferente entre memoria, cómputo e integración del que sigue un acelerador diseñado en torno a HBM.
Según el anuncio, un AX8 se ha diseñado para alojar un modelo de 1,6 billones de parámetros en FP4 con espacio para la caché de claves y valores. Es una afirmación de capacidad del fabricante a una precisión concreta. Cada aplicación debe comprobar si su representación exacta del modelo, las longitudes de contexto y las solicitudes simultáneas caben en la configuración compatible. La memoria de trabajo necesaria crece más allá de los pesos almacenados según aumentan el número o la duración de las conversaciones.
Mantener el modelo residente elimina un obstáculo. Lo que percibe el usuario es el tiempo de espera y la calidad de la respuesta. Incluso un modelo que cabe puede necesitar ajustes para alcanzar la latencia objetivo. Si un modelo menor ya resuelve la tarea con suficiente precisión, quizá no haga falta ampliar la memoria. Elige primero el modelo y la precisión admisible para el trabajo, y después evalúa el hardware capaz de servirlo.
La velocidad interactiva y el rendimiento total favorecen diseños diferentes
Imagina un asistente documental interno que los empleados usan en reuniones. Una respuesta a tiempo para que avance la conversación vale algo distinto a cientos de respuestas completadas durante la noche. Para el asistente importan tanto el tiempo hasta el primer texto útil y el ritmo posterior de generación como el total de tokens servidos. Es una carga de trabajo ilustrativa, sin ensayo en Titania.
Otro equipo podría tramitar documentos atrasados sin que nadie espere cada respuesta. Puede tolerar más demora si el procesamiento por lotes aumenta el trabajo acabado por hora. Un servicio compartido grande quizá necesite ambos comportamientos según la hora. Fijar la velocidad por usuario y maximizar el rendimiento agregado puede producir clasificaciones distintas.
Axelera orienta Titania a la inferencia con respuesta rápida y reconoce en su página de producto que sistemas de GPU a escala de rack pueden sacar ventaja con lotes muy grandes. Los gráficos incluyen diferentes modelos y configuraciones de rack. Para comprar, interesa saber qué configuración satisface la latencia requerida con la concurrencia y el coste previstos. Condiciones de rendimiento de Titania
| Pregunta sobre la carga de trabajo | Evidencia que conviene pedir | Qué deja sin resolver un solo dato máximo |
|---|---|---|
| ¿Se puede usar un asistente de documentos en directo? | Tiempo hasta la primera respuesta y velocidad de generación con la concurrencia objetivo | Colas y respuestas especialmente lentas en horas punta |
| ¿Puede un servicio por lotes terminar el trabajo atrasado durante la noche? | Tareas completadas por hora con documentos representativos | Efecto de la longitud de entrada y los lotes sobre los plazos |
| ¿Puede un servidor combinar vídeo y lenguaje? | Resultados de extremo a extremo con descodificación, inferencia y lógica de aplicación activas | Carga del anfitrión, tareas que compiten y trabajo perdido o retrasado |
Antes de mirar las ratios de rendimiento, lee las condiciones de simulación
La página de Titania identifica sus cifras de rendimiento como simulaciones internas ejecutadas con el compilador de producción de Axelera. Un gráfico compara un sistema de ocho tarjetas Titania simulado en agosto de 2026 con datos de competidores de InferenceX fechados en septiembre de 2026. Entre las condiciones indicadas se incluyen FP4, 8.000 tokens de entrada y 1.000 de salida. Otros gráficos utilizan simulaciones de racks de octubre, cada una con su configuración.
Esas condiciones aclaran qué intentan comparar los gráficos y limitan lo que un comprador puede concluir. Una simulación que incorpora un compilador aporta información de ingeniería. La prueba independiente en hardware Titania de serie sigue siendo un paso distinto. Los despliegues previos de Metis o Europa ayudan a situar la tecnología de Axelera, sin convertir las proyecciones de Titania en mediciones de sistemas entregados.
Las ventajas anunciadas, de hasta siete veces en rendimiento por vatio y de hasta veinte veces en coste total de propiedad, pertenecen al marco de comparación del fabricante. No equivalen a un presupuesto ni permiten predecir la factura de un centro concreto. La página de producto indica que compara TDP con TDP y que los costes proceden del modelo de coste total de Axelera. El TDP es una cifra de diseño. El consumo de un servicio desplegado depende de todo el sistema y su carga de trabajo.
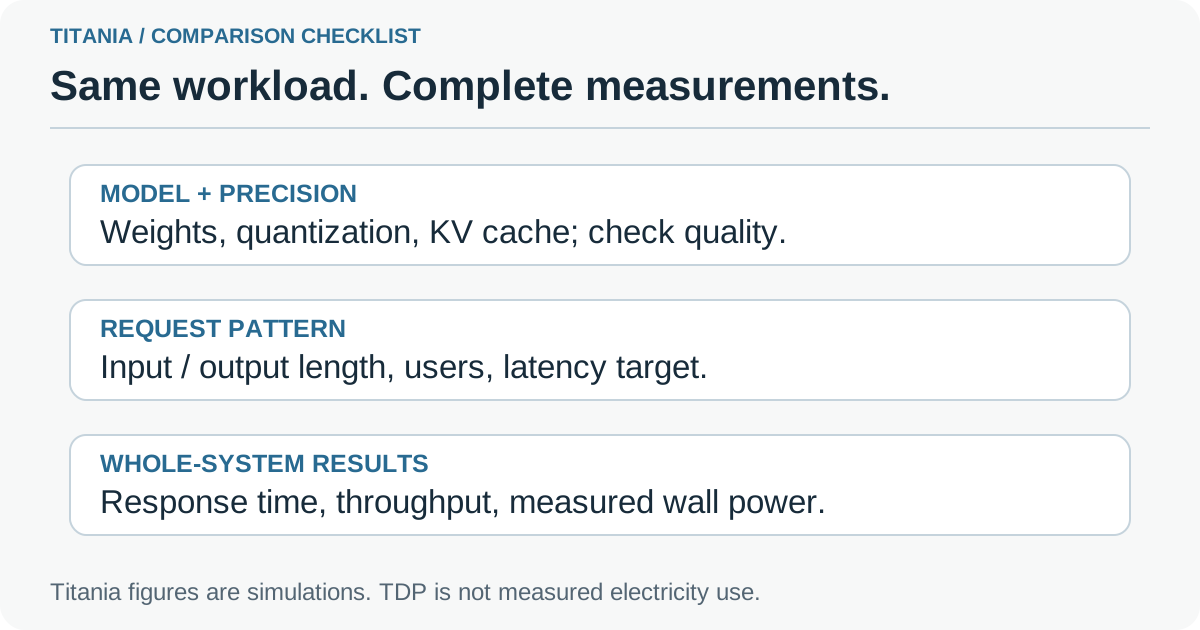
Gráfico explicativo propio. Interpreta cada comparación con el modelo, la precisión, la longitud de las solicitudes y la concurrencia. Las condiciones proceden de la página de producto Titania de Axelera.
Pide la configuración detrás de la ratio antes de llevarla a una hoja de compras. Conserva con el resultado la versión del modelo, su precisión, las comprobaciones de calidad y la distribución de las solicitudes. Aclara si se midió el acelerador, el servidor completo o las instalaciones. De otro modo, un resultado puede parecer mejor solo porque se midió un ámbito más estrecho.
El aire también exige margen eléctrico y térmico
La refrigeración por aire describe cómo cede el servidor calor al aire que lo rodea. Un sistema de climatización adecuado aún tiene que sacar ese calor de la sala. Los 5–6 kW típicos propuestos por Axelera representan una carga notable para una sola máquina 4U. El equipo de instalaciones necesita conocer la configuración presupuestada, las condiciones de montaje y la carga prevista para decidir si un rack puede alojarla.
Un cálculo sencillo permite hacerse a la idea. Una máquina que consuma de media 5–6 kW las 24 horas gastaría por sí sola 120–144 kWh en un día. Es una estimación bajo el supuesto de una media continua, sin medición de Titania. La carga real y el comportamiento en reposo pueden modificarla. La refrigeración, las pérdidas de conversión eléctrica y el resto de las instalaciones añaden su propio consumo.
La propuesta de Axelera promete la posibilidad de aprovechar un centro de datos existente sin reconstruirlo para un rack de alta densidad refrigerado por líquido. El ahorro depende de lo que las instalaciones ya admitan. Un centro con margen eléctrico y térmico afronta un proyecto distinto de otro cuyos circuitos y refrigeración se acercan a su límite. Instalar un chasis 4U o una tarjeta PCIe requiere más que ampliar un ordenador de sobremesa.
La continuidad del software puede importar tanto como la capacidad del hardware
Axelera afirma que el SDK Voyager y la base de AxeleraScript abarcan Metis, Europa y Titania. El anuncio describe planes para el paralelismo de tensores, expertos y etapas, la descodificación especulativa y la descarga o desagregación de la caché KV. Presenta asimismo la tarjeta Titania PCIe como futura opción de sustitución para el Axelera Server 250p basado en Europa. Son planes relevantes para equipos que ya evalúan el ecosistema del fabricante.
Para un usuario de Europa, la primera duda es cuánto podrá reutilizar: operaciones admitidas, conversiones del modelo, código de integración, monitorización y paquetes de despliegue. Para un equipo de otra plataforma, migrar a Voyager ya supone trabajo de ingeniería. Un SDK común reduce el esfuerzo entre productos de un fabricante. Aún así, cada aplicación debe validarse en el sistema de destino. La portabilidad se demuestra con el modelo y la cadena de procesamiento reales.
Un ejemplo es un servicio de vídeo que genera descripciones de eventos grabados. La descodificación 8K y la codificación 4K de H.265 y AV1 anunciadas en el chip podrían redistribuir el trabajo entre acelerador y anfitrión. Una prueba práctica debe incluir los ajustes de códec admitidos, la preparación de fotogramas, el modelo de lenguaje, el almacenamiento y la respuesta de la aplicación. La velocidad del modelo por sí sola no demuestra que el servicio completo pueda asumir la carga de vídeo.
Para un asistente documental privado también hay que diseñar la recuperación y el control de acceso. Llevar la inferencia al propio centro cambia el lugar de ejecución del modelo. Los permisos de documentos, registros, copias y credenciales del servicio necesitan su propio diseño. Añade al presupuesto del hardware un plan para decidir quién actualizará el entorno de ejecución, revisará cambios de modelos y restaurará el servicio ante fallos.
Una evaluación útil empieza con seis decisiones
El estado de Titania aconseja evaluar por etapas. Empieza por la aplicación y la referencia disponible hoy. Solicita pruebas conforme llegue el hardware con soporte. Una demostración del fabricante puede orientar el siguiente paso si quedan documentadas sus condiciones y límites. La aceptación final en el lugar de instalación sigue siendo una prueba propia.
- Define la tarea y el objetivo de servicio. Selecciona solicitudes representativas de documentos, agentes o vídeo. Fija la calidad, el tiempo de respuesta y la concurrencia en horas punta antes de escoger el mayor modelo.
- Registra la referencia actual. Usa el sistema existente o un servicio alojado para establecer volumen, latencia y costes de operación. Guarda las versiones de los modelos y solicitudes para poder comparar después.
- Pide la configuración admitida. Obtén la lista de modelos previstos, la distribución de memoria, las especificaciones del anfitrión, las versiones de software y las responsabilidades del integrador. Separa las funciones anunciadas de las demostradas en esa configuración.
- Encarga una inspección del emplazamiento. Entrega al equipo responsable los requisitos eléctricos, de flujo de aire y de instalación. Haz que considere los equipos vecinos y la capacidad de refrigeración disponible.
- Prueba el servicio completo cuando haya hardware. Incluye la llegada de solicitudes, la recuperación de datos, los códecs y la monitorización. Mide en el mismo intervalo la potencia del servidor entero, el trabajo completado y los tiempos de respuesta.
- Calcula el compromiso operativo. Incluye el tiempo de integración, el soporte, el mantenimiento y una alternativa viable. Compara costes de propiedad con la carga de trabajo prevista, incluidas las horas tranquilas.
Estos pasos respaldan también la decisión de conservar los equipos actuales. Si un modelo menor cumple el objetivo con poco trabajo operativo, evitar una migración ahorra dinero y tiempo. Si el límite está en la memoria o en la dificultad de la instalación, el diseño de Titania concreta las preguntas para el proveedor.
El calendario de producción también define el hardware
El anuncio de Axelera fija como objetivo de producción el tercer trimestre de 2027 y menciona compromisos de despliegue de clientes hasta principios de 2028. La página de producto contempla una ventana más amplia, el segundo semestre de 2027, y muestra una vía de actualización para 2028. Son previsiones de una hoja de ruta. El comienzo de la fabricación, la entrega de un servidor compatible y su montaje en un país concreto son hitos distintos.
Al planificar en noviembre de 2026, el precio regional, las fechas de entrega y la cobertura de servicio requieren confirmación de un integrador. Un compromiso de adquirir hardware futuro aporta evidencia distinta a la de una instalación operativa. Una organización que necesita inferencia ya debe contar con una solución disponible y un plan de operación con soporte. Puede incorporar Titania a una evaluación futura sin convertirlo en dependencia de un lanzamiento cercano.
El resultado de mayor valor sería una capacidad de inferencia que el equipo pudiera instalar, mantener y pagar en sus propias instalaciones. Titania plantea esa posibilidad al unir memoria, rendimiento interactivo e infraestructura existente. El siguiente paso es llevar las decisiones de diseño y las simulaciones a sistemas con soporte, medidos en las tareas que necesitan los clientes.
Fuentes
- Axelera AI, anuncio de la arquitectura Titania, 12 de noviembre de 2026
- Axelera AI, especificaciones de Titania, calendario y condiciones de simulación, consulta del 18 de noviembre de 2026.
- Proyecto DARE, su socio Axelera presenta Titania, 12 de noviembre de 2026
Guarda juntos el alcance de la carga, las preguntas al proveedor y los resultados de las pruebas para partir de los mismos supuestos en la próxima comparación. Crea tu primera nota con Telli.sh.