Tysiąc alertów, jedna osiągalna baza danych: AWS Continuum zmienia kolejkę
AWS Continuum for code vulnerabilities jest ogólnie dostępny. Jego praktyczna obietnica to dowody wykorzystywalności i wpływu biznesowego, zanim zespół poświęci kolejny dzień na przegląd wygenerowanych poprawek.
Pulpit bezpieczeństwa pokazuje setki ustaleń. Jedno dotyczy narzędzia, do którego nigdy nie trafia ruch z zewnątrz. Drugie leży o kilka kroków od systemu z danymi płatniczymi klientów. Sam poziom istotności nie mówi małemu zespołowi inżynierskiemu, co naprawić najpierw.
22 października 2026 r. AWS ogłosił ogólną dostępność Continuum for code vulnerabilities. Usługa łączy analizę kodu z kontekstem środowiska, ocenia możliwość wykorzystania i konsekwencje biznesowe oraz proponuje poprawki do przeglądu. Szczegółowy artykuł premierowy umieszcza człowieka przed końcową decyzją naprawczą. Ogłoszenie AWS.
AWS to dostawca infrastruktury chmurowej stojący za EC2 i S3. Ma to znaczenie, bo pilność słabości kodu zależy od sieci, zasobów i otaczających danych. Ciekawa deklaracja Continuum dotyczy lepiej uzasadnionej kolejki napraw, nie po prostu kolejnego sposobu generowania łatek.
 Centra danych AWS w Oregonie, sierpień 2023 r. Zdjęcie: Tedder / Wikimedia Commons, CC BY-SA 4.0. Zmniejszono i przekonwertowano do WebP bez przycinania. Zewnętrzne zdjęcie tła nie przedstawia interfejsu Continuum; zobacz oficjalne ogłoszenie i ekrany produktu.

Podatność staje się incydentem przez konkretną ścieżkę
Skaner może rozpoznać niebezpieczną funkcję lub zależność ze znaną słabością. Możliwość jej użycia przez napastnika zależy od dodatkowych faktów. Czy podatna ścieżka kodu jest uruchamiana? Czy dociera do niej zewnętrzne żądanie? Jakie uprawnienia i dane staną się dostępne, jeśli żądanie się powiedzie?
Te pytania łączą bezpieczeństwo aplikacji ze sposobem wdrożenia systemu. Narzędzie tylko deweloperskie i publiczna usługa mogą współdzielić podatny komponent, ale prezentować zupełnie inne ryzyko. Odwrotnie, problem o mniej alarmującym ogólnym wyniku może wymagać natychmiastowej uwagi, jeśli prowadzi wprost do ważnego systemu.
Premiera Continuum opisuje graf kontekstu budowany z kodu i opcjonalnie informacji o środowisku AWS z uprawnionego collectora. Kontekst wiąże ustalenia z zasobami i systemami istotnymi dla biznesu. Kontekst i collector; przegląd usługi.
Naszym zdaniem czyni to priorytetyzację centralnym pytaniem o produkt. Poprawka AI jest użyteczna tylko wtedy, gdy zespół rozumie problem na tyle, by ocenić zmianę i zdecydować o wydaniu. Więcej automatycznej treści nie pomaga, jeśli powiększa już nieopanowaną kolejkę przeglądów.
Kolejka przypomina poczekalnię. Sortowanie według głośności alarmu jest mniej użyteczne niż rozumienie pilnego stanu, dowodów oceny i efektu leczenia. Usługa bezpieczeństwa zdobywa zaufanie, pozwalając zbadać to rozumowanie.
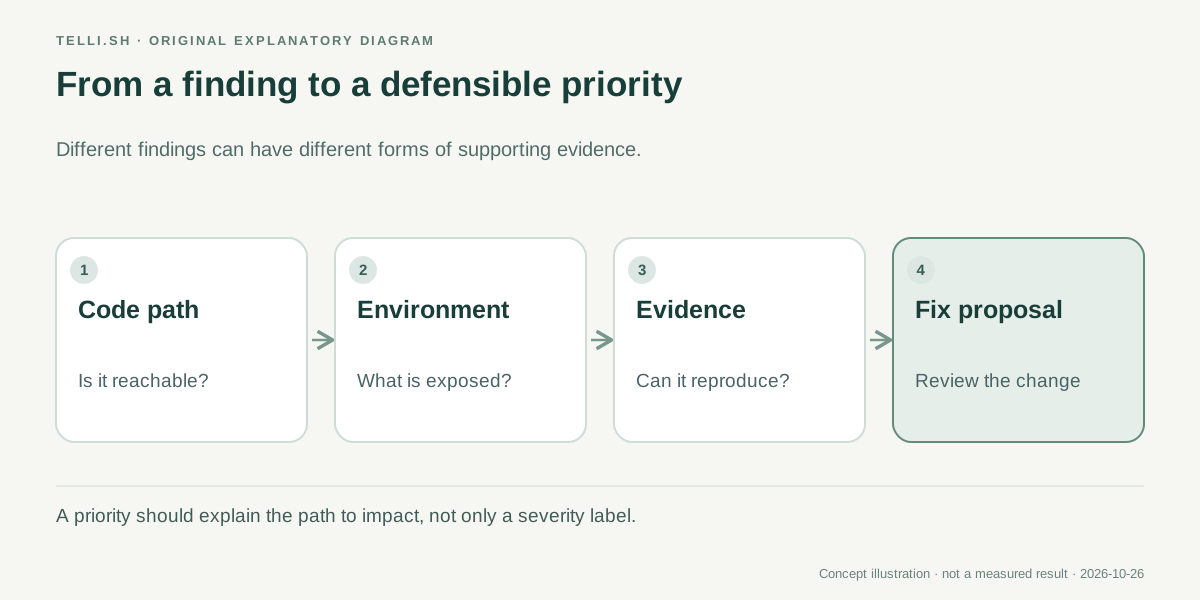 Autorskie wyjaśnienie przeglądu opartego na dowodach. Nie każdy problem ma ten sam rodzaj potwierdzenia ani da się odtworzyć tak samo.
Poziomy dowodów znaczą więcej niż pewne wyjaśnienie
AWS opisuje kilka rodzajów potwierdzenia. Ustalenie może wynikać ze statycznej analizy ścieżki kodu. Dla odtwarzalnych problemów usługa może użyć izolowanej piaskownicy, dołączając kod proof of concept i kroki reprodukcji. To istotna różnica: wiarygodna opowieść o ataku nie jest odtworzonym exploitem.
Przykład premierowy rozróżnia też wytworzenie łatki od rozwiązania problemu. Continuum może otworzyć pull request, ale zespół musi go sprawdzić i scalić. Samo istnienie wygenerowanej zmiany nie oznacza naprawy produkcyjnej usługi. Prezentacja i przegląd.
Dowody powinny pozwolić recenzentowi odpowiedzieć na konkretne pytania. Jakie wejście dociera do podatnej operacji? Jakich założeń o uwierzytelnianiu i uprawnieniach wymaga demonstracja? Czy proponowana zmiana usuwa ścieżkę bez uszkodzenia uprawnionego użycia?
Warto oddzielić te pytania od jakości języka raportu. Jasne wyjaśnienie przyspiesza przegląd, lecz klarowność nie stanowi niezależnego potwierdzenia. Techniczne twierdzenie nadal opiera się na kodzie, konfiguracji i warunkach reprodukcji.
W pilotażu uwzględnij przykłady, w których wykorzystanie powinno zawieść. Skutecznie chroniona usługa, nieużywana ścieżka zależności i problem już złagodzony konfiguracją pokażą, czy narzędzie rozumie kontekst, czy tylko powtarza ocenę skanera.
Usługa płatnicza i narzędzie deweloperskie potrzebują innych decyzji
Rozważmy przykładową aplikację z publiczną usługą zamówień i prywatnym generatorem raportów używanym wyłącznie w rozwoju. Obie mają pozornie poważne ustalenia. Usługa zamówień obsługuje żądania powiązane z transakcjami klientów, a generator nie ma planowanej roli produkcyjnej.
Ocena oparta na dowodach najpierw ustali fakty wdrożeniowe. Sprawdzi osiągalność rzekomo prywatnego narzędzia, rzeczywiste przekroczenie granicy zaufania w zamówieniach oraz dane i operacje dostępne każdą ścieżką. Opis architektury zespołu trzeba porównać z wdrożoną konfiguracją.
Jeśli ścieżka zamówień się potwierdzi, poprawka nadal musi mieć ograniczony zakres. Łatka blokująca złośliwe żądania, ale odrzucająca też prawidłowe zamówienia tylko przenosi problem. Testy regresji powinny objąć zachowanie, które zespół chce zachować.
Jeśli narzędzie deweloperskie faktycznie nie występuje we wdrożeniu, jego naprawę można zaplanować inaczej. Nie jest to powód do wiecznego ignorowania. To podstawa odróżnienia bezpośredniej ekspozycji od utrzymania oraz zachowania uzasadniających dowodów.
Przykład służy planowaniu oceny, nie opisuje wyniku klienta. Najważniejsza jest kolejność napraw możliwa do obrony bieżącymi informacjami. Narzędzie zgadzające się z każdym dotychczasowym priorytetem uczy mniej niż to, które wyjaśnia zaskakującą, lecz weryfikowalną różnicę.
Pierwsze wdrożenie powinno zbadać jedną aplikację, nie zezwalać na wszystkie poprawki
Ogłoszenie ogólnej dostępności wskazuje początkowe regiony US East w Northern Virginia i US West w Oregonie. Opisuje źródło kodu przez GitHub lub S3 oraz opcjonalny kontekst AWS przez collector. Wymagania konta, regionu i dostępu pozostają częścią konfiguracji. Dostępność i wymagania źródłowe.
Dobrym początkiem próby jest aplikacja o znanej architekturze i ważnych procesach. Ułatwi zauważenie niespodziewanego problemu i brakującego założenia. Recenzenci zyskają też punkt odniesienia dla tego, co usługa powinna uznać za krytyczne.
- Wybierz repozytorium lub obsługiwane źródło i ustal faktyczne środowisko aplikacji.
- Przeczytaj bieżące wymagania, wybierz obsługiwany region i oceń dostęp konieczny do połączenia kodu.
- Zdecyduj o uprawnionym collectorze AWS i kontekście środowiska, który ma dostarczać.
- Porównaj pierwsze ustalenia ze znanymi problemami, zabezpieczeniami i świadomie wybranymi trudnymi przypadkami.
- Zbadaj dowody jednej proponowanej naprawy, jej założenia i możliwy wpływ na prawidłowych użytkowników.
- Sprawdź pull request, uruchom odpowiednie kontrole i zweryfikuj wynik wdrożenia w normalnym procesie wydawniczym zespołu.
To proponowana sekwencja oceny. Nie zastępuje aktualnej instrukcji produktu ani zasad wdrażania organizacji. Pożytecznym nawykiem jest zachowanie odrębności dostępu do źródła, oceny dowodów i zgody na wydanie.
Koszty należy liczyć podobnie. Zespół potrzebuje bieżących cen i planowanego zakresu skanowania. Musi też uwzględnić czas przyjmowania, odrzucania lub poprawiania propozycji. Łatka oszczędzająca kodowanie może tworzyć wysiłek przeglądu gdzie indziej.
Propozycja naprawy i autonomiczna naprawa to inne etapy
Szczegółowy artykuł premierowy mówi, że naprawa zaczyna się od propozycji zatwierdzanej przez człowieka. Szersze autonomiczne stosowanie wybranych poprawek opisuje jako przyszłą funkcję. Inne teksty AWS szerzej omawiają stopniowe wymuszanie. Dla zespołu decydującego o wdrożeniu ostrożnym i praktycznym punktem startu jest udokumentowana ścieżka ludzkiego przeglądu. Szczegółowy opis premiery; ogłoszenie What's New.
To nie drobiazg językowy. Automatyczne przygotowanie łatki, otwarcie pull requestu i zmiana działającego systemu mają inne skutki. Demonstracji jednego etapu nie należy traktować jako dowodu, że wszystkie następne są aktywne lub właściwe.
| Etap | Czego dowiaduje się zespół | Co pozostaje do ustalenia |
|---|---|---|
| Ustalenie | Istnieje podejrzana słabość | Czy kod i konfiguracja są faktycznie używane |
| Dowody i kontekst | Dlaczego ścieżka może być wykorzystywalna i ważna | Czy założenia odpowiadają obecnemu środowisku |
| Proponowana łatka lub PR | Jest konkretna zmiana do przeglądu | Czy naprawia problem i zachowuje pożądane działanie |
| Scalona i wdrożona zmiana | System otrzymał zatwierdzoną modyfikację | Czy podatna droga jest zamknięta bez nowej regresji |
Rozdzielenie pozwala wprowadzać automatyzację stopniowo. Usługa może być cennym źródłem dowodów, zanim zespół zacznie rutynowo przyjmować łatki. Może też tworzyć użyteczne poprawki, zanim firma zechce jakiegokolwiek automatycznego wydania.
Kolejne interesujące dowody dotyczą powtarzanego działania w realnym środowisku. Czy zaakceptowany typ naprawy pozostaje bezpieczny po zmianie aplikacji? Czy recenzent widzi powód innego priorytetu pozornie podobnego problemu? Czy system rozpozna niekompletny kontekst?
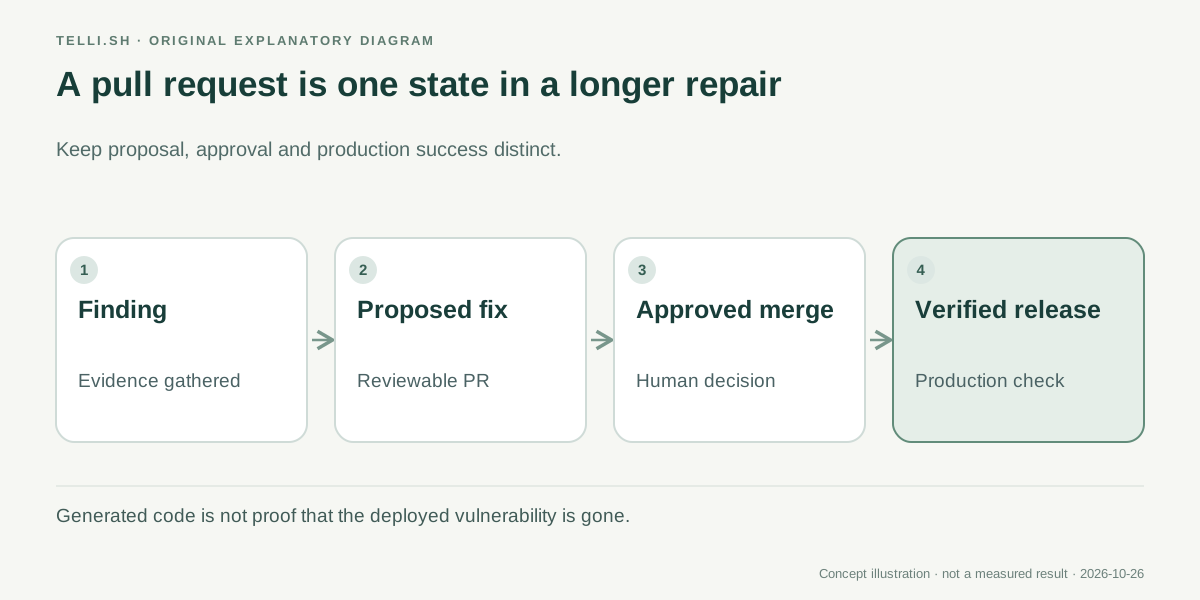 Wygenerowany PR jest artefaktem do przeglądu. Skuteczna naprawa produkcyjna to późniejszy stan z własnymi dowodami.
Collector kontekstu zasługuje na taką samą kontrolę jak model
Lepszy kontekst może poprawić ocenę bezpieczeństwa, ale dostarczające go połączenie staje się częścią założeń działania systemu. Jeśli collector widzi tylko niektóre zasoby, raport opisze jedynie część ścieżki ataku. Zmiana środowiska może wymagać ponownej oceny wcześniejszego wniosku.
Dlatego pilotaż powinien zapisywać podłączone źródła i moment ich aktualności. Raport należy interpretować w odniesieniu do tego zakresu. Przejrzenie jednego zbioru ustaleń nie może zamieniać się w ogólne twierdzenie, że aplikacja jest bezpieczna.
Ta sama zasada dotyczy wpływu biznesowego. Technicznie osiągalna baza może przechowywać mało istotne testowe dane, a pozornie poboczny zasób obsługiwać krytyczny proces. Właściciel biznesowy i zespół inżynierski muszą wspólnie rozumieć znaczenie zasobu.
To obiecujący podział pracy. Oprogramowanie pomaga łączyć duże ilości technicznych dowodów i tworzyć konkretną propozycję. Ludzie decydują, który system jest istotny, czy założenia są poprawne i jakie ryzyko wydania akceptuje biznes.
Skuteczna ocena mierzy fałszywe alarmy oraz pominięte priorytety. Mniej alertów wygląda imponująco nawet wtedy, gdy ważne problemy znikają z pola widzenia. Celem jest kolejka zachowująca właściwą pracę i dająca lepszy powód do jej wykonania.
Użyteczna AI bezpieczeństwa ułatwia uzasadnienie kolejnej decyzji
Premiera Continuum jest ciekawa, bo łączy naprawę wspieraną AI z kontekstem mówiącym, czy warto poświęcić jej uwagę. To użyteczniejsza ambicja niż kolejny stos wiarygodnych zmian kodu.
Przed przyjęciem poprawki zapytaj, co zmieniło się w rozumieniu ryzyka. Jeśli odpowiedź obejmuje osiągalną ścieżkę, sprawdzalne dowody i ograniczoną naprawę, narzędzie pomogło w trudnej części. Jeśli daje tylko pewny akapit i nowy PR, kolejka nadal należy do ciebie.
Źródła
- AWS: Continuum for code vulnerabilities is generally available, 22 października 2026 r.
- AWS What's New: Continuum GA, 22 października 2026 r.
- Podręcznik AWS Continuum, sprawdzony 26 października 2026 r.
Zachowaj związek przeglądu ze źródłem
Telli.sh to jedna z możliwości zachowania dozwolonych materiałów źródłowych i notatek stojących za decyzją techniczną. Utwórz przestrzeń notatek.