Mille avvisi e un database raggiungibile: AWS Continuum cambia la coda delle priorità
AWS Continuum for code vulnerabilities è generalmente disponibile. La promessa utile sono prove su sfruttabilità e impatto aziendale prima di dedicare un'altra giornata alle correzioni generate.
La dashboard di sicurezza mostra centinaia di rilievi. Uno riguarda un'utilità che non riceve traffico esterno. Un altro è a pochi passaggi dal sistema con i dati di pagamento dei clienti. La sola etichetta di gravità non dice a un piccolo team che cosa correggere per primo.
Il 22 ottobre 2026 AWS ha annunciato la disponibilità generale di Continuum for code vulnerabilities. Il servizio collega analisi del codice e contesto dell'ambiente, valuta sfruttabilità e impatto aziendale e propone correzioni da rivedere. L'articolo dettagliato del lancio prevede una persona prima della decisione finale di rimedio. Annuncio AWS.
AWS fornisce l'infrastruttura cloud alla base di servizi come EC2 e S3. Questo conta perché l'urgenza di un difetto dipende da reti, risorse e dati circostanti. La proposta interessante di Continuum è una coda di riparazione meglio informata, più che un altro generatore di patch.
 Data center AWS in Oregon, agosto 2023. Foto: Tedder / Wikimedia Commons, CC BY-SA 4.0. Ridimensionata e convertita in WebP senza ritagli. Questa foto esterna di contesto non mostra Continuum; vedi annuncio e schermate ufficiali.

Una vulnerabilità diventa incidente attraverso un percorso
Uno scanner può trovare una funzione pericolosa o una dipendenza con un difetto noto. La possibilità di sfruttarla dipende da altro. Il percorso vulnerabile viene utilizzato? Una richiesta esterna può raggiungerlo? Quali dati e permessi diventano disponibili se riesce?
Queste domande collegano la sicurezza al dispiegamento del sistema. Uno strumento solo di sviluppo e un servizio esposto possono condividere lo stesso componente ma presentare rischi molto diversi. Al contrario, un punteggio generico meno allarmante può meritare attenzione immediata se conduce a un sistema importante.
Continuum descrive un grafo di contesto costruito dal codice e, se configurato, dai dati AWS raccolti da un collector autorizzato. Il contesto collega i rilievi alle risorse e ai sistemi critici dell'attività. Contesto e collector; panoramica del servizio.
A nostro avviso la priorità diventa la domanda centrale del prodotto. Una patch IA serve solo se il team capisce il problema abbastanza da rivederla e decidere quando pubblicarla. Più risultati automatici non aiutano se allungano una coda già ingestibile.
La coda è come una sala d'attesa. Ordinare tutti secondo il volume dell'allarme serve meno che capire urgenza, prove del giudizio e cosa cambierebbe il trattamento. Un servizio conquista fiducia rendendo ispezionabile questo ragionamento.
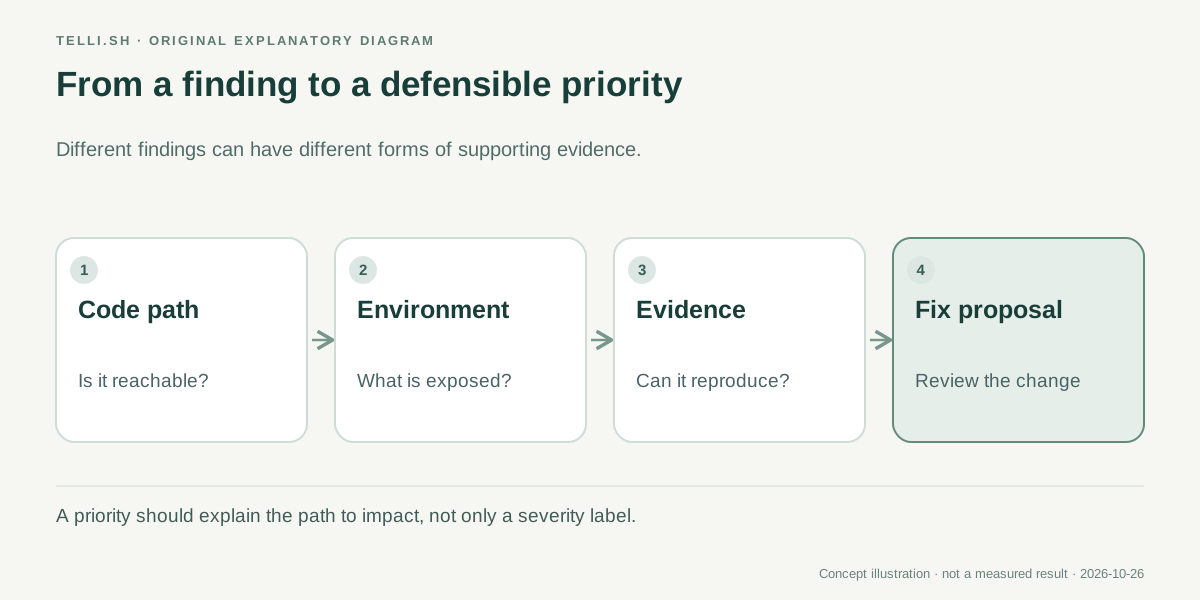 Spiegazione originale di una revisione guidata dalle prove. Non tutti i rilievi hanno la stessa evidenza o sono riproducibili allo stesso modo.
Il livello delle prove conta più di una spiegazione sicura
AWS descrive più forme di evidenza. L'analisi statica può stabilire un percorso nel codice. Per i problemi riproducibili, il servizio può usare un sandbox isolato e allegare una prova di concetto con i passaggi. Una narrazione plausibile dello sfruttamento è diversa da un exploit riprodotto.
Il lancio distingue anche la creazione di una patch dalla soluzione. Continuum può aprire una pull request, ma il team deve rivederla e integrarla. La presenza del cambiamento non dimostra che il servizio vulnerabile sia riparato in produzione. Dimostrazione e revisione.
Le prove devono permettere risposte concrete. Quale ingresso raggiunge l'operazione? Quali ipotesi fa il test su autenticazione e permessi? La modifica elimina il percorso senza rompere un utilizzo legittimo?
Queste domande vanno separate dalla qualità della scrittura. La chiarezza facilita la revisione, ma non è una validazione indipendente. A sostenere l'affermazione tecnica restano codice, configurazione e condizioni di riproduzione.
Nel pilota includi esempi in cui lo sfruttamento dovrebbe fallire. Un controllo efficace, un percorso di dipendenza inutilizzato o un problema già mitigato dalla configurazione aiutano a capire se lo strumento comprende il contesto o ripete il punteggio dello scanner.
Un servizio di pagamento e uno strumento di sviluppo richiedono decisioni diverse
Consideriamo un'applicazione illustrativa con checkout pubblico e generatore di report privato, usato solo nello sviluppo. Entrambi hanno rilievi che sembrano seri isolatamente. Il primo gestisce richieste collegate alle transazioni; il secondo non ha un ruolo previsto in produzione.
Una revisione basata sulle prove verifica prima il dispiegamento reale. Controlla se l'utilità ritenuta privata sia raggiungibile, se il difetto del checkout attraversi un confine di fiducia e quali dati o operazioni esponga ciascun percorso. Il documento di architettura va confrontato con la configurazione effettiva.
Se il percorso del checkout è confermato, serve comunque una correzione circoscritta. Bloccare richieste malevole ma respingere ordini validi sposta il problema anziché risolverlo. I test di regressione devono preservare il comportamento legittimo.
Se lo strumento di sviluppo è davvero assente dal dispiegamento, la riparazione può avere un calendario diverso. Non è un motivo per ignorarlo per sempre. È un motivo per distinguere esposizione immediata e manutenzione, conservando le prove di tale distinzione.
È un esempio per impostare una valutazione, non un risultato cliente. L'esito importante è un ordine delle riparazioni difendibile con dati attuali. Uno strumento che concorda sempre con le priorità esistenti rivela meno di uno che spiega una differenza sorprendente ma verificabile.
Il primo utilizzo dovrebbe ispezionare un'applicazione, non autorizzare ogni correzione
L'annuncio identifica le regioni iniziali US East in Northern Virginia e US West in Oregon. Descrive fonti di codice GitHub o S3 e contesto AWS opzionale tramite collector. Account, regione e accessi restano requisiti di configurazione. Disponibilità e fonti.
Un buon punto di partenza è un'applicazione di cui si conoscono architettura e flussi importanti. Diventa più facile notare un risultato inatteso e un'ipotesi mancante. I revisori hanno anche una base per capire ciò che dovrebbe essere considerato critico.
- Seleziona repository o fonte supportata e identifica l'ambiente rappresentato davvero.
- Leggi i requisiti attuali, scegli la regione supportata e verifica gli accessi del collegamento al codice.
- Decidi se aggiungere un collector autorizzato e quale contesto debba fornire.
- Confronta i primi risultati con difetti e mitigazioni noti e casi difficili selezionati.
- Ispeziona le prove di una proposta, incluse ipotesi ed effetti sugli utenti legittimi.
- Rivedi la pull request, esegui i controlli e verifica il risultato distribuito con il normale processo di rilascio.
La sequenza propone una valutazione. Non sostituisce la guida corrente o le regole aziendali. L'abitudine utile è distinguere accesso alle fonti, revisione delle prove e approvazione del rilascio.
Anche il costo segue la stessa logica. Occorre conoscere prezzi e quantità di lavoro da analizzare. Bisogna contare il tempo per accettare, rifiutare o correggere la proposta. Una patch che risparmia programmazione può creare revisione altrove.
Una proposta di riparazione e una riparazione autonoma sono traguardi diversi
L'articolo dettagliato dice che il rimedio parte da una proposta approvata da una persona. L'applicazione autonoma più ampia di correzioni selezionate è descritta come futura. Altri testi AWS parlano più genericamente di applicazione progressiva. Per un dispiegamento, il punto di partenza prudente e concreto è il percorso documentato con revisione umana. Descrizione dettagliata; annuncio What's New.
Non è una sfumatura minore. Preparare una patch, aprire una pull request e modificare un sistema in esecuzione hanno conseguenze diverse. Dimostrare una fase non prova che tutte le successive siano abilitate o appropriate.
| Fase | Che cosa apprende il team | Che cosa stabilire ancora |
|---|---|---|
| Rilievo | Esiste una possibile debolezza | Uso effettivo di codice e configurazione pertinenti |
| Prove e contesto | Perché il percorso è sfruttabile e importante | Corrispondenza delle ipotesi con l'ambiente attuale |
| Patch o PR proposta | C'è una modifica concreta da rivedere | Efficacia e conservazione del comportamento previsto |
| Modifica integrata e distribuita | Il sistema ha ricevuto una modifica approvata | Chiusura del percorso senza nuove regressioni |
Questa separazione consente un uso graduale. Il servizio può essere una fonte di prove prima che il team accetti regolarmente le patch. Può produrre patch utili prima che l'organizzazione voglia rilasci automatici.
Le prossime evidenze riguardano operazioni ripetute in ambienti reali. Una classe di correzioni resta sicura quando cambia l'applicazione? Il revisore comprende perché rilievi simili hanno priorità diverse? Il sistema rileva quando il suo contesto è incompleto?
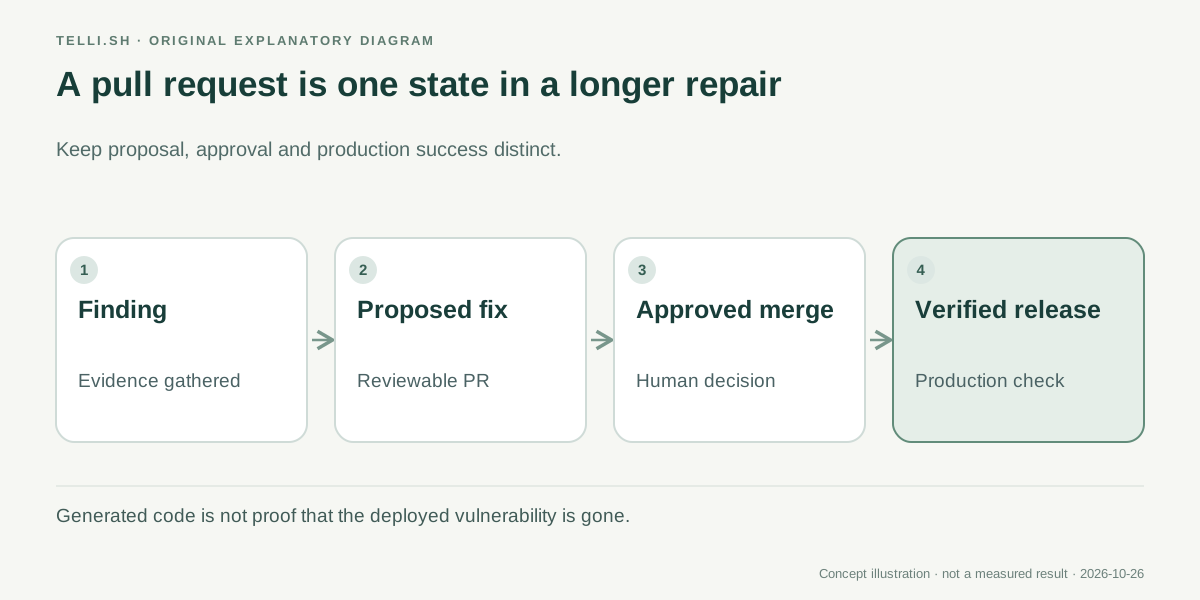 Una PR generata è un artefatto da rivedere. Il rimedio riuscito in produzione è uno stato successivo con prove proprie.
Il collector merita lo stesso esame del modello
Più contesto può migliorare il giudizio, ma il collegamento che lo fornisce entra nelle ipotesi operative. Se il collector vede solo alcune risorse, il report può mostrare parte del percorso d'attacco. Se l'ambiente cambia, un giudizio precedente può richiedere revisione.
Il pilota deve registrare fonti collegate e attualità dei dati. Il report va letto rispetto a quell'ambito. Rivedere un insieme di rilievi non diventa una dichiarazione universale di sicurezza.
Lo stesso vale per l'impatto aziendale. Un database può essere raggiungibile ma contenere dati di prova poco importanti, oppure sembrare marginale e sostenere un flusso critico. Responsabile aziendale e ingegneri devono condividere il significato della risorsa.
C'è una divisione promettente del lavoro. Il software collega grandi quantità di prove tecniche e produce una proposta. Le persone decidono quale sistema conti, se le ipotesi siano corrette e quale rischio di rilascio assumere.
Una valutazione efficace misura falsi allarmi e priorità mancate. Meno avvisi può impressionare anche quando scompaiono problemi importanti. L'obiettivo è una coda che conserva il lavoro giusto e spiega meglio perché agire.
Lo strumento di sicurezza utile rende giustificabile la prossima decisione
Continuum interessa perché collega la riparazione assistita al contesto che ne determina l'urgenza. È più utile che produrre un'altra pila di modifiche plausibili.
Prima di accettare, chiediti cosa sia cambiato nella comprensione del rischio. Percorso raggiungibile, prove ispezionabili e modifica circoscritta significano aiuto nella parte difficile. Un paragrafo sicuro e una nuova PR lasciano ancora a te la gestione della coda.
Fonti
- AWS: Disponibilità generale di Continuum for code vulnerabilities, 22 ottobre 2026.
- AWS What's New: Continuum GA, 22 ottobre 2026.
- Guida utente AWS Continuum, consultata il 26 ottobre 2026.
Mantieni la revisione collegata alla fonte
Telli.sh è un'opzione per conservare materiale autorizzato e note alla base di una decisione tecnica. Crea uno spazio per le note.