Mille alertes de sécurité, une base accessible : AWS Continuum change les priorités
AWS Continuum pour les vulnérabilités du code est disponible. Sa promesse utile : apporter des preuves d'exploitabilité et d'impact métier avant de consacrer encore une journée à vérifier des correctifs générés.
Un tableau de bord de sécurité affiche des centaines de problèmes. L'un se trouve dans un utilitaire qui ne reçoit jamais de trafic extérieur. Un autre est à quelques étapes du système qui contient les données de paiement des clients. Une étiquette de gravité ne dit pas, à elle seule, lequel une petite équipe doit corriger en premier.
Le 22 octobre 2026, AWS a annoncé la disponibilité générale de Continuum pour les vulnérabilités du code. Le service associe analyse du code et contexte d'environnement, évalue l'exploitabilité et l'impact métier, puis propose des corrections à vérifier. L'article de lancement détaillé place une personne avant la décision finale de remédiation. Annonce de lancement AWS.
AWS est le fournisseur d'infrastructure cloud derrière des services comme EC2 et S3. Ce contexte compte ici : une faiblesse du code devient plus ou moins urgente selon le réseau, les ressources et les données qui l'entourent. La promesse intéressante de Continuum est une file de corrections mieux informée, plutôt qu'une nouvelle façon de générer un patch.
 Centres de données AWS dans l'Oregon, août 2023. Photo : Tedder / Wikimedia Commons, CC BY-SA 4.0. Redimensionnée et convertie en WebP sans recadrage. Cette photographie externe de contexte ne montre pas l'interface de Continuum ; voir l'annonce et les écrans officiels.

Une vulnérabilité devient un incident par un chemin d'accès
Un outil d'analyse peut repérer une fonction dangereuse ou une dépendance avec une faiblesse connue. La possibilité de l'exploiter dépend d'autres faits. Le chemin de code vulnérable est-il réellement utilisé ? Une requête externe peut-elle l'atteindre ? Quels droits et quelles données deviennent accessibles si elle réussit ?
Ces questions relient la sécurité applicative à la manière dont le système est déployé. Un outil de développement et un service exposé peuvent partager un composant vulnérable tout en présentant des risques très différents. À l'inverse, un problème au score générique moins alarmant peut exiger une intervention immédiate s'il mène directement à un système important.
Le lancement de Continuum décrit un graphe de contexte construit à partir du code et, si cette option est configurée, d'informations d'environnement AWS recueillies par un collecteur autorisé. Le service s'en sert pour relier les problèmes aux ressources et aux systèmes critiques pour l'activité. Contexte et collecteur ; présentation du service.
À notre avis, cela place la priorisation au centre du produit. Une correction générée par IA n'est utile que si l'équipe comprend suffisamment le problème pour vérifier le changement et décider quand le livrer. Davantage de résultats automatisés n'aide pas si cela grossit une file de vérification déjà ingérable.
Cette file ressemble à une salle d'attente. Classer chacun selon le volume de son alarme est moins utile que comprendre quelle situation est urgente, quelles preuves soutiennent ce jugement et ce que le traitement changerait. Un service de sécurité mérite la confiance en rendant ce raisonnement vérifiable.
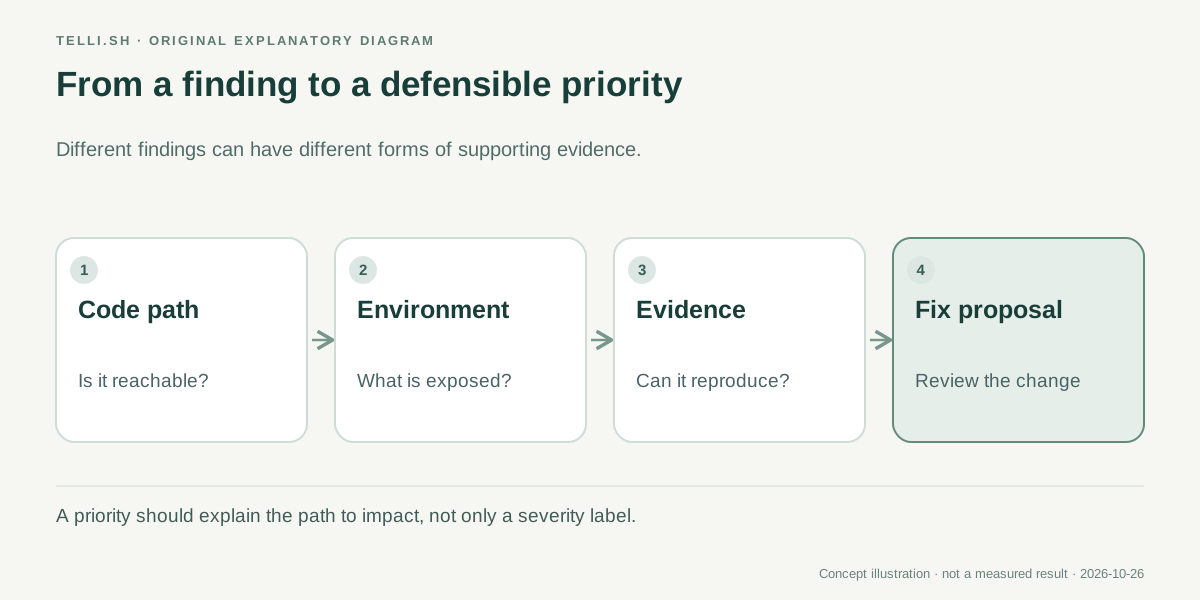 Explication originale d'une vérification guidée par les preuves. Tous les problèmes n'ont pas le même type de preuve et ne se reproduisent pas de la même manière.
Le niveau de preuve compte plus qu'une explication assurée
AWS décrit plusieurs formes de pièces à l'appui. Un problème peut être établi par analyse statique d'un chemin de code. Pour ceux que le service peut reproduire, il peut utiliser un environnement isolé et joindre un code de preuve de concept ainsi que des étapes de reproduction. La distinction est essentielle : un récit plausible d'exploitation n'est pas un exploit reproduit.
La démonstration de lancement distingue aussi utilement la production d'un patch de la résolution du problème. Continuum peut ouvrir une pull request, mais l'équipe doit la vérifier et la fusionner. L'existence d'un changement généré ne signifie pas, à elle seule, que le service vulnérable est réparé en production. Démonstration de lancement et circuit de vérification.
À partir des preuves, un réviseur doit pouvoir répondre à des questions concrètes. Quelle entrée atteint l'opération vulnérable ? Quelles hypothèses la preuve fait-elle sur l'authentification ou les droits ? Le changement proposé supprime-t-il ce chemin sans casser un usage légitime ?
Il est utile de séparer ces questions de la qualité rédactionnelle du rapport. Une explication claire peut accélérer la relecture, mais la clarté n'est pas une validation indépendante. Le code, la configuration et les conditions de reproduction portent toujours l'affirmation technique.
Dans un pilote, incluez des exemples où l'exploitation devrait échouer. Un service derrière un contrôle efficace, un chemin de dépendance inutilisé et un problème déjà atténué par une configuration peuvent montrer si l'outil comprend le contexte ou répète simplement la gravité de l'analyseur initial.
Un service de paiement et un outil de développement appellent des décisions différentes
Prenons une application illustrative avec un service public de paiement et un générateur privé de rapports utilisé uniquement pendant le développement. Tous deux contiennent des problèmes qui semblent graves isolément. Le service de paiement traite des requêtes liées aux transactions des clients ; le générateur n'a aucun rôle prévu en production.
Une vérification guidée par les preuves établirait d'abord les faits du déploiement réel. Elle examinerait si l'utilitaire supposé privé est accessible, si le problème du paiement franchit une véritable frontière de confiance et quelles données ou opérations deviennent accessibles par chaque chemin. La description du document d'architecture doit être comparée à la configuration déployée.
Si le chemin du paiement est confirmé, la correction proposée doit encore rester circonscrite. Un patch qui bloque une requête malveillante mais rejette aussi les commandes valides déplace le problème plutôt qu'il ne le résout. Les contrôles de non-régression doivent couvrir le comportement légitime à préserver.
Si l'outil de développement est vraiment absent de l'application déployée, l'équipe peut planifier sa réparation différemment. Ce n'est pas une raison de l'ignorer définitivement. C'est une raison de distinguer exposition immédiate et maintenance, et de conserver les preuves justifiant cette différence.
Cet exemple cadre une évaluation ; il ne rapporte pas un résultat client. Le résultat important est un ordre de réparation défendable avec des informations actuelles. Un outil qui confirme toutes les priorités existantes apporte moins qu'un outil expliquant une différence surprenante mais vérifiable.
Le premier déploiement doit examiner une application, pas autoriser tous les correctifs
L'annonce de disponibilité générale cite comme régions initiales US East en Virginie du Nord et US West dans l'Oregon. Elle décrit la connexion d'une source de code par GitHub ou S3, avec ajout facultatif du contexte d'environnement AWS par un collecteur. Compte, région et droits d'accès font partie de la configuration. Disponibilité et conditions des sources.
Pour un essai, le bon point de départ est une application dont l'architecture et les parcours importants sont déjà compris. On peut ainsi remarquer plus facilement une découverte inattendue ou une hypothèse manquante. Les personnes qui vérifient disposent aussi d'une référence pour savoir ce que le service doit considérer comme critique.
- Sélectionnez le dépôt ou la source compatible et identifiez l'environnement applicatif réellement représenté.
- Lisez les exigences actuelles du service, choisissez une région prise en charge et examinez les droits nécessaires à la connexion du code.
- Décidez d'ajouter ou non un collecteur AWS autorisé et du contexte d'environnement qu'il doit fournir.
- Comparez les premiers résultats aux problèmes connus, aux mesures d'atténuation connues et à des cas difficiles choisis délibérément.
- Examinez les preuves d'une réparation proposée, notamment ses hypothèses et son effet probable sur les utilisateurs légitimes.
- Vérifiez la pull request, exécutez les contrôles pertinents et vérifiez le résultat déployé selon le processus normal de livraison de l'équipe.
Cette séquence propose une évaluation. Elle ne remplace ni le guide actuel du produit ni les règles de déploiement de l'organisation. L'habitude utile est de garder distinctes les décisions d'accès aux sources, de vérification des preuves et d'approbation de livraison.
Le calcul des coûts doit suivre la même logique. Une équipe doit comprendre les tarifs actuels et le volume de travail à analyser. Elle doit aussi compter le temps consacré à accepter, rejeter ou corriger une proposition. Un patch généré qui économise du codage peut créer ailleurs du travail de vérification.
Une proposition de réparation et une réparation autonome sont deux étapes différentes
L'article détaillé de lancement indique que la remédiation commence par une correction proposée qu'une personne approuve. Il décrit l'application autonome élargie de certains correctifs comme une capacité future. D'autres formulations produit AWS parlent plus généralement d'application progressive. Pour décider d'un déploiement, le point de départ prudent et exploitable est le parcours documenté avec vérification humaine. Description détaillée du lancement ; annonce What's New.
La distinction n'est pas une simple nuance rédactionnelle. Préparer automatiquement un patch, ouvrir automatiquement une pull request et changer automatiquement un système en fonctionnement ont des conséquences différentes. Une démonstration d'une étape ne prouve pas que toutes les étapes ultérieures sont activées ou appropriées.
| Étape | Ce que l'équipe peut apprendre | Ce qu'il reste à établir |
|---|---|---|
| Problème détecté | Une faiblesse est soupçonnée | Si le code et la configuration concernés sont réellement utilisés |
| Preuves et contexte | Pourquoi un chemin pourrait être exploitable et important | Si les hypothèses correspondent à l'environnement actuel |
| Patch ou PR proposé | Une modification concrète peut être vérifiée | Si elle corrige le problème et préserve le comportement voulu |
| Modification fusionnée et déployée | Le système actif a reçu un changement approuvé | Si le chemin vulnérable est fermé sans nouvelle régression |
Cette séparation aide à adopter l'automatisation progressivement. Un service peut fournir des preuves utiles avant que l'équipe accepte régulièrement ses patchs. Il peut produire de bons patchs avant que l'organisation souhaite une quelconque livraison automatique.
Les prochaines preuves intéressantes concernent le traitement des opérations répétées dans des environnements réels. Une catégorie de réparation déjà acceptée reste-t-elle sûre après une évolution de l'application ? Un réviseur voit-il pourquoi deux problèmes apparemment semblables reçoivent des priorités différentes ? Le système détecte-t-il un contexte incomplet ?
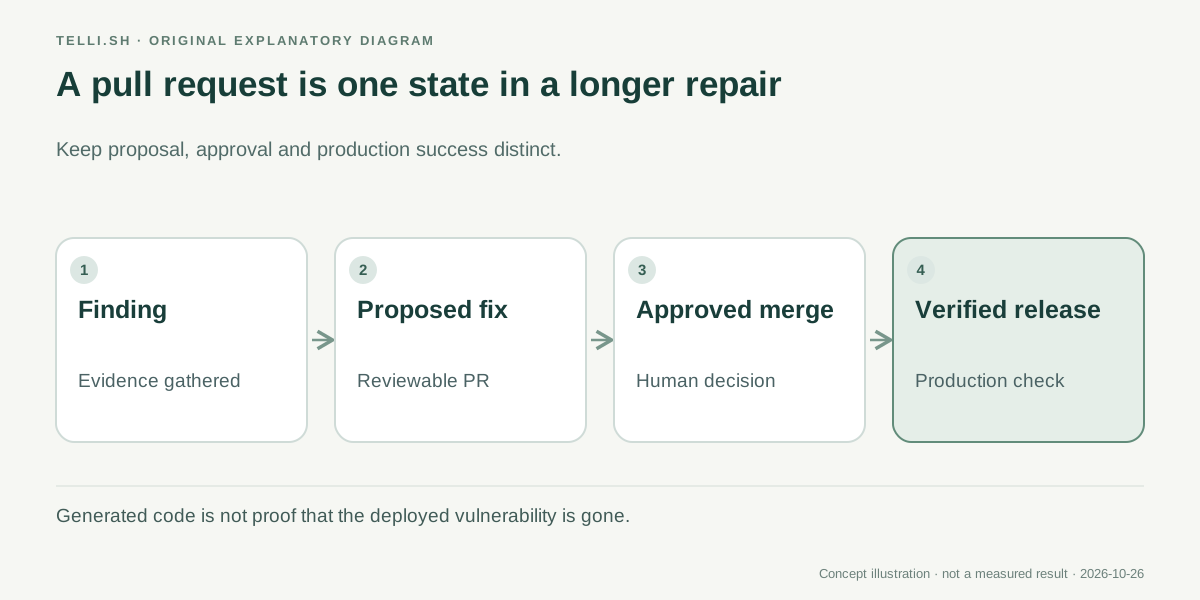 Une PR générée est un objet à vérifier. Une remédiation réussie en production est un état ultérieur qui demande ses propres preuves.
Le collecteur de contexte mérite autant d'attention que le modèle
Un meilleur contexte peut rendre le jugement de sécurité plus utile, mais la connexion qui le fournit entre dans les hypothèses de fonctionnement du système. Si le collecteur ne voit qu'une partie des ressources, le rapport peut ne décrire qu'une partie du chemin d'attaque. Si l'environnement a changé, un jugement antérieur peut devoir être réexaminé.
C'est pourquoi un pilote doit noter les sources connectées et la date de fraîcheur de leurs données. Le rapport se lit en fonction de ce périmètre. Il ne doit pas devenir une déclaration universelle de sécurité de l'application simplement parce qu'un ensemble de problèmes a été vérifié.
Le principe s'applique aussi à l'impact métier. Une base peut être techniquement accessible tout en ne contenant que des données de test de faible valeur, ou paraître périphérique tout en soutenant un parcours critique. Le responsable métier et l'équipe technique doivent partager le sens de cette ressource.
Une répartition du travail semble prometteuse. Le logiciel peut relier de nombreuses preuves techniques et produire une proposition concrète. Les personnes peuvent décider quel système compte, si les hypothèses sont justes et quel risque de livraison l'entreprise est prête à prendre.
Une évaluation efficace doit mesurer les fausses alertes comme les priorités manquées. Moins d'alertes peut impressionner même quand des problèmes importants disparaissent de la vue. L'objectif est une file qui conserve le bon travail et donne aux réviseurs de meilleures raisons d'agir.
L'outil de sécurité IA utile rend la prochaine décision plus facile à justifier
La sortie de Continuum est intéressante parce qu'elle relie la réparation assistée par IA au contexte qui permet de juger si elle mérite l'attention. C'est une ambition plus utile que produire une nouvelle pile de changements de code plausibles.
Avant d'accepter un correctif, demandez ce qui a changé dans votre compréhension du risque. Si la réponse contient un chemin accessible, des preuves examinables et une réparation limitée, l'outil a aidé sur la partie difficile. S'il ne fournit qu'un paragraphe assuré et une nouvelle PR, la file reste votre problème.
Sources
- AWS : disponibilité générale de Continuum pour les vulnérabilités du code, 22 octobre 2026.
- AWS What's New : Continuum GA, 22 octobre 2026.
- Guide utilisateur AWS Continuum, consulté le 26 octobre 2026.
Garder la vérification reliée à sa source
Telli.sh permet de conserver les sources autorisées et les notes derrière une décision technique. Créer un espace de notes.