Mil alertas de seguridad y una base de datos accesible: AWS Continuum cambia las prioridades
AWS Continuum for code vulnerabilities ya tiene disponibilidad general. Su promesa útil es aportar pruebas de explotabilidad e impacto empresarial antes de dedicar otro día a revisar correcciones generadas.
Un panel de seguridad muestra cientos de hallazgos. Uno está en una utilidad que nunca recibe tráfico externo. Otro se encuentra a pocos pasos del sistema que almacena los datos de pago de los clientes. Una etiqueta de gravedad no basta para decirle a un equipo pequeño qué debe arreglar primero.
El 22 de octubre de 2026, AWS anunció la disponibilidad general de Continuum for code vulnerabilities. El servicio conecta el análisis de código con el contexto del entorno, evalúa la explotabilidad y el impacto empresarial y propone correcciones para revisión. Su artículo detallado de lanzamiento sitúa a una persona antes de la decisión final de remediación. Anuncio de lanzamiento de AWS.
AWS es el proveedor de infraestructura en la nube de servicios como EC2 y S3. Ese contexto importa porque la urgencia de una debilidad de código depende de las redes, los recursos y los datos que la rodean. La propuesta interesante de Continuum es una cola de reparación mejor informada, además de otra forma de generar parches.
 Centros de datos de AWS en Oregón, agosto de 2023. Foto: Tedder / Wikimedia Commons, CC BY-SA 4.0. Redimensionada y convertida a WebP sin recortar. Esta fotografía externa de contexto no muestra la interfaz de Continuum; consulta el anuncio y las pantallas oficiales.

Una vulnerabilidad se convierte en incidente a través de una ruta
Un escáner puede identificar una función peligrosa o una dependencia con una debilidad conocida. Que un atacante pueda aprovecharla depende de otros hechos. ¿Se utiliza realmente la ruta vulnerable? ¿Puede alcanzarla una solicitud externa? ¿Qué permisos y datos quedarían disponibles si tuviera éxito?
Estas preguntas conectan la seguridad de la aplicación con su despliegue. Una herramienta solo de desarrollo y un servicio expuesto pueden compartir un componente vulnerable y representar riesgos muy distintos. A la inversa, un problema con una puntuación genérica menos alarmante puede exigir atención inmediata si conduce directamente a un sistema importante.
El lanzamiento de Continuum describe un grafo de contexto construido con código y, si se configura, información del entorno de AWS obtenida mediante un recopilador autorizado. Utiliza ese contexto para relacionar hallazgos con recursos y sistemas críticos para el negocio. Contexto y recopilador; descripción del servicio.
Nuestra lectura es que la priorización se convierte en la pregunta central del producto. Una corrección generada por IA solo es útil si el equipo entiende el problema lo suficiente para revisar el cambio y decidir cuándo publicarlo. Más resultados automáticos no ayudan si amplían una cola de revisión que ya es inmanejable.
La cola se parece a una sala de espera. Ordenar a todos por el volumen de su alarma sirve menos que entender qué situación es urgente, qué pruebas justifican ese juicio y qué cambiaría el tratamiento. Un servicio de seguridad gana confianza haciendo inspeccionable ese razonamiento.
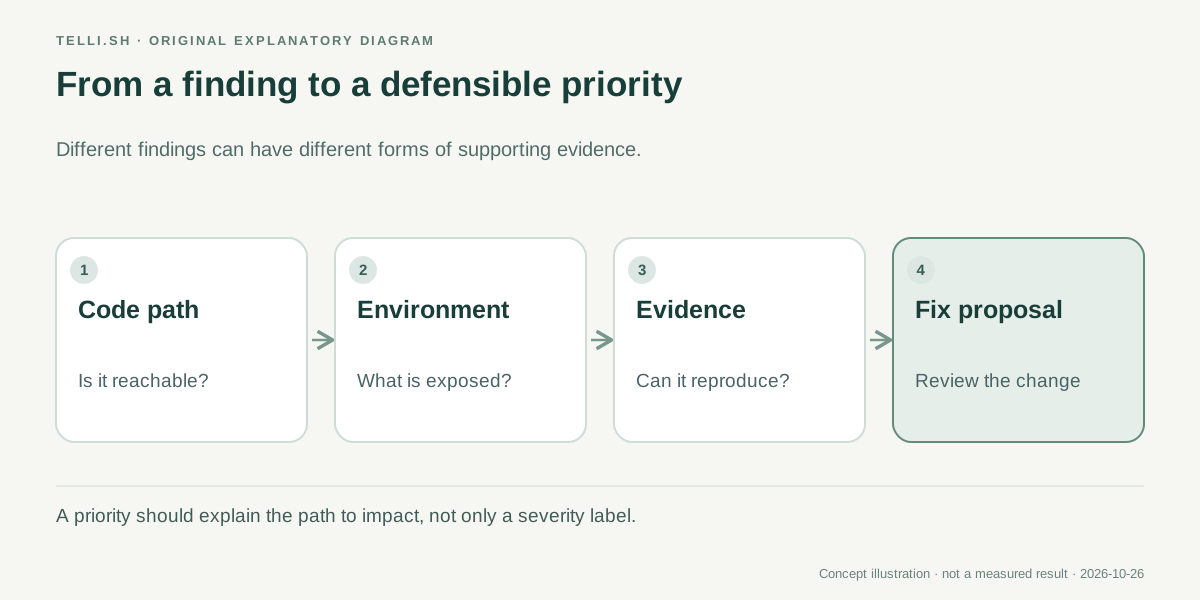 Explicación original de una revisión basada en pruebas. No todos los hallazgos tienen el mismo tipo de evidencia ni pueden reproducirse de la misma manera.
El nivel de evidencia importa más que una explicación segura de sí misma
AWS describe distintas formas de evidencia. Un hallazgo puede establecerse mediante análisis estático de una ruta de código. Para problemas que el servicio puede reproducir, puede utilizar un entorno aislado y adjuntar código de prueba de concepto y pasos de reproducción. La diferencia importa: una narración plausible sobre explotación no equivale a un ataque reproducido.
El recorrido del lanzamiento también distingue producir un parche de resolver una incidencia. Continuum puede abrir una pull request, pero el equipo debe revisarla e integrarla. Un cambio generado no significa por sí mismo que el servicio vulnerable esté reparado en producción. Recorrido del lanzamiento y revisión.
La evidencia debe permitir al revisor responder preguntas concretas. ¿Qué entrada llega a la operación vulnerable? ¿Qué supone la prueba sobre autenticación o permisos? ¿El cambio propuesto elimina esa ruta sin romper un uso legítimo?
Conviene separar estas preguntas de la calidad de redacción del informe. Una explicación clara puede acelerar la revisión, pero no es una validación independiente. El código, la configuración y las condiciones de reproducción siguen respaldando la afirmación técnica.
Incluye en un piloto ejemplos en los que la explotación debería fallar. Un servicio protegido por un control eficaz, una ruta de dependencia que no se usa y un problema ya mitigado con configuración ayudan a comprobar si la herramienta entiende el contexto o repite la gravedad del escáner original.
Un servicio de pagos y una herramienta de desarrollo exigen decisiones distintas
Consideremos una aplicación ilustrativa con un servicio público de pago y un generador privado de informes utilizado solo en desarrollo. Ambos contienen hallazgos que parecen graves por separado. El primero procesa solicitudes relacionadas con transacciones de clientes; el segundo no tiene una función prevista en producción.
Una revisión basada en pruebas establecería primero los hechos del despliegue. Comprobaría si la utilidad supuestamente privada es accesible, si el problema del pago atraviesa una frontera real de confianza y qué datos u operaciones quedan disponibles por cada ruta. La descripción de arquitectura del equipo debe contrastarse con la configuración desplegada.
Si se confirma la ruta del pago, la corrección sigue necesitando un cambio acotado. Un parche que bloquea una solicitud maliciosa, pero rechaza también pedidos válidos, desplaza el problema en lugar de resolverlo. Las comprobaciones de regresión deben cubrir el comportamiento legítimo que se quiere conservar.
Si la herramienta de desarrollo no está realmente en la aplicación desplegada, el equipo puede programar su reparación de otra manera. Eso no justifica ignorarla para siempre. Justifica distinguir la exposición inmediata del mantenimiento y conservar las pruebas que respaldan esa distinción.
El ejemplo sirve para plantear una evaluación, no comunica resultados de un cliente. Lo importante es un orden de reparación defendible con información actual. Una herramienta que coincide con todas las prioridades existentes aporta menos que una que explica una diferencia sorprendente, pero verificable.
El primer despliegue debería inspeccionar una aplicación, no autorizar todas las correcciones
El anuncio de disponibilidad general identifica como regiones iniciales US East, en el norte de Virginia, y US West, en Oregón. Describe conectar una fuente de código mediante GitHub o S3 y añadir opcionalmente contexto de AWS con un recopilador. Los requisitos de cuenta, región y acceso siguen formando parte de la configuración. Disponibilidad y requisitos de fuentes.
Para un equipo que valore una prueba, un buen comienzo es una aplicación cuya arquitectura y procesos importantes ya conozca. Así será más fácil detectar un hallazgo inesperado y una suposición ausente. También da a los revisores una referencia de lo que el servicio debería considerar crítico.
- Selecciona el repositorio o la fuente compatible e identifica el entorno de aplicación que representa realmente.
- Lee los requisitos vigentes, elige una región compatible y revisa el acceso necesario para conectar el código.
- Decide si añades un recopilador autorizado de AWS y qué contexto debe proporcionar.
- Compara los primeros hallazgos con problemas conocidos, mitigaciones conocidas y casos difíciles elegidos deliberadamente.
- Inspecciona las pruebas de una reparación propuesta, incluidas sus suposiciones y el posible efecto sobre usuarios legítimos.
- Revisa la pull request, ejecuta las comprobaciones pertinentes y verifica el resultado desplegado mediante el proceso normal de publicación del equipo.
Esta secuencia propone una evaluación. No sustituye a la guía actual del producto ni a las reglas de despliegue de la organización. Lo útil es mantener distinguibles el acceso a fuentes, la revisión de pruebas y la aprobación de publicación.
El cálculo del coste debe seguir la misma lógica. El equipo necesita conocer los precios actuales y cuánto trabajo pretende analizar. También debe contar el tiempo dedicado a aceptar, rechazar o corregir propuestas. Un parche que ahorra programación puede crear trabajo de revisión en otro lugar.
Una reparación propuesta y una reparación autónoma son hitos distintos
El artículo detallado de lanzamiento indica que la remediación empieza con una corrección propuesta que una persona aprueba. Describe la aplicación autónoma más amplia de determinadas correcciones como una capacidad futura. Otros textos de AWS hablan de aplicación progresiva en términos más generales. Para decidir un despliegue, el punto de partida prudente y accionable es el proceso documentado con revisión humana. Descripción detallada del lanzamiento; anuncio de novedades.
La diferencia va más allá de una precisión verbal. Preparar automáticamente un parche, abrir una pull request y modificar un sistema en ejecución tienen consecuencias distintas. Una demostración de una etapa no demuestra que todas las posteriores estén activadas o sean apropiadas.
| Etapa | Qué puede averiguar el equipo | Qué falta establecer |
|---|---|---|
| Hallazgo | Existe una posible debilidad | Si el código y la configuración relevantes se utilizan realmente |
| Pruebas y contexto | Por qué una ruta puede ser explotable e importante | Si las suposiciones coinciden con el entorno actual |
| Parche o PR propuestos | Hay un cambio concreto para revisar | Si corrige el problema y conserva el comportamiento previsto |
| Cambio integrado y desplegado | El sistema en ejecución recibió un cambio aprobado | Si se cerró la ruta vulnerable sin nuevas regresiones |
Esta separación permite adoptar la automatización gradualmente. Un servicio puede aportar evidencia valiosa antes de que el equipo esté preparado para aceptar sus parches con regularidad. Puede producir parches útiles antes de que la organización quiera publicaciones automáticas de ningún tipo.
La siguiente evidencia interesante es cómo gestiona operaciones repetidas en entornos reales. ¿Sigue siendo segura una clase de reparación antes aceptada cuando cambia la aplicación? ¿Puede un revisor ver por qué un hallazgo parecido recibe otra prioridad? ¿Detecta el sistema cuándo su contexto está incompleto?
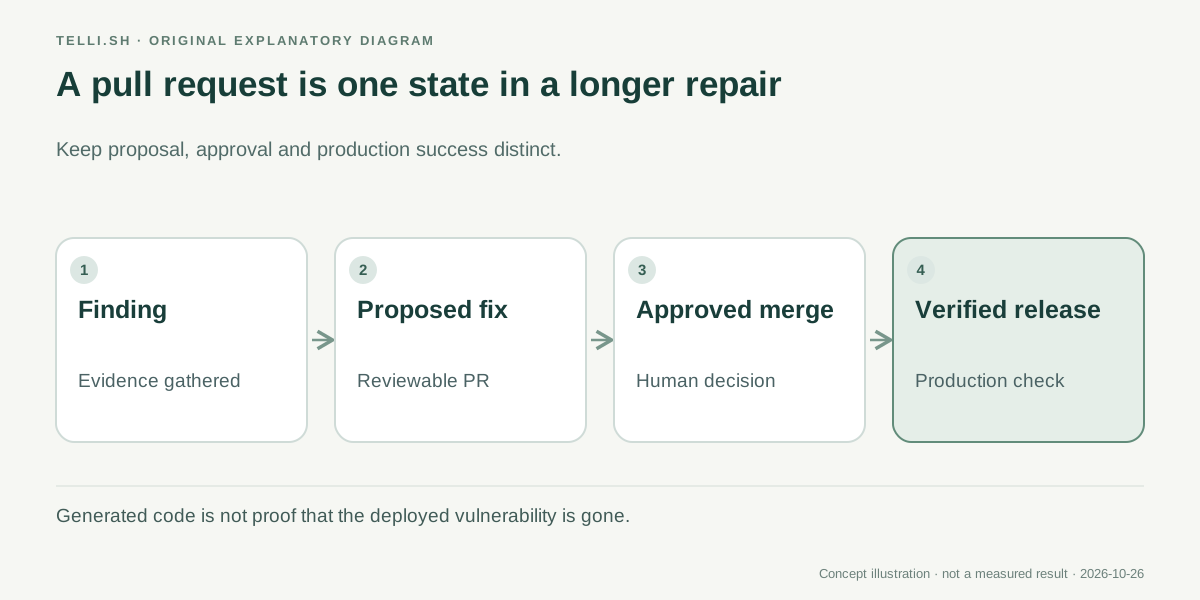 Una PR generada es un artefacto revisable. La reparación correcta en producción es un estado posterior con sus propias pruebas.
El recopilador de contexto merece el mismo examen que el modelo
Un contexto mejor hace más útil un juicio de seguridad, pero la conexión que lo aporta se convierte en parte de las suposiciones operativas del sistema. Si el recopilador solo ve algunos recursos, el informe puede describir solo una parte de la ruta de ataque. Si el entorno cambió, puede ser necesario revisar un juicio anterior.
Por eso el piloto debe registrar qué fuentes se conectaron y cuándo estaban actualizadas. El informe debe interpretarse dentro de ese alcance. Revisar un conjunto de hallazgos no debería convertirse en una declaración universal de que la aplicación es segura.
Lo mismo vale para el impacto empresarial. Una base de datos puede ser técnicamente accesible y contener datos de prueba de poco valor, o parecer secundaria y sostener un proceso crítico. El responsable del negocio y el equipo técnico necesitan comprender de forma compartida qué significa el recurso.
Aquí hay una división prometedora del trabajo. El software puede conectar grandes cantidades de evidencia técnica y producir una propuesta concreta. Las personas pueden decidir qué sistema importa, si las suposiciones son correctas y qué riesgo de publicación está dispuesto a asumir el negocio.
Una evaluación eficaz debe medir falsas alarmas y prioridades que se pasan por alto. Menos alertas puede parecer impresionante aunque desaparezcan problemas importantes. El objetivo es conservar el trabajo correcto en la cola y dar mejores razones para actuar.
Una herramienta de seguridad útil facilita justificar la siguiente decisión
Continuum resulta interesante porque conecta la reparación asistida por IA con el contexto que indica si merece atención. Es una aspiración más útil que producir otra pila de cambios plausibles de código.
Antes de aceptar una corrección, pregunta qué ha cambiado en tu comprensión del riesgo. Si la respuesta incluye una ruta accesible, pruebas inspeccionables y una reparación acotada, la herramienta ha ayudado con la parte difícil. Si solo aporta un párrafo convincente y una nueva PR, la cola sigue siendo responsabilidad tuya.
Fuentes
- AWS: disponibilidad general de Continuum for code vulnerabilities, 22 de octubre de 2026.
- AWS What's New: Continuum GA, 22 de octubre de 2026.
- Guía de usuario de AWS Continuum, consultada el 26 de octubre de 2026.
Mantén la revisión conectada con su fuente
Telli.sh es una opción para conservar fuentes autorizadas y las notas que respaldan una decisión técnica. Crea un espacio de notas.