A ocho horas de distancia, una decisión: el relevo asíncrono de 10 minutos
Un sistema práctico de relevo para equipos en los que una jornada termina cuando otra comienza. Descubre los seis campos que necesita quien toma el relevo, por qué importa confirmar la recepción, cómo escribir plazos inequívocos entre zonas horarias y cómo comprobar si el trabajo puede reanudarse en diez minutos sin una reunión de reconstrucción.
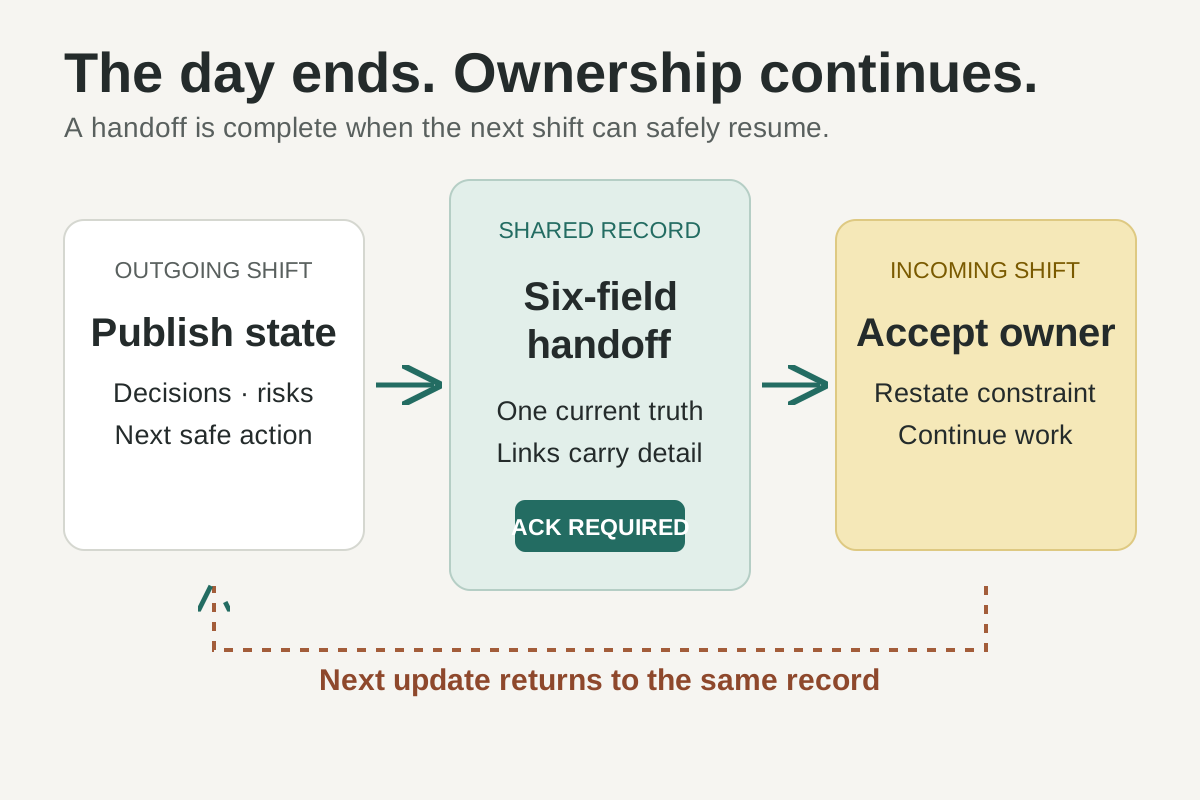
Un diagrama de flujo original. Un relevo solo termina cuando la siguiente persona puede identificar el estado, el próximo paso y su responsabilidad sin reproducir el turno anterior.
En Seúl, la jornada termina a las 18:00. En Londres aún queda la mayor parte del día. En San Francisco ni siquiera ha empezado el desayuno.
Esta disposición suele presentarse como una ventaja de 24 horas: el trabajo puede seguir avanzando mientras cada persona duerme. En la práctica, muchos equipos distribuidos consiguen un sistema más lento. Londres dedica su primera hora a reconstruir lo que cambió Seúl, San Francisco pide una aclaración cuando Seúl ya está desconectado y la siguiente reunión compartida repite una decisión que ya se había tomado.
El problema no son las zonas horarias. Es el relevo. Esta guía define un traspaso compacto que el compañero que empieza debería poder entender y aceptar en 10 minutos: estado actual, decisiones, evidencias, siguiente acción, riesgos y responsabilidad. Esos diez minutos son un objetivo de diagnóstico propuesto para esta guía, no un benchmark sectorial publicado. También explica cuándo el texto resulta insuficiente y una breve llamada durante el solapamiento es la opción más segura.
En resumen:
- Una actualización de estado describe actividad. Un relevo transfiere responsabilidad. El segundo necesita un receptor identificado y una confirmación explícita.
- Escribe seis campos en un orden fijo: estado, cambios, decisiones, siguiente acción, riesgos y responsable/hora. Sitúa al principio la verdad operativa más reciente.
- Nunca escribas «mañana», «Friday EOD» o un
09:00aislado entre zonas horarias. Para futuros eventos locales, incluye la fecha, la hora local y la zona IANA, como2026-10-02 09:00 Europe/London.
El modelo follow-the-sun falla en el relevo, no por el sol
Los investigadores dieron un nombre preciso al modelo antes de que el trabajo remoto se convirtiera en una condición laboral corriente. En 2009, Erran Carmel, Yael Dubinsky y J. Alberto Espinosa describieron el desarrollo follow-the-sun como un trabajo que se entrega cada día de un centro a otro situado a muchas zonas horarias de distancia, con el objetivo de reducir la duración de los proyectos. Su estudio exploratorio también observó que la práctica era poco habitual y a menudo se entendía mal. El registro de la publicación de IBM Research.
Su artículo de 2010 en el Journal of Management Information Systems expone con claridad el atractivo: el trabajo puede continuar sin interrupción. También identifica las condiciones que determinan si el modelo ayuda: eficiencia del calendario, eficiencia del relevo y coordinación dentro de cada centro y entre ellos. El resumen de la revista enumera 12 proposiciones de investigación en vez de prometer una aceleración universal.
Ese matiz importa. Tres jornadas de ocho horas no se convierten automáticamente en un día ininterrumpido de 24 horas. Cada transferencia introduce lo que llamaremos el coste de reanudación: el tiempo y los errores que aparecen cuando la persona entrante debe deducir el estado, redescubrir los motivos y localizar la siguiente acción segura.
Si el coste de reanudación es de 45 minutos en dos cambios diarios, el proceso nominal de 24 horas pierde 90 minutos antes de que comience cualquier trabajo nuevo. Y lo que es más importante, la falta de contexto puede enviar al siguiente turno en la dirección equivocada. Entregar rápido la tarea incorrecta no es continuidad.
Por tanto, el objetivo no es «más trabajo asíncrono». Es la capacidad de reanudación: ¿puede un compañero cualificado continuar el trabajo sin esperar al turno anterior y sin dar por cierta una suposición oculta?
Una actualización de estado no transfiere la responsabilidad
Muchos relevos fallidos comienzan con un mensaje que parece perfectamente razonable:
Buenos avances en el checkout. La API está casi terminada.
Hay un problema extraño con los reintentos. Lo volveré a mirar mañana.
El mensaje informa de la actividad, pero el turno entrante no puede actuar a partir de él. ¿Qué rama o entorno cambió? ¿Qué queda incompleto? ¿El problema de los reintentos se ha reproducido o solo se sospecha? ¿Debe investigarlo la siguiente persona, evitar esa zona o continuar con otra tarea? ¿Quién se responsabiliza del problema mientras duerme quien escribió el mensaje?
Un relevo tiene otra función gramatical. Transfiere un estado activo y nombra a la persona o el rol responsable del siguiente intervalo.
La guía publicada por Google SRE para gestionar incidentes hace explícito el cambio de responsabilidad. Recomienda mantener un documento vivo del incidente con la información más importante al principio y señala que el Incident Commander saliente debe comunicar claramente el relevo y permanecer hasta que la persona entrante lo confirme. Google SRE, «Managing Incidents». Un proyecto corriente no es un incidente de producción, pero la regla subyacente se traslada bien: la responsabilidad no cambia solo porque se haya enviado información.
La misma distinción aparece en un entorno de alto riesgo muy diferente. Un estudio prospectivo de intervención publicado en el New England Journal of Medicine el 6 de noviembre de 2014 evaluó un paquete estandarizado de relevos en nueve hospitales universitarios y 10.740 ingresos de pacientes. Los errores médicos bajaron de 24,5 a 18,8 por cada 100 ingresos, una reducción relativa del 23 %, y los acontecimientos adversos evitables descendieron de 4,7 a 3,3 por cada 100 ingresos, una reducción relativa del 30 %. La duración del relevo oral no cambió de forma significativa: 2,4 frente a 2,5 minutos por paciente. El estudio I-PASS.
No traslades esos porcentajes al software, el diseño o el marketing. El estudio trataba sobre relevos entre residentes de pediatría y un paquete que incluía formación, observación y trabajo de sostenibilidad, no solo una plantilla. La conclusión transferible es más limitada, pero sigue siendo valiosa: los elementos escritos y orales estandarizados, combinados con formación y confirmación, pueden mejorar la calidad del relevo sin alargar necesariamente cada traspaso.
Seis campos permiten reanudar el trabajo
Utiliza los mismos seis campos en el mismo orden para cada relevo operativo. El orden fijo importa porque el lector entrante no debería dedicar los primeros cinco minutos a descubrir cómo ha organizado el mensaje quien lo escribió hoy.
- Estado actual: la descripción exacta más breve de lo que es cierto en el momento del relevo.
- Cambios de este turno: trabajo completado, con enlaces al artefacto o la revisión.
- Decisiones tomadas: elecciones resueltas y sus motivos; con enlace al registro de decisión.
- Siguiente acción segura: un paso concreto que puede iniciar la persona entrante.
- Riesgos e incógnitas: fallos, suposiciones, rutas bloqueadas y lo que no debe cambiarse a la ligera.
- Responsable y hora: quién se hace cargo del siguiente intervalo, cuándo debe confirmar la recepción y cuándo será el próximo punto de control.
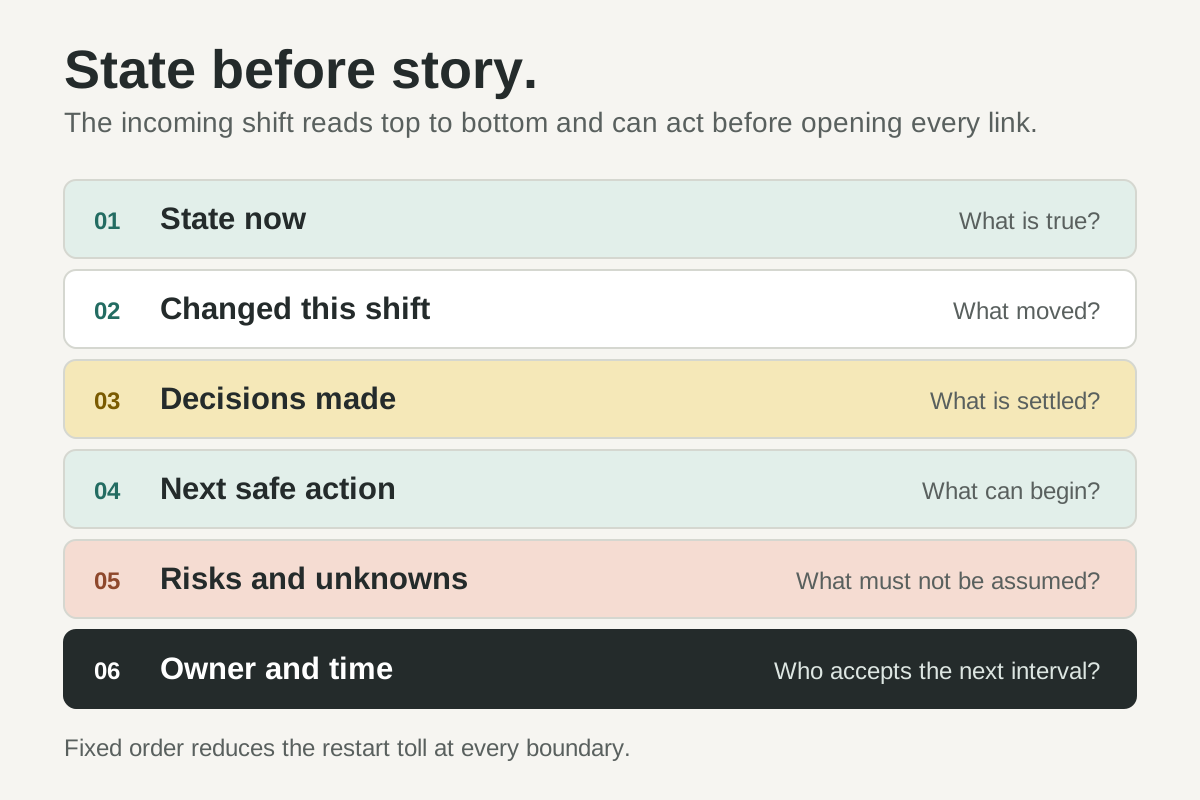
Figura 1: El lector entrante debe encontrar la verdad operativa antes que el relato. Los enlaces contienen los detalles; la ficha contiene el estado.
Así queda el mensaje anterior una vez reescrito:
RELEVO DE CHECKOUT · 2026-09-24T18:00+09:00 [Asia/Seoul]

ESTADO ACTUAL
El endpoint de reintentos está desplegado en staging tras el flag
`checkout_retry_v2`. Está desactivado para todas las cuentas de prueba.
El checkout principal no ha cambiado.

CAMBIOS DE ESTE TURNO
- Añadido el almacenamiento de claves de idempotencia: PR #1842, commit 7ac2e91.
- Añadidas 12 pruebas; pasan 11. El caso que falla está enlazado más abajo.

DECISIONES TOMADAS
- Mantener los reintentos en el servidor; no añadir un bucle en el cliente.
- Motivo: riesgo de cobro duplicado. Decisión D-77.

SIGUIENTE ACCIÓN SEGURA
Reproducir la prueba `retry_after_timeout` en staging con registro del ID de solicitud.
No activar el flag.

RIESGOS / INCÓGNITAS
- Se desconoce si la pasarela reutiliza el mismo ID de solicitud tras un timeout de 30 s.
- El cliente de prueba `acct_retry_04` puede contener intentos obsoletos.

RESPONSABLE / HORA
El equipo de guardia de Londres asume la investigación tras confirmar la recepción.
Confirma antes de 2026-09-24 10:00 Europe/London.
Siguiente punto de control: 2026-09-24T14:00Z en la issue #912.
El relevo reescrito tiene unas 100 palabras más y ahorra una hora de arqueología. La persona entrante sabe qué no debe hacer, qué prueba ejecutar, dónde cambió el código, por qué se eligió la arquitectura y cuándo comienza su responsabilidad.
El campo de la siguiente acción segura es la bisagra. Una instrucción amplia como «seguir investigando» deja la priorización en manos de quien tiene menos contexto. Una acción segura debe ser reversible o estar claramente acotada, y debe producir nuevas evidencias aunque no resuelva el problema.
Separa las decisiones resueltas de las preguntas abiertas
Los equipos repartidos entre zonas horarias suelen volver a decidir el trabajo porque sus relevos mezclan tres estados: decisiones aceptadas, propuestas pendientes de revisión y preguntas sin resolver. El lector de la mañana ve un párrafo pulido y da por hecho que la cuestión está cerrada. Quien lo escribió por la tarde se despierta y descubre que una sugerencia se ha convertido en implementación.
Utiliza términos de estado explícitos. Las cuatro etiquetas siguientes son un vocabulario local sugerido, no un estándar externo:
| Etiqueta | Significado | Qué puede hacer el turno entrante |
|---|---|---|
DECIDED | La persona o el grupo con autoridad eligió una opción | Ejecutarla dentro de los límites registrados |
PROPOSED | Hay una recomendación lista para revisar | Comprobar las suposiciones; no presentarla como norma |
OPEN | Aún faltan evidencias o autoridad | Recopilar evidencias o escalar la pregunta identificada |
SUPERSEDED | Un registro posterior sustituyó esta elección | Seguir el reemplazo enlazado |
Esto es más estricto que la prosa corriente porque el coste de la ambigüedad aumenta con el tiempo de respuesta. Un compañero en la misma sala puede preguntar: «¿De verdad decidimos eso?». Otro situado a ocho horas de distancia podría esperar una jornada entera para recibir la respuesta o avanzar sin ella.
Cada línea DECIDED debe incluir tres enlaces o campos: quién tenía autoridad, los motivos resumidos y el registro de decisión duradero. Cada línea OPEN debe identificar la información que falta y la persona que puede cerrar la cuestión. «Precio sin resolver» no basta. «OPEN: descuento anual; Mina aporta datos de abandono por duración del contrato antes del 2 de octubre» sí permite retomar el trabajo.
El manual público de comunicación de GitLab ofrece un ejemplo de esta preferencia por la documentación. En la versión consultada el 24 de septiembre de 2026, presenta la comunicación asíncrona como punto de partida, pide a los equipos que documenten las conclusiones de las conversaciones sin conexión, prefiere las issues y merge requests públicas a los mensajes privados y dirige las decisiones y los debates hacia una única fuente de verdad. GitLab Communication. Es el modelo operativo de una empresa, no una evidencia controlada de que todas deban copiar sus herramientas. El principio útil es que una conversación puede ocurrir en cualquier lugar, pero su conclusión necesita un hogar duradero.
«Friday EOD» no es una hora
El trabajo distribuido convierte el lenguaje temporal informal en defectos. «Mañana por la mañana» depende de quién lo lea. «Friday EOD» puede describir una ventana de más de 24 horas entre Auckland, Seúl, Londres y San Francisco. Incluso 09:00 PST es frágil: las abreviaturas se utilizan de manera incoherente y los cambios horarios estacionales afectan a unas regiones mientras otras permanecen fijas.
Para un evento ya completado, escribe una marca temporal inequívoca con su desplazamiento respecto a UTC:
2026-09-24T18:00:00+09:00
RFC 3339, publicado en julio de 2002, define un formato de fecha y hora para Internet que incluye un desplazamiento numérico y ofrece ejemplos como 1996-12-19T16:39:57-08:00, que representa el mismo instante que 1996-12-20T00:39:57Z. RFC 3339.
Para un evento futuro ligado a la hora civil local, incluye la fecha, la hora local y el nombre de la zona horaria de IANA:
2026-10-02 09:00 Europe/London
¿Por qué incluir el nombre? Un desplazamiento numérico identifica un instante, pero los horarios locales futuros dependen de reglas de zona horaria que los gobiernos pueden cambiar. La IANA Time Zone Database registra conjuntos de reglas basados en ubicaciones. Por ejemplo, America/Denver y America/Phoenix pueden compartir una descripción convencional de la hora de montaña y aplicar comportamientos distintos respecto al horario de verano. La teoría de zonas horarias de IANA. RFC 9557, publicado en abril de 2024, amplía las marcas temporales de Internet con información adicional, incluidos los nombres de zona IANA. RFC 9557.
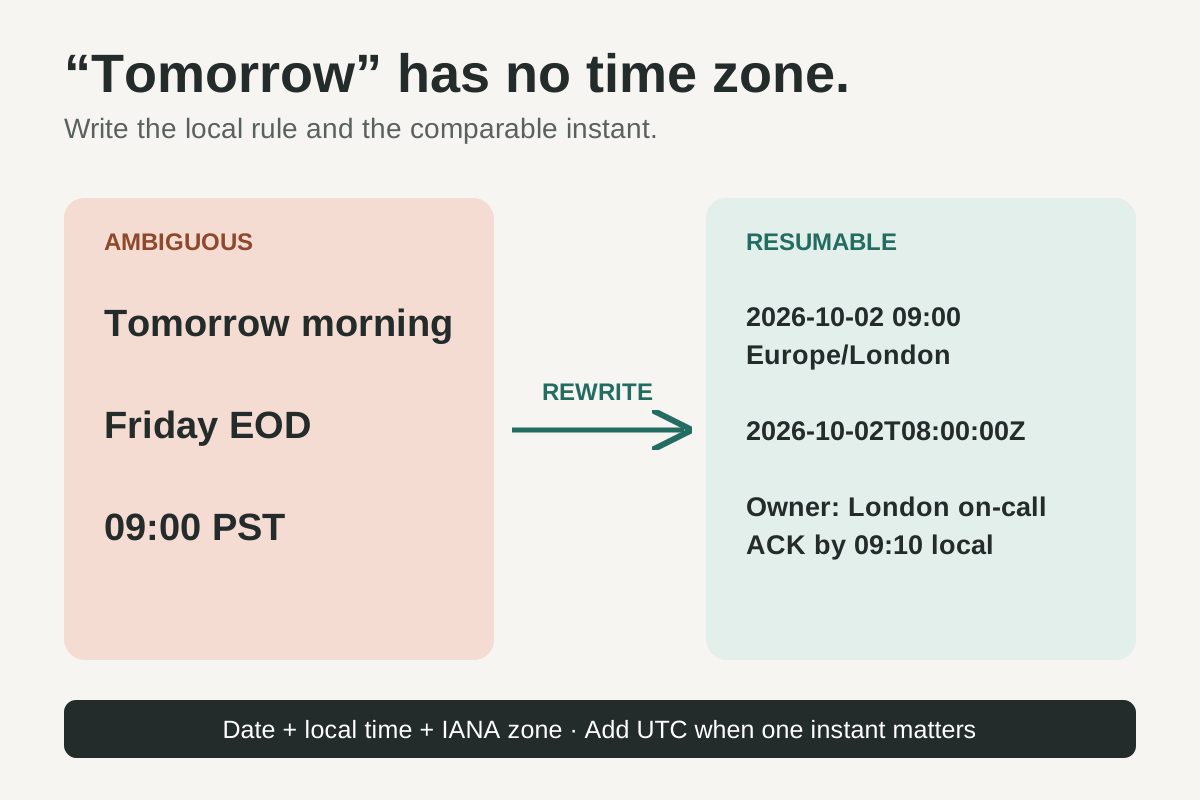
Figura 2: El receptor no debería tener que deducir de quién es el mañana, a qué viernes se refiere el mensaje ni si una abreviatura aplica el horario de verano.
En las notas destinadas a personas, muestra tanto la hora local del receptor como UTC cuando la coordinación sea sensible. El valor UTC permite comparar el instante. La zona identificada conserva la regla local prevista para la planificación del calendario. El software debe calcular uno a partir del otro; las personas no deberían hacer aritmética de desfases mentalmente.
La confirmación cierra el ciclo de responsabilidad
El envío se puede observar. La comprensión, no.
La persona entrante debe confirmar el relevo con una reformulación breve, no con un emoji de reacción:
ACK 2026-09-24 09:08 Europe/London
Me responsabilizo de investigar los reintentos del checkout hasta el punto de
control de las 14:00Z. Reproduciré `retry_after_timeout`; el feature flag seguirá
desactivado. La primera actualización irá a la issue #912.
Esto lleva menos de un minuto y comprueba cuatro cosas a la vez: el receptor vio el mensaje, entendió la siguiente acción, aceptó la responsabilidad y sabe dónde publicar el próximo estado. Un malentendido se hace visible mientras el turno saliente quizá siga disponible.
Fija una fecha límite para la confirmación. Si no llega, la responsabilidad no ha cambiado. La persona saliente debe utilizar la vía de escalado predefinida en vez de asumir que el silencio significa consentimiento. En el trabajo rutinario, puede bastar con una mención en el canal del equipo. En un incidente, un proceso regulado o un plazo de cliente, puede requerir una llamada en directo.
La confirmación no debe repetir toda la ficha. Su propósito es servir de suma de comprobación, no de segundo relevo. Repite el responsable, la acción inmediata, la restricción crítica y la ubicación de la próxima actualización.
Utiliza una breve llamada de solapamiento cuando el texto no pueda asumir el riesgo
El trabajo asíncrono no es una preferencia moral. Algunos estados son demasiado inestables o trascendentes para transferirlos solo con un documento.
Haz un relevo en directo cuando se cumpla al menos una de estas condiciones:
- El impacto activo en los clientes o la seguridad cambia más rápido de lo que puede actualizarse el documento.
- La siguiente acción es irreversible, destructiva o tiene consecuencias legales.
- La responsabilidad está en disputa o la persona entrante no puede reformular el plan con seguridad.
- El registro contiene evidencias contradictorias que la persona saliente no ha resuelto.
- El acceso, las credenciales o el estado del entorno no se pueden verificar a partir del registro compartido.
Mantén la llamada acotada. Abre la misma ficha de relevo, recórrela desde el estado hasta el riesgo, pide al nuevo responsable que reformule la siguiente acción y registra la confirmación en el documento. La llamada complementa el registro; no lo sustituye.
La guía de Google para incidentes sigue esa forma: documento de estado compartido, transferencia oral explícita, confirmación firme y comunicación al grupo general de quién dirige ahora. El artefacto duradero permite que los demás se orienten sin unirse a la llamada de relevo.
Comprueba si el trabajo se reanuda en 10 minutos
La métrica de calidad no es el número de actualizaciones publicadas ni las reuniones evitadas. Es el tiempo hasta la reanudación segura.
Una vez a la semana durante cuatro semanas, elige un relevo real y pide a la persona entrante que inicie un temporizador de 10 minutos antes de abrirlo. La frecuencia semanal y el periodo de cuatro semanas son heurísticas iniciales propuestas aquí; adáptalos al volumen y el riesgo de tu equipo. Al terminar, debe responder seis preguntas sin contactar con el autor:
- ¿Qué es cierto ahora?
- ¿Qué cambió durante el último turno?
- ¿Qué decisiones están cerradas y por qué?
- ¿Cuál es mi siguiente acción segura?
- ¿Qué debo evitar o escalar?
- ¿Dónde y cuándo publico el siguiente estado?
Puntúa cada respuesta como clear, found after searching o missing. No conviertas el resultado en una única cifra de satisfacción; repara el campo que falla de forma recurrente. Si el riesgo falta a menudo, colócalo más arriba. Si los motivos de una decisión exigen buscar en la transcripción, enlaza directamente con la sección correspondiente. Si la confirmación llega tarde con frecuencia, el rol receptor designado o el plazo son incorrectos.
Registra también las reuniones de reconstrucción. Una reunión de reconstrucción es una llamada programada principalmente para recuperar el estado o los motivos que deberían haber cruzado la frontera en el relevo. Etiquétala cuando ocurra. La cifra no demostrará causalidad, pero cada caso aporta una transferencia fallida concreta que se puede inspeccionar.
Tras la cuarta semana, realiza una prueba de ausencia: la persona que normalmente redacta el relevo no estará disponible durante un turno. Un sistema de relevo resistente debe seguir funcionando de forma razonable cuando quien posee más contexto se toma un día libre. Si el trabajo se detiene, el flujo todavía depende de la memoria, diga lo que diga la documentación.
La idea clave: el trabajo asíncrono es una cadena de responsabilidades aceptadas
Las zonas horarias no crean continuidad. Crean la oportunidad de tenerla.
La cadena real es humana y explícita: una persona publica el estado actual, otra reformula el siguiente paso, la responsabilidad cambia de manos y el registro compartido recibe la siguiente actualización. Si se elimina cualquiera de los eslabones, el equipo obtiene un hilo de chat con retraso, no un flujo de trabajo de 24 horas.
Diseña el relevo para el compañero que se despierta ocho horas después. Dale el estado antes que la historia, una decisión antes que el resumen de un debate, una hora exacta en vez de «mañana» y una acción segura que pueda iniciar. Después, pide una confirmación. Diez minutos disciplinados en el límite cuestan menos que una segunda reunión dedicada a reconstruir el día anterior.
Un lugar práctico para dejar el registro compartido: Telli.sh graba reuniones, conserva la transcripción y mantiene el resumen y las acciones en el mismo espacio de trabajo. Utiliza una nota duradera como punto de relevo para que el turno entrante pueda revisar lo que se dijo sin esperar a que se despierte el turno anterior.
Crea un espacio de trabajo en Telli.sh y graba el próximo relevo
Fuentes
- Carmel, Dubinsky y Espinosa, «Follow the sun software development: New perspectives, conceptual foundation, and exploratory field study», IBM Research / HICSS – 3 de abril de 2009; definición, beneficio previsto sobre la duración y contexto del estudio exploratorio.
- Carmel, Espinosa y Dubinsky, «Follow the Sun Workflow in Global Software Development», Journal of Management Information Systems – volumen 27, número 1, 2010, pp. 17-37; 12 proposiciones sobre eficiencia del calendario, eficiencia del relevo y coordinación.
- Starmer et al., «Changes in Medical Errors after Implementation of a Handoff Program», New England Journal of Medicine – 6 de noviembre de 2014; nueve hospitales, 10.740 ingresos y resultados comunicados sobre errores, acontecimientos adversos y duración del relevo. El artículo anterior no generaliza los tamaños del efecto médico al trabajo de conocimiento ordinario.
- Google, Site Reliability Engineering: Managing Incidents – consultado el 24 de septiembre de 2026; documento vivo del incidente, relevo explícito del mando y confirmación.
- GitLab Communication Handbook – consultado el 24 de septiembre de 2026; comunicación asíncrona como punto de partida, documentación de las conclusiones fuera de línea, canales de trabajo públicos y una única fuente de verdad. Es una práctica empresarial, no un estudio controlado.
- IETF RFC 3339, Date and Time on the Internet: Timestamps – julio de 2002; sintaxis inequívoca de fecha y hora en Internet y desplazamientos numéricos.
- IANA, Theory and pragmatics of the tz code and data – consultado el 24 de septiembre de 2026; reglas de zona horaria basadas en ubicaciones y ejemplos de regiones con distinto comportamiento de la hora civil.
- IETF RFC 9557, Date and Time on the Internet: Timestamps with Additional Information – abril de 2024; información adicional para las marcas temporales, incluidos los nombres de zona IANA.