Dwa mini-PC ze 128GB i drogie pytanie: czy warto dopłacić do RTX Spark?
ASUS ProArt GR1X trafił do sprzedaży, a niezależne testy RTX Spark pozwalają zapytać o coś więcej niż samą pamięć: jaki kompletny proces pracy uzasadnia dopłatę?
Dwa komputery mogą mieć na pudełku 128GB, a mimo to być zupełnie różnymi zakupami. Pojemność mówi, ile pamięci zainstalowano. Nie mówi, jak szybko odpowiada asystent, które narzędzia twórcze działają dobrze ani ile użytecznej pracy maszyna wykonuje za swoją cenę.
Ogłoszenie sprzedaży ASUS ProArt GR1X i nowe niezależne recenzje RTX Spark pokazują tę różnicę konkretnie. ASUS oferuje konfiguracje 64GB i 128GB. Tom's Guide podaje cenę początkową w USA $4,499 oraz $6,999 za testowany komputer 128GB, porównując go z mini-PC AMD również wyposażonym w 128GB.
Pytanie zakupowe brzmi: czy akceleracja RTX, responsywność i faktycznie używane oprogramowanie uzasadniają dopłatę? To lepsze pytanie niż to, czy komputer potrafi załadować duży model lokalny.
W skrócie: niezależne testy pokazują przewagę ASUS-a w konkretnych zadaniach lokalnych modeli, ale cena zakupu jest wysoka. Zanim wybierzesz wyłącznie na podstawie pamięci, porównaj swój model, narzędzia, czas całego zadania i koszty stałej pracy.
To dostępny komputer z Windows, ale warunki regionalne trzeba sprawdzić
Ogłoszenie NVIDIA z 18 listopada 2026 roku mówi o dostępności kompaktowych desktopów RTX Spark od ASUS, Dell i MSI oraz kolejnych dostawcach w przyszłości. Strona newsroomu ASUS ma datę 19 listopada, a tekst komunikatu jest datowany na 18 listopada. Praktyczna nowość to dostępność w sprzedaży, a nie kolejna zapowiedź przyszłej platformy.
ProArt to linia ASUS-a skierowana do twórców. W GR1X ta koncepcja łączy lokalne modele i agentów z aplikacjami kreatywnymi na kompaktowym desktopie Windows. NVIDIA wskazuje oprogramowanie Windows on Arm, procesy przyspieszane RTX, ComfyUI i aplikacje natywne jako elementy atrakcyjności platformy. Obsługę poszczególnych aplikacji i rozszerzeń nadal trzeba sprawdzić względem własnej pracy.
Wariantów ASUS-a 64GB i 128GB nie można zamieniać przy podawaniu ceny. Początkowe $4,499 w recenzji Tom's Guide nie jest ceną testowanego egzemplarza 128GB. Ten kosztował $6,999. Traktuj je jako amerykańskie punkty odniesienia z recenzji, a nie przeliczoną ofertę koreańską czy gwarancję, że sklep ma tę samą konfigurację na stanie.
Przed porównaniem ofert potwierdź pamięć, dysk, system operacyjny, gwarancję, zwroty i dokładny regionalny numer modelu. Ogłoszenie sprzedaży odpowiada, czy produkt wszedł na rynek. Lokalna faktura i zasady wsparcia mówią, co zakup oznacza dla ciebie.
Model 27B daje bardziej użyteczny test obietnicy pamięci
Tom's Guide porównał ProArt GR1X 128GB z Geekom A9 Mega 128GB opartym na AMD Ryzen AI Max 395. Recenzent użył LM Studio i Qwen 3.8 27B w dwóch zadaniach generatywnych i zadaniu programistycznym z agentem. Ta sama recenzja opisuje komputer AMD jako o około $3,000 tańszy w tym porównaniu.
Opublikowane wyniki rozdzielają tempo generowania od czasu reakcji. Ten drugi to opóźnienie przed początkiem odpowiedzi; pierwszy to szybkość napływania wyniku później. Żadna kolumna osobno nie mówi, czy zadanie programistyczne zakończyło się poprawną zmianą.
| Zadanie Tom's Guide, LM Studio z Qwen 3.8 27B | Generowanie ProArt GR1X | Generowanie A9 Mega | Reakcja ProArt GR1X | Reakcja A9 Mega |
|---|---|---|---|---|
| Tekst o Apollo 17 | 25.63 tokena/s | 20.76 tokena/s | 0.32 s | 1.10 s |
| Podsumowanie Waterloo | 31.11 tokena/s | 24.30 tokena/s | 0.98 s | 2.41 s |
| Programowanie z agentem | 30.03 tokena/s | 23.77 tokena/s | 0.55 s | 1.26 s |
Źródło: niezależna recenzja Tom's Guide. To wyniki modelu, środowiska i zadań z recenzji, a nie nasze pomiary ani uniwersalny ranking wszystkich lokalnych obciążeń.
Dla wiersza programistycznego 30.03 podzielone przez 23.77 daje około 1.26: mniej więcej 26% więcej wygenerowanych tokenów na sekundę w tym teście. Obliczenie nie oznacza, że projekt oprogramowania kończy się o 26% szybciej. Agent może czekać na narzędzia, uruchamiać testy, popełniać błędy lub potrzebować kolejnego przeglądu. Nie określa też wydajności znacznie większego checkpointu tylko dlatego, że oba systemy mają dość pamięci, by go załadować.
Różnicę czasu reakcji warto rozważyć osobno. Jeśli ktoś zadaje wiele krótkich pytań, krótsze oczekiwanie na każdą odpowiedź może wpływać na doświadczenie mocniej, niż sugeruje przepustowość. Jeśli komputer wykonuje długą partię bez nadzoru, ważniejsze mogą być całkowity czas i niezawodność.
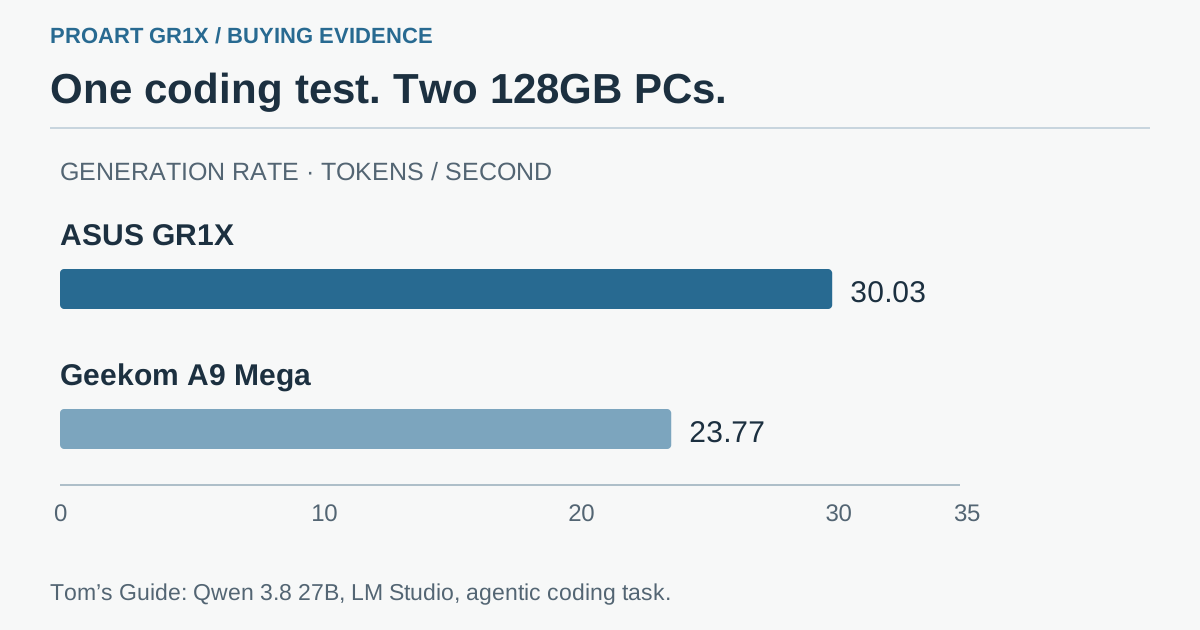 Autorskie ramy zakupu: taka sama pojemność pamięci nie oznacza równej responsywności, wsparcia oprogramowania ani całkowitego kosztu. Wynik recenzji dotyczy podanych zadań Qwen i LM Studio.
Dodatkowe pieniądze potrzebują konkretnego zadania
Rozważmy przykładowe gospodarstwo domowe lub małe studio szukające stałego lokalnego asystenta. Streszcza dokumenty, odpowiada na okazjonalne pytania i realizuje zaplanowane zadanie w nocy. Istotnym porównaniem nie jest szczytowa specyfikacja akceleratora. Chodzi o to, czy tańszy komputer obsługuje to samo akceptowalne obciążenie z tolerowanym oczekiwaniem i wystarczającą niezawodnością.
Drugi nabywca może w dzień używać lokalnego modelu, a po pracy generować materiały wizualne w ComfyUI. Dla niego zgodność z określonym procesem RTX/CUDA może być cenniejsza niż niewielka różnica przepustowości zwykłego czatu. Użytecznym dowodem byłby ukończony proces z docelowymi węzłami, modelami i rozszerzeniami, a nie sam fakt otwarcia aplikacji.
Trzeci scenariusz to mały zespół programistyczny używający dedykowanej maszyny, gdy laptopy są w podróży. Oddzielenie hosta agenta od codziennego laptopa może pomóc utrzymać zaplanowaną pracę. Poświadczenia repozytorium, zarządzanie aktualizacjami, kopie zapasowe i dostęp zdalny pozostają jednak zadaniami operacyjnymi. Urządzenie reklamowane dla agentów pracujących stale nie zapewnia samo bezpiecznego projektu uprawnień.
To scenariusze zakupowe, a nie testowane przez nas wdrożenia. Ich celem jest przypisanie dopłacie konkretnej pracy. Jeśli proponowaną korzyścią jest tylko „więcej AI”, trudno ocenić, czy wydatek cokolwiek poprawił.
Oprogramowanie RTX może być ważniejsze niż taka sama liczba przy pamięci
Ogłoszenie sprzedaży NVIDIA podkreśla lokalne generowanie, aplikacje twórcze i narzędzia deweloperskie obok pojemności pamięci. To rozsądny kierunek oceny komputera do mieszanych obciążeń. Endpoint modelu, graf generowania obrazów i aplikacja edycyjna mogą ujawniać różne mocne strony i ograniczenia.
Windows on Arm to pytanie o zgodność, nie tylko etykieta systemu. Sprawdź dokładne aplikacje, wtyczki, sterowniki i pakiety wiersza poleceń, których potrzebujesz. Aplikacja natywna może działać, podczas gdy starsze rozszerzenie, narzędzie urządzenia lub skompilowana zależność blokuje projekt. Aplikacja emulowana nie jest automatycznie bezużyteczna, ale zasługuje na osobną kontrolę funkcji i wydajności.
Podobnie wsparcie CUDA powinno prowadzić do konkretnego pytania: czy potrzebna wersja pakietu lub procesu obsługuje tę platformę i konfigurację? Nie zakładaj, że każdy poradnik dla desktopowej NVIDIA zadziała bez zmian. Formaty modeli, obsługiwane operacje i sposób pakowania oprogramowania mogą być równie istotne jak nazwa akceleratora.
Osobna recenzja ProArt GR1X w Windows Central dostarcza kolejnej niezależnej oceny do zestawienia z Tom's Guide. Czytaj konfigurację testów i wnioski każdej publikacji, zamiast łączyć różne pomiary w jeden wymyślony wynik. Dwie niezależne recenzje są przydatne, bo pokazują różne priorytety nabywców; nie eliminują potrzeby sprawdzenia własnej kluczowej aplikacji.
„Lokalnie” zmienia rachunek, ale go nie usuwa
Obsługiwana inferencja lokalna może uniknąć opłaty zdalnego API za tokeny tej inferencji. Przenosi też większą część kosztów na urządzenie, energię, dyski i czas obsługi. Narzędzia agenta łączące się z internetem lub usługi zewnętrzne nadal mogą mieć własne opłaty.
Dla stale włączonej maszyny zmierz pobór z gniazdka co najmniej w trzech stanach: bezczynność, reprezentatywne zadanie modelu i najintensywniejsze zwykłe obciążenie mieszane. Specyfikacja mocy komponentu nie jest pomiarem poboru z gniazdka, a krótki szczyt nie jest miesięcznym rachunkiem.
Gdy masz zmierzoną różnicę, rachunek jest prosty. Dodatkowe 10 watów średnio przez cały rok daje 87.6 kWh: 0.010 kW pomnożone przez 24 godziny i 365 dni. To przykład obliczenia, a nie twierdzenie, że te PC różnią się o 10 watów. Przemnóż zmierzoną energię przez własną taryfę, uwzględniając godziny pracy.
Cena zakupu zwykle zasługuje na równie jawne potraktowanie. Rozłóż koszt urządzenia na przewidywany okres użytkowania, uwzględnij rzeczywiście potrzebne dyski i backup, a następnie porównaj liczbę ukończonych użytecznych zadań. Jeśli tańsza maszyna już spełnia wymagania, szybsze droższe urządzenie potrzebuje korzyści uzasadniającej różnicę. Jeśli zgodny proces oszczędza znaczący, powtarzalny wysiłek, może to być lepszy argument niż izolowany benchmark czatu.
Unikaj też przeciwnej pułapki: najtańszego zakupu, po którym spędzisz tygodnie na wymianie nieobsługiwanego oprogramowania. Czas przebudowy narzędzi jest częścią zakupu, nawet gdy nigdy nie pojawia się na fakturze.
Wykorzystaj okres zwrotu
Użyteczny test zakupowy jest na tyle mały, by skończyć go, zanim decyzja przestanie być odwracalna. Przygotuj go przed zamówieniem, aby pierwszy tydzień poświęcić ocenie procesu, a nie zbieraniu składników.
- Wybierz trzy zadania odpowiadające przeznaczeniu maszyny. Na przykład lokalne zadanie programistyczne z istniejącymi testami, odpowiedź na długi dokument o znanych faktach i konkretny graf generowania obrazu. Zachowaj te same prompty i materiały źródłowe na porównywanych systemach.
- Zapisz dokładną konfigurację. Uwzględnij checkpoint modelu, kwantyzację, długość kontekstu, wersję środowiska wykonawczego, sterownik, wersje aplikacji i tryb zasilania. Równe liczby parametrów nie wystarczą do miarodajnego porównania.
- Oddziel zimne i rozgrzane działanie. Zmierz pierwsze załadowanie modelu i kolejne zapytanie. Nie porównuj przebiegu z bufora na jednej maszynie z pierwszym uruchomieniem na drugiej.
- Oceń gotowy rezultat. Sprawdź, czy kod przechodzi właściwe testy, odpowiedź dokumentowa zachowuje wymagane fakty, a proces twórczy daje oczekiwany plik ze wszystkimi niezbędnymi węzłami.
- Dodaj zwykłą pracę w tle. Pozostaw uruchomione aplikacje, których zamierzasz używać. Obserwuj presję na pamięć, responsywność, wentylatory i nieudane zapytania podczas reprezentatywnej sesji.
- Zmierz całą sesję. Zapisz łączny czas, pobór z gniazdka, jeśli masz właściwy miernik, niepowodzenia i ręczne interwencje. Podejmij decyzję według kryteriów zapisanych przed zobaczeniem najszybszego wyniku.
Wolniejsza odpowiedź, która niezawodnie tworzy poprawny rezultat, może być lepszym zakupem niż szybka wymagająca ciągłych poprawek. Odwrotność też jest możliwa, gdy wąskim gardłem jest zgodność lub przepustowość. Test powinien wskazać, do której sytuacji kupujesz sprzęt.
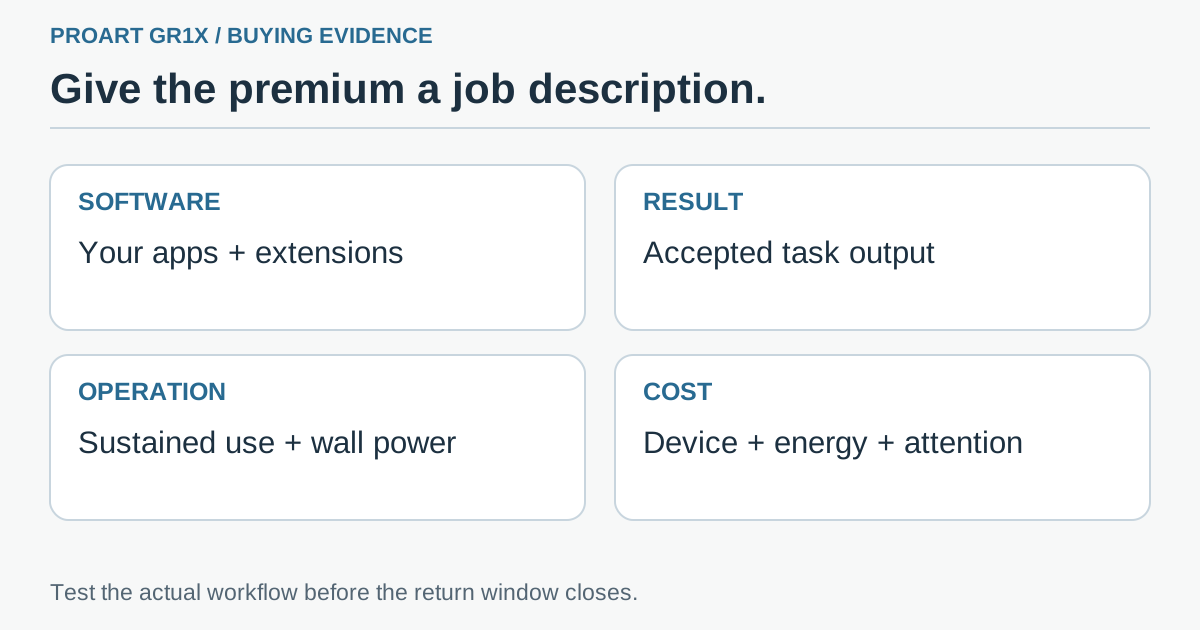 Autorska lista oceny: przed końcem okresu zwrotu sprawdź obsługę aplikacji, akceptowalny rezultat, ciągłość działania i pełny koszt zamierzonego obciążenia.
Kupuj proces pracy, nie naklejkę 128GB
Nowe ogłoszenia sprzedaży czynią RTX Spark konkretną opcją desktopową, a niezależne recenzje dodają dowody poza szczytowymi liczbami producenta. W przypadku ProArt GR1X opublikowane porównanie Qwen 3.8 27B pokazuje szybsze generowanie i krótsze oczekiwanie na początku badanych zadań. Testowana konfiguracja 128GB ma przy tym wysoką cenę w USA.
Nasza rada zakupowa to zacząć od wąskiego gardła, które potrafisz nazwać. Jeśli potrzebujesz konkretnego procesu twórczego przyspieszanego RTX, sprawdź właśnie ten proces. Jeśli potrzebujesz responsywnego ogólnego asystenta, porównaj interakcję i akceptowalne odpowiedzi z tańszymi alternatywami. Jeśli komputer ma działać bez nadzoru, uwzględnij długotrwałą niezawodność i energię.
Pamięć to rozmiar stołu roboczego, nie wartość wychodzącej z niego pracy. Dopłata staje się uzasadniona, gdy zasługują na nią ważne dla ciebie zadania, a nie tylko arkusz specyfikacji.
Źródła i oficjalne materiały
- Ogłoszenie dostępności ASUS ProArt GR1X: strona 19 listopada; tekst komunikatu 18 listopada 2026 roku.
- Ogłoszenie sprzedaży desktopów NVIDIA RTX Spark, 18 listopada 2026 roku.
- Tom's Guide: ceny w USA i porównanie Qwen 3.8 27B / LM Studio.
- Windows Central: osobna recenzja ProArt GR1X.
- Oficjalne zdjęcie produktu ASUS. Zdjęcia i wykresy recenzji pozostają u oryginalnych wydawców; dołączone grafiki zakupowe są autorskie.

Tabela benchmarku odtwarza przypisane źródłu fakty liczbowe, a nie wykres wydawcy. Testy zakupowe i przykład energii to proponowana analiza, a nie pomiary tych egzemplarzy recenzenckich.
Rekomendacja Telli.sh: Przechowuj oferty, dokładne konfiguracje i zaakceptowane wyniki zadań razem, aby kolejna decyzja sprzętowa zaczynała się od dowodów, które można wykorzystać ponownie. Utwórz pierwszą notatkę w Telli.sh.