Due mini PC da 128GB, una domanda costosa: RTX Spark vale il sovrapprezzo?
ASUS ProArt GR1X è in vendita e i test indipendenti di RTX Spark suggeriscono una domanda migliore della sola capacità di memoria: quale flusso di lavoro completo giustifica la spesa aggiuntiva?
Due computer possono riportare entrambi 128GB sulla confezione ed essere comunque acquisti molto diversi. La capacità dice quanta memoria è presente. Non dice quanto rapidamente risponde un assistente, quali strumenti creativi funzionano bene o quanto lavoro utile produce la macchina rispetto al suo prezzo.
L'annuncio di vendita di ASUS ProArt GR1X e le nuove recensioni indipendenti di RTX Spark rendono concreta questa distinzione. ASUS offre configurazioni da 64GB e 128GB. Tom's Guide riporta un prezzo iniziale negli Stati Uniti di $4,499 e di $6,999 per la macchina da 128GB provata, confrontandola poi con un mini PC AMD da 128GB.
La domanda da farsi è se l'accelerazione RTX, la reattività e il software che usi davvero giustifichino il sovrapprezzo. È una domanda più utile del semplice chiedersi se la macchina riesca a caricare un modello locale di grandi dimensioni.
In breve: i test indipendenti mostrano un vantaggio della macchina ASUS in specifici compiti con modelli locali, a fronte di un prezzo d'acquisto elevato. Confronta modello, strumenti, durata complessiva dei compiti e costi di funzionamento continuo prima di scegliere soltanto in base alla memoria.
È un PC Windows già in commercio, con dettagli regionali da verificare
L'annuncio NVIDIA del 18 novembre 2026 afferma che i desktop compatti RTX Spark di ASUS, Dell e MSI sono disponibili, con altri produttori in arrivo. La pagina della sala stampa ASUS riporta il 19 novembre, mentre il testo dell'annuncio è datato 18 novembre. La novità concreta è la disponibilità commerciale, non un'altra anteprima di una piattaforma futura.
ProArt è la linea di prodotti ASUS rivolta ai creativi. Nel GR1X, questo posizionamento collega modelli e agenti locali alle applicazioni creative su un desktop Windows compatto. NVIDIA cita il software Windows on Arm, i flussi accelerati RTX, ComfyUI e le applicazioni native tra i punti d'interesse della piattaforma. Il supporto di ogni applicazione ed estensione va comunque verificato rispetto al proprio lavoro.
Le opzioni ASUS da 64GB e 128GB non sono intercambiabili quando si cita un prezzo. I $4,499 iniziali della recensione di Tom's Guide non sono il prezzo dell'unità da 128GB recensita. Quella costava $6,999. Considerali riferimenti di prezzo statunitensi della recensione, non un preventivo coreano convertito né una garanzia che un rivenditore abbia la stessa configurazione disponibile.
Prima di confrontare le offerte, verifica memoria, archiviazione, sistema operativo, garanzia, resi e codice esatto del modello regionale. Un annuncio commerciale documentato chiarisce se un prodotto è arrivato sul mercato. Una fattura locale e una politica di assistenza chiariscono cosa significhi acquistarlo per te.
Un modello 27B offre un test più utile alla promessa della memoria
Tom's Guide ha confrontato ProArt GR1X da 128GB con Geekom A9 Mega da 128GB, basato su AMD Ryzen AI Max 395. Il recensore ha usato LM Studio e Qwen 3.8 27B per due compiti generativi e uno di programmazione con un agente. La stessa recensione descrive la macchina AMD come circa $3,000 meno costosa nel confronto.
I risultati pubblicati distinguono la velocità di generazione dal tempo di reazione. Quest'ultimo è l'attesa prima che inizi la risposta; la prima è il ritmo con cui arriva il testo dopo quel momento. Nessuna delle due colonne, da sola, descrive se il compito di programmazione abbia prodotto una modifica corretta.
| Compito di Tom's Guide, LM Studio con Qwen 3.8 27B | Generazione ProArt GR1X | Generazione A9 Mega | Reazione ProArt GR1X | Reazione A9 Mega |
|---|---|---|---|---|
| Testo su Apollo 17 | 25.63 token/s | 20.76 token/s | 0.32 s | 1.10 s |
| Riassunto di Waterloo | 31.11 token/s | 24.30 token/s | 0.98 s | 2.41 s |
| Programmazione con agente | 30.03 token/s | 23.77 token/s | 0.55 s | 1.26 s |
Fonte: recensione indipendente di Tom's Guide. Sono risultati relativi al modello, al runtime e ai compiti della recensione, non misurazioni nostre né una classifica universale di tutti i carichi locali.
Nella riga della programmazione, 30.03 diviso 23.77 fa circa 1.26: approssimativamente il 26% di token generati in più al secondo in quel test. Questo calcolo non significa che un progetto software finisca il 26% prima. L'agente può aspettare strumenti, eseguire test, sbagliare o richiedere un altro ciclo di revisione. Inoltre, il risultato non dimostra le prestazioni di un checkpoint molto più grande soltanto perché entrambi i sistemi hanno memoria sufficiente per caricarlo.
La differenza nei tempi di reazione merita una valutazione separata. Se una persona pone molte domande brevi, un'attesa inferiore prima di ogni risposta può influenzare l'esperienza più di quanto suggerisca il dato di throughput. Se la macchina esegue un lungo batch senza supervisione, durata totale e affidabilità possono contare di più.
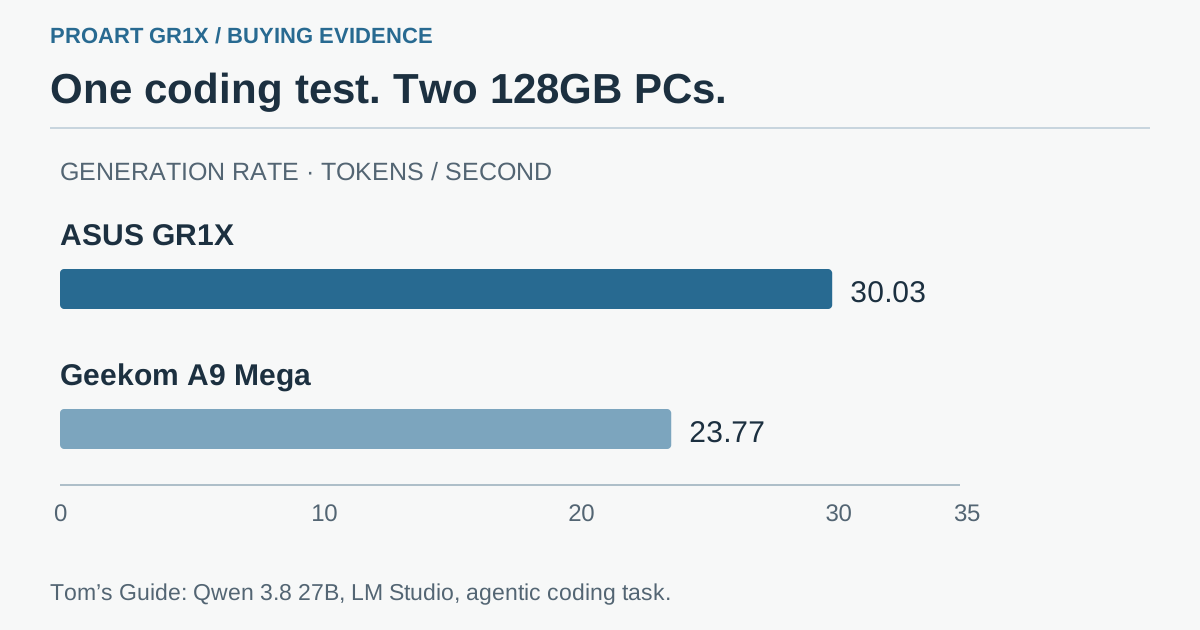 Schema d'acquisto originale: la stessa capacità di memoria non garantisce uguale reattività, supporto software o costo totale. Il risultato della recensione riguarda i compiti Qwen e LM Studio dichiarati.
Il denaro in più deve avere un compito preciso
Immagina una famiglia o un piccolo studio che desideri un assistente locale permanente. Riassume documenti, risponde a domande occasionali ed esegue un'attività pianificata durante la notte. Il confronto rilevante non riguarda la specifica di picco dell'acceleratore, ma se la macchina meno costosa gestisca lo stesso carico accettato con attese tollerabili e affidabilità sufficiente.
Un secondo acquirente potrebbe usare un modello locale di giorno e generare risorse visive in ComfyUI dopo il lavoro. Per lui, la compatibilità con uno specifico flusso RTX/CUDA potrebbe valere più di una modesta differenza nel throughput della chat generica. La prova utile sarebbe un flusso completato con i nodi, i modelli e le estensioni previsti, non il semplice fatto che l'applicazione si apra.
Un terzo scenario è un piccolo gruppo di sviluppo che usa una macchina dedicata mentre i portatili viaggiano. Separare l'host dell'agente dal portatile quotidiano può aiutare il lavoro pianificato a proseguire. Credenziali dei repository, gestione degli aggiornamenti, backup e accesso remoto restano però attività operative. Un dispositivo pubblicizzato per agenti sempre attivi non fornisce da solo una progettazione sicura dei permessi.
Sono scenari d'acquisto, non installazioni che abbiamo provato. Servono ad assegnare al sovrapprezzo un compito preciso. Se il beneficio proposto è soltanto «più IA», diventa difficile capire se la spesa abbia migliorato qualcosa.
Il software RTX può contare più di un numero di memoria uguale
L'annuncio commerciale NVIDIA sottolinea generazione locale, applicazioni creative e strumenti di sviluppo insieme alla memoria. È una direzione ragionevole per valutare una macchina destinata a carichi misti. Un endpoint di modello, un grafo di generazione immagini e un'applicazione di montaggio possono far emergere punti di forza e limiti diversi.
Windows on Arm è una questione di compatibilità oltre che un'etichetta del sistema operativo. Verifica le applicazioni, i plug-in, i driver e i pacchetti da riga di comando esatti che ti servono. Un'applicazione nativa può funzionare mentre una vecchia estensione, un'utilità per dispositivi o una dipendenza compilata blocca il progetto. Un'applicazione emulata non è automaticamente inutilizzabile, ma richiede una verifica funzionale e prestazionale propria.
Allo stesso modo, il supporto CUDA deve portare a una domanda precisa: la versione del pacchetto o del flusso che ti serve supporta questa piattaforma e configurazione? Non dedurre che ogni tutorial NVIDIA per desktop funzioni senza modifiche. Formati dei modelli, operazioni supportate e distribuzione del software possono contare quanto il nome dell'acceleratore.
La recensione separata di ProArt GR1X di Windows Central offre un'altra valutazione indipendente da confrontare con Tom's Guide. Leggi configurazione dei test e conclusioni di ogni pubblicazione, anziché combinare misure diverse in un unico punteggio inventato. Due recensioni indipendenti sono utili perché possono evidenziare priorità d'acquisto differenti; non eliminano la necessità di provare la propria applicazione essenziale.
«Locale» cambia il conto; non lo cancella
Eseguire localmente l'inferenza supportata può evitare la tariffa per token di un'API remota per quell'inferenza. Sposta anche una parte maggiore dei costi su dispositivo, elettricità, archiviazione e tempo di gestione. Gli strumenti dell'agente collegati a internet e i servizi esterni possono continuare ad avere costi propri.
Per una macchina sempre accesa, misura il consumo alla presa in almeno tre condizioni: inattività, un compito rappresentativo del modello e il normale carico misto più impegnativo. La specifica di potenza di un componente non è una misura alla presa, e un breve picco non è una bolletta mensile.
Il calcolo è semplice una volta misurata la differenza. Dieci watt aggiuntivi medi per un intero anno equivalgono a 87.6 kWh: 0.010 kW moltiplicati per 24 ore e 365 giorni. È un esempio di calcolo, non l'affermazione che questi PC differiscano di 10 watt. Moltiplica l'energia misurata per la tua tariffa elettrica e per le ore di utilizzo appropriate.
Anche il prezzo d'acquisto merita solitamente un trattamento altrettanto esplicito. Distribuisci il costo del dispositivo sul periodo per cui prevedi di tenerlo, includi archiviazione e backup effettivamente necessari e confronta poi il numero di compiti utili completati. Se una macchina più economica soddisfa già il carico, il dispositivo premium più veloce deve offrire un vantaggio sufficiente a giustificare la differenza. Se un flusso compatibile risparmia molto lavoro ripetuto, può essere un argomento più forte di un benchmark isolato della chat.
Evita anche la trappola opposta: comprare al prezzo minimo e poi passare settimane a sostituire software non supportato. Il tempo necessario a ricostruire la catena di strumenti fa parte dell'acquisto, anche quando non compare in fattura.
Metti al lavoro il periodo di reso
Un buon test d'acquisto è abbastanza piccolo da concludersi quando la scelta è ancora reversibile. Preparalo prima di ordinare, così la prima settimana servirà a valutare il flusso di lavoro anziché a raccoglierne gli ingredienti.
- Scegli tre compiti che rappresentino lo scopo della macchina. Per esempio, esegui un compito di programmazione locale con una suite di test esistente, una risposta su un documento lungo con fatti noti e uno specifico grafo di generazione immagini. Mantieni identici prompt e materiali di partenza tra i sistemi candidati.
- Registra la configurazione esatta. Includi checkpoint del modello, quantizzazione, lunghezza del contesto, versione del runtime, driver, versioni delle applicazioni e modalità energetica. Lo stesso numero di parametri non basta per un confronto significativo.
- Separa comportamento a freddo e a caldo. Misura il primo caricamento del modello e la richiesta successiva. Non confrontare una prova in cache su una macchina con il primo avvio sull'altra.
- Valuta il risultato completato. Controlla che il codice superi i test previsti, che la risposta sul documento preservi i fatti richiesti e che il flusso creativo produca il file atteso con tutti i nodi necessari.
- Aggiungi il normale lavoro in background. Lascia in esecuzione le applicazioni che prevedi di usare. Osserva pressione sulla memoria, reattività, comportamento delle ventole e richieste fallite durante una sessione rappresentativa.
- Misura la sessione completa. Registra tempo totale, consumo alla presa se disponi di un misuratore adatto, errori e interventi manuali. Decidi rispetto ai criteri scritti prima di vedere il risultato più veloce.
Una risposta più lenta che produce in modo affidabile il risultato corretto può essere un acquisto migliore di una risposta rapida che richiede correzioni ripetute. Può essere vero anche il contrario quando compatibilità o throughput sono il collo di bottiglia. Il test deve indicarti per quale situazione stai comprando.
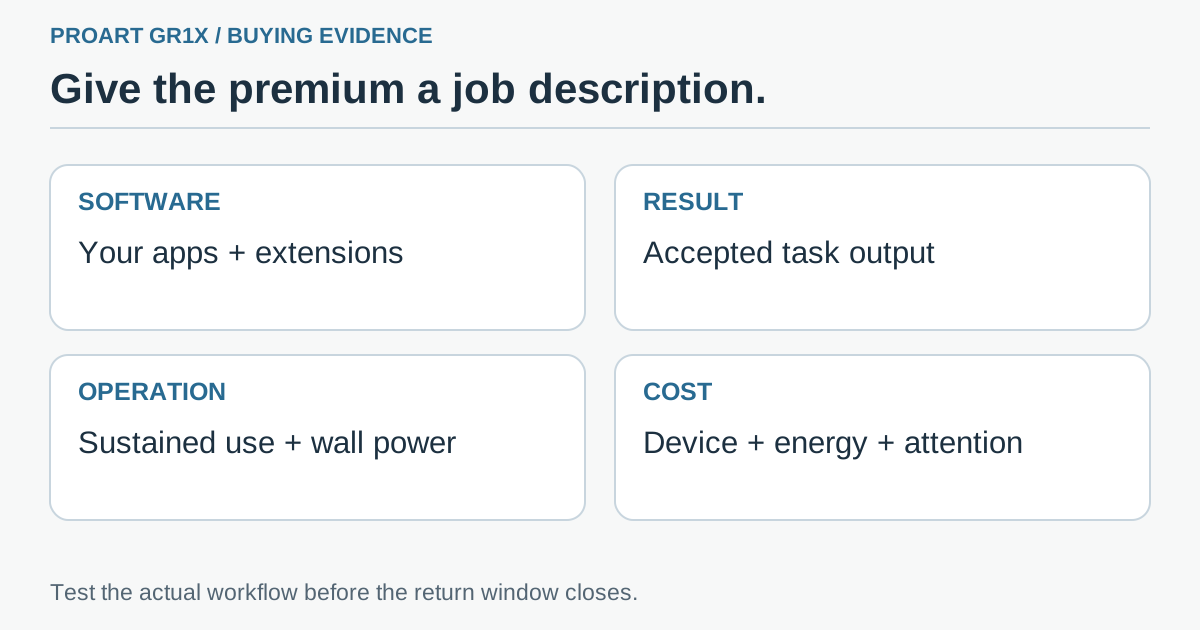 Lista di valutazione originale: verifica supporto delle applicazioni, output accettabile, funzionamento prolungato e costo completo del carico previsto prima della scadenza del reso.
Compra il flusso di lavoro, non l'adesivo 128GB
I nuovi annunci commerciali rendono RTX Spark un'opzione desktop concreta, e le recensioni indipendenti aggiungono prove oltre ai dati di picco dei produttori. Per ProArt GR1X, il confronto pubblicato con Qwen 3.8 27B mostra output più veloce e attese iniziali inferiori nei compiti provati. La configurazione recensita da 128GB ha anche un prezzo statunitense elevato.
La nostra prospettiva d'acquisto è partire da un collo di bottiglia identificabile. Se ti serve uno specifico flusso creativo accelerato RTX, prova quel flusso. Se vuoi un assistente generico reattivo, confronta interazione e risposte accettate con alternative meno costose. Se la macchina lavorerà senza supervisione, includi affidabilità prolungata ed energia.
La memoria è la dimensione del banco di lavoro, non il valore del lavoro che ne esce. Il sovrapprezzo diventa difendibile quando a giustificarlo sono i compiti che contano per te, non soltanto la scheda tecnica.
Fonti e materiali ufficiali
- Annuncio di disponibilità ASUS ProArt GR1X: pagina del 19 novembre; testo del 18 novembre 2026.
- Annuncio commerciale dei desktop NVIDIA RTX Spark, 18 novembre 2026.
- Tom's Guide: prezzi statunitensi e confronto Qwen 3.8 27B / LM Studio.
- Windows Central: una recensione separata di ProArt GR1X.
- Immagine ufficiale del prodotto ASUS. Foto e grafici delle recensioni restano presso i rispettivi editori; i grafici d'acquisto inclusi sono originali.

La tabella dei benchmark riproduce fatti numerici attribuiti, non il grafico di un editore. I test d'acquisto e l'esempio energetico sono analisi proposte, non misurazioni di queste unità recensite.
Consiglio di Telli.sh: Conserva insieme preventivi, configurazioni esatte e risultati dei compiti accettati, affinché la prossima scelta hardware parta da prove riutilizzabili. Crea la tua prima nota con Telli.sh.