Никто не говорил «сентябрь»: девятиминутная проверка, без которой нельзя доверять ИИ-протоколу
Исследования суммаризации стенограмм встреч показали: 30,4 % сгенерированных резюме заседаний городских советов содержали хотя бы одну фактическую ошибку, а за ними стоят семь названных типов ошибок. Практическое руководство по сверке ИИ-протокола с его же стенограммой: что проверять, в каком порядке и что говорить на самой встрече, чтобы проверка занимала девять минут, а не тридцать.
Резюме занимало три абзаца, было аккуратно структурировано и содержало ровно одну неверную фразу: команда договорилась выпустить миграцию в сентябре.
Никто ни о чём не договаривался. Кто-то сказал, что сентябрь, вероятно, реален, если подрядчик ответит вовремя, — условное предложение, произнесённое один раз, посреди отступления совсем о другом. Модель убрала условие, повысила догадку до решения, и протокол ушёл одиннадцати людям, которых не было в комнате. Двое из них начали планировать под сентябрь.
Ничего экзотического здесь нет. Это одно из самых подробно задокументированных свойств систем автоматической суммаризации, у него есть название в научной литературе, и оно не исчезнет оттого, что следующая модель станет больше. Эта статья даёт три вещи: семь способов, которыми резюме уходит в сторону от сказанного, девятиминутную проверку, которая ловит все семь, и несколько фраз, произнесённых на встрече, которые эту проверку сокращают.
Коротко:
- В бенчмарке TofuEval (NAACL 2024) 30,4 % сгенерированных резюме по реальным стенограммам заседаний городских советов содержали хотя бы одну фактическую ошибку; для периферийных тем — тех самых отступлений — доля поднималась до 43,6 %.
- Ошибки — не случайный шум. Исследователи разложили их на семь названных типов, и два самых вредных для встреч — это подача мнения как факта и сдвиги времени и модальности, то есть ровно тот момент, где «мы могли бы» превращается в «мы сделаем».
- Передать проверку обратно модели тоже не выйдет: на FaithBench (октябрь 2024) лучшие детекторы галлюцинаций показали точность около 50 %, а в TofuEval LLM-оценщики проиграли меньшим специализированным метрикам.
Фото: Shixart1985, Wikimedia Commons, CC BY 2.0. Очки здесь и есть суть. Читать всё равно кому-то придётся.
Запись решена. Проверка так и не началась.
Посчитайте инструменты для протоколов, показанные на Hacker News за последние полгода: с 1 марта по 13 августа 2026 года их не меньше пятнадцати. Локальные транскрайберы, блокноты без бота в звонке, импортеры в Obsidian, открытые клоны Granola. И у всех одни и те же две функции: записать звук и сгенерировать резюме.
Ни у одного нет третьего шага — единственного, в котором есть суждение. Резюме приходит вам в почту уже свёрстанным, уже уверенным в себе, уже разосланным всем участникам. Этот сценарий неявно утверждает ровно одно: результат готов.
Вот в чём дело: сгенерированное резюме — не запись встречи. Это высказывание о встрече, произведённое системой, которая не отвечает за свою правоту, и читать его нужно как любой пересказ из вторых рук — сверяя с источником, из которого оно получено.
Источник, к счастью, лежит рядом. Тот же инструмент, что сделал резюме, сделал и стенограмму, а сверка одного с другим занимает меньше времени, чем ушло на представления в начале встречи.
Цифра, которая должна изменить то, как вы читаете протоколы
TofuEval, опубликованный исследователями Salesforce AI и соавторами на NAACL 2024, — самое близкое к контролируемому измерению, что у нас есть по этой теме. Они взяли два диалоговых корпуса — новостные интервью и корпус MeetingBank из реальных стенограмм заседаний городских советов США, — попросили пять языковых моделей написать тематические резюме и поручили профессиональным лингвистам разметить каждое предложение резюме на фактическое соответствие источнику.
На стенограммах заседаний в среднем по пяти моделям 30,4 % резюме по основным темам содержали хотя бы одно фактическое несоответствие, а по периферийным темам — 43,6 %. Статья формулирует прямо: за исключением GPT-3.5-Turbo, «примерно 40–50 % их резюме содержат хотя бы одно фактическое несоответствие».
Честная оговорка: эти пять моделей относятся к 2023 году — Vicuna, три размера WizardLM и GPT-3.5-Turbo, — а сегодняшние передовые модели заметно лучше по фактической точности. Но два вывода из той же работы переживают это возражение, и именно они касаются вашего вторника.
Во-первых, масштаб не решил проблему надёжно. На данных заседаний доля ошибок у WizardLM-30B была ниже, чем у WizardLM-7B, всего на 3,8 процентного пункта — при более чем четырёхкратной разнице в размере; в отдельных сравнениях более крупная модель того же семейства давала больше ошибок. Во-вторых, число ошибок не имело значимой связи с длиной резюме (корреляция Пирсона ρ = 0,18). Более длинное и подробное резюме не является более безопасным. Ждать модель побольше — это не процесс проверки.
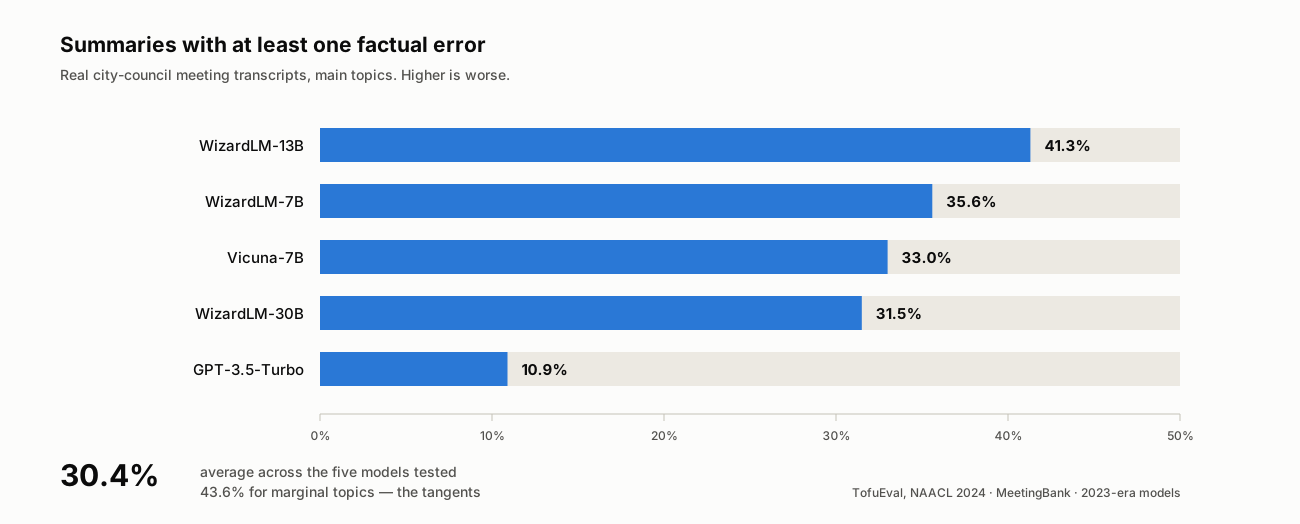
Доля резюме по реальным стенограммам городских советов, содержащих хотя бы одну фактическую ошибку, только основные темы. Источник: TofuEval, Tang et al., NAACL 2024 (arXiv:2402.13249). Тестировались модели 2023 года; типы ошибок ниже пережили их.
Семь способов, которыми резюме уходит в сторону от комнаты
Самое полезное в той работе — не проценты, а классификация: семь названных типов ошибок, выведенных разметчиками из тысяч помеченных предложений, как расширение более ранней таксономии для коротких диалогов.
Прочитайте их один раз — и начнёте узнавать их в собственных протоколах. Это не случайные сбои, а конкретные повторяющиеся пути, на которых сжатие устной речи в письменную стирает различие, на которое опиралась комната.
| Тип ошибки (TofuEval) | Как это выглядит в протоколе | Как поймать |
|---|---|---|
| Внешняя информация | Деталь, которая есть в резюме и которой нет в аудио: число, имя клиента, обоснование, которого никто не давал | Найдите это имя или число в стенограмме; если поиск пуст — оно выдумано |
| Неверная отсылка | Верное решение приписано не тому человеку, возражение одного записано на счёт другого | Перейдите к таймкоду и посмотрите, кто говорит |
| Мнение как факт | «Изменение цены увеличит отток» — хотя кто-то лишь опасался, что может увеличить | Ищите смягчение в оригинале: считает, опасается, подозревает |
| Ошибка рассуждения | Неверная арифметика или причинно-следственная связь, которую комната не проводила | Пересчитайте каждое число; спросите, было ли это «потому что» произнесено или выведено |
| Время / вид / модальность | «Мы могли бы выпустить в сентябре» превращается в «мы выпустим в сентябре» | Сверьте каждый глагол будущего времени с исходной модальностью |
| Противоречие | Потерянное отрицание: «мы не переносим срок» превращается в «мы переносим срок» | Ищите в стенограмме не, никогда, если только рядом с утверждением |
| Тонкий сдвиг смысла | «дать рекомендацию» переписано как «выдвинуть требование» | Сравните глагол резюме с глаголом источника |
Три из них проще всего узнать на конкретном примере. Вот каждый: стенограмма и фраза из резюме рядом.
Потерянное отрицание — ошибка противоречия. Что прозвучало в комнате:
ДАНИЭЛЬ (00:31:12): То есть дату запуска мы не двигаем. Что бы ещё
ни поменялось, эта дата стоит.
Что написало резюме:
Команда договорилась сдвинуть дату запуска.
Пропало одно слово — и фраза предписывает противоположное действие. При этом она безупречна грамматически, потому вычитка её и проскакивает, а поиск слова «не» рядом с решением находит её за четыре секунды.
Неверная атрибуция — ошибка отсылки. Что прозвучало в комнате:
ПРИЯ (00:18:40): Я против оплаты за место. В прошлом квартале два
корпоративных клиента сказали нам, что так сделка разваливается.
МИНА (00:18:55): Да, согласна.
Что написало резюме:
Мина возразила против оплаты за место, сославшись на отзывы
корпоративных клиентов.
Каждый факт в этой фразе есть в стенограмме. Нет только человека. В этом вся трудность: такое не поймать вопросом «правда ли сказанное», только вопросом «принадлежит ли сказанное тому, на кого его записали».
Повышенная в звании догадка — ошибка модальности. Что прозвучало в комнате:
СЭМ (00:44:02): Сентябрь, наверное, реален, если подрядчик успеет нам
ответить.
Что написало резюме:
Команда договорилась выпустить миграцию в сентябре.
Убраны две оговорки — слово «наверное» и целиком условное придаточное, — и общая догадка превратилась в обязательство с датой. Чтобы так вышло, никому не пришлось лгать. Это сделало сжатие.
Два типа заслуживают особого внимания, потому что именно они стоят командам реальных денег.
Мнение как факт — это и есть сентябрьский инцидент из начала статьи. На встрече большинство фраз смягчены: люди думают вслух, и именно смягчение несёт весь смысл. Модели суммаризации срезают смягчения по своей природе, потому что при сжатии это первое, что убирают. Результат читается решительнее, чем была комната, и именно поэтому его не оспаривают.
Сдвиги модальности так же портят даты. «Мог бы», «стоило бы», «вероятно» и «если подрядчик ответит» — это граница между планом и обязательством, и одновременно самые дешёвые слова, чтобы их выбросить. Резюме, где команда что-то делает в сентябре, тихо изготовило дедлайн, за который никто не отвечает.
Обратите внимание на общее. Модель не выдумывала факты из воздуха — она убрала оговорки. Это самая незаметная правка из возможных и та, которую ни один читатель не обнаружит без источника перед глазами.
Выдумывает она на отступлениях
В данных есть второй паттерн, который точно ложится на то, как проходят реальные встречи.
Резюме периферийных тем — того, что упомянули мимоходом, а не обсуждали подробно, — были заметно хуже: 43,6 % против 30,4 % на корпусе заседаний. Исследователи объясняют механизм: когда тема почти не раскрыта в источнике, модели «опираются на собственные знания, чтобы сделать выводы о теме, привнося в резюме неподтверждённую информацию». Там, где доказательств мало, пустоту заполняют общими знаниями, и по тону эта начинка неотличима от обоснованных частей.
Ваши встречи полны периферийных тем: две минуты про аудит безопасности, подрядчик, названный один раз, цифра, которую кто-то помнил наполовину. Эти строки обсуждались меньше всего и с наибольшей вероятностью неверны — и читаются ровно так же гладко, как всё остальное.
Слой ниже устроен так же. В работе «Careless Whisper», представленной на ACM FAccT 2024, Кёнеке и коллеги обнаружили, что примерно 1 % транскрипций Whisper содержал целые галлюцинированные фразы или предложения, которых в исходном аудио не было ни в каком виде, и что 38 % этих галлюцинаций несли явный вред: выдуманные связи, ложная авторитетность, сконструированное насилие. Интереснее всего триггер: галлюцинации непропорционально часто возникали у говорящих с более длинными неголосовыми промежутками.
То есть при тишине. А встреча из тишины и состоит: паузы на подумать, кто-то снимает микрофон с мьюта, грузится демонстрация экрана, четыре секунды после трудного вопроса. Именно этот материал модель транскрипции с наибольшей вероятностью заполнит тем, чего никто не говорил. А значит, ошибки стенограммы и ошибки резюме не независимы: выдуманная строка стенограммы — это для резюме идеально обоснованный вход.
Проверку нельзя вернуть модели
Очевидная идея — попросить вторую модель проверить первую. Измерения не обнадёживают.
В том же исследовании TofuEval авторы оценили LLM в роли бинарных судей фактической согласованности и обнаружили, что все они, включая GPT-4, «плохо справляются с обнаружением ошибок в резюме, сгенерированных LLM», уступая меньшим не-LLM метрикам фактичности, созданным специально для этой задачи. Даже когда GPT-4 верно помечал предложение, его объяснение почему было правильным примерно в 80 % случаев; у остальных оценщиков — примерно в половине.
FaithBench, выпущенный Vectara в октябре 2024 года, назвал цифру этого потолка. Он собрал галлюцинации десяти современных LLM из восьми семейств, по которым существующие детекторы расходились, и сообщил, что даже лучшие детекторы галлюцинаций показали точность около 50 %. Подбрасывание монеты — ровно на тех случаях, которые важны.
Значит, проверка на вас. Это звучит как нагрузка, пока не заметишь асимметрию: детектору нужно судить произвольный текст по незнакомому документу, а вы были в комнате. Вы уже знаете, какое утверждение выглядело странно. Остаётся только проверить его.
Три артефакта, три разные задачи
Большинство споров «ИИ-протокол против настоящего» — это ошибка категории. Встреча производит три артефакта, они не заменяют друг друга, и команда, оставившая только один, всегда теряет что-то конкретное.
| Сырая стенограмма | Резюме от ИИ | Журнал решений | |
|---|---|---|---|
| Точные формулировки сохранены | Да — дословно | Нет — сжато, смягчения выброшены | Нет |
| Кто это сказал | Да, при разделении говорящих | Иногда; неверная отсылка — отдельный названный тип ошибки | Да — ответственный и есть смысл |
| Когда это было сказано | Да — с таймкодами | Редко | Только срок |
| Решения с ответственным и датой | Похоронены примерно в 9 000 словах | Частично и ненадёжно | Да — это его единственная задача |
| Что отклонили и почему | Да, если кто-то произнёс | Обычно вырезается как избыточное | Да, одной строкой |
| Читается за 60 секунд | Нет | Да | Да |
| Можно сверить с доказательством | Он и есть доказательство | Только если стенограмма сохранилась | Только если сохранились оба |
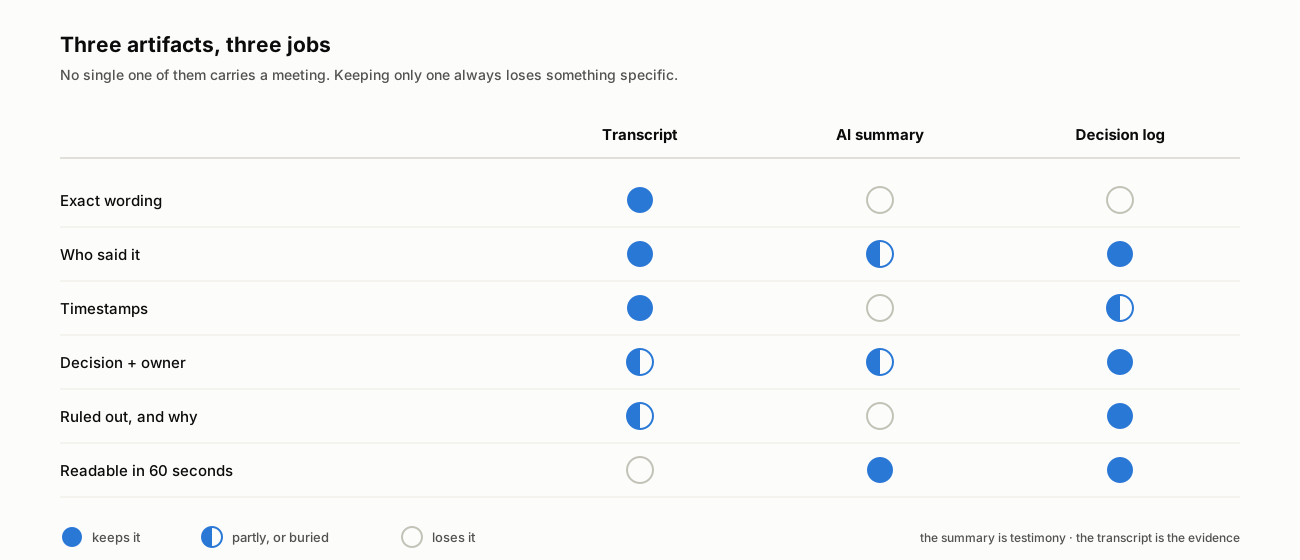
Что каждый артефакт сохраняет, сохраняет частично или теряет. Нижняя строка и решает, стоят ли двое других чего-нибудь.
Нижняя строка — это весь аргумент. Резюме без сохранившейся стенограммы нефальсифицируемо: когда коллега говорит «мы договаривались не об этом», у вас есть два мнения и ноль записей. Именно здесь ИИ-протокол более хрупок, чем человеческий: у рукописного протокола погрешность была видна, и все читали его с уместным недоверием. Машинная проза приходит с аккуратными заголовками и уверенными утверждениями и занимает авторитет, которого не заслужила.
Назовём вещи своими именами: резюме — это показания свидетеля, а стенограмма — доказательство. Показания полезны. Показания — это ещё и то, что проверяют.
Девятиминутная проверка по шагам
Вот процедура, которую мы рекомендуем, с таймингом под встречу на 60 минут. Порядок важен: вперёд вынесены проверки с самой высокой ценой ошибки, поэтому, если вас прервут на четвёртой минуте, дорогие ошибки уже пойманы.
- 0:00–1:30 — Читайте только предложения-решения. На первом проходе полностью игнорируйте повествовательное резюме. Найдите каждое предложение, которое утверждает исход, обязательство или дату. В типичной часовой встрече их от трёх до шести. Действовать будут только по этим строкам.
- 1:30–3:00 — Восстановите модальность. Для каждого такого предложения перейдите к нужному месту стенограммы и проверьте глагол. Сказали сделаем — или могли бы, стоило бы, вероятно? Если в оригинале было смягчение, перепишите строку, вернув его, а лучше пометьте как открытый вопрос с ответственным.
- 3:00–4:30 — Проверьте каждое имя собственное и каждое число. Имена, компании, версии, цены, даты, проценты. Ищите каждое в стенограмме. Чего там нет — это внешняя информация: удалите её или подтвердите вне встречи. Это работа поисковой строки, а не чтения.
- 4:30–5:30 — Проверьте атрибуцию. Для каждого решения и каждого возражения подтвердите, кто говорит на этом таймкоде. Неверная отсылка — та ошибка, что скорее создаст проблему между людьми, чем в планировании, и проверяется она быстрее всех.
- 5:30–6:30 — Охота на потерянные отрицания. Ищите в стенограмме не, никогда, если только и вместо рядом с каждым решением. Ошибка-противоречие переворачивает смысл, оставляя предложение безупречно грамматичным, поэтому вычитка её не найдёт — а поиск найдёт.
- 6:30–8:00 — Спросите, чего не хватает. Этот шаг за вас не сделает ни один инструмент, потому что резюме не может пометить собственные пропуски. Два вопроса: что мы отклонили и почему? И на какой вопрос мы не ответили? Ни то ни другое не переживает сжатия, и именно это делает протокол полезным через полгода.
- 8:00–9:00 — Напишите журнал решений и разошлите. Три-шесть строк, в каждой: что решили, кто отвечает за следующий шаг и к какому сроку. Свяжите со стенограммой. Именно эта ссылка делает всю проверку перепроверяемой кем-то другим.
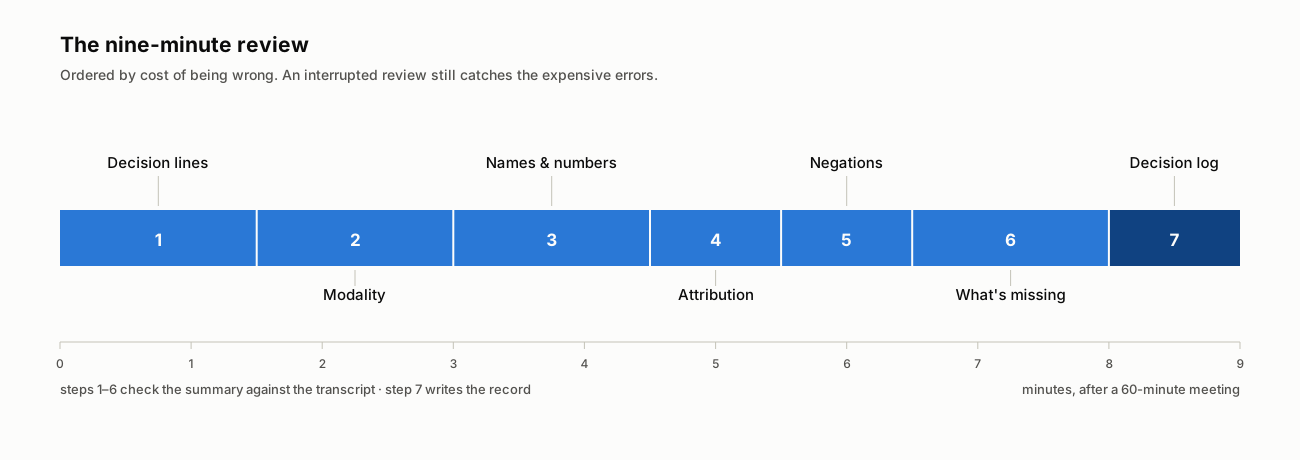
Порядок и есть замысел: модальность и выдуманные детали в начале, пропуски в конце. Прерванная проверка всё равно ловит дорогие ошибки.
Две заметки о том, как делать это регулярно. Если встреча длилась 30 минут, это работа на четыре минуты. А если делать её в инструменте, где резюме и стенограмма с таймкодами лежат вместе, шаги со второго по пятый превращаются в поиск и клики вместо переключения окон — в этом и разница между привычкой, которая переживёт загруженную неделю, и той, которая не переживёт.
Десять секунд на встрече экономят пять минут на проверке
Проверка резко сокращается, если нужная информация изначально есть в записи. Модель не восстановит того, чего никто не произнёс, а бо́льшая часть того, что делает протокол двусмысленным, в аудио никогда и не попадала.
- Начните с вопроса, вслух. «Сегодня решаем: выпускаем миграцию до конференции или после». Произнесённый вопрос даёт модели основную тему вместо набора периферийных — а периферийные и были случаем 43,6 %.
- Проговорите решение одной фразой, с именем и датой, пока никто не ушёл. «Решение: Мина ведёт переписку с подрядчиком, сентябрьскую дату подтверждаем до 25-го». Любой инструмент на рынке зафиксирует эту фразу идеально. И ни один её не придумает.
- Произносите отрицание явно. «Дату запуска мы не двигаем» надёжнее, чем пожатие плечами и кивок: потерянное отрицание — задокументированный тип ошибки, а непроизнесённое отрицание потерять невозможно.
- Назовите одной строкой, что отклонили и почему. «Рассматривали оплату за место, отказались, потому что в прошлом квартале два корпоративных клиента были против». Именно эта фраза не даёт тому же спору открыться заново через полгода.
- Один раз продиктуйте необычные имена собственные. Названия подрядчиков, внутренние кодовые имена и аббревиатуры — ровно то, что стенограмма коверкает, а резюме потом уверенно повторяет.
- Не давайте говорить тишине. Если в комнате стало тихо, потому что все читают документ, скажите это вслух. Длинные неголосовые промежутки — то самое условие, при котором модели транскрипции галлюцинируют сильнее всего.
Ничего из этого не театр. Это диктовка в протокол — навык, который стал ценнее, когда протокол начал писаться сам.
Итог
Резюме встречи от ИИ — это не запись. Это показания о записи, изложенные гладко, свидетелем, которому нечего терять от неточности и у которого документально зафиксирована склонность терять слово «вероятно».
Такая переформулировка закрывает спор «вручную или ИИ», которого никогда и не было по существу. Сохраняйте запись — она единственное доказательство. Пусть резюме пишет модель — она быстрее вас и не устаёт на сороковой минуте. А потом потратьте девять минут на единственную часть, для которой нужно было присутствовать: сверить уверенные фразы с тем, что действительно прозвучало, и записать те три строки, по которым кто-то должен действовать.
Обожгутся в 2026 году не те команды, что отказались от ИИ-протоколиста, а те, что читали его вывод как стенограмму, тогда как это был пересказ, — и не сохранили стенограмму, которая показала бы разницу. Более полная версия того, что должен нести хороший протокол, — в шести вещах, которые протокол встречи по-прежнему обязан содержать, а о том, почему процент ошибок в словах почти ничего не говорит о пригодности стенограммы, — в точности недостаточно.
Где здесь Telli.sh: девятиминутная проверка работает, только если резюме и источник живут в одном месте. Telli.sh держит стенограмму с таймкодами и разметкой говорящих рядом с редактируемым резюме от ИИ, так что проверка утверждения — это поиск и клик, а не охота по двум системам; а когда в комнате говорят не на одном языке, перевод стоит рядом с оригиналом, а не вместо него. Резюме приходит как черновик, который вы правите, а не как результат, который вы принимаете.
Источники
- Tang et al., «TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization», NAACL 2024 (arXiv:2402.13249, 20 февраля 2024)
- Koenecke et al., «Careless Whisper: Speech-to-Text Hallucination Harms», ACM FAccT 2024 (arXiv:2402.08021, 12 февраля 2024)
- Bao et al., «FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs», Vectara (arXiv:2410.13210, 17 октября 2024)
- Hu et al., «MeetingBank: A Benchmark Dataset for Meeting Summarization», ACL 2023 (arXiv:2305.17529, 27 мая 2023)
- Wang et al., «Analyzing and Evaluating Faithfulness in Dialogue Summarization», EMNLP 2022 (arXiv:2210.11777, 21 октября 2022)
- Страница изображения на Wikimedia Commons
