Ninguém disse setembro: a revisão de nove minutos que todo resumo de IA precisa
Pesquisas sobre sumarização de transcrições de reunião encontraram 30,4% de resumos gerados a partir de sessões de câmaras municipais com pelo menos um erro factual — e sete tipos de erro nomeados por trás disso. Um guia prático para revisar uma ata escrita por IA contra a própria transcrição: o que conferir, em que ordem, e o que dizer na reunião para que a revisão leve nove minutos em vez de trinta.
O resumo tinha três parágrafos, estava bem organizado e estava errado em exatamente uma frase: a equipe concordou em lançar a migração em setembro.
Ninguém concordou com isso. Alguém disse que setembro provavelmente daria certo se o fornecedor respondesse a tempo — uma condicional, dita uma única vez, no meio de uma digressão sobre outro assunto. O modelo apagou a condição, promoveu o palpite a decisão, e a ata foi para onze pessoas que não estavam na sala. Duas delas começaram a planejar contando com setembro.
Não há nada de exótico nisso. É um dos comportamentos mais bem documentados dos sistemas de sumarização automática, tem nome na literatura de pesquisa e não vai desaparecer porque o próximo modelo é maior. Este texto entrega três coisas: as sete maneiras pelas quais um resumo se afasta do que foi realmente dito, uma revisão de nove minutos que pega todas as sete, e as poucas frases ditas durante a reunião que encurtam essa revisão.
Resumo rápido:
- No benchmark TofuEval (NAACL 2024), 30,4% dos resumos gerados a partir de transcrições reais de câmaras municipais tinham pelo menos um erro factual; nos temas marginais — as digressões — o número subia para 43,6%.
- Os erros não são ruído aleatório. Os pesquisadores os classificaram em sete tipos nomeados, e os dois que mais prejudicam reuniões são opinião apresentada como fato e deslocamentos de tempo e modalidade — exatamente onde "a gente poderia" vira "a gente vai".
- Também não dá para devolver a checagem ao modelo: no FaithBench (outubro de 2024), os melhores detectores de alucinação ficaram com acurácia perto de 50%, e no TofuEval os avaliadores baseados em LLM perderam para métricas especializadas menores.
Imagem: Shixart1985, Wikimedia Commons, CC BY 2.0. Os óculos são o ponto. Alguém ainda precisa ler.
A captura foi resolvida. A conferência nunca começou.
Conte as ferramentas de ata lançadas no Hacker News nos últimos seis meses: pelo menos quinze entre 1º de março e 13 de agosto de 2026. Transcritores locais, blocos de notas que não colocam bot na chamada, importadores para Obsidian, clones open source do Granola. Todas trazem as mesmas duas funções: capturar o áudio e gerar o resumo.
Nenhuma traz a terceira etapa, a única em que existe julgamento. O resumo chega à sua caixa de entrada já formatado, já seguro de si, já enviado para a sala inteira. O que esse fluxo afirma implicitamente é uma coisa só: este resultado está pronto.
Aqui está o ponto: um resumo gerado não é o registro da reunião. É uma declaração sobre a reunião, produzida por um sistema que não responde pela própria exatidão, e deve ser lido como qualquer relato de segunda mão — contra as evidências de onde veio.
Felizmente, essas evidências estão logo ali. A mesma ferramenta que produziu o resumo produziu a transcrição, e conferir uma contra a outra leva menos tempo do que a reunião gastou nas apresentações.
O número que deveria mudar sua forma de ler atas
O TofuEval, publicado por pesquisadores da Salesforce AI e colaboradores no NAACL 2024, é o mais próximo de uma medição controlada que temos sobre isso. Eles pegaram dois corpora de diálogo — um de entrevistas jornalísticas e outro chamado MeetingBank, feito de transcrições reais de câmaras municipais dos EUA —, pediram que cinco modelos de linguagem escrevessem resumos por tema e contrataram linguistas profissionais para anotar cada frase quanto à consistência factual com a fonte.
Nas transcrições de reunião, na média dos cinco modelos, 30,4% dos resumos sobre os temas principais continham pelo menos uma inconsistência factual, subindo para 43,6% nos temas marginais. O artigo diz sem rodeios: com exceção do GPT-3.5-Turbo, "aproximadamente 40–50% dos seus resumos contêm pelo menos uma inconsistência factual".
Esses cinco modelos são de 2023 — Vicuna, três tamanhos do WizardLM e GPT-3.5-Turbo —, portanto as taxas de erro observadas não devem ser tratadas como estimativas para os modelos de ponta atuais. Ainda assim, dois achados do estudo continuam relevantes para revisar uma ata de hoje.
Primeiro, escala não resolveu de forma confiável. Nos dados de reunião, a taxa de erro do WizardLM-30B ficou apenas 3,8 pontos percentuais abaixo da do WizardLM-7B, apesar de ser mais de quatro vezes maior; em algumas comparações, o modelo maior da mesma família produziu mais erros. Segundo, a quantidade de erros não teve relação significativa com o tamanho do resumo (correlação de Pearson ρ = 0,18). Um resumo mais longo e detalhado não é mais seguro. Esperar por um modelo maior não é um processo de revisão.
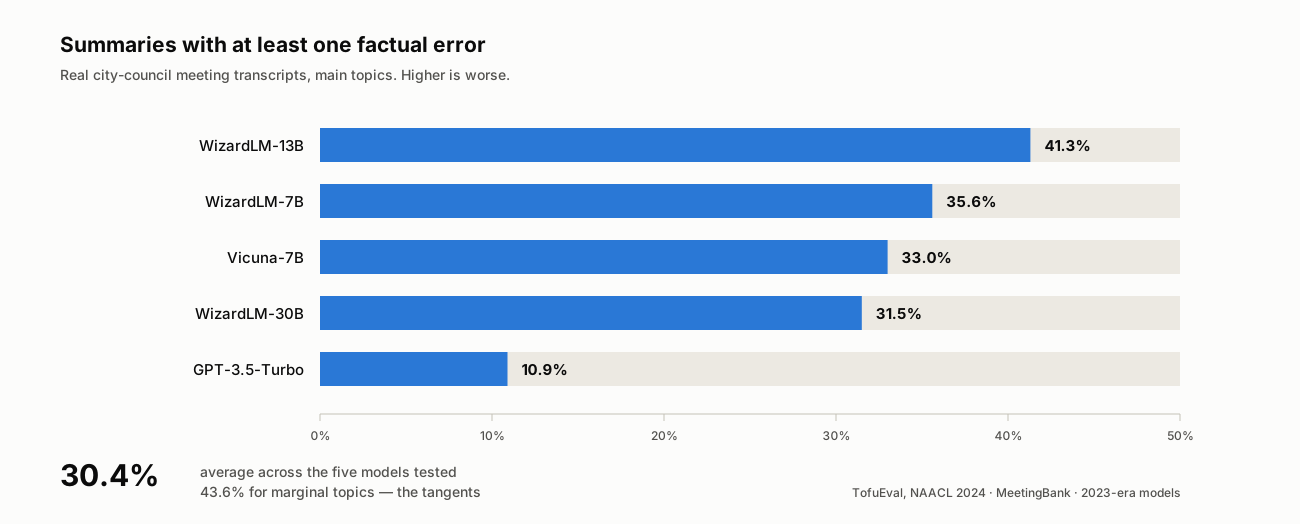
Proporção de resumos de transcrições reais de câmaras municipais com pelo menos um erro factual, apenas temas principais. Fonte: TofuEval, Tang et al., NAACL 2024 (arXiv:2402.13249). Os modelos testados são de 2023; os tipos de erro abaixo sobreviveram a eles.
Sete maneiras de um resumo se afastar da sala
O mais útil naquele artigo não é o percentual: é a taxonomia. Sete tipos de erro nomeados, derivados pelos anotadores a partir de milhares de frases sinalizadas, estendendo uma taxonomia anterior construída sobre diálogos curtos.
Leia uma vez e você vai começar a vê-los nas suas próprias atas, porque não são falhas aleatórias: são caminhos específicos e repetíveis pelos quais comprimir fala em prosa apaga uma distinção da qual a sala dependia.
| Tipo de erro (TofuEval) | Como aparece numa ata | Como pegar |
|---|---|---|
| Informação extrínseca | Um detalhe que aparece no resumo e em lugar nenhum do áudio — um número, o nome de um cliente, uma justificativa que ninguém deu | Busque o nome próprio ou o número na transcrição; se não retornar nada, foi inventado |
| Atribuição errada | A decisão certa creditada à pessoa errada, ou a objeção de um lançada na conta do outro | Pule para o timestamp e veja quem está falando |
| Opinião como fato | "A mudança de preço vai aumentar o churn" quando alguém apenas temia que pudesse aumentar | Procure a hesitação no original: acha, teme, desconfia |
| Erro de raciocínio | Conta errada, ou uma relação de causa e efeito que a sala nunca traçou | Refaça cada cálculo; pergunte se aquele "porque" foi dito ou deduzido |
| Tempo / aspecto / modalidade | "A gente poderia lançar em setembro" vira "vamos lançar em setembro" | Confronte cada verbo no futuro com o modal original |
| Contradição | Uma negação perdida: "não vamos mexer no prazo" vira "vamos mexer no prazo" | Busque não, nunca, a menos que perto da afirmação |
| Deslocamento sutil de sentido | "fazer uma recomendação" reescrito como "fazer um pedido" | Compare o verbo do resumo com o verbo da fonte |
Três deles ficam mais fáceis de reconhecer quando você vê o objeto. Aqui vai cada um com a transcrição e a frase do resumo lado a lado.
Uma negação perdida — erro de contradição. O que foi dito na sala:
DANIEL (00:31:12): Então a data de lançamento a gente não mexe. Mude o
que mudar, essa data fica.
O que o resumo escreveu:
A equipe concordou em mexer na data de lançamento.
Faltou uma palavra e a frase agora manda fazer o oposto. E ela está gramaticalmente perfeita, que é exatamente por isso que a releitura passa batido enquanto uma busca por "não" perto da decisão pega o erro em quatro segundos.
Uma atribuição errada — erro de referência. O que foi dito na sala:
PRIYA (00:18:40): Eu sou contra a cobrança por assento. Dois clientes
enterprise falaram no trimestre passado que assim o negócio não fecha.
MINA (00:18:55): É, concordo.
O que o resumo escreveu:
Mina se opôs à cobrança por assento, citando o retorno de clientes
enterprise.
Todo fato nessa frase está na transcrição. A pessoa não. É aí que mora a dificuldade: você não pega isso perguntando se as afirmações são verdadeiras, só perguntando se elas pertencem a quem foram penduradas.
Um palpite promovido — erro de modalidade. O que foi dito na sala:
SAM (00:44:02): Setembro provavelmente dá, se o fornecedor responder
pra gente a tempo.
O que o resumo escreveu:
A equipe concordou em lançar a migração em setembro.
Dois qualificadores removidos — a palavra "provavelmente" e a oração condicional inteira — e um palpite coletivo virou compromisso com data. Ninguém precisou mentir para isso acontecer. Quem fez foi a compressão.
Dois deles merecem atenção especial, porque são os que custam dinheiro de verdade.
Opinião como fato é o incidente de setembro que abre este texto. Em reunião, a maioria das frases vem com hesitação: as pessoas estão pensando em voz alta, e a hesitação carrega todo o sentido. Modelos de sumarização removem hesitações por construção, porque é a primeira coisa que se corta ao comprimir. O resultado soa mais decidido do que a sala foi, e é exatamente por isso que não é questionado.
Deslocamentos de modalidade causam o mesmo dano às datas. "Poderia", "deveria", "provavelmente" e "se o fornecedor responder" são a diferença entre um plano e um compromisso, e são também as palavras mais baratas de descartar. Um resumo que diz que a equipe vai fazer algo em setembro fabricou silenciosamente um prazo que ninguém assumiu.
Repare no que os dois têm em comum. O modelo não inventou fatos do nada: ele removeu qualificadores. É a edição menos visível que ele pode fazer, e a que nenhum leitor detecta sem a fonte à frente.
A invenção acontece nas digressões
Há um segundo padrão nos dados que se encaixa exatamente no jeito como reuniões acontecem.
Resumos de temas marginais — os mencionados de passagem em vez de discutidos a fundo — eram substancialmente piores: 43,6% contra 30,4% no corpus de reuniões. Os pesquisadores explicam o mecanismo: quando um tema mal aparece na fonte, os modelos "recorrem ao próprio conhecimento para fazer inferências sobre ele, trazendo informação sem respaldo para o resumo". Onde a evidência é rala, preenche-se com conhecimento geral, e esse preenchimento é indistinguível, no tom, das partes de fato ancoradas.
Suas reuniões são cheias de temas marginais: os dois minutos sobre a revisão de segurança, o fornecedor citado uma única vez, o número que alguém lembrava pela metade. Essas linhas são as menos discutidas e as mais propensas a estar erradas — e vão ler tão fluentes quanto o resto.
A camada de baixo tem o mesmo formato. Em "Careless Whisper", apresentado no ACM FAccT 2024, Koenecke e colegas encontraram que cerca de 1% das transcrições do Whisper continha frases inteiras alucinadas que não existiam de forma alguma no áudio original, e que 38% dessas alucinações traziam danos explícitos: associações inventadas, autoridade falsa, violência fabricada. O gatilho é a parte interessante: as alucinações ocorriam desproporcionalmente com falantes que tinham trechos não vocais mais longos.
Silêncio, em outras palavras. E é disso que uma reunião é feita: as pausas para pensar, alguém tirando o mudo, uma tela compartilhada carregando, os quatro segundos depois de uma pergunta difícil. É exatamente a matéria-prima que um modelo de transcrição tem mais chance de preencher com algo que nunca foi dito. Isso também significa que erros de transcrição e de resumo não são independentes: uma linha inventada na transcrição é, para o resumo, uma entrada perfeitamente fundamentada.
Você não pode devolver a checagem ao modelo
A ideia óbvia é pôr um segundo modelo para verificar o primeiro. As medições não animam.
No mesmo estudo do TofuEval, os autores avaliaram LLMs como juízes binários de consistência factual e concluíram que todos, GPT-4 incluído, "têm desempenho ruim na detecção de erros em resumos gerados por LLM" — e ficaram atrás de métricas de factualidade menores, não baseadas em LLM, construídas para a tarefa. Mesmo quando o GPT-4 sinalizava corretamente uma frase, sua explicação do porquê estava certa em cerca de 80% das vezes; para os demais avaliadores, cerca de metade.
O FaithBench, lançado pela Vectara em outubro de 2024, colocou número nesse teto. Ele reuniu as alucinações produzidas por dez LLMs modernos de oito famílias e sobre as quais os detectores existentes discordavam — e relatou que mesmo os melhores detectores de alucinação ficaram com acurácia perto de 50%. Cara ou coroa, justamente nos casos que importam.
Então a revisão é sua. Soa como um fardo até você notar a assimetria: o detector precisa julgar um texto qualquer contra um documento desconhecido, enquanto você estava na sala. Você já sabe qual afirmação soou estranha. Só precisa conferir.
Três artefatos, três funções diferentes
A maior parte das discussões "ata de IA versus ata de verdade" é um erro de categoria. Uma reunião produz três artefatos, eles não se substituem, e a equipe que guarda apenas um sempre perde algo específico.
| Transcrição bruta | Resumo de IA | Registro de decisões | |
|---|---|---|---|
| Preserva as palavras exatas | Sim — literal | Não — comprimido, hesitações caem | Não |
| Quem disse | Sim, se houver separação de falantes | Às vezes; atribuição errada é um tipo de erro nomeado | Sim — o responsável é o ponto |
| Quando foi dito | Sim — com timestamp | Raramente | Só o prazo |
| Decisões com responsável e data | Enterradas em cerca de 9.000 palavras | Em parte, e sem confiabilidade | Sim — essa é sua única função |
| O que foi descartado e por quê | Sim, se alguém disse | Normalmente cortado como redundante | Sim, em uma linha |
| Lê-se em 60 segundos | Não | Sim | Sim |
| Pode ser conferido contra evidência | Ele é a evidência | Só se a transcrição sobreviver | Só se as duas sobreviverem |
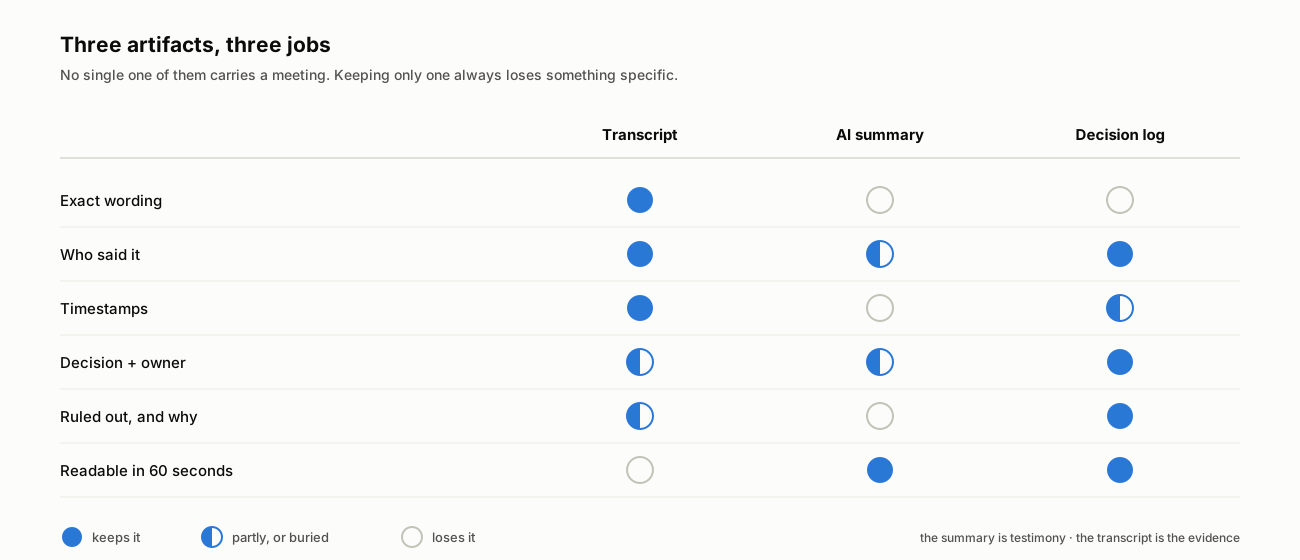
O que cada artefato guarda, guarda pela metade ou perde. A linha de baixo decide se os outros dois valem alguma coisa.
Aquela linha final é o argumento inteiro. Um resumo sem transcrição preservada é infalsificável: quando um colega diz "não foi isso que combinamos", você tem duas opiniões e nenhum registro. E é justamente aqui que uma ata de IA é mais frágil que uma humana: a ata escrita por uma pessoa carregava a falibilidade à vista, e todo mundo lia com a desconfiança adequada. A prosa da máquina chega em títulos limpos e afirmações seguras, tomando emprestada uma autoridade que não conquistou.
Vamos chamar pelo nome: o resumo é um depoimento e a transcrição é a prova. Depoimento é útil. Depoimento também é aquilo que se confere.
A revisão de nove minutos, em ordem
Em uma reunião de 60 minutos, esta revisão leva nove minutos. Ela começa pelas afirmações cujo erro teria o maior custo, para que uma interrupção não deixe as decisões mais importantes sem conferência.
- 0:00–1:30 — Leia só as frases de decisão. Ignore completamente o resumo narrativo na primeira passada. Encontre toda frase que afirma um resultado, um compromisso ou uma data. Numa reunião típica de uma hora são três a seis. Só essas linhas serão executadas por alguém.
- 1:30–3:00 — Restaure a modalidade. Para cada uma dessas frases, pule ao ponto correspondente da transcrição e confira o verbo. Alguém disse vamos ou disse poderia, deveria, provavelmente? Se o original tinha hesitação, reescreva a linha com a hesitação de volta — ou melhor, marque como questão em aberto com um responsável.
- 3:00–4:30 — Confira cada nome próprio e cada número. Nomes, empresas, versões, preços, datas, percentuais. Busque cada um na transcrição. O que não aparecer lá é informação extrínseca: apague ou confirme fora da reunião. É trabalho de caixa de busca, não de leitura.
- 4:30–5:30 — Verifique a atribuição. Para cada decisão e cada objeção, confirme quem está falando naquele timestamp. Atribuição errada é o erro com mais chance de causar problema interpessoal em vez de problema de cronograma, e é o mais rápido de conferir.
- 5:30–6:30 — Cace as negações perdidas. Busque na transcrição não, nunca, a menos que e em vez de na vizinhança de cada decisão. Um erro de contradição inverte o sentido deixando a frase perfeitamente gramatical, então revisar lendo não acha: buscar acha.
- 6:30–8:00 — Pergunte o que está faltando. Esta é a etapa que nenhuma ferramenta faz por você, porque um resumo não consegue sinalizar as próprias omissões. Duas perguntas: o que descartamos e por quê? E qual pergunta ficou sem resposta? Nenhuma das duas sobrevive à compressão, e ambas são o que torna a ata útil daqui a seis meses.
- 8:00–9:00 — Escreva o registro de decisões e envie. De três a seis linhas, cada uma com o que foi decidido, quem assume o próximo passo e até quando. Vincule à transcrição. É esse link que torna a revisão inteira reconferível por outra pessoa.
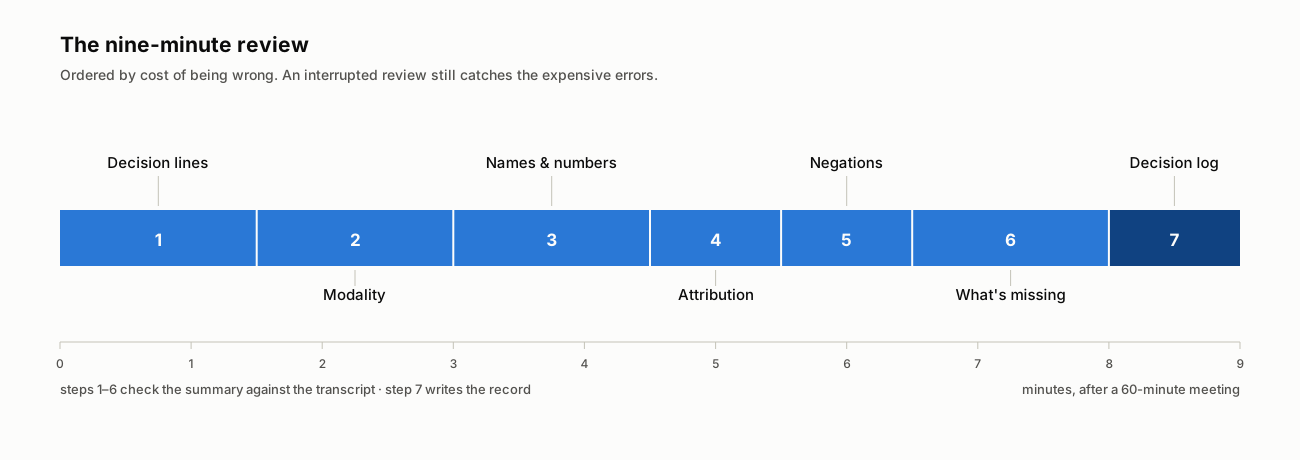
A ordem é o projeto: modalidade e detalhes inventados primeiro, omissões por último. Uma revisão interrompida ainda assim pega os erros caros.
Duas observações para fazer isso no dia a dia. Se a reunião teve 30 minutos, é um trabalho de quatro minutos. E se você fizer na ferramenta que guarda ao mesmo tempo o resumo e a transcrição com timestamps, as etapas 2 a 5 viram buscas e cliques em vez de troca de janelas — que é a diferença entre um hábito que sobrevive a uma semana corrida e outro que não.
Dez segundos na reunião economizam cinco minutos na revisão
A revisão fica muito mais curta se a informação já estiver na gravação desde o início. Um modelo não recupera o que ninguém falou, e quase tudo que deixa uma ata ambígua nunca esteve no áudio.
- Abra com a pergunta, em voz alta. "Hoje a gente decide se a migração sai antes ou depois da conferência." Uma pergunta enunciada dá ao modelo um tema principal em vez de um punhado de temas marginais — e marginais eram o caso dos 43,6%.
- Diga a decisão em uma frase, com nome e data, antes de alguém sair. "Decisão: a Mina cuida do retorno com o fornecedor, e confirmamos a data de setembro até o dia 25." Toda ferramenta do mercado captura essa frase perfeitamente. Nenhuma vai inventá-la.
- Diga a negação de forma explícita. "A gente não vai mexer na data de lançamento" é mais seguro que dar de ombros e assentir, porque negação perdida é um tipo de erro documentado — e uma negação nunca dita não tem como se perder.
- Diga o que vocês rejeitaram e por quê, em uma linha. "Consideramos cobrança por assento e descartamos porque dois clientes enterprise foram contra no trimestre passado." É essa frase que impede o mesmo debate de reabrir daqui a seis meses.
- Soletre uma vez os nomes próprios incomuns. Nomes de fornecedor, codinomes internos e siglas são exatamente o que a transcrição destrói e o resumo repete depois com toda a confiança.
- Não deixe o silêncio falar. Se a sala ficou quieta porque todo mundo está lendo um documento, diga isso. Trechos longos sem voz são a condição em que modelos de transcrição mais alucinam.
Esses hábitos tornam o registro mais preciso, especialmente quando um sistema redige as notas automaticamente.
Conclusão
Um resumo de reunião feito por IA não é um registro. É um depoimento sobre um registro, entregue com fluência, por uma testemunha que não tem nada a perder com a imprecisão e cuja tendência a descartar a palavra "provavelmente" está documentada.
Esse reenquadramento encerra a discussão manual-versus-IA, que nunca foi uma discussão de verdade. Guarde a gravação, porque é a única prova. Deixe o modelo escrever o resumo, porque ele é mais rápido que você e não se cansa no minuto quarenta. Depois gaste nove minutos na única parte que exige ter estado lá: conferir as frases seguras contra o que foi realmente dito e escrever as três linhas que alguém precisa executar.
As equipes que vão se queimar em 2026 não são as que dispensaram a ferramenta de ata com IA. São as que leram a saída dela como transcrição quando era paráfrase — e não guardaram a transcrição que teria mostrado a diferença. A versão completa do que uma boa ata precisa carregar está em as seis coisas que uma ata de reunião ainda precisa ter, e por que a taxa de erro de palavras diz quase nada sobre a utilidade de uma transcrição está em precisão não basta.
Onde a Telli.sh entra: a revisão de nove minutos só funciona se o resumo e a fonte moram no mesmo lugar. A Telli.sh mantém a transcrição com timestamps e identificação de falantes ao lado de um resumo de IA editável, então conferir uma afirmação é uma busca e um clique em vez de uma caçada entre dois sistemas — e quando a sala não fala um idioma só, a tradução fica ao lado do original em vez de substituí-lo. O resumo chega como um rascunho que você corrige, não como um resultado que você aceita.
Começar uma nota de IA ao vivo
Fontes
- Tang et al., "TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization", NAACL 2024 (arXiv:2402.13249, 20 de fevereiro de 2024)
- Koenecke et al., "Careless Whisper: Speech-to-Text Hallucination Harms", ACM FAccT 2024 (arXiv:2402.08021, 12 de fevereiro de 2024)
- Bao et al., "FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs", Vectara (arXiv:2410.13210, 17 de outubro de 2024)
- Hu et al., "MeetingBank: A Benchmark Dataset for Meeting Summarization", ACL 2023 (arXiv:2305.17529, 27 de maio de 2023)
- Wang et al., "Analyzing and Evaluating Faithfulness in Dialogue Summarization", EMNLP 2022 (arXiv:2210.11777, 21 de outubro de 2022)
- Página da imagem no Wikimedia Commons
