Personne n'a dit septembre : la relecture de neuf minutes dont tout compte rendu IA a besoin
Les travaux sur le résumé de transcriptions de réunion montrent que 30,4 % des résumés générés à partir de séances de conseils municipaux contenaient au moins une erreur factuelle, avec sept types d'erreurs identifiés derrière. Guide pratique pour relire un compte rendu IA face à sa propre transcription : quoi vérifier, dans quel ordre, et quoi dire en réunion pour que la relecture prenne neuf minutes plutôt que trente.
Le résumé faisait trois paragraphes, il était bien structuré, et il était faux dans exactement une phrase : l'équipe a convenu de livrer la migration en septembre.
Personne n'avait rien convenu. Quelqu'un avait dit que septembre serait sans doute jouable si le prestataire répondait à temps — une conditionnelle, prononcée une seule fois, au milieu d'une digression. Le modèle a supprimé la condition, promu la supposition au rang de décision, et la note est partie vers onze personnes qui n'étaient pas dans la salle. Deux d'entre elles ont commencé à planifier sur septembre.
Rien d'exotique là-dedans. C'est l'un des comportements les mieux documentés des systèmes de résumé automatique, il porte un nom dans la littérature de recherche, et il ne disparaîtra pas parce que le prochain modèle sera plus gros. Cet article vous donne trois choses : les sept manières dont un résumé s'écarte de ce qui a réellement été dit, une relecture de neuf minutes qui attrape les sept, et les quelques phrases à prononcer en réunion pour raccourcir cette relecture.
L'essentiel :
- Dans le banc d'essai TofuEval (NAACL 2024), 30,4 % des résumés générés à partir de transcriptions réelles de conseils municipaux contenaient au moins une erreur factuelle ; sur les sujets marginaux — les digressions — le chiffre montait à 43,6 %.
- Ces erreurs ne sont pas du bruit aléatoire. Les chercheurs les ont classées en sept types nommés, et les deux qui font le plus de dégâts en réunion sont l'opinion présentée comme un fait et les glissements de temps et de modalité — exactement là où « on pourrait » devient « on va ».
- Impossible de renvoyer la vérification au modèle : sur FaithBench (octobre 2024), les meilleurs détecteurs d'hallucination plafonnaient autour de 50 % de justesse, et dans TofuEval les évaluateurs LLM se faisaient battre par de plus petites métriques spécialisées.
Image : Shixart1985, Wikimedia Commons, CC BY 2.0. Les lunettes, c'est tout le sujet. Quelqu'un doit encore lire.
La captation est réglée. La vérification n'a jamais commencé.
Comptez les outils de compte rendu lancés sur Hacker News ces six derniers mois : au moins quinze entre le 1er mars et le 13 août 2026. Transcripteurs locaux, blocs-notes sans robot dans la visio, importateurs Obsidian, clones open source de Granola. Tous embarquent les deux mêmes fonctions : capter l'audio, générer le résumé.
Aucun n'embarque la troisième étape, la seule où il y a du jugement. Le résumé arrive dans votre boîte déjà mis en forme, déjà assuré, déjà envoyé à toute la salle. Ce que ce flux affirme implicitement tient en une phrase : ce livrable est terminé.
Voilà le point : un résumé généré n'est pas le compte rendu de la réunion. C'est une déclaration sur la réunion, produite par un système qui n'a aucune responsabilité quant à son exactitude, et il faut le lire comme n'importe quel témoignage de seconde main — face aux preuves dont il est issu.
Ces preuves sont heureusement juste à côté. L'outil qui a produit le résumé a aussi produit la transcription, et confronter l'un à l'autre prend moins de temps que le tour de table du début.
Le chiffre qui devrait changer votre façon de lire vos comptes rendus
TofuEval, publié par des chercheurs de Salesforce AI et leurs coauteurs à NAACL 2024, est ce qui se rapproche le plus d'une mesure contrôlée sur ce sujet. Ils ont pris deux corpus de dialogue — l'un d'entretiens journalistiques, l'autre nommé MeetingBank, constitué de transcriptions réelles de conseils municipaux américains —, fait rédiger des résumés thématiques par cinq modèles de langue, puis fait annoter chaque phrase par des linguistes professionnels pour vérifier sa cohérence factuelle avec la source.
Sur les transcriptions de réunion, en moyenne sur les cinq modèles, 30,4 % des résumés portant sur les sujets principaux contenaient au moins une incohérence factuelle, et 43,6 % pour les sujets marginaux. L'article le dit sans détour : à l'exception de GPT-3.5-Turbo, « environ 40 à 50 % de leurs résumés contiennent au moins une incohérence factuelle ».
La réserve honnête : ces cinq modèles datent de 2023 — Vicuna, trois tailles de WizardLM et GPT-3.5-Turbo — et les modèles de pointe actuels sont nettement meilleurs en fidélité factuelle. Deux résultats du même article survivent pourtant à cette objection, et ce sont ceux qui concernent votre mardi.
D'abord, la taille n'a pas réglé le problème de façon fiable. Sur les données de réunion, le taux d'erreur de WizardLM-30B n'était inférieur que de 3,8 points à celui de WizardLM-7B, alors qu'il est plus de quatre fois plus gros ; sur certaines comparaisons, le plus grand modèle d'une même famille produisait davantage d'erreurs. Ensuite, le nombre d'erreurs n'avait pas de lien significatif avec la longueur du résumé (corrélation de Pearson ρ = 0,18). Un résumé plus long et plus détaillé n'est pas un résumé plus sûr. Attendre un modèle plus gros n'est pas une procédure de relecture.
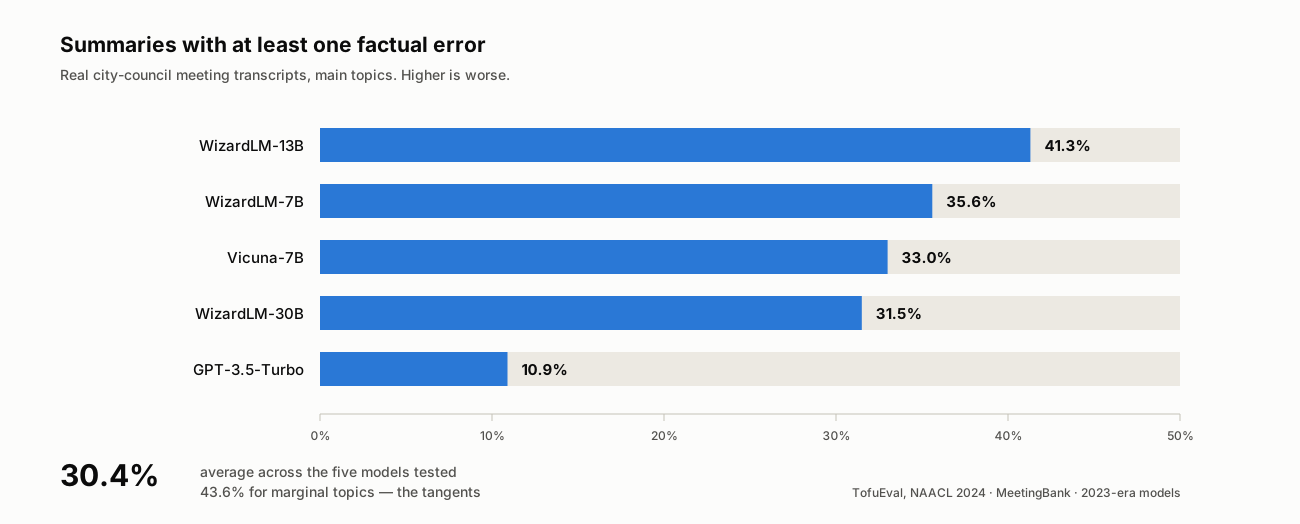
Part des résumés de transcriptions réelles de conseils municipaux contenant au moins une erreur factuelle, sujets principaux uniquement. Source : TofuEval, Tang et al., NAACL 2024 (arXiv:2402.13249). Les modèles testés datent de 2023 ; les types d'erreurs ci-dessous leur ont survécu.
Sept manières dont un résumé s'écarte de la salle
Le plus utile dans cet article n'est pas le pourcentage : c'est la typologie. Sept types d'erreurs nommés, dégagés par les annotateurs à partir de milliers de phrases signalées, en extension d'une typologie antérieure conçue pour les dialogues courts.
Lisez-les une fois et vous les verrez apparaître dans vos propres notes. Ce ne sont pas des ratés aléatoires, mais des chemins précis et répétables par lesquels la compression de la parole en prose fait disparaître une distinction sur laquelle la salle s'appuyait.
| Type d'erreur (TofuEval) | À quoi ça ressemble dans un compte rendu | Comment l'attraper |
|---|---|---|
| Information extrinsèque | Un détail présent dans le résumé et absent de l'audio — un chiffre, un nom de client, une justification que personne n'a donnée | Chercher le nom propre ou le chiffre dans la transcription ; aucun résultat signifie qu'il a été inventé |
| Mauvaise attribution | La bonne décision attribuée à la mauvaise personne, ou l'objection de l'un mise au compte de l'autre | Sauter à l'horodatage et regarder qui parle |
| Opinion présentée comme un fait | « Le changement de tarif va augmenter l'attrition » alors que quelqu'un craignait seulement que ce soit le cas | Chercher l'atténuation dans l'original : pense, craint, soupçonne |
| Erreur de raisonnement | Un calcul faux, ou un lien de cause à effet que la salle n'a jamais tracé | Refaire chaque calcul ; demander si le « parce que » a été dit ou déduit |
| Temps / aspect / modalité | « On pourrait livrer en septembre » devient « on livrera en septembre » | Confronter chaque futur au modal d'origine |
| Contradiction | Une négation perdue : « on ne décale pas l'échéance » devient « on décale l'échéance » | Chercher ne, jamais, sauf si autour de l'affirmation |
| Glissement de sens subtil | « formuler une recommandation » reformulé en « formuler une demande » | Comparer le verbe du résumé au verbe de la source |
Trois d'entre eux se reconnaissent le plus facilement sur pièce. Voici chacun avec la transcription et la phrase du résumé placées côte à côte.
Une négation perdue — erreur de contradiction. Ce qui a été dit dans la salle :
DANIEL (00:31:12): Donc on ne décale pas la date de lancement. Quoi
qu'il arrive par ailleurs, cette date tient.
Ce qu'en a fait le résumé :
L'équipe a convenu de décaler la date de lancement.
Un mot en moins, et la phrase prescrit l'action inverse. Elle est par ailleurs parfaitement grammaticale, et c'est exactement pour cela que la relecture passe à côté alors qu'une recherche de « ne » autour de la décision la trouve en quatre secondes.
Une mauvaise attribution — erreur de référence. Ce qui a été dit dans la salle :
PRIYA (00:18:40): Moi je suis contre la tarification par siège. Deux
clients grands comptes nous ont dit le trimestre dernier que ça tue
l'affaire.
MINA (00:18:55): Oui, d'accord.
Ce qu'en a fait le résumé :
Mina s'est opposée à la tarification par siège, en s'appuyant sur les
retours de clients grands comptes.
Chaque fait de cette phrase figure dans la transcription. La personne, non. Toute la difficulté est là : vous ne pouvez pas repérer cela en demandant si les affirmations sont vraies, seulement en demandant si elles appartiennent à la personne à qui on les a attribuées.
Une hypothèse promue — erreur de modalité. Ce qui a été dit dans la salle :
SAM (00:44:02): Septembre est sans doute jouable, si le prestataire
nous répond à temps.
Ce qu'en a fait le résumé :
L'équipe a convenu de livrer la migration en septembre.
Deux qualificateurs supprimés — le « sans doute » et toute la proposition conditionnelle — et une hypothèse partagée est devenue un engagement daté. Personne n'a eu besoin de mentir pour cela. C'est la compression qui l'a fait.
Deux de ces types méritent une attention particulière, parce que ce sont ceux qui coûtent de l'argent aux équipes.
L'opinion présentée comme un fait, c'est l'incident de septembre en ouverture de cet article. En réunion, la plupart des phrases sont atténuées : les gens pensent à voix haute, et l'atténuation porte tout le sens. Les modèles de résumé retirent les atténuations par construction, puisque c'est la première chose qu'on coupe en compressant. Le résultat se lit plus tranché que ne l'était la salle, et c'est précisément pour cela qu'il n'est pas remis en question.
Les glissements de modalité font les mêmes dégâts sur les dates. « Pourrait », « devrait », « probablement », « si le prestataire nous répond » : c'est la frontière entre un plan et un engagement, et ce sont aussi les mots les moins coûteux à supprimer. Un résumé qui dit que l'équipe fera quelque chose en septembre vient de fabriquer discrètement une échéance dont personne n'est responsable.
Notez ce que les deux ont en commun. Le modèle n'a pas inventé des faits à partir de rien : il a retiré des qualificateurs. C'est la modification la moins visible qu'il puisse faire, et celle qu'aucun lecteur ne peut détecter sans la source sous les yeux.
L'invention se produit dans les digressions
Les données contiennent un second motif, qui recouvre exactement la façon dont les réunions se déroulent.
Les résumés de sujets marginaux — ceux évoqués en passant plutôt que discutés à fond — étaient nettement moins bons : 43,6 % contre 30,4 % sur le corpus de réunions. Les chercheurs expliquent le mécanisme : quand un sujet est à peine couvert dans la source, les modèles « s'appuient sur leurs connaissances pour formuler des inférences à son propos, faisant entrer dans le résumé des informations non étayées ». Les zones où la preuve est mince sont comblées par de la culture générale, et ce remplissage est indiscernable, au ton, des parties réellement ancrées.
Vos réunions sont pleines de sujets marginaux : les deux minutes sur la revue de sécurité, le prestataire cité une seule fois, le chiffre dont quelqu'un se souvient à moitié. Ces lignes sont les moins discutées et les plus susceptibles d'être fausses, et elles se lisent aussi bien que le reste.
La couche du dessous a la même forme. Dans « Careless Whisper », présenté à ACM FAccT 2024, Koenecke et ses collègues ont trouvé qu'environ 1 % des transcriptions de Whisper contenaient des phrases entières hallucinées n'existant sous aucune forme dans l'audio d'origine, et que 38 % de ces hallucinations comportaient des préjudices explicites : associations inventées, autorité fictive, violence fabriquée. Le déclencheur est la partie intéressante : les hallucinations touchaient de façon disproportionnée les locuteurs présentant de longues plages non vocales.
Le silence, autrement dit. Or une réunion est faite de silence : les pauses pour réfléchir, quelqu'un qui coupe son micro, un partage d'écran qui charge, les quatre secondes après une question difficile. C'est exactement la matière que le modèle de transcription est le plus susceptible de combler par quelque chose qui n'a jamais été dit. Cela signifie aussi que les erreurs de transcription et de résumé ne sont pas indépendantes : une ligne inventée dans la transcription est, pour le résumé, une entrée parfaitement étayée.
On ne peut pas renvoyer la vérification au modèle
L'idée évidente serait de faire vérifier le premier modèle par un second. Les mesures ne sont pas encourageantes.
Dans la même étude TofuEval, les auteurs ont évalué des LLM comme juges binaires de cohérence factuelle et ont constaté que tous, GPT-4 compris, « détectent mal les erreurs dans les résumés générés par des LLM » — et se faisaient dépasser par de plus petites métriques de factualité non-LLM conçues pour la tâche. Même lorsque GPT-4 signalait correctement une phrase, son explication du pourquoi n'était juste que dans environ 80 % des cas ; pour les autres évaluateurs, environ la moitié.
FaithBench, publié par Vectara en octobre 2024, a chiffré ce plafond. Le banc d'essai a rassemblé les hallucinations produites par dix LLM modernes issus de huit familles et sur lesquelles les détecteurs existants divergeaient — et rapporte que même les meilleurs détecteurs d'hallucination atteignaient une justesse proche de 50 %. Un tirage à pile ou face, sur les cas qui comptent.
La relecture vous revient donc. Cela sonne comme une charge, jusqu'à ce qu'on remarque l'asymétrie : le détecteur doit juger un texte quelconque face à un document inconnu, alors que vous, vous étiez dans la salle. Vous savez déjà quelle affirmation semblait bizarre. Il ne reste qu'à la vérifier.
Trois artefacts, trois métiers différents
La plupart des débats « notes IA contre vraies notes » sont une erreur de catégorie. Une réunion produit trois artefacts, ils ne se remplacent pas, et une équipe qui n'en garde qu'un perd toujours quelque chose de précis.
| Transcription brute | Résumé IA | Journal des décisions | |
|---|---|---|---|
| Formulation exacte conservée | Oui — mot à mot | Non — compressée, atténuations supprimées | Non |
| Qui l'a dit | Oui, si les locuteurs sont séparés | Parfois ; la mauvaise attribution est un type d'erreur nommé | Oui — le responsable est le sujet même |
| Quand ça a été dit | Oui — horodaté | Rarement | Seulement l'échéance |
| Décisions avec responsable et date | Enfouies dans environ 9 000 mots | Partiellement, et sans fiabilité | Oui — c'est sa seule fonction |
| Ce qui a été écarté, et pourquoi | Oui, si quelqu'un l'a dit | Souvent supprimé comme redondant | Oui, en une ligne |
| Lisible en 60 secondes | Non | Oui | Oui |
| Vérifiable face aux preuves | C'est la preuve | Seulement si la transcription survit | Seulement si les deux survivent |
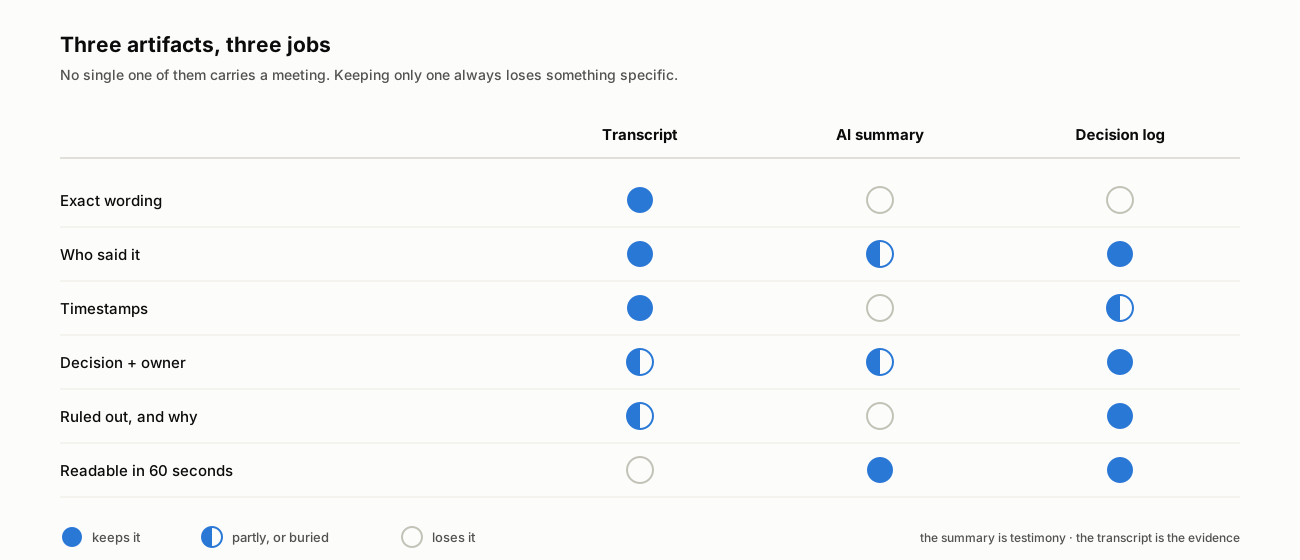
Ce que chaque artefact conserve, conserve à moitié, ou perd. La dernière ligne décide si les deux autres valent quelque chose.
Cette dernière ligne, c'est tout l'argument. Un résumé sans transcription conservée est infalsifiable : quand un collègue dit « ce n'est pas ce qu'on avait décidé », vous avez deux opinions et aucun enregistrement. C'est précisément là qu'une note IA est plus fragile qu'une note humaine : un compte rendu écrit par une personne portait sa faillibilité de façon visible, et chacun le lisait avec la méfiance appropriée. La prose de machine arrive en titres nets et en affirmations assurées, et emprunte une autorité qu'elle n'a pas gagnée.
Appelons les choses par leur nom : le résumé est un témoignage, la transcription est la preuve. Un témoignage, c'est utile. Un témoignage, c'est aussi ce qu'on vérifie.
La relecture de neuf minutes, dans l'ordre
Voici la procédure que nous recommandons, calibrée pour une réunion de 60 minutes. L'ordre compte : il place en premier les vérifications dont l'erreur coûte le plus cher, de sorte que si l'on vous interrompt à la quatrième minute, les erreurs coûteuses sont déjà attrapées.
- 0:00–1:30 — Ne lire que les phrases de décision. Ignorez complètement le résumé narratif au premier passage. Cherchez chaque phrase qui affirme un résultat, un engagement ou une date. Dans une réunion d'une heure, il y en a trois à six. Ce sont les seules lignes sur lesquelles quelqu'un agira.
- 1:30–3:00 — Restaurer la modalité. Pour chacune de ces phrases, sautez au passage correspondant de la transcription et vérifiez le verbe. A-t-on dit va, ou pourrait, devrait, probablement ? Si l'original était atténué, réécrivez la ligne en remettant l'atténuation — ou mieux, marquez-la comme question ouverte avec un responsable.
- 3:00–4:30 — Vérifier chaque nom propre et chaque chiffre. Noms, entreprises, versions, prix, dates, pourcentages. Cherchez-les un par un dans la transcription. Ce qui n'y figure pas est une information extrinsèque : supprimez-la ou confirmez-la hors réunion. C'est du travail de champ de recherche, pas de lecture.
- 4:30–5:30 — Vérifier l'attribution. Pour chaque décision et chaque objection, confirmez qui parle à cet horodatage. La mauvaise attribution est l'erreur la plus susceptible de créer un problème humain plutôt qu'un problème de planning, et c'est la plus rapide à vérifier.
- 5:30–6:30 — Chasser les négations perdues. Cherchez dans la transcription ne, jamais, pas, sauf si et au lieu de autour de chaque décision. Une erreur de contradiction inverse le sens en laissant la phrase parfaitement grammaticale : la relecture ne la trouve pas, la recherche si.
- 6:30–8:00 — Demander ce qui manque. Aucune machine ne fera cette étape à votre place, car un résumé ne peut pas signaler ses propres omissions. Deux questions : qu'avons-nous écarté, et pourquoi ? Et à quelle question n'avons-nous pas répondu ? Ni l'une ni l'autre ne survit à la compression, et ce sont elles qui rendront la note utile dans six mois.
- 8:00–9:00 — Écrire le journal des décisions et l'envoyer. Trois à six lignes, chacune portant ce qui a été décidé, qui prend la suite et pour quand. Reliez-le à la transcription. C'est ce lien qui rend toute la relecture revérifiable par quelqu'un d'autre.
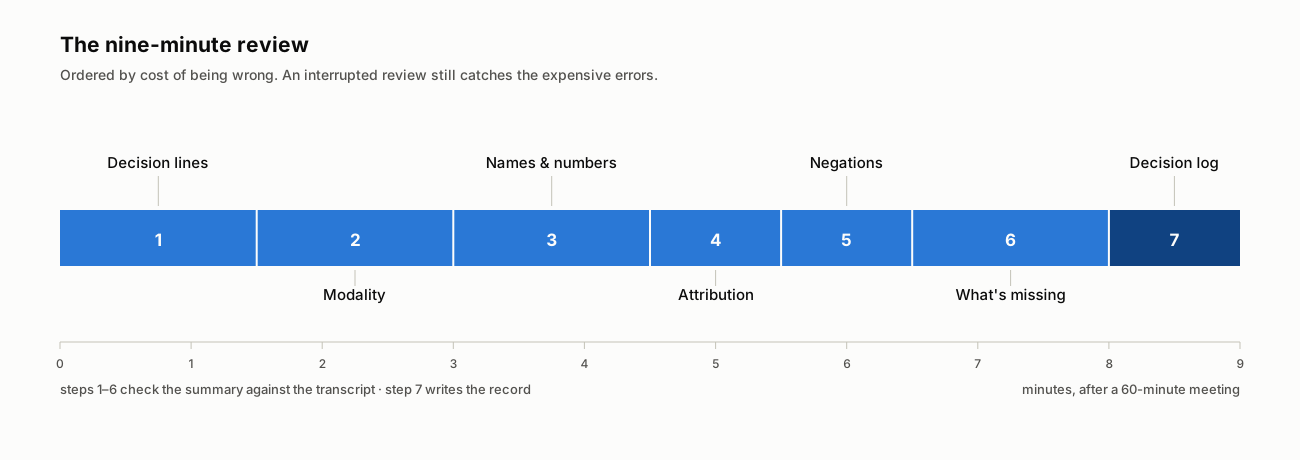
L'ordre est la conception : modalité et détails inventés d'abord, omissions en dernier. Une relecture interrompue attrape quand même les erreurs coûteuses.
Deux remarques pour tenir la cadence. Si la réunion durait 30 minutes, c'est un travail de quatre minutes. Et si vous le faites dans l'outil qui contient à la fois le résumé et la transcription horodatée, les étapes 2 à 5 deviennent des recherches et des clics plutôt que des allers-retours entre fenêtres — c'est la différence entre une habitude qui survit à une semaine chargée et une qui n'y survit pas.
Dix secondes en réunion économisent cinq minutes de relecture
La relecture raccourcit énormément si l'information se trouve dès le départ dans l'enregistrement. Un modèle ne peut pas restituer ce que personne n'a dit, et l'essentiel de ce qui rend une note ambiguë n'a jamais été dans l'audio.
- Ouvrez avec la question, à voix haute. « Aujourd'hui on décide si la migration sort avant ou après la conférence. » Une question énoncée donne au modèle un sujet principal plutôt qu'un ensemble de sujets marginaux — et les sujets marginaux, c'était le cas à 43,6 %.
- Dites la décision en une phrase, avec un nom et une date, avant que quiconque parte. « Décision : Mina prend la relance du prestataire, et on confirme la date de septembre d'ici le 25. » Tous les outils du marché captent parfaitement cette phrase. Aucun ne l'inventera.
- Énoncez la négation explicitement. « On ne décale pas la date de lancement » est plus sûr qu'un haussement d'épaules et un hochement de tête, car une négation perdue est un type d'erreur documenté, et une négation jamais prononcée ne peut pas être perdue.
- Nommez ce que vous avez écarté et pourquoi, en une ligne. « On a envisagé la tarification par siège et on l'a écartée parce que deux clients grands comptes s'y sont opposés le trimestre dernier. » C'est la phrase qui empêche le même débat de rouvrir dans six mois.
- Épelez une fois les noms propres inhabituels. Noms de prestataires, noms de code internes et acronymes sont exactement ce qu'une transcription écorche et qu'un résumé répète ensuite avec assurance.
- Ne laissez pas le silence parler. Si la salle se tait parce que tout le monde lit un document, dites-le. Les longues plages non vocales sont la condition dans laquelle les modèles de transcription hallucinent le plus.
Rien de tout cela n'est du théâtre de réunion. C'est dicter au compte rendu — une compétence qui a pris plus de valeur depuis que le compte rendu s'écrit tout seul.
En résumé
Un résumé de réunion produit par une IA n'est pas un compte rendu. C'est un témoignage sur un compte rendu, livré avec aisance, par un témoin qui n'a aucun intérêt à l'exactitude et dont la tendance à laisser tomber le mot « probablement » est documentée.
Ce recadrage règle le débat manuel-contre-IA, qui n'en a jamais été un. Gardez l'enregistrement, c'est la seule preuve. Laissez le modèle écrire le résumé, il est plus rapide que vous et ne se lasse jamais à la quarantième minute. Puis consacrez neuf minutes à la seule partie qui exige d'avoir été là : confronter les phrases assurées à ce qui a réellement été dit, et écrire les trois lignes sur lesquelles quelqu'un doit agir.
Les équipes qui se brûleront en 2026 ne sont pas celles qui ont fait l'impasse sur l'outil de prise de notes. Ce sont celles qui ont lu sa sortie comme une transcription alors que c'était une paraphrase — et qui n'ont pas gardé la transcription qui aurait montré la différence. Pour la version complète de ce qu'une bonne note doit porter, nous avons écrit les six choses qu'un compte rendu doit encore contenir, et sur les raisons pour lesquelles le taux d'erreur sur les mots ne dit presque rien de l'utilisabilité d'une transcription, la précision ne suffit pas.
Ce que fait Telli.sh : la relecture de neuf minutes ne fonctionne que si le résumé et la source vivent au même endroit. Telli.sh garde la transcription horodatée avec attribution des locuteurs à côté d'un résumé IA modifiable, si bien que vérifier une affirmation devient une recherche et un clic plutôt qu'une fouille dans deux systèmes — et quand la salle ne parle pas une seule langue, la traduction se place à côté de l'original au lieu de le remplacer. Le résumé arrive comme un brouillon que vous corrigez, pas comme un livrable que vous acceptez.
Démarrer une note IA en direct
Sources
- Tang et al., « TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization », NAACL 2024 (arXiv:2402.13249, 20 février 2024)
- Koenecke et al., « Careless Whisper: Speech-to-Text Hallucination Harms », ACM FAccT 2024 (arXiv:2402.08021, 12 février 2024)
- Bao et al., « FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs », Vectara (arXiv:2410.13210, 17 octobre 2024)
- Hu et al., « MeetingBank: A Benchmark Dataset for Meeting Summarization », ACL 2023 (arXiv:2305.17529, 27 mai 2023)
- Wang et al., « Analyzing and Evaluating Faithfulness in Dialogue Summarization », EMNLP 2022 (arXiv:2210.11777, 21 octobre 2022)
- Page de l'image sur Wikimedia Commons
