Czy wspólny laptop może przeczytać lekcję w języku twi bez internetu?
Africa TTS 0.5.0 ma domyślne głosy dla 92 języków afrykańskich oraz angielskiego. Oto co sprawdzić w pilotażu syntezy mowy offline.
Wyobraź sobie lokalny ośrodek edukacyjny ze wspólnym laptopem i przerywanym dostępem do internetu. Nauczycielka ma krótkie ćwiczenie z czytania w języku twi. Chce, żeby uczniowie usłyszeli je dwa razy, przed udzieleniem odpowiedzi i podczas ich sprawdzania. Oczywistym rozwiązaniem jest nagranie. Synteza mowy przydaje się, kiedy tekst często się zmienia, potrzebne są różne wersje ćwiczenia albo zatwierdzone nagranie jeszcze nie powstało.
8 listopada 2026 r. AfriSpeech opublikował Africa TTS 0.5.0. Według opisu wydania pakiet generuje mowę z tekstu w 92 językach afrykańskich i po angielsku, z domyślnym głosem dla każdego języka. Działa na CPU, a po pobraniu modelu do pamięci podręcznej umożliwia syntezę offline. Opiekunowie projektu udostępniają demonstrację internetową i próbki audio. Można ich posłuchać przed poświęceniem czasu na instalację. Wydanie w PyPI · Oficjalne próbki audio
Dla ośrodka pytanie jest konkretniejsze niż liczba języków. Czy słuchacze rozpoznają słowa i zrozumieją materiał na wspólnym laptopie we własnej odmianie języka? Potrzebny jest odsłuch i próba na urządzeniu. Oba będą użyteczniejsze, jeśli zaczną się od rzeczywistych zdań używanych w ośrodku.
Zdjęcie kontekstowe ze studia radiowego w Ghanie, wykonane w 2017 r. Fotografia Joy Agyepong, przeskalowana na licencji CC BY-SA 4.0. Oryginalne zdjęcie

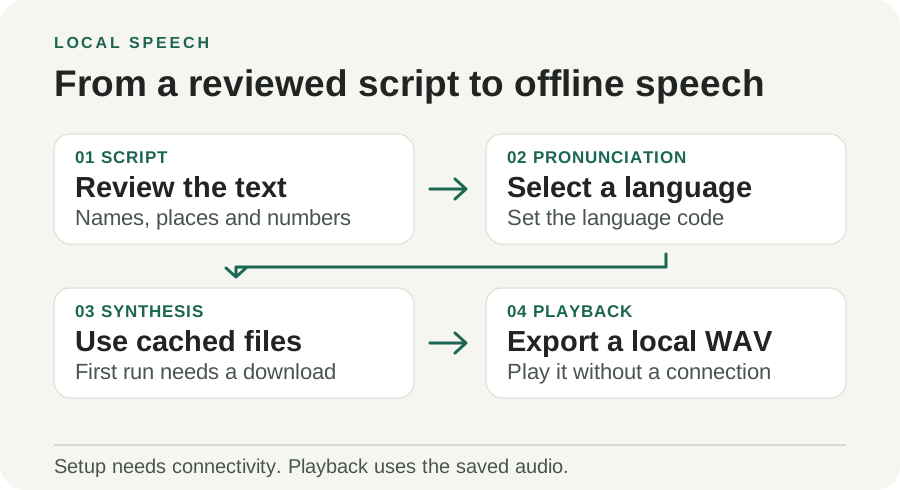
Autorska ilustracja Telli.sh. Model pobiera się podczas konfiguracji. Po zapisaniu wymaganych plików odsłuch może pozostać na urządzeniu.
Domyślny głos ułatwia przygotowanie pierwszej lekcji
Wydanie daje prosty sposób na początek. Podaj napisane zdanie i trzyliterowy kod ISO, taki jak twi dla twi, swh dla suahili albo yor dla joruba. Pakiet użyje domyślnego głosu i zapisze mowę w pliku audio. Nauczyciel może dodać plik do lekcji offline lub odtworzyć go bezpośrednio, zostawiając tekst do porównania.
Tekst wejściowy powinien już być w języku, który odbiorcy mają usłyszeć. Komunikat w suahili wymaga tekstu w suahili. Jeżeli powstał w innym języku, tłumaczenie i sprawdzenie przez rodzimego użytkownika języka są odrębnymi krokami. Przekaż tłumaczowi nazwy miejsc, jednostki i daty używane przez odbiorców. Umieść sprawdzony tekst obok nagrania, żeby dało się ustalić, skąd wzięło się nieporozumienie.
Zacznij od materiału, w którym można wprowadzać małe poprawki. Nauczycielka może przygotować kilka fragmentów o podobnej trudności i poprosić dwie osoby mówiące w tym języku o odsłuch bez tekstu. Ośrodek szkoleniowy może przygotować dźwiękowy odpowiednik instrukcji i sprawdzić, czy uczestnicy rozumieją kolejność kroków. W obu przypadkach pracownik może nagrać krótką poprawkę, gdy głos syntetyczny źle wypowiada nazwę lub rzadki zwrot.
Kolejny przykład to krótki komunikat publiczny. Ośrodek zmienia godzinę warsztatów i udostępnia wydruk oraz nagranie w lokalnym kiosku. Poproś osobę mówiącą w danym języku o sprawdzenie godziny przed zastąpieniem wczorajszego pliku. Jeśli głos dobrze czyta resztę, ale godzinę można źle zrozumieć, nagraj ponownie to zdanie i zostaw widoczną wersję pisaną. Poprawna godzina ma większą wartość niż wygoda wygenerowania całego pliku naraz.
Zdecyduj, jak aktualizować audio, zanim trafi na wspólne urządzenie. Można zachować nadrzędny plik tekstowy z datą i językiem obok zatwierdzonego WAV. Po zmianie lekcji poprzedni plik jest dostępny, aż słuchacz zatwierdzi nowy. Bez internetu dwie nieaktualne kopie mogą brzmieć równie przekonująco. Krótkie oznaczenie wersji w lekcji pozwoli nauczycielowi sprawdzić, co zostanie odtworzone, bez otwierania folderu produkcyjnego.
Wymowa zaczyna się przed modelem mowy
Dokumentacja AfriSpeech opisuje sześciowarstwowy model ucznia ze 110 mln parametrów łącznie z kodekiem audio. Powstał przez destylację z 24-warstwowego modelu bazowego. Podczas treningu mniejszy model uczył się odtwarzać wynik sterowanego generowania większego. To jeden z powodów, dla których pakiet może działać na CPU. Na wspólnym komputerze liczy się czas przygotowania użytecznego pliku, gdy jednocześnie działa lekcja. Szczegóły modelu
Model otrzymuje zapis w międzynarodowym alfabecie fonetycznym IPA z procesora tekstu dostosowanego do języka. Procesor mapuje tekst na jednostki dźwiękowe oczekiwane przez model. W obsługiwanych językach afrykańskich projekt używa konwertera Africa G2P, a dla angielskiego dokumentuje eSpeak NG. To wyjaśnia, czemu nietypowa pisownia, zapożyczenie albo nazwa mogą sprawić kłopot mimo płynnego brzmienia. Błąd przed etapem akustycznym może dać modelowi naturalny sposób wypowiedzenia niewłaściwego słowa. Model i przygotowanie wymowy
Opiekunowie zalecają zapisywanie liczb słownie. Użyj konwencji odbiorców. Przetestuj formy spotykane w materiałach, w tym daty, godziny, zakresy, skróty i ilości. Jeśli zapis różni się od wersji dostosowanej do wymowy, trzymaj oba osobno. Zapis pozostanie przydatny na ekranie, a skrypt syntezy zachowa ślad poprawek.
Teksty zmieniające język w środku zdania wymagają osobnej próby. Dokumentacja pozwala wybrać język, więc warto sprawdzić nazwy i cytaty w tekście, który poza tym jest jednojęzyczny. Gdy pojedyncze uruchomienie daje zaskakujący wynik, przygotuj treść w oddzielnych sprawdzonych fragmentach. Jest to szczególnie przydatne w edukacji, kiedy obcy termin trzeba zachować i wypowiadać spójnie w kolejnych lekcjach.
Dane treningowe dają punkt wyjścia
Karta modelu podaje 897 godzin mowy w danych treningowych. Tabela według języka podaje około 322,6 godziny angielskiego, 27,0 suahili, 24,0 twi i 15,3 joruba. Godziny opisują zbiór danych. Nie określają lokalnej odmiany używanej w klasie, częstości danego zwrotu w treningu ani tego, czy ktoś rozpozna konkretną syntetycznie wypowiedzianą nazwę. Karta modelu i tabela języków
Wydanie opisuje też eksperymentalną listę 657 języków, dla których nie prowadzono treningu. Można próbować je czytać z użyciem najbliższego języka z zestawu treningowego. Traktuj tę metodę jako osobną ścieżkę badawczą. Język z głównego wykazu i język obsługiwany zastępczo mają różne podstawy. W pilotażu dla osób zależnych od audio zacznij od głównej listy i zdecyduj, czy wariant eksperymentalny ma dość weryfikacji przez rodzimych użytkowników. Uwagi o językach eksperymentalnych
Opiekunowie podają dwa wyniki warte kontekstu. Po pierwsze, na chmurowej maszynie z czterema vCPU generowanie było 2,4 raza szybsze od czasu rzeczywistego. Po drugie, opisują test na wydzielonych danych, w którym Omnilingual ASR transkrybował syntezę. Africa TTS wyprzedził MMS-TTS dla 21 z 27 języków objętych porównaniem. Obie wartości pochodzą od projektu. W sali lekcyjnej zmieniają się akcenty, urządzenia, hałas i osoby mówiące. Wynik transkrypcji jest przybliżeniem zrozumiałości. Dla lekcji liczy się to, jak słuchacz rozumie zdanie. Wyniki wydania · Metody ewaluacji
| Próba | Co mierzyć na urządzeniu pilotażowym | Dlaczego to ważne |
|---|---|---|
| Pierwsze uruchomienie | Czas konfiguracji, rozmiar pobrania i miejsce po zapełnieniu pamięci podręcznej | Wspólny laptop może mieć mało miejsca lub wolne łącze |
| Generowanie z pamięci podręcznej | Czas od żądania do gotowego WAV przy otwartej lekcji | Aplikacja w tle może zmieniać odczuwaną szybkość CPU |
| Kluczowe fakty | Czy słuchacze poprawnie powtarzają nazwy, godziny, liczby i polecenia | Fragment może brzmieć naturalnie mimo jednego ważnego błędu |
| Odmiana lokalna | Ocena rodzimych użytkowników dla przewidzianych zwrotów i akcentów | Jeden kod języka może obejmować wiele sposobów mówienia |
| Postępowanie po awarii | Czy lekcja działa z tekstem lub nagraniem pracownika | Model lub urządzenie audio mogą zawieść w dniu zajęć |
Skonfiguruj pracę offline raz i sprawdź ją bez połączenia
- Wybierz krótki sprawdzony fragment. Napisz powitanie, typowe ćwiczenie i fragment z nazwami lub liczbami. Przed syntezą poproś osobę mówiącą w języku o potwierdzenie zapisu i sformułowań.
- Utwórz izolowane środowisko Pythona. Wydanie 0.5.0 wymaga Pythona od 3.10 do 3.14. Włącz środowisko wirtualne odpowiednie dla systemu i zainstaluj wskazane wydanie.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- Zaplanuj pierwsze pobranie modelu. Dokumentacja wersji podaje około 440 MB dla modelu domyślnego. Pobierz go w zatwierdzonej sieci podczas konfiguracji albo uruchom syntezę i potwierdź pobranie po wyświetleniu komunikatu. Jeśli pilotaż obejmuje angielski, zainstaluj eSpeak NG zgodnie z dokumentacją. Sprawdź instrukcję przed zmianą platformy lub silnika.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- Powtórz próbę przy wyłączonej sieci. Użyj tego samego konta i tej samej lokalizacji pamięci podręcznej co na lekcji. Utwórz nowy WAV, otwórz go na docelowym urządzeniu i zapisz czas generowania oddzielnie od długości odtwarzania.
- Poproś o odsłuch przed czytaniem. Odtwórz końcowe nagrania z docelową głośnością i poproś dwie osoby o powtórzenie istotnych faktów. Zachowaj wersję tekstu, wersję modelu i uwagi. Jeżeli ktoś źle zrozumie informację, popraw tekst albo zastąp nagranie i powtórz sprawdzenie.
Procedura przyda się także zespołom zainteresowanym Androidem. AfriSpeech dokumentuje pakiet sherpa-onnx z procesorem tekstu w C i warstwą dla Androida. Osobno sprawdź kompilację na telefon, bo pakiet mobilny i domyślne środowisko komputerowe używają innych silników. Porównaj zimny start, zajęte miejsce, jakość audio i pracę na baterii na reprezentatywnych urządzeniach i całych fragmentach. Działające polecenie na komputerze potwierdza dopasowanie do jednego środowiska. Telefon wymaga własnej próby. Dokumentacja uruchamiania na urządzeniu
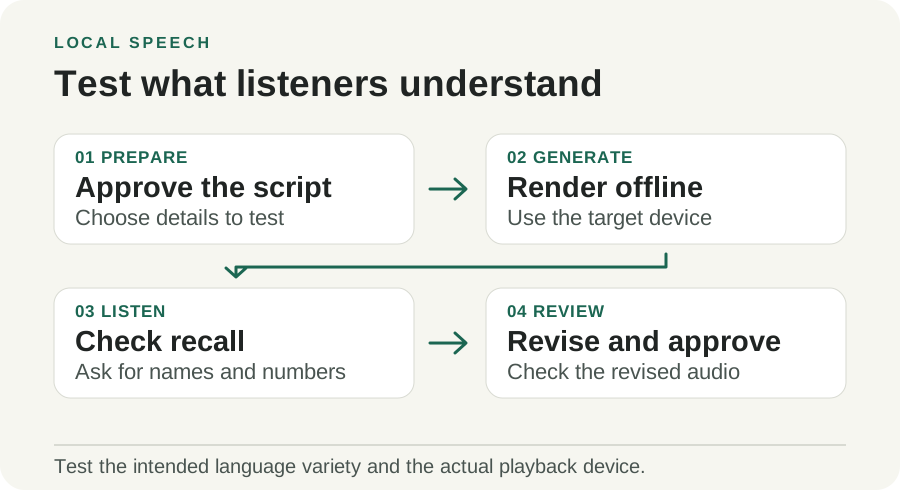
Autorska ilustracja Telli.sh. Poproś słuchaczy o powtórzenie ważnych faktów przed lekturą tekstu. Mogą wykryć problemy wymowy, które przeoczy korektor.
Sprawdź licencję głosu obok licencji kodu
Kod pakietu Pythona jest na licencji MIT. Według opisu wydania 0.5.0 model i domyślne głosy korzystają z CC BY-NC 4.0. Zależność eSpeak NG dla angielskiego ma własne warunki GPL. Sprawdź każdy składnik osobno, planując dystrybucję narzędzia, głosów lub usługi. Publicznie dostępny plik może być łatwy do wypróbowania, a niektóre zastosowania komercyjne mogą wymagać innego modelu lub zgody. Licencje wydania · Warunki CC BY-NC 4.0
Pakiet może też używać dostarczonej próbki głosu. Domyślny głos upraszcza próbę w szkole, bo nie trzeba zbierać nagrania wzorcowego konkretnej osoby. Jeśli potrzebujesz określonego głosu, uzyskaj zgodę osoby na planowane użycie i uzgodnij miejsce przechowywania próbki oraz plików. Ośrodek może ominąć ten wybór, nagrywając poprawki głosem pracownika za jego zgodą i używając modelu domyślnego do wariantów ćwiczeń.
Synteza offline może pomóc zachować teksty i głosy na własnym urządzeniu. Demonstracja internetowa to inna ścieżka. Wysłanie tekstu lub próbki głosu do usługi w sieci wymaga osobnej decyzji o udostępnianiu danych. Do demonstracji użyj publicznego zdania. Materiały objęte zasadami szkoły lub organizacji przetwarzaj lokalnie.
O powodzeniu decyduje słuchacz
Africa TTS pozwala przygotować pierwszą wersję audio dla osób, które rzadko widzą swój język w narzędziu mowy. Użyteczna próba powinna być na tyle mała, żeby można ją było sprawdzić ze słuchu. Weź fragment, który ludzie naprawdę usłyszą, wygeneruj go z wyłączoną siecią i poproś o powtórzenie ważnego szczegółu. Odpowiedź mówi więcej o pilotażu niż liczba pozycji w menu języków.
Źródła
- Wydanie Africa TTS 0.5.0 z 8 listopada 2026 r.
- Karta modelu AfriSpeech i zakres treningu
- Metody ewaluacji AfriSpeech
- Publiczne próbki audio AfriSpeech
- Licencja CC BY-NC 4.0
- Zdjęcie studia radiowego w Ghanie autorstwa Joy Agyepong, CC BY-SA 4.0
Aby zachować rozmowy i decyzje w archiwum z wyszukiwaniem, utwórz konto Telli.sh.