공용 노트북에서 인터넷 없이 트위어 교재를 읽어줄 수 있을까?
Africa TTS 0.5.0은 아프리카 언어 92개와 영어에 기본 음성을 제공한다. 실제 수업에 쓸 오프라인 음성이라면 무엇을 확인해야 할까?
공용 노트북 한 대를 쓰는 지역 학습센터에서 인터넷이 간헐적으로 끊긴다고 하자. 교사는 트위어 읽기 지문을 두 번 들려주고 싶다. 처음에는 문제를 풀기 전, 두 번째는 답을 확인하는 동안이다. 녹음이 가장 먼저 떠오르는 방법이다. 대본이 자주 바뀌거나 연습 문제를 여러 버전으로 만들고 싶거나, 검토한 녹음본이 아직 없을 때는 음성 합성 도구가 도움이 된다.
AfriSpeech는 2026년 11월 8일 Africa TTS 0.5.0을 공개했다. 릴리스 설명에 따르면 아프리카 언어 92개와 영어의 텍스트를 음성으로 변환하며 언어마다 기본 음성이 있다. CPU에서 실행되고 모델 파일을 받아 캐시에 저장하면 오프라인에서 합성할 수 있다. 개발팀은 온라인 데모와 음성 예시를 제공한다. 설치에 시간을 쓰기 전에 관심 언어의 음성을 들어볼 수 있다. 버전이 명시된 PyPI 릴리스 · 공식 청취 예시
학습센터에 중요한 질문은 언어 수보다 구체적이다. 학습자가 평소 쓰는 말의 변이에서도 의도한 단어를 알아듣고 공용 노트북으로 수업을 따라올 수 있을까? 기기와 청취를 각각 점검해야 한다. 센터에서 실제로 쓰는 문장으로 시작하면 두 시험 모두 도움이 된다.
2017년 촬영한 가나 라디오 녹음실 참고 사진. Joy Agyepong 촬영, CC BY-SA 4.0에 따라 크기를 조정했다. 원본 사진

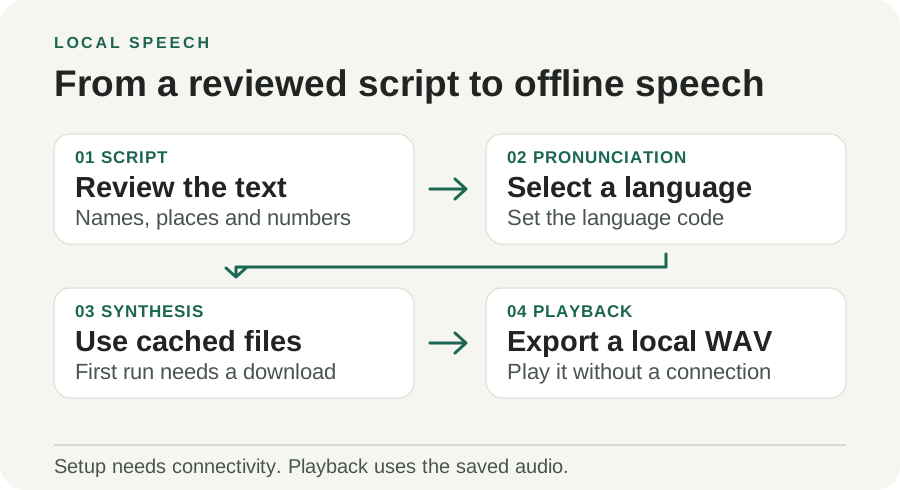
Telli.sh 제작 도해. 설치할 때 모델을 내려받고 필요한 파일을 캐시에 둔 뒤에는 기기 안에서 음성을 만들고 들을 수 있다.
기본 음성이 첫 수업 준비를 덜어준다
이번 버전에는 처음 쓰는 사람을 위한 간단한 경로가 있다. 문장과 세 글자 ISO 언어 코드를 입력한다. 트위어는 twi, 스와힐리어는 swh, 요루바어는 yor다. 패키지가 기본 음성으로 읽고 오디오 파일을 저장한다. 교사는 파일을 오프라인 수업에 넣거나 바로 재생하고, 필요할 때 대본과 대조할 수 있다.
텍스트는 청취자가 들을 언어로 미리 작성해야 한다. 스와힐리어 공지에는 스와힐리어 대본이 필요하다. 다른 언어에서 시작했다면 번역과 원어민 검토를 따로 한다. 청중이 쓰는 지명, 단위, 날짜 표기를 번역자에게 알려준다. 검토한 대본을 음성 옆에 두면 어디에서 오해가 생겼는지 찾기 쉽다.
작게 수정해도 되는 자료부터 시작한다. 교사는 비슷한 난도의 지문을 몇 개 만들고 두 화자에게 텍스트를 보지 않고 들어달라고 할 수 있다. 교육센터는 서면 지침에 덧붙일 음성을 만들고 참석자가 절차 순서를 이해하는지 확인할 수 있다. 합성 음성이 이름이나 드문 표현을 제대로 읽지 못하면 담당자가 그 부분을 짧게 녹음해 보완할 수 있다.
짧은 공지도 알맞은 작업이다. 센터가 워크숍 시간을 바꾸고 인쇄 안내와 함께 현장 키오스크에 음성을 제공한다고 하자. 전날 파일을 교체하기 전에 화자에게 바뀐 시간을 제대로 들었는지 확인한다. 나머지는 잘 읽지만 시간만 모호하면 그 문장을 다시 녹음하고 서면 안내를 계속 볼 수 있게 한다. 한 번에 파일을 생성하는 편의보다 정확한 공지가 중요하다.
공용 기기에 넣기 전에 업데이트 방법을 정한다. 날짜와 언어가 적힌 원본 텍스트를 승인된 WAV와 나란히 보관할 수 있다. 직원이 수업을 바꿔도 새 버전을 청취자가 확인할 때까지 이전 파일을 남겨둔다. 연결이 없는 기기에서는 오래된 두 파일도 모두 그럴듯하게 들린다. 수업 화면에 짧은 버전 표시를 두면 교사가 작업 폴더를 열지 않고 재생본을 알아볼 수 있다.
발음은 음성 모델 이전 단계에서 시작한다
AfriSpeech 문서에 따르면 학생 모델은 오디오 코덱을 포함해 1억 1,000만 매개변수를 가진 6층 모델이다. 24층 기반 모델에서 증류했다. 학습 과정에서 큰 모델이 유도 조건에 따라 만든 결과를 작은 모델이 근사하도록 했다. CPU 실행을 목표로 할 수 있었던 이유 중 하나다. 공용 컴퓨터에서는 수업 앱도 켜진 상태에서 쓸 만한 파일을 만드는 데 얼마나 걸리는지가 중요하다. 모델 상세 정보
모델은 언어별 텍스트 처리기를 거쳐 국제음성기호 IPA를 받는다. 처리기가 적힌 문장을 음성 모델이 기대하는 소리 단위로 바꾼다. 지원하는 아프리카 언어에는 Africa G2P 변환기를 쓰고 영어에는 eSpeak NG를 사용한다고 문서에 적혀 있다. 낯선 표기, 외래어, 사람 이름이 매끄럽게 들리면서도 틀릴 수 있는 이유다. 음향 처리 전에 틀리면 모델이 잘못된 발음을 자연스럽게 읽어준다. 모델과 발음 처리기
관리팀은 숫자를 글자로 풀어 쓰라고 권한다. 청취자에게 익숙한 방식으로 적는다. 실제 자료에 나오는 날짜, 시각, 범위, 약어, 수량을 시험한다. 화면에 보여줄 원래 문장과 발음을 위해 다듬은 버전이 다르면 따로 남긴다. 화면에는 원문을 보여주고 생성에 쓰는 대본에는 바꾼 내용을 기록할 수 있다.
한 문장 안에서 언어가 바뀌는 대본도 별도 시험이 필요하다. 문서에 따라 입력 언어를 고를 수 있으므로, 주로 한 언어로 된 자료에서도 고유명사와 인용구를 확인한다. 한 번에 생성한 결과가 어색하면 검토한 구간으로 나눠서 합성한다. 외국어 용어를 여러 수업에 걸쳐 같은 방식으로 읽어야 할 때 특히 유용하다.
학습 데이터는 시험을 어디서 시작할지 알려준다
모델 카드에 따르면 학습 음성은 897시간이다. 언어별 표에는 영어 약 322.6시간, 스와힐리어 27.0시간, 트위어 24.0시간, 요루바어 15.3시간으로 나온다. 시간은 데이터셋을 설명한다. 수업에서 쓰는 지역 방언, 특정 표현이 학습에 등장한 빈도, 합성된 이름을 청취자가 알아들을지는 시간만으로 판단하기 어렵다. 모델 카드와 언어별 표
학습하지 않은 언어 657개를 가장 가까운 학습 언어로 대신 읽어보는 실험적 목록도 있다. 별도 연구 경로로 다룰 만하다. 직접 학습한 언어와 다른 언어로 대신 처리한 언어는 근거 수준이 다르다. 음성에 의존하는 청취자를 위한 시험이라면 학습된 목록에서 시작한다. 실험적 경로를 사용할 때는 목적에 충분한 원어민 검토가 가능한지 따로 판단한다. 실험 언어 문서
관리팀은 4 vCPU 클라우드 기기에서 실시간 재생 길이 대비 2.4배 속도로 생성했다고 보고했다. 별도로, 학습에 쓰지 않은 데이터에 합성 음성을 만들고 Omnilingual ASR로 받아 적는 비교 평가도 소개했다. 비교가 보고된 27개 언어 중 21개에서 Africa TTS가 MMS-TTS보다 좋은 결과를 냈다. 두 수치 모두 프로젝트 측 측정이다. 실제 교실에서는 억양, 기기, 주변 소음, 스피커가 다르다. 받아쓰기 점수로 명료도를 가늠할 수 있고, 수업에 중요한 확인은 청취자가 문장을 어떻게 이해했는지다. 릴리스 벤치마크 · 평가 방법
| 시험 | 실제 기기에서 측정할 것 | 중요한 이유 |
|---|---|---|
| 첫 실행 | 설정 시간, 다운로드 크기, 캐시 저장 후 남은 공간 | 공용 노트북은 저장 공간이나 빠른 인터넷이 부족할 수 있다 |
| 캐시가 있는 상태의 합성 | 수업을 띄운 상태에서 요청부터 WAV 완성까지의 시간 | 다른 앱이 CPU를 쓰면 체감 속도가 달라진다 |
| 핵심 사실 | 이름, 시간, 숫자, 지시를 정확히 되풀이하는지 | 전체가 자연스러워도 중요한 한 단어가 틀릴 수 있다 |
| 지역 변이 | 대상 표현과 억양에 대한 원어민 판단 | 같은 언어 코드 안에 여러 말투가 포함된다 |
| 실패 복구 | 서면 자료나 직원 녹음으로 수업을 이어갈 수 있는지 | 필요한 당일에 모델이나 오디오 기기가 고장 날 수 있다 |
오프라인 환경을 설치하고 연결을 끊어 시험한다
- 검토한 짧은 지문을 고른다. 인사, 대표 연습 문제, 이름이나 숫자가 들어간 지문을 하나씩 쓴다. 합성 전에 해당 언어 화자에게 맞춤법과 표현을 확인받는다.
- 독립 Python 환경을 만든다. 0.5.0은 Python 3.10부터 3.14까지를 명시한다. 운영체제에 맞는 가상 환경을 활성화하고 해당 버전을 설치한다.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- 첫 모델 다운로드를 준비한다. 버전 문서는 기본 모델 다운로드를 약 440MB로 안내한다. 설치 중 승인된 네트워크에서 받거나 합성을 시작한 뒤 다운로드 안내에 동의한다. 영어를 시험한다면 문서에 따라 eSpeak NG도 설치한다. 플랫폼이나 실행 방식을 바꿀 때는 패키지 안내를 확인한다.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- 설치 후 네트워크를 끄고 다시 시험한다. 수업에서 사용할 계정과 캐시 위치를 그대로 쓴다. 새 WAV를 만들어 대상 기기에서 열고, 생성 시간은 재생 길이와 구분해 기록한다.
- 대본을 보기 전에 듣게 한다. 실제로 사용할 음량으로 재생하고 두 화자나 청취자에게 핵심 사실을 되풀이해 달라고 한다. 대본과 모델의 버전, 의견을 저장한다. 잘못 들은 사실이 있으면 텍스트를 수정하거나 녹음을 바꾼 뒤 다시 확인한다.
Android를 시험하는 팀에도 이 순서가 도움이 된다. AfriSpeech는 C 처리기와 Android 래퍼를 포함한 sherpa-onnx 번들을 문서화했다. 모바일 패키지와 기본 데스크톱 환경은 서로 다른 실행 방식을 쓰므로 실제 휴대전화 빌드를 따로 시험한다. 대표 기기와 완전한 지문으로 첫 시작 시간, 저장 공간, 음질, 배터리를 비교한다. 데스크톱 명령이 성공하면 해당 환경에서 작동한다는 근거가 생긴다. 휴대전화에서는 별도로 실행해 봐야 한다. 기기 내 배포 문서
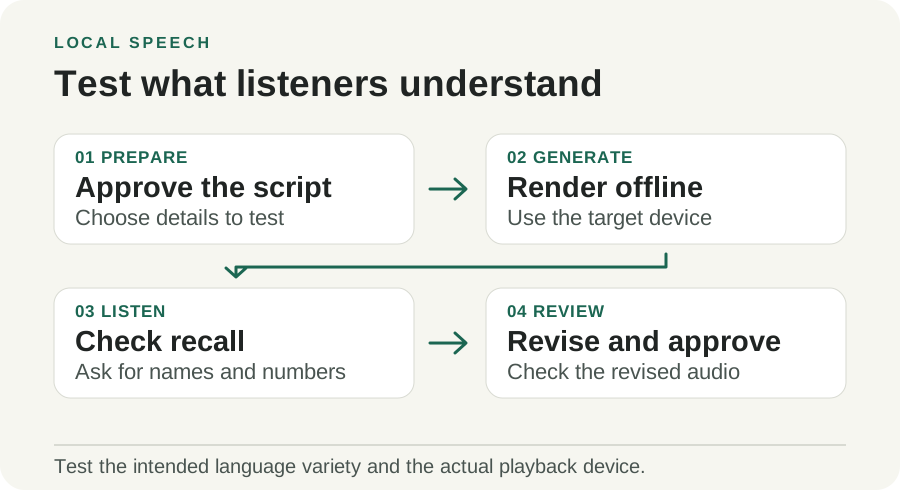
Telli.sh 제작 도해. 청취자가 대본을 읽기 전에 핵심 내용을 말해 보면 교정만으로 놓치기 쉬운 발음 문제를 찾을 수 있다.
코드와 음성의 라이선스를 따로 확인한다
Python 패키지 코드는 MIT 라이선스다. 0.5.0 릴리스는 모델과 기본 음성이 CC BY-NC 4.0을 사용한다고 밝힌다. 영어 처리에 필요한 eSpeak NG에는 별도의 GPL 조건이 있다. 도구와 음성 파일을 배포하거나 이를 이용해 서비스를 만들 때 각각 확인한다. 공개 파일은 시험하기 쉽지만 일부 상업적 용도에는 다른 모델이나 별도 허가가 필요할 수 있다. 릴리스 라이선스 · CC BY-NC 4.0 조건
패키지는 제공한 참조 음성도 사용할 수 있다. 기본 음성으로 학교에서 시험하면 누군가의 참조 녹음을 수집할 일이 없다. 특정 음성이 필요하다면 화자에게 해당 사용 목적의 허락을 받고, 원본과 생성 파일을 어디에 둘지 합의한다. 센터는 연습용 변형에는 기본 음성을 쓰고, 발음 수정은 허락을 받은 직원의 실제 목소리로 직접 녹음할 수도 있다.
오프라인 합성은 대본과 음성을 기기에 보관하는 데 도움이 된다. 웹 데모에 대본이나 참조 음성을 올리는 것은 별도의 데이터 공유다. 웹 데모를 볼 때는 공개해도 되는 예문으로 시작하고, 학교나 기관 정책을 적용받는 자료는 로컬에서 처리한다.
합격 여부는 청취자가 정한다
Africa TTS로 평소 음성 도구에서 자기 언어를 접하기 어려운 사람에게도 첫 음성 초안을 들려줄 수 있다. 귀로 확인할 수 있을 만큼 작은 시험부터 시작한다. 실제 수업에서 들을 지문을 네트워크가 없는 상태에서 합성하고, 청취자에게 중요한 세부 내용을 말해 달라고 한다. 정확하게 되풀이한 내용이 언어 메뉴의 선택지 개수보다 시험 결과를 잘 말해준다.
출처
- Africa TTS 0.5.0 릴리스, 2026년 11월 8일
- AfriSpeech 모델 카드와 학습 언어 범위
- AfriSpeech 평가 방법
- AfriSpeech 공개 청취 예시
- CC BY-NC 4.0 라이선스
- Joy Agyepong의 가나 라디오 녹음실 참고 사진, CC BY-SA 4.0
작업에 얽힌 대화와 결정을 검색할 수 있게 기록하려면 Telli.sh 계정을 만드세요.