Un portatile condiviso può leggere ad alta voce una lezione in twi senza connessione?
Africa TTS 0.5.0 include voci predefinite per 92 lingue africane e per l’inglese. Ecco che cosa verificare in un test di sintesi vocale offline.
Immagina un centro di apprendimento di quartiere con un portatile condiviso e una connessione intermittente. Un’insegnante ha un breve esercizio di lettura in twi e vuole farlo ascoltare due volte, prima delle risposte e durante la correzione. Una registrazione è una soluzione ovvia. La sintesi vocale diventa utile quando il testo cambia spesso, quando l’insegnante vuole creare varianti di esercizio o quando manca ancora una registrazione approvata.
AfriSpeech ha pubblicato Africa TTS 0.5.0 l’8 novembre 2026. Secondo la descrizione della versione, il pacchetto sintetizza la voce dal testo in 92 lingue africane e in inglese, con una voce predefinita per ciascuna lingua. Funziona su CPU e può sintetizzare offline dopo aver scaricato il modello e averlo salvato nella cache. Il progetto pubblica una dimostrazione online ed esempi audio. Sono un modo rapido per ascoltare le lingue di interesse prima di dedicare tempo all’installazione. Versione su PyPI · Esempi audio ufficiali
Per il centro la domanda è più circoscritta del numero di lingue. Chi ascolta riconosce le parole e segue il materiale sul portatile condiviso, nella propria varietà linguistica? Servono una prova d’ascolto e una sul dispositivo. Entrambe sono più utili se partono dalle frasi effettivamente usate dal centro.
Foto di contesto di uno studio radiofonico ghanese, scattata nel 2017. Foto di Joy Agyepong, ridimensionata con licenza CC BY-SA 4.0. Foto originale

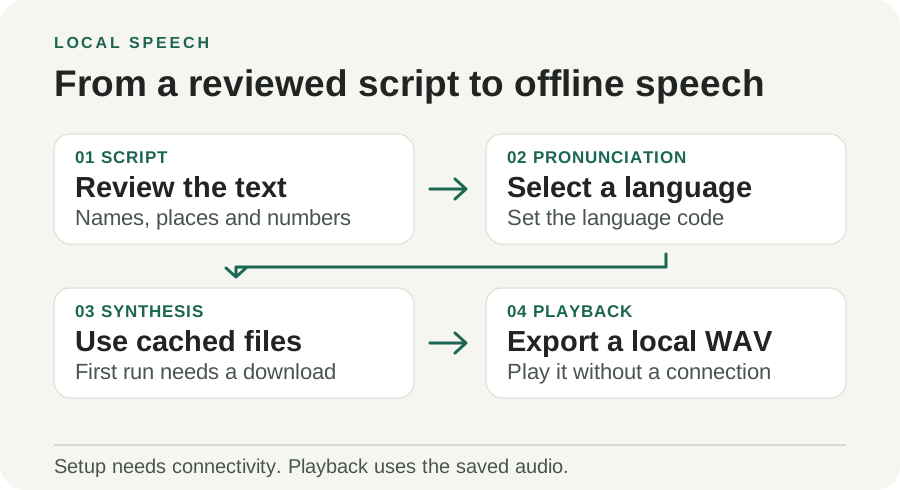
Illustrazione originale di Telli.sh. Il modello si scarica durante la configurazione. Dopo aver salvato in cache i file necessari, l’ascolto può restare sul dispositivo.
Una voce predefinita semplifica la preparazione della prima lezione
La versione offre un percorso semplice per cominciare. Fornisci una frase scritta e un codice ISO di tre lettere, come twi per il twi, swh per lo swahili o yor per lo yoruba. Il pacchetto usa una voce predefinita e salva il parlato in un file audio. L’insegnante può inserirlo in una lezione offline o riprodurlo direttamente con il testo disponibile per il confronto.
Il testo deve già essere nella lingua prevista dall’ascoltatore. Un annuncio in swahili richiede un testo in swahili. Se nasce in un’altra lingua, traduzione e revisione da parte di un parlante nativo sono passaggi distinti. Dai a chi traduce toponimi, unità e date usati dal pubblico. Tieni il testo revisionato accanto all’audio, così chi ascolta può capire dove è iniziato un equivoco.
Parti da materiale che consenta piccole correzioni. Un’insegnante può creare diversi brani di difficoltà simile e farli ascoltare a due parlanti senza mostrare il testo. Un centro di formazione può preparare un accompagnamento vocale alle istruzioni scritte e verificare se i partecipanti capiscono l’ordine dei passi. In entrambi i casi un membro del personale può registrare una breve correzione se la voce sintetica fatica con un nome o un’espressione insolita.
Un breve avviso pubblico è un altro impiego plausibile. Un centro cambia l’orario di un laboratorio e offre il testo stampato e la versione vocale in una postazione locale. Chiedi a un parlante di controllare l’orario prima di sostituire il file di ieri. Se la voce legge bene il corpo dell’avviso ma lascia ambiguo l’orario, registra di nuovo quella frase e mantieni visibile l’alternativa scritta. Il dettaglio annunciato vale più della comodità di generare tutto in una volta.
Decidi come aggiornare l’audio prima di metterlo sul dispositivo condiviso. Puoi conservare il testo principale in formato semplice con data e lingua accanto al WAV approvato. Quando qualcuno cambia la lezione, il file precedente resta disponibile finché un ascoltatore approva il nuovo. Su un dispositivo scollegato due copie superate possono suonare ugualmente convincenti. Una breve etichetta di revisione nella lezione indica quale versione partirà senza aprire la cartella di produzione.
La pronuncia comincia prima del modello vocale
La documentazione di AfriSpeech descrive un modello studente di sei strati con 110 milioni di parametri, incluso il codec audio. È stato distillato da un modello di base di 24 strati. L’addestramento ha insegnato al piccolo ad approssimare la generazione guidata del grande. È un motivo per cui il pacchetto può puntare alla CPU. Su un computer condiviso conta il tempo necessario per ottenere un file utilizzabile mentre gira anche la lezione. Dettagli del modello
Il modello riceve l’alfabeto fonetico internazionale, IPA, tramite un elaboratore di testo specifico per lingua. Questo trasforma la scrittura nelle unità sonore che il modello si aspetta. Il progetto usa il convertitore Africa G2P per le lingue africane supportate e documenta eSpeak NG per l’inglese. L’architettura spiega perché ortografie insolite, prestiti o nomi possano fallire anche se l’uscita suona scorrevole. Un errore prima della fase acustica può offrire al modello un modo naturale di dire una cosa sbagliata. Modello ed elaborazione della pronuncia
Il progetto raccomanda di scrivere i numeri in lettere. Usa le convenzioni del pubblico previsto. Prova le forme presenti nei materiali reali, tra cui date, orari, intervalli, abbreviazioni e quantità. Se differiscono, conserva separatamente il testo digitato e quello adattato per la pronuncia. Il primo rimane utile sullo schermo e lo script di sintesi conserva traccia dei cambiamenti.
I testi che cambiano lingua dentro una frase meritano una prova propria. La documentazione consente di selezionare la lingua. Controlla quindi i nomi e le citazioni in un testo per il resto monolingue. Se una singola esecuzione sorprende, prova a preparare il testo in segmenti revisionati. È particolarmente utile nei materiali didattici, dove può servire conservare un termine straniero e leggerlo in modo coerente tra lezioni.
La copertura di addestramento offre un punto di partenza
La scheda dichiara 897 ore di parlato per l’addestramento. La tabella per lingua indica circa 322,6 ore di inglese, 27,0 di swahili, 24,0 di twi e 15,3 di yoruba. Le ore descrivono i dati. Non indicano quale varietà locale usi una classe, quante volte sia comparsa un’espressione o se chi ascolta riconosca un nome sintetizzato. Scheda del modello e tabella delle lingue
La versione descrive anche una lista sperimentale di 657 lingue su cui il modello non è stato addestrato direttamente e che si possono leggere passando per la lingua addestrata più vicina. Considerala una via di ricerca separata. La lista principale e le lingue trattate attraverso una lingua sostitutiva hanno evidenze diverse. Per un test rivolto a persone che dipendono dall’audio, parti dalla lista addestrata e valuta poi se la via sperimentale ha sufficiente revisione da parte di parlanti nativi. Note sulle lingue sperimentali
Il progetto dichiara due risultati da contestualizzare. Primo, una generazione a 2,4 volte la velocità del tempo reale su una macchina cloud con quattro CPU virtuali. Secondo, un confronto su dati tenuti da parte in cui Omnilingual ASR ha trascritto l’uscita sintetizzata. In quella prova Africa TTS ha superato MMS-TTS in 21 delle 27 lingue per cui è pubblicato il confronto. Entrambe le cifre vengono dal progetto. Un’aula ha accenti, dispositivi, rumore di fondo e parlanti diversi. Il punteggio di trascrizione approssima la comprensibilità. Per la lezione conta come l’ascoltatore interpreta la frase. Benchmark della versione · Metodi di valutazione
| Prova | Che cosa misurare sul dispositivo effettivo | Perché conta |
|---|---|---|
| Primo avvio | Tempo di configurazione, dimensione del download e spazio dopo aver riempito la cache | Un portatile condiviso può avere poco spazio o una connessione lenta |
| Generazione dalla cache | Tempo dalla richiesta al WAV pronto con la lezione aperta | Un’app in background può cambiare la velocità percepita della CPU |
| Fatti essenziali | Se gli ascoltatori ripetono correttamente nomi, orari, numeri e istruzioni | Un brano può sembrare naturale anche con una parola importante sbagliata |
| Varietà locale | Giudizio di parlanti nativi su espressioni e accenti previsti | Un codice di lingua può coprire diversi modi di parlare |
| Recupero da un guasto | Se la lezione funziona ancora con testo scritto o una registrazione del personale | Modello o dispositivo audio possono fallire il giorno in cui servono |
Configura il percorso offline una volta e poi provalo senza rete
- Scegli un brano breve revisionato. Scrivi un saluto, un esercizio rappresentativo e un brano con nomi o numeri. Chiedi a un parlante di confermare ortografia e formulazione prima della sintesi.
- Crea un ambiente Python isolato. La versione 0.5.0 indica Python da 3.10 a 3.14. Attiva un ambiente virtuale adatto al sistema operativo e installa la versione indicata.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- Pianifica il primo download. La documentazione della versione indica circa 440 MB per il modello predefinito. Scaricalo durante la configurazione su una rete approvata oppure avvia una sintesi e accetta il download quando richiesto. Installa eSpeak NG come documentato se il test include l’inglese. Consulta le istruzioni prima di cambiare piattaforma o backend.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- Ripeti con la rete disattivata. Usa l’account e la cache previsti per la lezione. Crea un nuovo WAV, aprilo sul dispositivo finale e annota il tempo di generazione separatamente dalla durata della riproduzione.
- Fai ascoltare prima di leggere. Riproduci le tracce al volume previsto e chiedi a due parlanti o ascoltatori di ripetere i fatti principali. Salva versione del testo, versione del modello e commenti. Se un dettaglio viene frainteso, correggi il testo o sostituisci la traccia e ripeti il controllo.
La sequenza è utile anche a chi è interessato ad Android. AfriSpeech documenta un pacchetto sherpa-onnx con elaboratore in C e involucro per Android. Prova a parte la build effettiva del telefono, perché il pacchetto mobile e l’ambiente desktop predefinito usano backend diversi. Confronta avvio a freddo, spazio, audio e batteria con dispositivi rappresentativi e brani completi. Un comando funzionante su desktop dimostra che il progetto si adatta a un ambiente. Il telefono richiede una prova propria. Note di esecuzione sul dispositivo
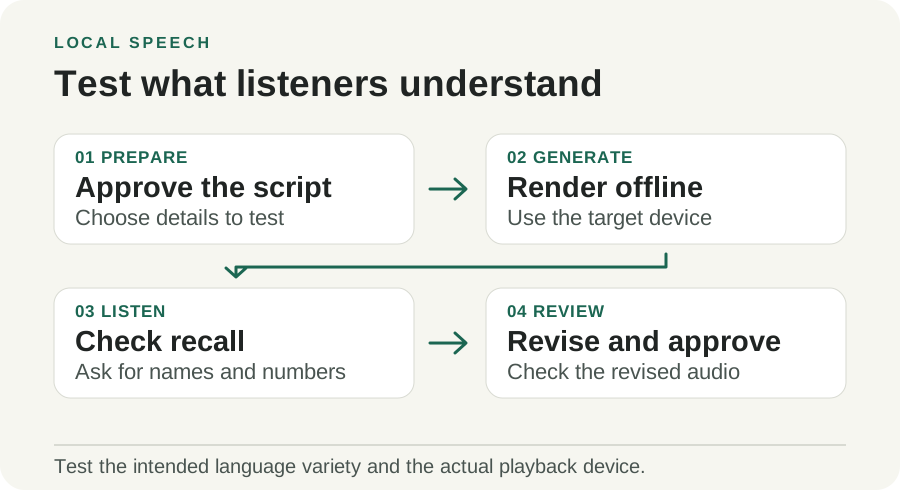
Illustrazione originale di Telli.sh. Chiedi agli ascoltatori di ripetere i fatti principali prima di leggere il testo, così possono trovare problemi di pronuncia che sfuggono a chi corregge il testo.
Controlla la licenza della voce oltre a quella del codice
Il codice del pacchetto Python è sotto licenza MIT. La versione 0.5.0 indica per modello e voci predefinite CC BY-NC 4.0. La dipendenza inglese eSpeak NG ha proprie condizioni GPL. Verifica separatamente queste parti quando decidi come distribuire strumento, file vocali o un servizio che ne dipende. Un download pubblico può essere facile da provare anche se alcuni usi commerciali richiedono un altro modello o un permesso separato. Licenze della versione · Condizioni CC BY-NC 4.0
Il pacchetto può usare anche un campione vocale fornito dall’utente. Una voce predefinita semplifica la prova scolastica perché evita di raccogliere una registrazione di riferimento. Se l’app richiede una voce specifica, ottieni il permesso della persona per l’uso previsto e concorda dove risiederanno campione e file generati. Un centro può evitare quella scelta registrando correzioni con la voce di un membro del personale consenziente e usando il modello predefinito per le varianti di esercizio.
La sintesi offline può aiutare a tenere testi e voci sul proprio dispositivo. La dimostrazione ospitata è una via diversa. Inviare un testo o una traccia di riferimento a un servizio web richiede una scelta separata sulla condivisione dei dati. Parti da una frase pubblica per provare la demo e usa il flusso locale per materiale soggetto alle regole della scuola o dell’organizzazione.
Il criterio di riuscita spetta a chi ascolta
Africa TTS rende realistico offrire una prima bozza vocale a persone che raramente vedono la propria lingua in uno strumento di sintesi. Una prova utile è abbastanza piccola da poterla controllare a orecchio. Prendi un brano che le persone ascolteranno davvero, eseguilo con la rete spenta e chiedi di ripetere il dettaglio che conta. La risposta dice di più sulla prova del numero di opzioni nel menu delle lingue.
Fonti
- Versione 0.5.0 di Africa TTS, 8 novembre 2026
- Scheda AfriSpeech e copertura dell’addestramento
- Metodi di valutazione di AfriSpeech
- Esempi audio pubblici di AfriSpeech
- Licenza CC BY-NC 4.0
- Foto di contesto di uno studio radiofonico in Ghana di Joy Agyepong, CC BY-SA 4.0
Per conservare in un archivio consultabile le conversazioni e le decisioni alla base del tuo lavoro, crea un account Telli.sh.