Un ordinateur partagé peut-il lire une leçon en twi à voix haute hors ligne ?
Africa TTS 0.5.0 fournit des voix par défaut pour 92 langues africaines et l’anglais. Voici ce qu’un pilote de synthèse vocale hors ligne devrait vérifier.
Imaginez un centre d’apprentissage avec un ordinateur partagé et une connexion irrégulière. Une enseignante a préparé un exercice de lecture en twi. Elle voudrait que ses élèves l’entendent deux fois, avant de répondre puis pendant la correction. Un enregistrement est la solution évidente. La synthèse vocale devient utile lorsque le texte change souvent, lorsque l’enseignante souhaite créer des variantes ou lorsqu’un enregistrement validé reste à faire.
AfriSpeech a publié Africa TTS 0.5.0 le 8 novembre 2026. Selon la description de la version, le paquet produit de la parole à partir de textes dans 92 langues africaines et en anglais, avec une voix par défaut pour chaque langue. Il fonctionne sur processeur et peut synthétiser hors ligne une fois le modèle téléchargé et mis en cache. L’équipe publie une démonstration en ligne et des extraits audio. Ces extraits permettent d’écouter les langues envisagées avant de passer du temps à installer le logiciel. Version PyPI · Extraits audio officiels
Pour le centre, la question dépasse le nombre de langues. Les personnes reconnaissent-elles les mots et suivent-elles le contenu sur l’ordinateur partagé, dans leur variété de la langue ? Il faut un test d’écoute et un test sur l’appareil. Les deux gagnent à partir des phrases réellement utilisées au centre.
Photo d’illustration prise dans un studio de radio au Ghana en 2017. Photographie de Joy Agyepong, redimensionnée sous CC BY-SA 4.0. Photo originale

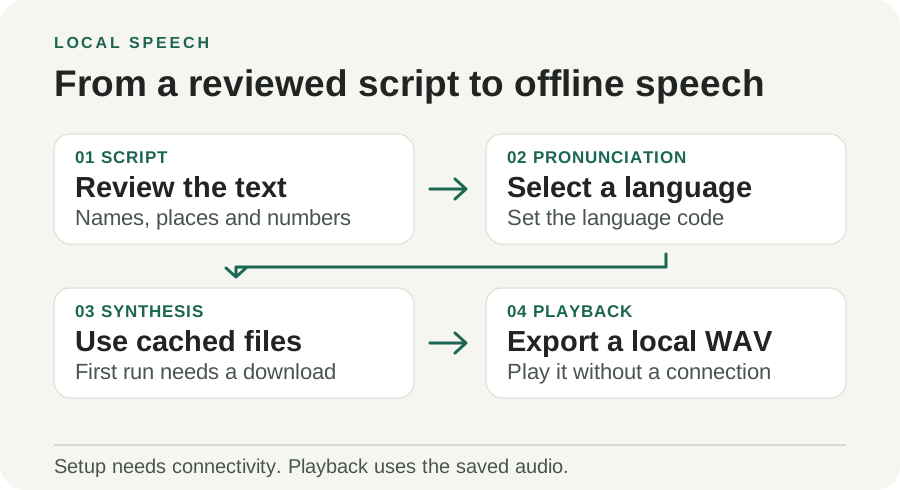
Illustration originale de Telli.sh. Le modèle est téléchargé à l’installation. Après mise en cache des fichiers nécessaires, l’écoute peut rester sur l’appareil.
Une voix par défaut simplifie la première leçon
La version fournit un point d’entrée direct. Donnez une phrase écrite et un code ISO de langue à trois lettres, comme twi pour le twi, swh pour le swahili ou yor pour le yoruba. Le paquet choisit une voix par défaut et enregistre la parole dans un fichier audio. Une enseignante peut intégrer ce fichier à une leçon hors ligne ou le lire directement, avec le texte à disposition pour comparer.
Le texte doit déjà être dans la langue attendue par la personne qui écoute. Une annonce en swahili demande un texte en swahili. Si elle a été rédigée dans une autre langue, la traduction et la relecture par une personne qui maîtrise la langue sont des étapes distinctes. Donnez au traducteur les noms de lieux, unités et conventions de date utilisés par le public. Placez le texte relu à côté de l’audio pour aider à retrouver l’origine d’un malentendu.
Commencez avec du contenu facile à corriger. Une enseignante peut créer plusieurs passages de difficulté comparable et demander à deux locuteurs de les écouter sans lire. Un centre de formation peut accompagner des consignes écrites d’une version parlée et vérifier que les participants comprennent l’ordre des étapes. Dans les deux cas, une personne de l’équipe peut enregistrer une courte correction si la synthèse achoppe sur un nom ou une expression inhabituelle.
Un court avis public est un autre usage possible. Un centre déplace l’horaire d’un atelier et propose un texte imprimé et une version parlée sur une borne locale. Demandez à une personne de vérifier l’heure modifiée avant de remplacer le fichier précédent. Si la voix restitue le corps de l’annonce mais laisse l’heure ambiguë, réenregistrez cette phrase et gardez le texte visible. L’information annoncée compte davantage que la commodité d’un fichier produit d’un seul coup.
Déterminez comment l’audio sera mis à jour avant de le déposer sur un appareil partagé. Une méthode consiste à conserver le texte maître daté et la langue à côté du WAV approuvé. Lorsqu’un membre de l’équipe modifie la leçon, l’ancien fichier reste disponible jusqu’à validation du nouveau après écoute. Sur un appareil déconnecté, deux anciennes copies peuvent paraître tout aussi convaincantes. Une courte mention de version dans l’interface indique à l’enseignante quel fichier sera lu sans ouvrir le dossier de production.
La prononciation se joue avant le modèle vocal
La documentation décrit un modèle élève à six couches de 110 millions de paramètres, codec audio compris. Il a été obtenu par distillation à partir d’un modèle de base à 24 couches. L’entraînement a appris au petit modèle à approcher la génération guidée du grand. Cela contribue à rendre possible l’exécution sur processeur. Sur un ordinateur partagé, la mesure utile est le temps nécessaire à la production d’un fichier utilisable alors que la leçon tourne aussi. Détails du modèle
Le modèle reçoit l’alphabet phonétique international, ou API, via un prétraitement propre à chaque langue. Ce prétraitement associe les formes écrites aux unités sonores attendues. Le projet utilise son convertisseur Africa G2P pour les langues africaines prises en charge et documente eSpeak NG pour l’anglais. Cette architecture explique pourquoi une orthographe inhabituelle, un emprunt ou un nom peut échouer alors que la voix reste fluide. Une erreur avant l’étape acoustique peut donner une prononciation naturelle au mauvais mot. Modèle et prétraitement phonétique
L’équipe recommande d’écrire les nombres en toutes lettres. Suivez les conventions du public visé. Testez les dates, heures, intervalles, abréviations et quantités telles qu’elles apparaissent dans les documents. Gardez le passage écrit et sa version adaptée à la prononciation séparément s’ils diffèrent. Le texte reste utilisable à l’écran et le script de génération conserve une trace précise des retouches.
Les textes qui changent de langue au milieu d’une phrase méritent leur propre essai. La documentation permet de choisir une langue. Vérifiez les noms et citations dans un texte autrement monolingue. Si une exécution produit un résultat inattendu, préparez les passages concernés en segments séparés et relus. C’est particulièrement utile dans des supports où un terme étranger doit être conservé et prononcé de la même façon d’une leçon à l’autre.
La couverture d’entraînement donne un point de départ
La fiche du modèle rapporte 897 heures de parole dans les données d’entraînement. Le tableau par langue indique environ 322,6 heures d’anglais, 27,0 de swahili, 24,0 de twi et 15,3 de yoruba. Ces durées décrivent le jeu de données. Elles n’indiquent ni la variété employée en classe, ni la fréquence d’une expression, ni la capacité des auditeurs à reconnaître un nom synthétisé. Fiche du modèle et tableau des langues
La version décrit aussi une liste expérimentale de 657 langues non apprises, que le système peut tenter de lire par l’intermédiaire de la langue entraînée la plus proche. C’est une piste de recherche distincte. Une langue de la liste principale et une langue traitée par approximation ne disposent pas des mêmes éléments de validation. Pour un pilote destiné à des personnes qui dépendent de l’audio, partez de la liste entraînée, puis examinez si la voie expérimentale a été suffisamment relue par des locuteurs pour l’usage souhaité. Notes sur les langues expérimentales
Deux résultats du projet méritent du contexte. L’équipe rapporte une génération à 2,4 fois le temps réel sur une machine cloud à quatre vCPU. Elle décrit aussi une comparaison sur des données mises de côté, dans laquelle Omnilingual ASR transcrivait la parole synthétisée. Africa TTS y devance MMS-TTS pour 21 des 27 langues comparées. Les deux chiffres viennent du projet. Une salle de classe apporte d’autres accents, appareils, bruits et haut-parleurs. Un score de transcription donne un indice d’intelligibilité. Pour la leçon, c’est l’interprétation de la phrase par les personnes qui compte. Benchmarks de la version · Méthodes d’évaluation
| Test | Mesure sur l’appareil pilote | Pourquoi c’est important |
|---|---|---|
| Premier lancement | Temps d’installation, taille du téléchargement, espace après mise en cache | Un ordinateur partagé peut manquer d’espace ou de débit |
| Génération depuis le cache | Temps entre la demande et le WAV prêt avec la leçon ouverte | Une application en arrière-plan peut ralentir un processeur ordinaire |
| Informations clés | Restitution correcte des noms, heures, nombres et consignes | Un passage peut sembler naturel tout en déformant un mot important |
| Variété locale | Avis de locuteurs sur les expressions et accents visés | Un code de langue peut couvrir plusieurs façons de parler |
| Reprise après échec | Fonctionnement de la leçon avec le texte ou un enregistrement de l’équipe | Le modèle ou le matériel audio peut tomber en panne le jour de l’usage |
Installer le parcours hors ligne puis le tester sans connexion
- Choisir un court passage relu. Rédigez une salutation, un exercice représentatif et un passage avec des noms ou des chiffres. Faites vérifier l’orthographe et la formulation par une personne qui parle la langue avant la synthèse.
- Créer un environnement Python isolé. La version 0.5.0 indique Python 3.10 à 3.14. Activez un environnement virtuel adapté au système puis installez la version indiquée.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- Prévoir le premier téléchargement du modèle. La documentation de la version indique environ 440 Mo pour le premier téléchargement du modèle par défaut. Lancez-le à l’installation sur un réseau autorisé ou démarrez une synthèse et acceptez le téléchargement. Installez la dépendance eSpeak NG documentée si l’essai inclut l’anglais. Consultez les instructions avant de changer de plateforme ou de moteur.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- Recommencer sans réseau après l’installation. Utilisez le compte et l’emplacement du cache prévus pour la leçon. Produisez un nouveau WAV, ouvrez-le sur l’appareil et mesurez le temps de génération séparément de la durée de lecture.
- Faire écouter avant de faire lire. Jouez les fichiers au volume prévu et demandez à deux locuteurs ou auditeurs de répéter les informations clés. Enregistrez la version du texte, celle du modèle et les remarques. Si un élément est mal compris, corrigez le texte ou remplacez le clip et répétez l’essai.
Cette démarche aide aussi les équipes qui envisagent Android. AfriSpeech documente un paquet sherpa-onnx avec un prétraitement en C et une couche Android. Testez séparément l’application sur téléphone, car la version mobile et l’environnement de bureau par défaut utilisent des moteurs différents. Comparez le démarrage à froid, le stockage, l’audio et la batterie sur des appareils représentatifs avec des passages complets. Une commande de bureau qui fonctionne confirme un environnement. Le téléphone demande son propre essai. Notes de déploiement sur appareil
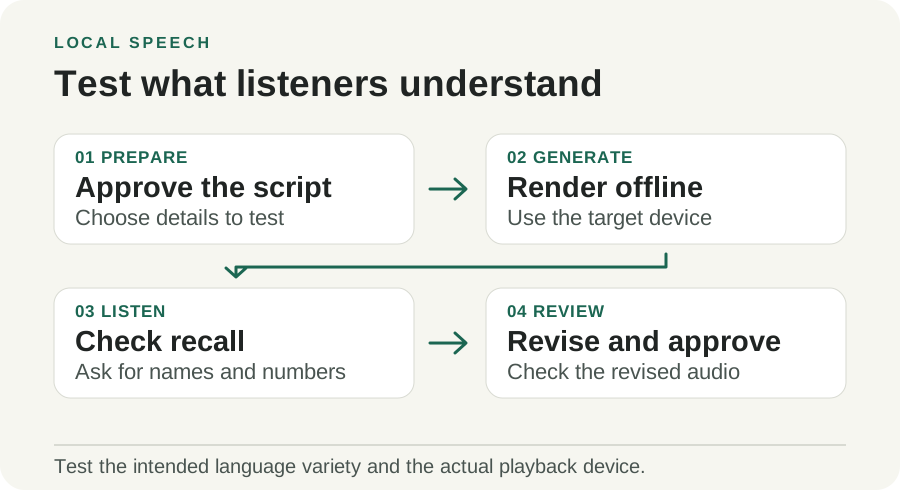
Illustration originale de Telli.sh. Demandez de répéter les informations avant de lire le texte pour repérer les erreurs de prononciation qu’une relecture peut manquer.
La voix et le code relèvent de licences distinctes
Le code du paquet Python est sous licence MIT. Selon la version 0.5.0, le modèle et les voix par défaut sont sous CC BY-NC 4.0. eSpeak NG, utilisé pour l’anglais, relève de ses propres conditions GPL. Vérifiez ces éléments séparément avant de distribuer l’outil, les voix ou un service qui les utilise. Un téléchargement public est facile à essayer. Certains usages commerciaux exigent un autre modèle ou une autorisation distincte. Licences de la version · Conditions CC BY-NC 4.0
Le paquet accepte aussi un échantillon de voix fourni. Une voix par défaut simplifie un pilote scolaire, car elle évite de collecter l’enregistrement d’une personne. Si l’application exige une voix précise, obtenez l’accord de la personne pour l’usage prévu et convenez de l’emplacement de stockage de la référence et des fichiers générés. Un centre peut enregistrer les corrections dans la voix d’un membre de l’équipe avec son accord et employer la voix par défaut pour les variantes d’exercice.
La synthèse hors ligne peut garder les textes et références vocales sur l’appareil. La démonstration hébergée suit une autre voie. Soumettre un texte ou un extrait à un service web constitue une décision distincte de partage. Pour vérifier une démonstration hébergée, commencez par une phrase publique. Utilisez le parcours local pour les supports soumis aux règles de l’école ou de l’organisation.
L’auditeur décide si l’essai est réussi
Africa TTS permet de faire écouter un premier brouillon à des personnes qui rencontrent rarement leur langue dans un outil vocal. Un essai utile reste assez petit pour être vérifié à l’oreille. Prenez un passage que les gens entendront vraiment, générez-le sans réseau et demandez-leur de répéter le détail important. Une réponse correcte renseigne davantage sur le pilote que la longueur du menu des langues.
Sources
- Version Africa TTS 0.5.0 du 8 novembre 2026
- Fiche du modèle AfriSpeech et couverture d’entraînement
- Méthodes d’évaluation d’AfriSpeech
- Extraits audio publics d’AfriSpeech
- Licence CC BY-NC 4.0
- Photo d’illustration d’un studio de radio au Ghana par Joy Agyepong, CC BY-SA 4.0
Pour retrouver les conversations et les décisions qui ont guidé votre travail, créez un compte Telli.sh.