¿Puede un portátil compartido leer en voz alta una lección en twi sin conexión?
Africa TTS 0.5.0 trae voces predeterminadas para 92 idiomas africanos y el inglés. Esto es lo que conviene comprobar en un piloto de voz sin conexión.
Imagina un centro comunitario de aprendizaje con un portátil compartido y una conexión a internet intermitente. Una profesora tiene un ejercicio breve de lectura en twi y quiere que el alumnado lo oiga dos veces, antes de responder y al comprobar las respuestas. Una grabación es una solución evidente. La síntesis de voz resulta útil si el guion cambia a menudo, si la profesora quiere crear variantes de práctica o si todavía no hay una grabación aprobada.
AfriSpeech publicó Africa TTS 0.5.0 el 8 de noviembre de 2026. Según la descripción de la versión, el paquete sintetiza voz a partir de texto en 92 idiomas africanos y en inglés, con una voz predeterminada por idioma. Funciona en CPU y puede sintetizar sin conexión tras descargar el modelo y guardarlo en caché. El equipo publica una demostración en línea y muestras de audio. Sirven para escuchar los idiomas que interesan antes de dedicar tiempo a la instalación. Versión en PyPI · Muestras oficiales de audio
Para el centro, la pregunta es más concreta que la cantidad de idiomas. ¿Pueden los oyentes reconocer las palabras y seguir el material en el portátil compartido y en su propia variedad lingüística? Hace falta una prueba de escucha y otra de dispositivo. Ambas resultan más útiles si parten de frases reales del centro.
Fotografía contextual de un estudio de radio de Ghana, tomada en 2017. Fotografía de Joy Agyepong, redimensionada bajo CC BY-SA 4.0. Fotografía original

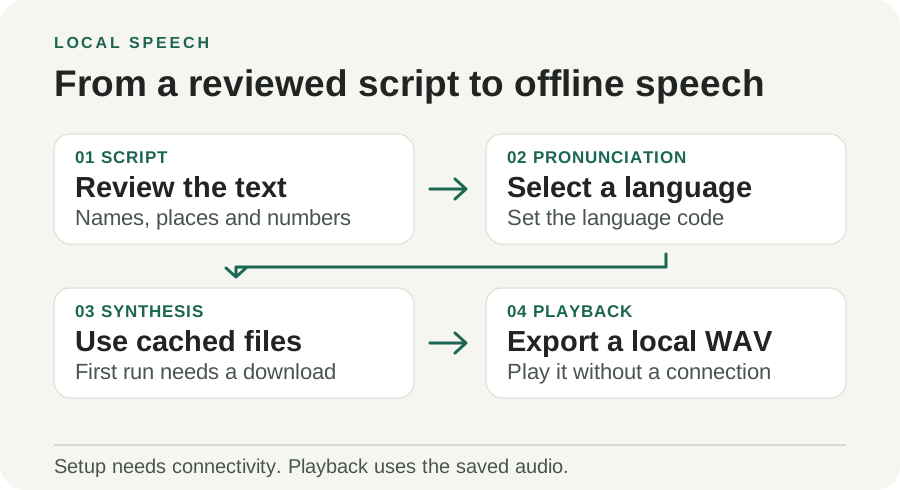
Ilustración original de Telli.sh. El modelo se descarga al configurar el sistema. La escucha puede permanecer en el equipo tras guardar los archivos necesarios en caché.
Una voz predeterminada simplifica la preparación de la primera lección
La versión ofrece una vía directa para empezar. Proporciona una frase escrita y un código ISO de tres letras como twi para twi, swh para suajili o yor para yoruba. El paquete usa una voz predeterminada y guarda el resultado en un archivo de audio. La profesora puede añadirlo a una lección sin conexión o reproducirlo directamente y dejar el texto disponible para comparar.
El texto debe estar ya en el idioma que espera el oyente. Un anuncio en suajili necesita un guion en suajili. Si empezó en otro idioma, traducirlo y revisarlo con un hablante nativo son pasos separados. Da al traductor los nombres de lugar, unidades y fechas que usa el público. Deja el guion revisado junto al audio para que el oyente identifique dónde empezó un malentendido.
Empieza con material que permita pequeñas correcciones. Una profesora puede crear varios pasajes de dificultad parecida y pedir a dos hablantes que escuchen sin ver el texto. Un centro de formación puede preparar una versión hablada de unas instrucciones y comprobar si los asistentes entienden el orden de los pasos. En ambos casos, alguien del equipo puede grabar una corrección breve cuando la voz sintética tropiece con un nombre o una expresión poco común.
Otro trabajo plausible es un aviso breve. Un centro cambia la hora de un taller y ofrece el texto impreso y una versión sonora en un quiosco local. Pide a un hablante que compruebe la hora antes de sustituir el archivo de ayer. Si la voz lee bien el cuerpo del aviso pero deja ambigua la hora, vuelve a grabar esa frase y mantén visible la versión escrita. El dato anunciado vale más que generar todo el archivo de una vez.
Decide cómo actualizarás el audio antes de ponerlo en un equipo compartido. Puedes guardar un guion maestro en texto plano con fecha e idioma junto al WAV aprobado. Cuando alguien cambia la lección, el archivo previo queda disponible hasta que un oyente aprueba el nuevo. Sin conexión, dos copias obsoletas pueden sonar igual de convincentes. Una etiqueta breve de revisión en la lección indica al docente qué versión se va a reproducir sin abrir la carpeta de producción.
La pronunciación empieza antes del modelo de voz
La documentación de AfriSpeech describe un modelo alumno de seis capas con 110 millones de parámetros, incluido su códec de audio. Se obtuvo por destilación de un modelo base de 24 capas. El entrenamiento enseñó al pequeño a aproximar la generación guiada del grande. Es una razón por la que puede orientarse a CPU. En un ordenador compartido interesa cuánto tarda en crear un archivo utilizable mientras el equipo también ejecuta la lección. Detalles del modelo
El modelo recibe el Alfabeto Fonético Internacional (AFI) a través de un procesador de texto específico del idioma. Ese procesador convierte la escritura en las unidades sonoras esperadas. El proyecto usa su conversor Africa G2P para los idiomas africanos compatibles y documenta eSpeak NG para inglés. La arquitectura explica por qué una ortografía poco habitual, un préstamo o un nombre pueden fallar aunque la salida suene fluida. Un error previo a la etapa acústica puede dar al modelo una manera natural de decir algo equivocado. Modelo y procesamiento de pronunciación
El equipo recomienda escribir los números con palabras. Usa las convenciones del público previsto. Prueba los formatos reales de fechas, horas, rangos, abreviaturas y cantidades. Si difieren, guarda por separado el pasaje escrito y la versión ajustada a la pronunciación. El texto original seguirá sirviendo en pantalla y el guion de síntesis conservará un registro de los cambios.
Los guiones que cambian de idioma dentro de una frase merecen una prueba propia. La documentación permite seleccionar idioma, de modo que conviene comprobar nombres y citas en contenido por lo demás monolingüe. Si una sola ejecución da un resultado inesperado, prepara el material en segmentos revisados. Es especialmente útil en educación, donde un término extranjero quizá deba conservarse y pronunciarse de forma coherente entre lecciones.
La cobertura de entrenamiento ofrece un punto de partida
La ficha indica 897 horas de voz de entrenamiento. La tabla por idioma da unas 322,6 horas para inglés, 27,0 para suajili, 24,0 para twi y 15,3 para yoruba. Son una descripción de los datos. No indican qué variedad local usa una clase, cuántas veces apareció una expresión en el entrenamiento ni si los oyentes reconocerán un nombre sintetizado concreto. Ficha del modelo y tabla de idiomas
La versión también describe una lista experimental de 657 idiomas sin entrenamiento directo que pueden leerse a través del idioma entrenado más cercano. Trátalo como una vía de investigación separada. Los idiomas de la lista principal y los que pasan por un sustituto tienen distinto respaldo. En un piloto dirigido a personas que dependen del audio, empieza por la lista entrenada y decide después si la vía experimental tiene suficiente revisión nativa para su propósito. Notas de idiomas experimentales
El equipo declara dos resultados que conviene contextualizar. El primero es una generación a 2,4 veces el tiempo real en una máquina en la nube con cuatro CPU virtuales. El segundo es una comparación con datos reservados en la que Omnilingual ASR transcribió la salida sintetizada. Africa TTS superó a MMS-TTS en 21 de los 27 idiomas con comparación publicada. Ambas cifras proceden del proyecto. Un aula tiene acentos, dispositivos, ruido de fondo y hablantes distintos. Una puntuación de transcripción aproxima la inteligibilidad. Lo que importa para la lección es cómo entiende el oyente la frase. Pruebas de la versión · Métodos de evaluación
| Prueba | Qué medir en el dispositivo del piloto | Por qué importa |
|---|---|---|
| Primer inicio | Tiempo de instalación, tamaño de descarga y espacio tras llenar la caché | Un portátil compartido puede tener poco disco o una conexión lenta |
| Generación en caché | Tiempo desde la petición hasta el WAV terminado con la lección abierta | Una aplicación en segundo plano puede cambiar el rendimiento de la CPU |
| Datos clave | Si los oyentes repiten bien nombres, horas, números e instrucciones | El texto puede sonar natural con una palabra importante equivocada |
| Variedad local | Juicio de hablantes nativos sobre las expresiones y acentos previstos | Un código de idioma puede cubrir varias formas de hablar |
| Recuperación | Si la lección sigue funcionando con texto o una grabación del personal | El modelo o el dispositivo de audio pueden fallar el día de uso |
Configura una vez la vía local y pruébala sin conexión
- Elige un pasaje breve revisado. Escribe un saludo, un ejercicio representativo y un pasaje con nombres o números. Pide a un hablante que confirme la ortografía y la redacción antes de sintetizar.
- Crea un entorno aislado de Python. La versión 0.5.0 especifica Python de 3.10 a 3.14. Activa un entorno virtual adecuado a tu sistema operativo e instala la versión indicada.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- Planifica la primera descarga del modelo. La documentación de la versión indica unos 440 MB para el modelo predeterminado. Descárgalo en una red aprobada al configurar o inicia una síntesis y acepta la descarga cuando se solicite. Instala eSpeak NG según la documentación si el piloto incluye inglés. Consulta las instrucciones antes de cambiar de plataforma o backend.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- Repite con la red desactivada. Usa la cuenta y la caché de la lección. Genera un WAV nuevo, ábrelo en el dispositivo final y apunta el tiempo de generación por separado de la duración de la reproducción.
- Pide que escuchen antes de leer. Reproduce los fragmentos de audio al volumen previsto y pide a dos hablantes u oyentes que repitan los datos clave. Guarda la versión del guion, la del modelo y los comentarios. Si alguien oye un dato incorrecto, corrige el texto o reemplaza el fragmento y repite la comprobación.
La secuencia también sirve si te interesa Android. AfriSpeech documenta un paquete sherpa-onnx con un procesador de texto en C y una capa para Android. Prueba por separado la compilación real del móvil, porque el paquete móvil y el entorno de escritorio usan backends distintos. Compara el arranque en frío, el almacenamiento, la calidad de audio y la batería con equipos representativos y pasajes completos. Un comando de escritorio que funciona demuestra que el proyecto encaja en ese entorno. El móvil necesita su propia prueba. Notas de despliegue local
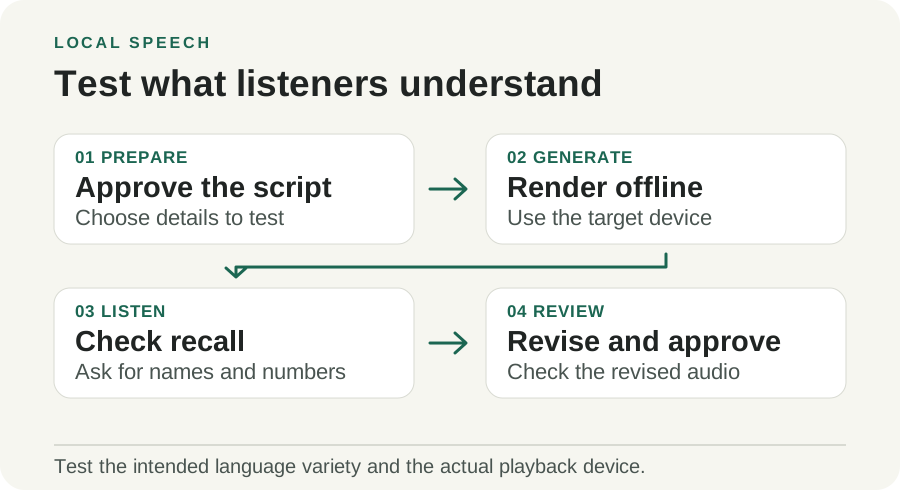
Ilustración original de Telli.sh. Pide que repitan los datos clave antes de leer el guion para detectar problemas de pronunciación que podrían pasar inadvertidos al revisar el texto.
Revisa la licencia de la voz además de la del código
El código del paquete Python tiene licencia MIT. La versión 0.5.0 indica que el modelo y las voces predeterminadas usan CC BY-NC 4.0. eSpeak NG, la dependencia inglesa, tiene sus propias condiciones GPL. Revisa cada parte al decidir cómo distribuir la herramienta, las voces o un servicio que dependa de ellas. Una descarga pública puede ser fácil de probar aunque algunos usos comerciales exijan otro modelo o un permiso aparte. Licencias de la versión · Condiciones CC BY-NC 4.0
El paquete también puede usar una muestra de voz que le proporciones. Una voz predeterminada simplifica la prueba escolar porque evita recoger una grabación de referencia de una persona. Si la aplicación necesita una voz específica, obtén el permiso del hablante para ese uso y acuerda dónde estarán el audio de referencia y los archivos generados. Un centro puede evitar esa decisión grabando correcciones con la voz de un miembro del equipo que dé permiso y usando el modelo predeterminado para las variantes de práctica.
La síntesis sin conexión puede ayudar a mantener guiones y voces en el propio equipo. La demostración alojada es otra vía. Enviar un guion o un fragmento de referencia a un servicio web requiere una decisión aparte sobre compartir datos. Usa una frase pública para probar el servicio alojado y la vía local para material sujeto a normas escolares o de la organización.
El criterio de éxito corresponde al oyente
Africa TTS facilita presentar un primer borrador de audio a personas que rara vez ven su idioma en una herramienta de voz. Una prueba útil es lo bastante pequeña para verificarla de oído. Toma un pasaje que la gente vaya a escuchar, ejecútalo con la red apagada y pide que repitan el dato importante. La respuesta a esa pregunta dice más sobre el piloto que la cantidad de opciones del menú de idiomas.
Fuentes
- Versión 0.5.0 de Africa TTS, 8 de noviembre de 2026
- Ficha de AfriSpeech y cobertura de entrenamiento
- Métodos de evaluación de AfriSpeech
- Muestras públicas de audio de AfriSpeech
- Licencia CC BY-NC 4.0
- Fotografía contextual de un estudio de Ghana de Joy Agyepong, CC BY-SA 4.0
Para guardar las conversaciones y decisiones de tu trabajo en un registro en el que puedas buscar, crea una cuenta de Telli.sh.